MiniMax H3 与 LTX 2.5 对比:质量、速度与真实基准测试
 Yifan Zhao9 分钟阅读 ·
MiniMax H3更适合复杂动作、物理规律、场景逻辑、运镜编排及大量参考素材生成,而 LTX 2.5 在速度、快速迭代和高分辨率后期方面更强。如果你正在决定在哪里使用 MiniMax H3,有用的问题不是哪个模型普遍更好,而是对于所需视频类型,哪个更快获得可用镜头。
这种区别在制作中可能代价很高。在我们审阅的MiniMax H3 工作流中,LTX 2.5 在一项RTX 5090测试中快约6.8倍,在DGX Spark上快约14倍;但H3 仍然更有吸引力,尤其当动作或物理互动决定镜头是否成功时。因此,我们的研究更倾向于按任务分配AI模型,而非选出一个单一模型赢家。
Virse专为这种多模型工作方式设计。Virse 不将模型分隔在孤立聊天工具中,而是让设计师与多个AI智能体在共享视觉画布上协作,项目资产与上下文可在任务间延续。这种连通环境支持更广泛的从简报到交付的AI设计工作流。付费套餐包含40多种模型的无限使用,包括 Nano Banana 2 和 GPT Image 2,以及无限席位。新用户还会获得注册积分,最多可用于10张 Nano Banana 2 图片或一个 Seedance 2.0 视频。
MiniMax H3 与 LTX 2.5:核心区别是什么?
H3 与 LTX 2.5 的最大区别,在于计算资源花在哪里,以及在哪些环节创造制作价值。
方面 | MiniMax H3 | LTX 2.5 |
|---|---|---|
模型规模 | 33B | 22B |
复杂动作 | 强 | 波动较大 |
物理与互动 | 强 | 困难场景中较不可靠 |
复杂提示词执行 | 表现较强的倾向 | 有所改善,但仍会失败 |
快速迭代 | 慢 | 优秀 |
测试中的步数模式 | 通常约20步 | 8步蒸馏工作流 |
高分辨率后期 | 成本更高 | 主要优势 |
多参考控制 | 主要优势 | 工作流重点不同 |
本地制作工具链 | 支持,但要求高 | 更完整 |
最佳角色 | 动作关键型生成 | 迭代、放大、后期 |
从产品设计角度看,H3 像一位高算力专家,而LTX 2.5 更像一个制作引擎。
这种区别比比较静帧更有用。如果物体在镜头中途消失,视频再清晰也可能失败;而对于简单产品揭示,复杂动作模型可能并无必要。
MiniMax H3 与 LTX 2.5 质量对比:动作和物理表现谁更好?
最清晰的质量比较方式,是将时间维度质量与空间维度质量分开。
当动作决定镜头成败时,H3 更强
我们的MiniMax H3 评测反复发现,H3 在以下方面更有吸引力:
- 打斗和奔跑
- 全身动作
- 多角色互动
- 物体操作
- 物理因果关系
- 电影感运镜
- 包含多个连续动作的提示词
这里重要的失败模式不是第一帧不好,而是时间逻辑破裂:手穿过物体、道具消失、快速动作中人体结构崩坏,或所要求的动作只完成一部分。
因此,对于动作密集的主打镜头,较慢生成如果减少重试,总成本反而可能更低。
LTX 2.5 在空间细节方面仍有竞争力
不应简单地将 LTX 2.5 描述为质量更低。在多个已审阅案例中,其输出因画面锐度、小物体稳定性、服装细节、烟雾和局部纹理而更受偏好。
这使 LTX 很适合产品镜头、较慢运镜、氛围片段,以及物理互动有限的场景。
实用结论很简单:H3 在时间维度质量上的优势更强,LTX 2.5 则在空间维度质量上仍能保持很强竞争力。
LTX 2.5 与 H3 速度对比:真实工作流基准显示什么?
研究中所有定量案例里,LTX 2.5 都更快。
硬件与输出 | H3 | LTX 2.5 | 结果 |
|---|---|---|---|
RTX 5060 Ti,约12秒,约0.6MP | 29分钟 | 18分钟 | LTX 节省约11分钟 |
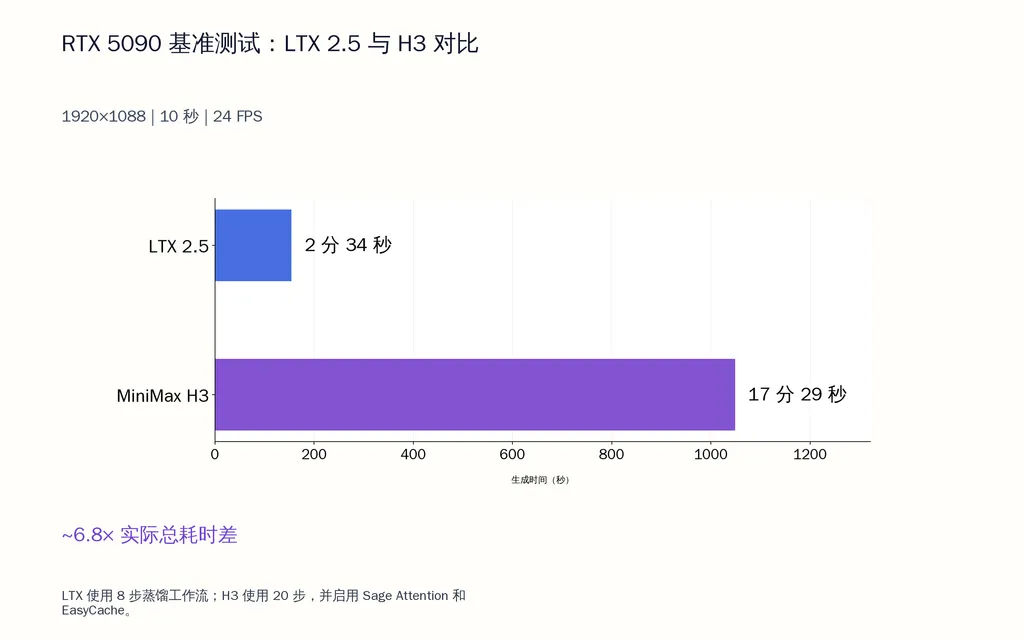
RTX 5090,1920×1088,10秒,24 FPS | 17分29秒 | 2分34秒 | 快约6.8倍 |
DGX Spark,1280×704,5秒,24 FPS | 866秒 | 61.89秒 | 快约14倍 |
这些是工作流基准,而非普遍适用的模型速度倍数。
RTX 5060 Ti 案例:29分钟与18分钟
在 RTX 5060 Ti 案例中,LTX 在约12秒、0.6MP生成中节省了约11分钟。
不过,已审阅的质量评估在物理、运镜、美感和指令准确性方面更偏向 H3。
这个案例说明,单看生成时间并不完整。简单片段中,LTX 节省时间的优势可能最重要;困难动作中,H3 仍可能用更少修正获得可用结果。
RTX 5090 案例:2分34秒与17分29秒
对于1920×1088、10秒、24 FPS的目标输出:
LTX 2.5:2分34秒
H3:17分29秒
这意味着约6.8倍的实际耗时差异。
但两者配置并不相同。LTX 使用8步蒸馏工作流,H3 则使用20步,配合 Sage Attention 和 EasyCache。因此,正确解读是测试中的 LTX 工作流完成速度快6.8倍,而非其 transformer 本身快6.8倍。
DGX Spark 案例:61.89秒与866秒
在 DGX Spark 上,一个1280×704、5秒、24 FPS并带音频的工作流耗时:
LTX 2.5:61.89秒
H3:866秒
观察到的差异约为14倍。
工作负载分析更能说明问题。估算的token步数工作量约为LTX 70,400,H3 651,200,相差约9.25倍。每token每步的执行耗时则接近得多:约为LTX 0.879毫秒,H3 0.959毫秒。
因此,最大的优势来自大幅减少扩散总工作量,而不是模型核心快14倍。
为什么 LTX 2.5 比 H3 更快?
LTX 2.5 通过低步数推理、分阶段分辨率处理和较低token工作量获得速度优势。
LTX 在最终分辨率之前完成大部分扩散
一个已审阅的 LTX 工作流在约640×352下生成8步,进行潜空间2倍放大,然后仅使用少量高分辨率细化步数。
这很重要,因为全分辨率视频扩散成本高。LTX 避免在整个采样过程中持续支付这项成本。
H3 也经过 CFG 蒸馏,因此速度差异不应简单归结为“蒸馏的 LTX 对比未蒸馏的 H3”。更有用的区别是 LTX 的低步数制作策略和较低的token步数总工作量。
H3 的成本随分辨率上升而增加
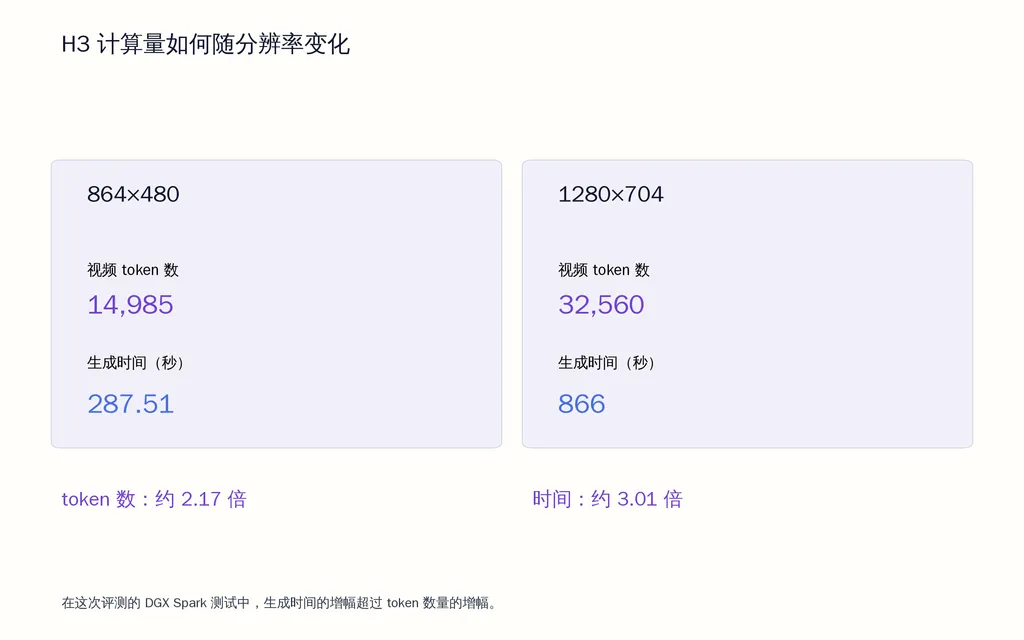
在一项 H3 DGX Spark 测试中:
864×480:14,985个token,287.51秒
1280×704:32,560个token,866秒
token数量升至约2.17倍,但生成时间升至约3.01倍。
因此,直接将 H3 推到更高分辨率可能成本很高,也因此将动作生成与后期分开可能合理。
H3 与 LTX 2.5 量化:为什么 NVFP4 仅略快于 INT8?
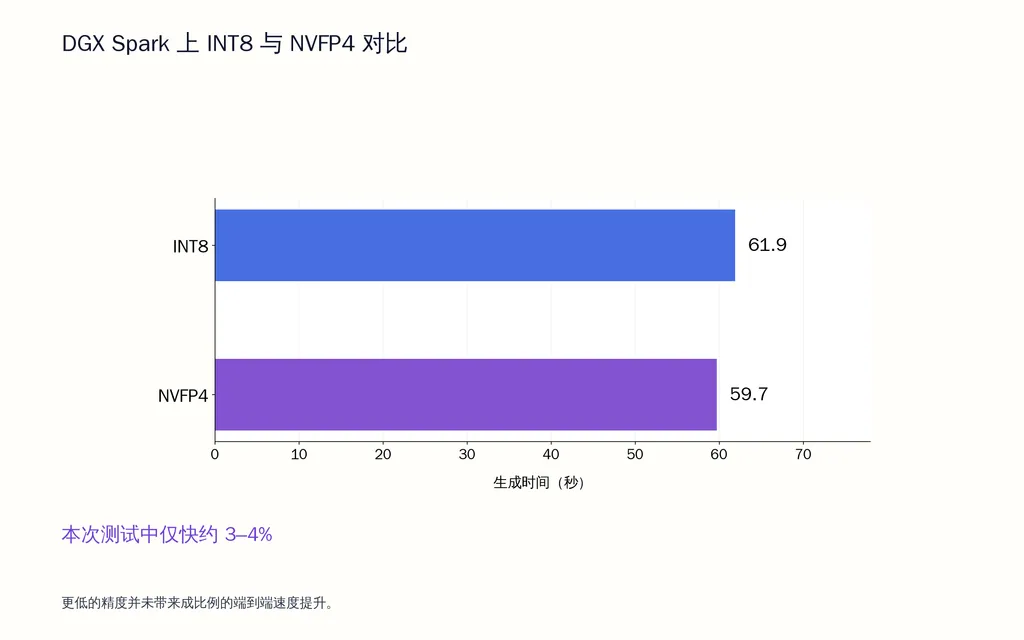
一次 DGX Spark 对比测得约:
INT8:61.9秒
NVFP4:59.7秒
这仅约为3–4%的提升。
实用启示是:更低精度不保证端到端速度按比例提升。算子内核支持、内存行为、张量布局、模型加载和框架成熟度都可能成为瓶颈。
对于本地工作流,应在实际硬件栈上测试量化格式,而不是只按位深选择。
MiniMax H3 与 LTX 2.5:本地部署与消费级GPU
两个模型都能本地运行,但LTX 2.5 目前更容易构建成可重复的本地制作流水线。
H3 可以本地运行,但硬件限制很重要
我们审阅的用户问题中,反复出现 RTX 3060 12GB、RTX 3090 24GB、RTX 5090、8GB显卡和 DGX Spark。
真正的问题不是 H3 能否本地运行,而是需要在分辨率、量化、内存和生成时间上做出多大妥协。
24GB级GPU比8GB或12GB硬件灵活得多,但当前研究没有标准化的 H3 GPU矩阵。因此,不应从孤立系统推导普遍适用的速度或分辨率承诺。
LTX 2.5 拥有更强的后期生态
审阅的 LTX 工具链包含量化检查点、VAE工作流、LoRA、ComfyUI支持、空间放大、时间维度放大和高分辨率后期。
周边生态很重要,因为专业制作不止一步生成,而是构思、筛选、细化、放大、审阅和交付。
H3 与 LTX 2.5:2K、4K、HDR和专业后期
高分辨率制作暴露了两者最明显的区别之一。
H3 工作流包括H3-Context-IR、H3-Base 和 H3-Regenerate-2K。H3-Base 可以本地运行,但完整高分辨率工作流的自包含程度较低。
当团队需要空间细化、时间细化、面向4K的后期、HDR、面向EXR的输出,以及反复本地迭代时,LTX 2.5 更强。
对于专业视频工作,我会避免把每个像素都交给 H3 使用最大算力处理。在动作需要时使用昂贵的时间推理,再将后期交给更高效的流水线。
H3 与 LTX 2.5:音频、参考素材和多镜头工作流
这也是两种模型分化的一个方面。
H3 擅长密集多模态参考控制
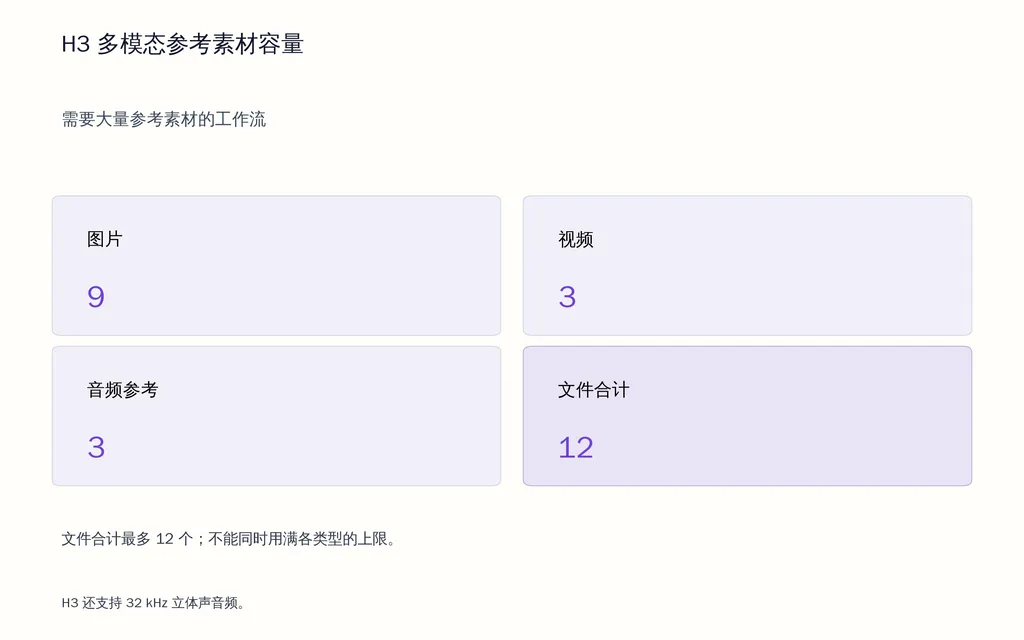
H3 支持32 kHz立体声音频,以及涉及图片、视频和音频输入的大量参考素材工作流。已审阅规格支持最多9张图片、3个视频和3段音频参考,但须遵守文件总数限制。
当镜头需要在多个输入间保持角色、物体、动作或音频上下文时,这让 H3 特别有吸引力。
LTX 2.5 更适合结构化制作序列
LTX 2.5 的制作方向强调同步音视频工作流、高效长视频迭代和面向多镜头的生成。
对于制作多个相连片段的团队,这可能比密集参考控制更重要,因为瓶颈从单镜头保真转向可重复的序列制作。
H3+LTX 2.5 工作流:为什么两者结合可能更好
最有用的制作策略可能是先 H3,后 LTX。
H3 处理动作关键型生成
我们的MiniMax H3 工作流研究涵盖约0.4MP的 H3 工作流、Turbo LoRA配置、8步实验和640×384源片段。
在这个阶段,重点关注:
- 动作
- 互动
- 物理
- 镜头行为
- 时间连续性
LTX 处理放大与细化
选出最佳 H3 结果后,使用 LTX 进行2倍放大、空间细化、时间细化或更高分辨率交付。
这种分工让 H3 聚焦时间智能,让 LTX 聚焦制作效率。
主要风险是生成式重新诠释。脸部、产品、标志、服装和小细节可能在细化过程中改变,因此身份敏感的工作需要视觉质检。
MiniMax H3 与 LTX 2.5 商业许可:团队应检查什么?
许可可能先于视觉质量决定选择。
在已审阅的 H3 许可中,标准社区许可排除美国、欧盟、英国和韩国,较大规模商业部署还需满足额外营收和署名条件。
审阅的 LTX 许可地理覆盖更广,但大型商业用户仍可能面临许可门槛和法律限制。
关键规则是:开放权重不等于无限制商业权利。
企业团队应在部署前审查地域、年营收、再分发、署名、产品集成和当前许可版本。
MiniMax H3 与 LTX 2.5 决策矩阵
制作场景 | 最佳起点 | 原因 |
|---|---|---|
复杂打斗场景 | H3 | 更好的时间逻辑 |
全身动作 | H3 | 更强的动作一致性 |
多角色互动 | H3 | 更好的场景关系 |
物体操作 | H3 | 更强的物理表现倾向 |
多参考生成 | H3 | 密集多模态控制 |
快速构思 | LTX 2.5 | 更快迭代 |
批量生成 | LTX 2.5 | 更高吞吐量 |
简单视觉镜头 | LTX 2.5 | 较低时间成本下的高质量 |
4K/HDR后期 | LTX 2.5 | 更强制作工具链 |
本地流水线 | LTX 2.5 | 更完整生态 |
动作密集的主打镜头 | H3 | 时间质量值得算力投入 |
动作+高分辨率交付 | H3+LTX 2.5 | 最佳职责分工 |
实用决策规则很简单:如果镜头因动作错误而失败,从 H3 开始;如果工作流因迭代或后期过贵而失败,从 LTX 2.5 开始;如果两者都重要,就结合使用。
常见问题
H3 的质量比 LTX 2.5 更好吗?
当质量取决于动作、物理、物体互动、镜头逻辑或复杂指令执行时,H3 通常更强。LTX 2.5 在画面锐度和较简单场景中仍能保持很强竞争力。因此,最有用的比较是时间质量与空间质量,而非单一总分。
为什么 LTX 2.5 比 H3 更快?
已审阅工作流显示,LTX 通过低步数采样和分阶段分辨率处理,大幅减少扩散总工作量。在一项 DGX Spark 分析中,估算工作量约为LTX 70,400个token步,H3 651,200个token步,而每token每步执行时间接近得多。
H3 与 LTX 2.5 可以在消费级GPU上本地运行吗?
可以,两者都能本地运行,但实际要求不同。H3 对内存和推理时间的要求更高,LTX 2.5 的本地工具链则更适合制作。GPU是否合适取决于显存、量化、分辨率、时长和工作流配置,而非仅看模型名称。
应该结合使用 H3 和 LTX 2.5 吗?
对于动作密集又需要高分辨率交付的镜头,应该。H3 可在适中分辨率下解决困难的时间阶段,LTX 负责放大与细化。代价是生成式细化可能改变身份敏感细节,因此应仔细检查最终输出。
结论
MiniMax H3 与 LTX 2.5 针对不同制作瓶颈进行优化。当复杂动作、物理、镜头逻辑、参考素材或场景理解决定镜头是否成功时,H3 更强;LTX 2.5 更适合快速迭代、批量制作、本地工作流和高分辨率后期。RTX 5060 Ti、RTX 5090和DGX Spark案例确认了 LTX 显著的工作流速度优势,token步数分析则解释了为何这种优势大于仅按每token计算量得到的差异。因此,对于专业创作者,最佳策略不是选择永久赢家,而是将每项任务交给能最有效解决它的模型;当镜头兼需两者时,采用H3 负责时间维度生成,LTX 2.5 负责细化的组合。