MiniMax H3 と LTX 2.5 の比較:品質、速度、実際のベンチマーク
 Yifan Zhao読了 12 分 ·
MiniMax H3は複雑な動作、物理、場面の論理、カメラの振り付け、参照の多い生成に適し、LTX 2.5 は速度、素早い反復、高解像度の仕上げに優れています。MiniMax H3 をどこで使うかを決める際に有用なのは、どのモデルが常に優れているかではなく、必要な動画の種類でどちらが早く使用可能なショットに到達するかです。
この違いは制作コストに大きく影響します。調査したMiniMax H3 ワークフローでは、ある RTX 5090 テストで LTX 2.5 が約6.8倍、DGX Spark では約14倍速い結果でした。それでも、動作や物理的な相互作用がショットの成否を決める場合には、H3 の魅力が上回りました。そのため本調査では、単一モデルを勝者にするよりも、タスクに応じたAIモデルの使い分けを支持します。
Virseは、この複数モデルを使う働き方のために設計されています。モデルを別々のチャットツールに分けず、デザイナーが共有ビジュアルキャンバス上で複数のAIエージェントと作業し、プロジェクトのアセットと文脈をタスク間で引き継げます。このつながった環境は、より広範な指示書から納品までのAIデザインワークフローを支えます。有料プランには、Nano Banana 2 と GPT Image 2 を含む40以上のモデルの無制限利用と、無制限の席数が含まれます。新規ユーザーには登録クレジットも付与され、Nano Banana 2 の画像最大10枚、または Seedance 2.0 の動画1本に使えます。
MiniMax H3 と LTX 2.5:主な違いは?
H3 と LTX 2.5 の最大の違いは、どこに計算資源を使い、どこで制作上の価値を生むかです。
項目 | MiniMax H3 | LTX 2.5 |
|---|---|---|
モデル規模 | 33B | 22B |
複雑な動作 | 強い | ばらつきが大きい |
物理と相互作用 | 強い | 難しいシーンでは安定性が低い |
複雑なプロンプトの実行 | 強い傾向 | 改善したが、失敗は残る |
素早い反復 | 遅い | 優秀 |
テストしたステップ構成 | 一般に約20 | 8ステップ蒸留ワークフロー |
高解像度の仕上げ | より高コスト | 大きな強み |
複数参照の制御 | 大きな強み | ワークフローの重点が異なる |
ローカル制作環境 | 対応するが要求は高い | より充実 |
最適な役割 | 動作重視の生成 | 反復、アップスケール、仕上げ |
プロダクトデザインの観点では、H3 は多くの計算資源を使う専門家のように振る舞い、LTX 2.5 は制作エンジンに近い役割を果たします。
この違いは静止フレームの比較より有用です。鮮明な動画でも、途中で物体が消えれば失敗になります。一方、単純な製品の公開演出には高度な動作モデルが不要な場合もあります。
MiniMax H3 と LTX 2.5 の品質:動作と物理に優れるのは?
品質比較で最も明確なのは、時間的な品質と空間的な品質を分けることです。
動作がショットの成否を決める場面では H3 が強い
本稿のMiniMax H3 レビューでは、次の用途で H3 の魅力が繰り返し確認されました:
- 格闘と走行
- 全身の動作
- 複数人物のやり取り
- 物体の操作
- 物理的な因果関係
- 映画的なカメラ移動
- 複数の連続動作を含むプロンプト
ここで重要な失敗は、最初のフレームの悪さではなく、時間的な論理の破綻です。手が物体を突き抜ける、小道具が消える、速い動きで人体構造が崩れる、要求した動作が一部しか完了しない、といった問題です。
そのため、動きの多い見せ場のショットでは、再生成を減らせるなら遅い生成の方が全体として安くなる場合があります。
LTX 2.5 は空間的な細部でも競争力を保つ
LTX 2.5 を単純に低品質と呼ぶべきではありません。調査した複数の事例では、フレームの鮮明さ、小物体の安定性、衣服の細部、煙、局所的な質感で出力が好まれました。
そのため LTX は、製品ショット、ゆっくりしたカメラ移動、雰囲気を重視するクリップ、物理的な相互作用の少ないシーンに魅力があります。
実用的な結論は単純です。H3 は時間的品質でより強い優位性を持ち、LTX 2.5 は空間的品質で高い競争力を保てます。
LTX 2.5 と H3 の速度:実ワークフローのベンチマークは何を示すか?
調査したすべての定量事例で、LTX 2.5 の方が高速でした。
ハードウェアと出力 | H3 | LTX 2.5 | 結果 |
|---|---|---|---|
RTX 5060 Ti、約12秒、約0.6MP | 29分 | 18分 | LTX は約11分短縮 |
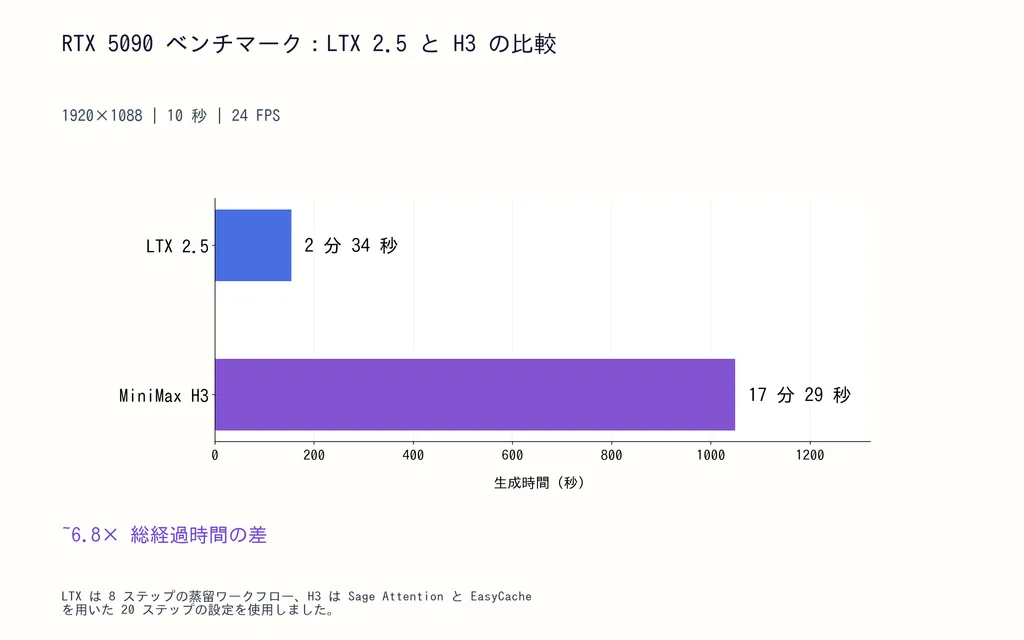
RTX 5090、1920×1088、10秒、24 FPS | 17分29秒 | 2分34秒 | 約6.8倍高速 |
DGX Spark、1280×704、5秒、24 FPS | 866秒 | 61.89秒 | 約14倍高速 |
これらはワークフローのベンチマークであり、モデル速度の普遍的な倍率ではありません。
RTX 5060 Ti の事例:29分と18分
RTX 5060 Ti の事例では、約12秒、0.6MPの生成で LTX が約11分短縮しました。
ただし、調査した品質評価では、物理、カメラ移動、美観、指示の正確さで H3 が好まれました。
この事例は、生成時間だけでは不十分であることを示します。単純なクリップでは LTX の時間短縮が決め手になりえますが、難しい動作では H3 が少ない修正で使える結果に到達する可能性があります。
RTX 5090 の事例:2分34秒と17分29秒
1920×1088、10秒、24 FPSを目標とした場合:
LTX 2.5:2分34秒
H3:17分29秒
これは約6.8倍の実経過時間の差です。
ただし構成は同一ではありません。LTX は8ステップの蒸留ワークフロー、H3 は Sage Attention と EasyCache を使う20ステップでした。したがって正しい解釈は、テストした LTX ワークフローが6.8倍速く完了したのであり、Transformer 自体が本質的に6.8倍高速ということではありません。
DGX Spark の事例:61.89秒と866秒
DGX Spark で1280×704、5秒、24 FPS、音声付きのワークフローにかかった時間:
LTX 2.5:61.89秒
H3:866秒
観測された差は約14倍でした。
処理量の分析はさらに示唆的です。推定トークン・ステップ処理量は約LTX が70,400、H3 が651,200で、約9.25倍の差でした。一方、トークン・ステップあたりの実行時間はずっと近く、約LTX が0.879ミリ秒、H3 が0.959ミリ秒でした。
つまり最大の利点は、拡散の総処理量が大幅に少ないことにあり、モデルの中核が14倍速いことではありません。
LTX 2.5 が H3 より速い理由は?
LTX 2.5 は、少ないステップの推論、段階的な解像度処理、少ないトークン処理量で高速化しています。
LTX は最終解像度の前に拡散の大半を行う
調査したある LTX ワークフローでは、約640×352で8ステップ生成し、潜在空間で2倍にアップスケールしてから、高解像度での調整を数ステップだけ行いました。
フル解像度の動画拡散は高コストなので、この違いは重要です。LTX はサンプリング全体でそのコストを払い続けることを避けています。
H3 も CFG 蒸留されているため、速度差を単純化してはいけません。「蒸留済み LTX 対未蒸留 H3」ではなく、LTX の少ステップ制作戦略と、少ない総トークン・ステップ処理量が重要な違いです。
H3 は解像度が上がると高コストになる
ある H3 の DGX Spark テストでは:
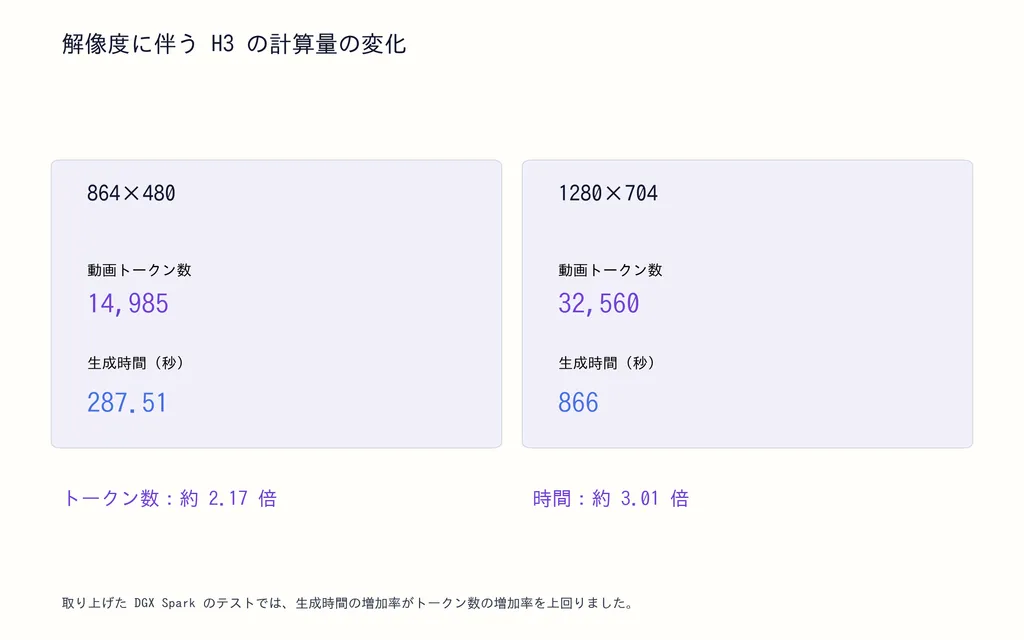
864×480:14,985トークン、287.51秒
1280×704:32,560トークン、866秒
トークン数は約2.17倍になりましたが、生成時間は約3.01倍になりました。
そのため、H3 を直接高解像度にすると高コストになりやすく、動作の生成と仕上げを分けることに意味があります。
H3 と LTX 2.5 の量子化:NVFP4 が INT8 をわずかに上回っただけなのはなぜか?
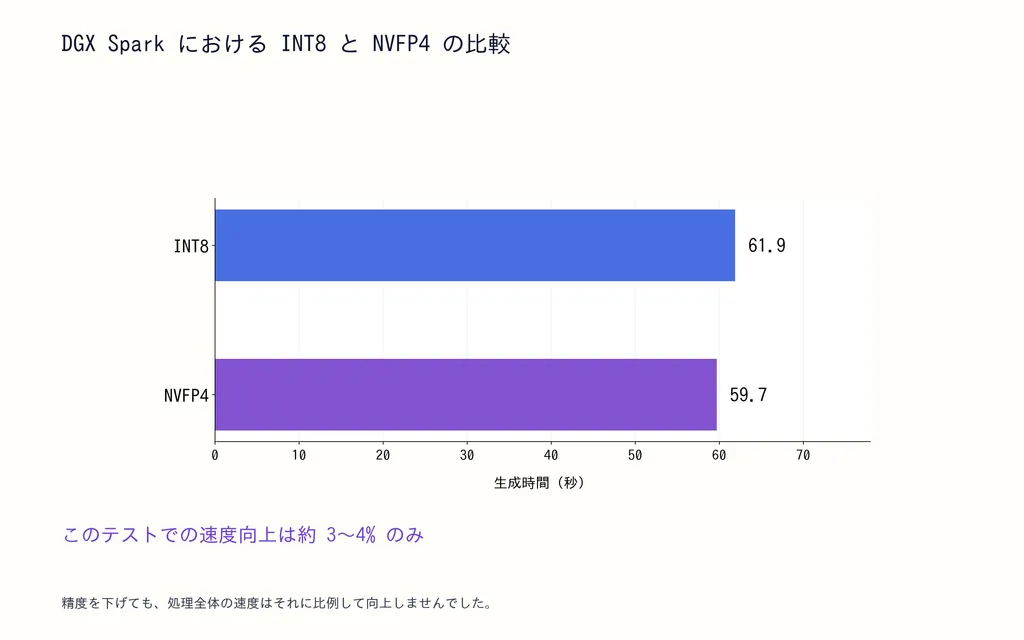
ある DGX Spark 比較でのおおよその測定値:
INT8:61.9秒
NVFP4:59.7秒
これはわずか約3~4%の改善です。
実用的な教訓は、精度を下げても全工程の速度が比例して向上するとは限らないことです。カーネル対応、メモリの挙動、テンソル配置、モデル読み込み、フレームワークの成熟度がボトルネックになりえます。
ローカルワークフローでは、ビット深度だけで選ばず、実際のハードウェア環境で量子化形式を測定しましょう。
MiniMax H3 と LTX 2.5:ローカル導入と一般向けGPU
両モデルともローカル実行できますが、現時点では LTX 2.5 の方が再現可能なローカル制作パイプラインを構築しやすい状態です。
H3 はローカル実行できるが、ハードウェアの制約が重要
調査したユーザーの質問には、RTX 3060 12GB、RTX 3090 24GB、RTX 5090、8GBカード、DGX Spark が繰り返し登場しました。
本当の問題は H3 がローカルかどうかではなく、解像度、量子化、メモリ、生成時間でどれだけ妥協が必要かです。
24GB級GPUは8GBや12GBのハードウェアより大幅に柔軟ですが、現在の調査には標準化された H3 のGPU比較表はありません。したがって、個別システムの結果から具体的な速度や解像度を一般的に保証するべきではありません。
LTX 2.5 は仕上げのエコシステムが充実
調査した LTX 環境には、量子化チェックポイント、VAEワークフロー、LoRA、ComfyUI対応、空間アップスケール、時間方向のアップスケール、高解像度仕上げが含まれます。
周辺のエコシステムが重要なのは、プロの制作が1回の生成だけではないからです。発想、選別、調整、アップスケール、確認、納品という工程があります。
H3 と LTX 2.5:2K、4K、HDR、プロ向け仕上げ
高解像度制作では、最も明確な違いの1つが表れます。
H3 のワークフローには、H3-Context-IR、H3-Base、H3-Regenerate-2Kが含まれます。H3-Base はローカル実行できますが、高解像度の全工程はそれほど自己完結していません。
LTX 2.5 は、空間的・時間的な調整、4K向けの仕上げ、HDR、EXR向け出力、ローカルでの反復作業を必要とするチームにより適しています。
プロの動画制作では、すべてのピクセルに H3 の最大計算量を使うことは避けたいところです。動作に必要な箇所へ高コストな時間的推論を使い、仕上げは効率的なパイプラインへ渡します。
H3 と LTX 2.5:音声、参照、複数ショットのワークフロー
これも両モデルが異なる領域です。
H3 は密度の高いマルチモーダル参照制御に強い
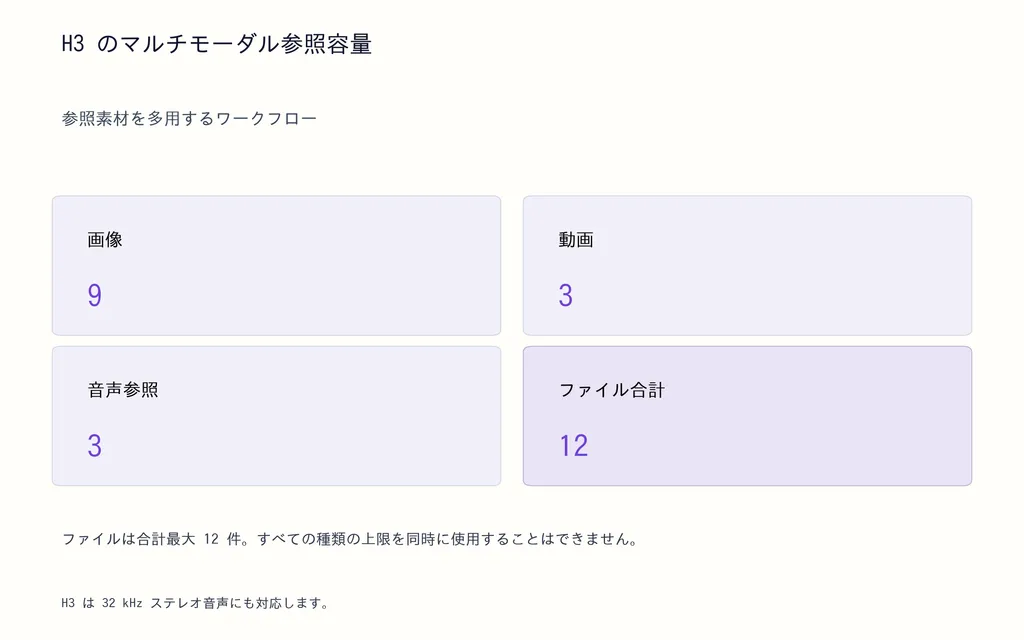
H3 は32 kHzのステレオ音声と、画像・動画・音声入力を含む参照の多いワークフローに対応します。調査した仕様では、画像最大9枚、動画3本、音声参照3件に対応しますが、ファイルの合計上限が適用されます。
複数の入力にわたって人物、物体、動作、音声の文脈を保持したいショットでは、H3 が特に魅力的になります。
LTX 2.5 は構造化された制作シーケンス向け
LTX 2.5 の制作上の方向性は、音声と動画の同期ワークフロー、効率的な長尺の反復、複数ショット向け生成を重視しています。
複数のつながったクリップを制作するチームでは、密な参照制御より重要になる場合があります。ボトルネックが単一ショットの忠実度から、再現可能なシーケンス制作へ移るためです。
H3+LTX 2.5 ワークフロー:併用が有利になる理由
最も役立つ制作戦略は、最初に H3、次に LTXかもしれません。
H3 が動作重視の生成を担当
本稿のMiniMax H3 ワークフロー調査には、約0.4MPの H3 ワークフロー、Turbo LoRA 構成、8ステップの実験、640×384の元クリップが含まれます。
この段階で重視するもの:
- 動作
- 相互作用
- 物理
- カメラの挙動
- 時間的連続性
LTX がアップスケールと調整を担当
最良の H3 出力を選んだら、LTX で2倍アップスケール、空間・時間方向の調整、または高解像度での納品を行います。
この分担により、H3 は時間的な知能、LTX は制作効率に集中できます。
主なリスクは生成による再解釈です。調整中に顔、製品、ロゴ、衣装、細部が変わる可能性があるため、同一性が重要な作業では視覚的な品質確認が必要です。
MiniMax H3 と LTX 2.5 の商用ライセンス:チームが確認すべきことは?
視覚的な品質より先に、ライセンスが選択を決めることがあります。
調査した H3 ライセンスでは、標準の Community License は米国、EU、英国、韓国を対象外とし、大規模な商用導入には追加の収益条件と帰属表示条件があります。
調査した LTX ライセンスは対象地域が広いものの、大規模な商用利用者にはライセンスの基準や法的制約が適用される場合があります。
重要な原則は、重みが公開されていても商用権利が無制限とは限らないことです。
企業チームは導入前に、地域、年間収益、再配布、帰属表示、製品への統合、現在のライセンス版を確認するべきです。
MiniMax H3 と LTX 2.5 の判断表
制作シナリオ | 最適な出発点 | 理由 |
|---|---|---|
複雑な格闘シーン | H3 | より優れた時間的論理 |
全身の動作 | H3 | より強い動作の一貫性 |
複数人物のやり取り | H3 | より適切なシーン内の関係 |
物体の操作 | H3 | 物理に強い傾向 |
複数参照からの生成 | H3 | 密度の高いマルチモーダル制御 |
素早い発想 | LTX 2.5 | より速い反復 |
バッチ生成 | LTX 2.5 | より高い処理量 |
単純な映像ショット | LTX 2.5 | 少ない時間コストで高品質 |
4K/HDR仕上げ | LTX 2.5 | より強力な制作環境 |
ローカルパイプライン | LTX 2.5 | より充実したエコシステム |
動きの多い見せ場のショット | H3 | 時間的品質が計算コストに見合う |
動作+高解像度納品 | H3+LTX 2.5 | 最適な役割分担 |
実用的な判断は単純です。動作が誤ってショットが失敗するなら H3 から始めます。反復や仕上げが高すぎて工程が回らないなら LTX 2.5 から始めます。両方が重要なら併用します。
よくある質問
品質では H3 が LTX 2.5 より優れているか?
動作、物理、物体の相互作用、カメラの論理、複雑な指示実行が品質を決めるなら、H3 は一般に強い選択肢です。LTX 2.5 はフレームの鮮明さや単純なシーンで高い競争力を保てます。したがって最も役立つ比較は、時間的品質と空間的品質であり、単一の総合点ではありません。
LTX 2.5 が H3 より速い理由は?
調査したワークフローでは、LTX は少ステップのサンプリングと段階的な解像度処理により、拡散の総処理量を大幅に減らしています。ある DGX Spark 分析での推定処理量は約LTX が70,400トークン・ステップ、H3 が651,200トークン・ステップで、トークン・ステップあたりの実行時間はずっと近い値でした。
H3 と LTX 2.5 は一般向けGPUでローカル実行できるか?
はい、両方ともローカル実行できますが、実際の要件は異なります。H3 はメモリと推論時間の要求が大きく、LTX 2.5 は制作向けのローカル環境が充実しています。GPUの適性はモデル名だけでなく、VRAM、量子化、解像度、時間、ワークフロー構成で決まります。
H3 と LTX 2.5 を併用するべきか?
動きが多く、高解像度納品も必要なショットなら、はい。H3 が中程度の解像度で難しい時間的処理を担い、LTX がアップスケールと調整を担当できます。ただし生成による調整が同一性に関わる細部を変える可能性があるため、最終出力は注意深く確認する必要があります。
結論
MiniMax H3 と LTX 2.5 は、異なる制作上のボトルネックに最適化されています。複雑な動作、物理、カメラの論理、参照、シーン理解が成否を決めるなら H3 が強く、LTX 2.5 は素早い反復、バッチ制作、ローカルワークフロー、高解像度仕上げに適します。RTX 5060 Ti、RTX 5090、DGX Spark の事例は LTX の大きなワークフロー速度の利点を示し、トークン・ステップ分析は、その差がトークン単位の計算速度だけの差を上回る理由を説明します。プロの制作者にとって最適なのは、恒久的な勝者を1つ選ぶことではなく、各タスクを最も効率的に解決するモデルへ振り分け、両方を要するショットでは、時間的な生成を H3、調整を LTX 2.5で行う戦略です。