
MiniMax H3 frente a LTX 2.5: calidad, velocidad y pruebas reales
 Yifan Zhao13 min de lectura ·
MiniMax H3 es mejor para movimiento complejo, física, lógica de escena, coreografía de cámara y generación con muchas referencias, mientras LTX 2.5 destaca en velocidad, iteración rápida y acabado de alta resolución. Si decides dónde usar MiniMax H3, la pregunta útil no es qué modelo es mejor universalmente, sino cuál logra antes un plano utilizable para el tipo de vídeo que necesitas.
Esa diferencia puede salir cara en producción. En los flujos de MiniMax H3 revisados, LTX 2.5 fue unas 6,8 veces más rápido en una prueba RTX 5090 y unas 14 veces en DGX Spark; aun así, H3 seguía resultando más convincente cuando el movimiento o la interacción física decidían el éxito del plano. Por ello, favorecemos asignar modelos de IA según la tarea en vez de elegir un único ganador.
Virse está diseñado para trabajar con varios modelos. En vez de separarlos en herramientas de chat aisladas, permite a los diseñadores trabajar con varios agentes de IA en un lienzo visual compartido, llevando recursos y contexto entre tareas. Este entorno conectado respalda un flujo de diseño con IA más amplio, desde el encargo hasta la entrega. Los planes de pago incluyen uso ilimitado de más de 40 modelos, como Nano Banana 2 y GPT Image 2, y puestos ilimitados. Los nuevos usuarios reciben créditos de registro para hasta 10 imágenes de Nano Banana 2 o un vídeo de Seedance 2.0.
MiniMax H3 frente a LTX 2.5: ¿cuáles son las diferencias principales?
H3 y LTX 2.5 se diferencian sobre todo en dónde invierten cómputo y dónde aportan valor de producción.
Área | MiniMax H3 | LTX 2.5 |
|---|---|---|
Tamaño del modelo | 33B | 22B |
Movimiento complejo | Sólido | Más variable |
Física e interacción | Sólido | Menos fiable en escenas difíciles |
Ejecución de instrucciones complejas | Tendencia sólida | Mejorado, pero aún falla |
Iteración rápida | Lento | Excelente |
Patrón de pasos probado | Normalmente unos 20 | Flujo destilado de 8 pasos |
Acabado de alta resolución | Más caro | Gran fortaleza |
Control de varias referencias | Gran fortaleza | Enfoque de flujo distinto |
Conjunto de producción local | Compatible, pero exigente | Más completo |
Mejor función | Generación con movimiento crítico | Iteración, ampliación, acabado |
Desde el diseño de producto, H3 se comporta como un especialista de alto cómputo, mientras LTX 2.5 se parece más a un motor de producción.
Esta distinción es más útil que comparar fotogramas fijos. Un vídeo nítido puede fallar si un objeto desaparece a mitad del plano, mientras un modelo sofisticado de movimiento puede ser innecesario para presentar un producto de forma sencilla.
Calidad de MiniMax H3 frente a LTX 2.5: ¿cuál destaca en movimiento y física?
La forma más clara de comparar calidad es separar la calidad temporal de la calidad espacial.
H3 es más fuerte cuando el movimiento decide si un plano funciona
Nuestra evaluación de MiniMax H3 encontró repetidamente que H3 resulta más convincente para:
- peleas y carreras
- movimiento de cuerpo completo
- interacción entre varios personajes
- manipulación de objetos
- causa y efecto físicos
- movimientos cinematográficos de cámara
- instrucciones con varias acciones consecutivas
El fallo importante aquí no es un mal primer fotograma, sino la ruptura de la lógica temporal: una mano atraviesa un objeto, desaparece un accesorio, la anatomía se deforma con movimientos rápidos o la acción pedida queda incompleta.
Por tanto, en planos principales con mucho movimiento, una generación más lenta puede salir más barata en conjunto si reduce las regeneraciones.
LTX 2.5 sigue siendo competitivo en detalle espacial
No debe describirse LTX 2.5 como simplemente inferior en calidad. En varios casos revisados, se prefirieron sus resultados por nitidez de fotogramas, estabilidad de objetos pequeños, detalle de ropa, humo y textura local.
Esto hace atractivo a LTX para planos de producto, movimientos lentos de cámara, clips atmosféricos y escenas con poca interacción física.
La conclusión práctica es sencilla: H3 tiene una ventaja mayor en calidad temporal, mientras LTX 2.5 puede seguir siendo muy competitivo en calidad espacial.
Velocidad de LTX 2.5 frente a H3: ¿qué muestran las pruebas reales de flujo?
En todos los casos cuantitativos de nuestra investigación, LTX 2.5 fue más rápido.
Hardware y salida | H3 | LTX 2.5 | Resultado |
|---|---|---|---|
RTX 5060 Ti, ~12 s, ~0,6 MP | 29 min | 18 min | LTX ahorra ~11 min |
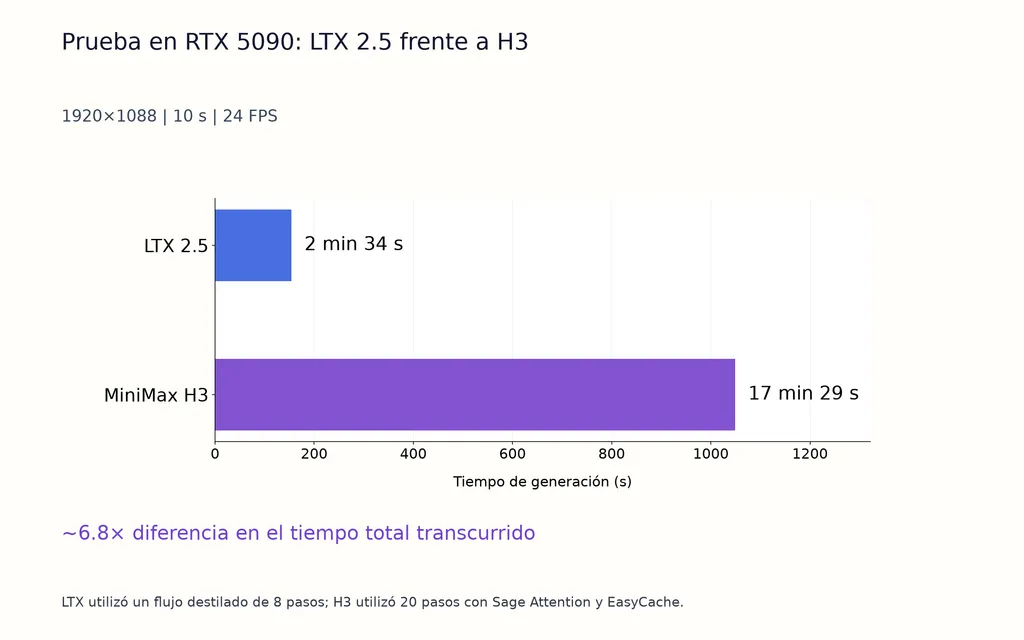
RTX 5090, 1920×1088, 10 s, 24 FPS | 17 min 29 s | 2 min 34 s | ~6,8 veces más rápido |
DGX Spark, 1280×704, 5 s, 24 FPS | 866 s | 61,89 s | ~14 veces más rápido |
Son pruebas de flujos de trabajo, no multiplicadores universales de velocidad de modelos.
Caso RTX 5060 Ti: 29 frente a 18 minutos
En el caso RTX 5060 Ti, LTX ahorró unos 11 minutos en una generación de aproximadamente 12 segundos y 0,6 MP.
Sin embargo, la evaluación de calidad revisada favoreció a H3 en física, movimiento de cámara, estética y precisión de instrucciones.
El caso muestra por qué el tiempo bruto de generación no basta. En clips sencillos, el ahorro de LTX puede dominar. En movimientos difíciles, H3 aún puede lograr un resultado utilizable con menos correcciones.
Caso RTX 5090: 2:34 frente a 17:29
Para una salida de 1920×1088, 10 segundos y 24 FPS:
LTX 2.5: 2 min 34 s
H3: 17 min 29 s
Eso supone una diferencia de tiempo real de unas 6,8 veces.
Pero las configuraciones no eran idénticas. LTX usó un flujo destilado de 8 pasos y H3, 20 pasos con Sage Attention y EasyCache. La interpretación correcta es que el flujo LTX probado terminó 6,8 veces más rápido, no que su transformer sea intrínsecamente 6,8 veces más rápido.
Caso DGX Spark: 61,89 frente a 866 segundos
En DGX Spark, un flujo de 1280×704, cinco segundos y 24 FPS con audio tardó:
LTX 2.5: 61,89 segundos
H3: 866 segundos
La diferencia observada fue de unas 14 veces.
El análisis de carga es más revelador. El trabajo estimado en token-pasos fue de unos 70.400 para LTX frente a 651.200 para H3, una diferencia de aproximadamente 9,25 veces. La ejecución por token-paso fue mucho más cercana: unos 0,879 ms para LTX y 0,959 ms para H3.
Por tanto, la mayor ventaja viene de hacer mucho menos trabajo total de difusión, no de un núcleo de modelo 14 veces más rápido.
¿Por qué LTX 2.5 es más rápido que H3?
LTX 2.5 gana velocidad mediante inferencia de pocos pasos, procesamiento por etapas de resolución y menor carga de tokens.
LTX realiza la mayor parte de la difusión antes de la resolución final
Un flujo LTX revisado generó a unos 640×352 durante ocho pasos, aplicó ampliación latente 2× y usó solo unos pocos pasos de refinamiento en alta resolución.
Esto importa porque la difusión de vídeo a resolución completa es cara. LTX evita asumir ese coste durante todo el muestreo.
H3 también está destilado con CFG, así que la diferencia de velocidad no debe reducirse a «LTX destilado frente a H3 no destilado». La distinción útil es la estrategia de pocos pasos de LTX y su menor carga total de token-pasos.
H3 se encarece al aumentar la resolución
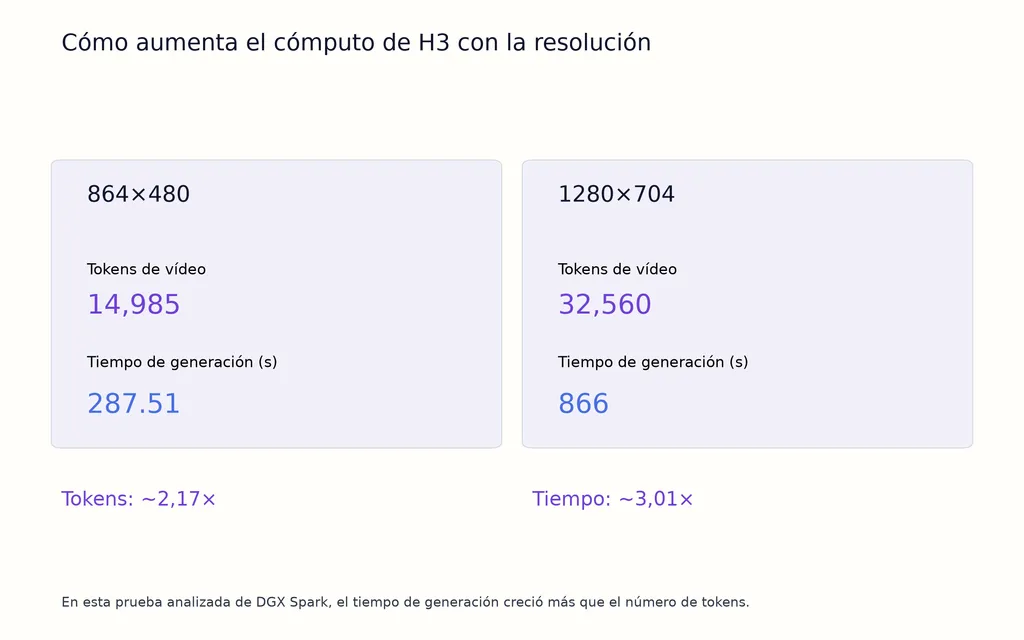
En una prueba H3 en DGX Spark:
864×480: 14.985 tokens, 287,51 segundos
1280×704: 32.560 tokens, 866 segundos
La cantidad de tokens aumentó unas 2,17 veces, pero el tiempo de generación aumentó unas 3,01 veces.
Por eso llevar H3 directamente a resoluciones mayores puede salir caro y separar la generación de movimiento del acabado puede tener sentido.
Cuantización H3 y LTX 2.5: ¿por qué NVFP4 apenas superó a INT8?
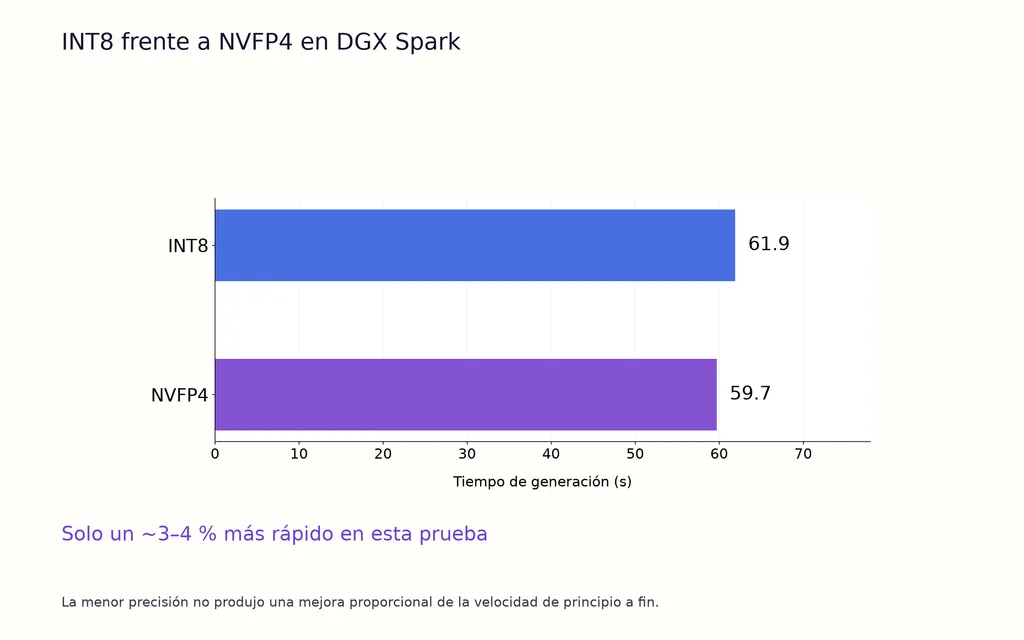
Una comparación en DGX Spark midió aproximadamente:
INT8: 61,9 segundos
NVFP4: 59,7 segundos
Eso supone solo una mejora de aproximadamente el 3–4 %.
La lección práctica es que menor precisión no garantiza mejoras proporcionales de velocidad total. La compatibilidad de kernels, el comportamiento de memoria, la disposición de tensores, la carga del modelo y la madurez del framework pueden ser cuellos de botella.
Para flujos locales, prueba el formato de cuantización en el hardware real en vez de elegir solo por profundidad de bits.
MiniMax H3 y LTX 2.5 para despliegue local y GPU de consumo
Ambos modelos pueden ejecutarse localmente, pero LTX 2.5 es actualmente más fácil de integrar en un flujo local de producción repetible.
H3 puede ejecutarse localmente, pero importan las limitaciones de hardware
En las preguntas revisadas aparecieron repetidamente RTX 3060 12GB, RTX 3090 24GB, RTX 5090, tarjetas de 8GB y DGX Spark.
La cuestión real no es si H3 es local, sino cuánto hay que sacrificar en resolución, cuantización, memoria y tiempo de generación.
Una GPU de 24GB ofrece mucha más flexibilidad que hardware de 8GB o 12GB, pero nuestra investigación no incluye una matriz estandarizada de GPU para H3. Por eso no deben generalizarse promesas de velocidad o resolución a partir de sistemas aislados.
LTX 2.5 tiene un ecosistema de acabado más sólido
El conjunto LTX revisado incluye checkpoints cuantizados, flujos VAE, LoRA, soporte ComfyUI, ampliación espacial, ampliación temporal y acabado de alta resolución.
Ese ecosistema importa porque la producción profesional no es un solo paso de generación. Incluye ideación, selección, refinamiento, ampliación, revisión y entrega.
H3 y LTX 2.5 para 2K, 4K, HDR y acabado profesional
La producción de alta resolución revela una de las diferencias más claras.
El flujo de H3 incluye H3-Context-IR, H3-Base y H3-Regenerate-2K. H3-Base puede ejecutarse localmente, pero el flujo completo de alta resolución es menos autosuficiente.
LTX 2.5 es más fuerte cuando los equipos necesitan refinamiento espacial y temporal, acabado orientado a 4K, HDR, salida orientada a EXR e iteración local repetida.
Para vídeo profesional, evitaría dedicar el máximo cómputo de H3 a cada píxel. Usa el razonamiento temporal caro donde lo requiera el movimiento y deja el acabado al flujo más eficiente.
H3 y LTX 2.5 para audio, referencias y flujos de varios planos
Este es otro ámbito en el que difieren los modelos.
H3 destaca en el control intensivo de referencias multimodales
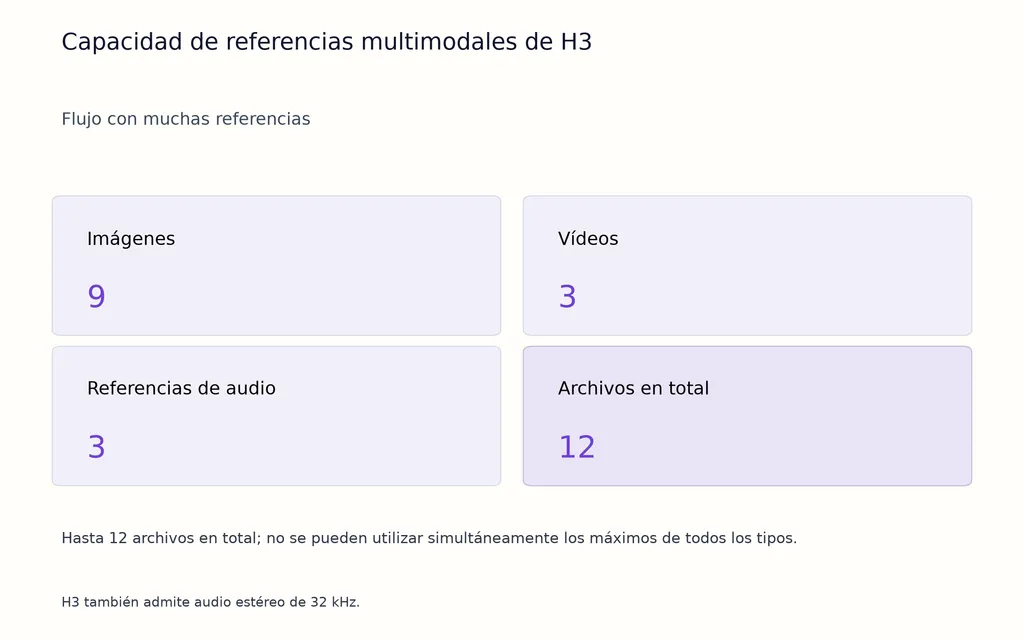
H3 admite audio estéreo de 32 kHz y un flujo intensivo en referencias con entradas de imagen, vídeo y audio. La especificación revisada incluye hasta nueve imágenes, tres vídeos y tres referencias de audio, sujetos a límites combinados de archivos.
Esto hace a H3 especialmente interesante cuando un plano debe preservar contexto de personaje, objeto, movimiento o audio entre varias entradas.
LTX 2.5 se adapta mejor a secuencias de producción estructuradas
La orientación de producción de LTX 2.5 enfatiza flujos de audio y vídeo sincronizados, iteración larga eficiente y generación orientada a varios planos.
Para equipos que producen varios clips conectados, esto puede importar más que el control denso de referencias, porque el cuello de botella pasa de la fidelidad de un plano a la producción repetible de secuencias.
Flujo H3 + LTX 2.5: por qué usar ambos puede ser mejor
La estrategia de producción más útil puede ser primero H3, después LTX.
H3 se ocupa de la generación con movimiento crítico
Nuestra investigación de flujos MiniMax H3 incluye flujos de H3 de unos 0,4 MP, configuraciones Turbo LoRA, experimentos de ocho pasos y clips fuente de 640×384.
En esta etapa, céntrate en:
- movimiento
- interacción
- física
- comportamiento de cámara
- continuidad temporal
LTX se ocupa de la ampliación y el refinamiento
Tras seleccionar el mejor resultado de H3, usa LTX para ampliación 2×, refinamiento espacial y temporal o entrega en mayor resolución.
Esta división centra H3 en la inteligencia temporal y LTX en la eficiencia de producción.
El riesgo principal es la reinterpretación generativa. Rostros, productos, logotipos, ropa y detalles pequeños pueden cambiar durante el refinamiento, por lo que los trabajos sensibles a la identidad requieren control visual de calidad.
Licencia comercial de MiniMax H3 y LTX 2.5: ¿qué deben revisar los equipos?
La licencia puede decidir la elección antes que la calidad visual.
En la licencia H3 revisada, la Community License estándar excluye EE. UU., la UE, Reino Unido y Corea del Sur, y los despliegues comerciales grandes están sujetos a condiciones adicionales de ingresos y atribución.
La licencia LTX revisada tiene mayor cobertura geográfica, pero los usuarios comerciales grandes aún pueden afrontar umbrales de licencia y restricciones legales.
La regla clave es: pesos abiertos no significa derechos comerciales sin restricciones.
Los equipos empresariales deben revisar ubicación geográfica, ingresos anuales, redistribución, atribución, integración en productos y versión actual de la licencia antes del despliegue.
Matriz de decisión de MiniMax H3 y LTX 2.5
Escenario de producción | Mejor punto de partida | Motivo |
|---|---|---|
Escena de pelea compleja | H3 | Mejor lógica temporal |
Acción de cuerpo completo | H3 | Mayor coherencia de movimiento |
Interacción entre varios personajes | H3 | Mejores relaciones de escena |
Manipulación de objetos | H3 | Mayor tendencia a una física correcta |
Generación con varias referencias | H3 | Control multimodal intensivo |
Ideación rápida | LTX 2.5 | Iteración más rápida |
Generación por lotes | LTX 2.5 | Mayor capacidad de procesamiento |
Planos visuales sencillos | LTX 2.5 | Buena calidad con menor coste de tiempo |
Acabado 4K/HDR | LTX 2.5 | Conjunto de producción más sólido |
Flujo local | LTX 2.5 | Ecosistema más completo |
Plano principal con mucho movimiento | H3 | La calidad temporal justifica el cómputo |
Movimiento + entrega en alta resolución | H3 + LTX 2.5 | Mejor reparto de responsabilidades |
La regla práctica es sencilla: si el plano falla por el movimiento, empieza con H3. Si el flujo falla por el coste de iteración o acabado, empieza con LTX 2.5. Si ambos importan, usa los dos.
Preguntas frecuentes
¿Tiene H3 mejor calidad que LTX 2.5?
H3 suele ser más fuerte cuando la calidad depende de movimiento, física, interacción de objetos, lógica de cámara o ejecución de instrucciones complejas. LTX 2.5 puede seguir siendo muy competitivo en nitidez y escenas sencillas. La comparación más útil es, por tanto, calidad temporal frente a calidad espacial, no una puntuación global única.
¿Por qué LTX 2.5 es más rápido que H3?
Los flujos revisados muestran que LTX realiza mucho menos trabajo total de difusión mediante muestreo de pocos pasos y resolución por etapas. En un análisis DGX Spark, la carga estimada fue de unos 70.400 token-pasos para LTX frente a 651.200 para H3, mientras la ejecución por token-paso era mucho más cercana.
¿Pueden H3 y LTX 2.5 ejecutarse localmente en GPU de consumo?
Sí, ambos pueden ejecutarse localmente, pero los requisitos prácticos difieren. H3 exige más memoria y tiempo de inferencia, mientras LTX 2.5 tiene un conjunto local más orientado a producción. La idoneidad de la GPU depende de VRAM, cuantización, resolución, duración y configuración del flujo, no solo del nombre del modelo.
¿Debería usar H3 y LTX 2.5 juntos?
Para planos con mucho movimiento que también necesitan entrega en alta resolución, sí. H3 puede resolver la fase temporal difícil a resolución moderada y LTX encargarse de la ampliación y el refinamiento. La contrapartida es que el refinamiento generativo puede alterar detalles sensibles a la identidad, por lo que hay que revisar cuidadosamente el resultado final.
Conclusión
MiniMax H3 y LTX 2.5 están optimizados para distintos cuellos de botella de producción. H3 es mejor cuando movimiento complejo, física, lógica de cámara, referencias o comprensión de escena determinan el éxito; LTX 2.5 encaja mejor en iteración rápida, producción por lotes, flujos locales y acabado de alta resolución. Los casos RTX 5060 Ti, RTX 5090 y DGX Spark confirman una gran ventaja de velocidad del flujo LTX, y el análisis de token-pasos explica por qué supera la diferencia de cómputo por token. Para profesionales, la estrategia más sólida no es elegir un ganador permanente, sino asignar cada tarea al modelo que la resuelva más eficientemente y usar H3 para generación temporal y LTX 2.5 para refinamiento cuando el plano necesite ambas cosas.
Más del blog de Virse
Producto
GPT Image 2.5 Resolution Explained: Can It Generate True 4K Images?
9 de octubre de 2026 by Yifan Zhao
Producto
GPT Image 2.5 Quality Settings Explained: Low vs Medium vs High vs XHigh vs Max
9 de octubre de 2026 by Yifan Zhao
Producto
What Is Product Design in 2026? What Product Designers Actually Do
21 de septiembre de 2026 by Vincent