
Flujo de MiniMax H3: soluciona OOM, audio ininteligible y renderizados lentos
Vincent11 min de lectura ·
El mejor flujo de ComfyUI para MiniMax H3 usa FL2VA para T2V, I2V y generación con fotogramas inicial y final, cambia a Ref2VA cuando las referencias deben controlar identidad, movimiento, cámara o voz, y separa las previsualizaciones rápidas del renderizado final. La producción fiable con H3 depende de la selección del modelo, la estructura de referencias, la gestión de RAM/VRAM y la calidad del audio nativo, en lugar de un grafo «perfecto».
La dificultad aparece al ampliar los proyectos. Varias imágenes, referencias de movimiento, audio, prompts, previsualizaciones y renderizados finales fragmentan rápidamente los flujos, lo que dificulta conservar la identidad, comparar generaciones, controlar la memoria y mantener la continuidad. Nuestra revisión de casos de flujos H3 reveló que reducir el coste de iteración sin dañar el audio es una de las decisiones de equilibrio más importantes de la producción.
Virse aborda esta carencia más amplia del flujo al incorporar agentes de IA a un lienzo infinito.Los diseñadores pueden organizar recursos, conectar el contexto creativo, ejecutar varios agentes en paralelo y trabajar con preferencias de marca compartidas y conocimientos del proyecto. En lugar de sustituir a los diseñadores con generación en un clic, Virse ayuda a equipos creativos profesionales a hacer la producción asistida por IA más estructurada, repetible y escalable. MiniMax H3, Seedance 2.5 y Seedance 2.0 ya están disponibles en Virse, para explorar y comparar varios modelos de vídeo líderes en un mismo flujo creativo.
¿Cuál es el mejor flujo de MiniMax H3 en ComfyUI?
Un flujo de MiniMax H3 listo para producción debe separar la exploración del renderizado final. Renderizar cada semilla a resolución completa antes de saber si funcionan la composición, el movimiento, la identidad o la dirección de cámara desperdicia tiempo de GPU. La investigación revisada para esta guía confirma que estas son las rutas oficiales principales del flujo.
Usa un flujo H3 de previsualización a resultado final
Una secuencia práctica es:
- Define el plano — duración, relación de aspecto, sujeto, cámara y restricciones visuales imprescindibles.
- Elige FL2VA o Ref2VA según el tipo de control necesario.
- Asigna un papel a cada referencia antes de generar.
- Genera varias previsualizaciones de menor resolución para comparar composición y movimiento.
- Selecciona la mejor semilla y dirección.
- Restaura los ajustes de calidad final para el plano aprobado.
- Amplía o regenera solo los resultados aprobados.
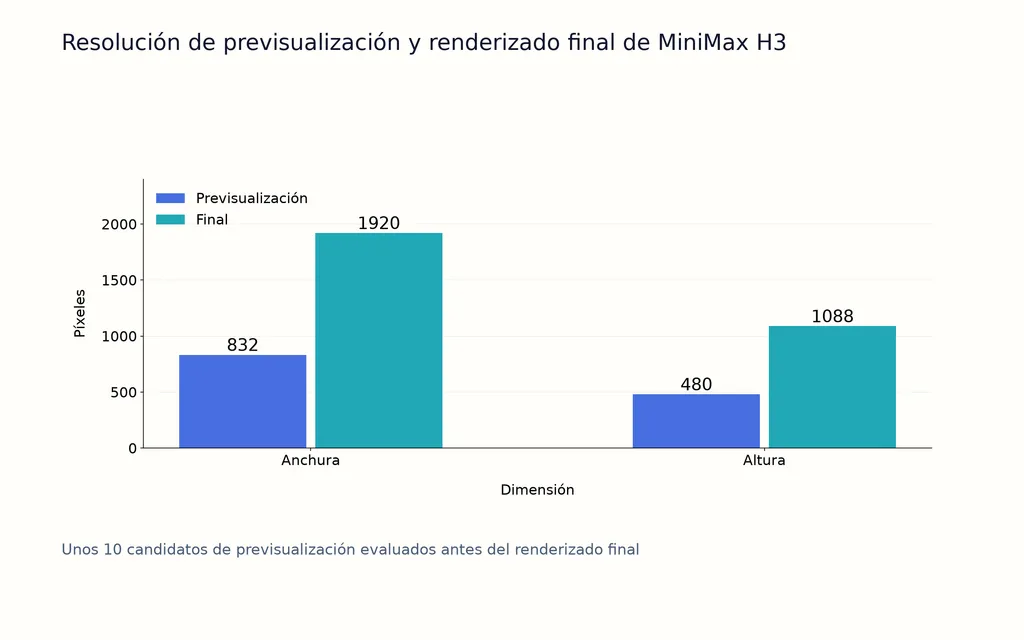
Un flujo documentado utilizó previsualizaciones de aproximadamente 832 × 480 antes de un renderizado final a 1920 × 1088, lo que permitió evaluar primero unos diez candidatos rápidos. En otro caso, reducir el muestreo de 20 a 10 pasos provocó cambios visuales relativamente modestos, pero empeoró notablemente el audio nativo.
La lección práctica es bajar la resolución de previsualización antes de reducir drásticamente los pasos, sobre todo cuando importan el diálogo o el sonido sincronizado.
Cómo configurar MiniMax H3 en ComfyUI
El flujo oficial H3 de ComfyUI se organiza en torno a T2V, I2V y R2V, con FL2VA y Ref2VA para distintas necesidades de generación. La investigación revisada para esta guía confirma que estas son las rutas oficiales principales.
¿Con qué flujo H3 deberías empezar?
Empieza por la ruta más sencilla que satisfaga el plano:
- T2V: FL2VA
- I2V con una imagen: FL2VA
- Fotograma inicial + final: FL2VA
- Referencia de identidad: Ref2VA
- Referencia de movimiento o cámara: Ref2VA
- Referencia de audio o voz: Ref2VA
- Control combinado de imagen + vídeo + audio: Ref2VA
Evita cargar ambas ramas grandes del modelo solo porque un grafo híbrido lo permite. Simplificar el modelo reduce la presión sobre la memoria y facilita diagnosticar fallos.
MiniMax H3 FL2VA frente a Ref2VA: ¿qué flujo usar?
FL2VA es la opción predeterminada eficiente; Ref2VA es el flujo de control multimodal.
Necesidad | FL2VA | Ref2VA |
T2V | Mejor opción | Generalmente innecesario |
I2V | Mejor opción | Solo para referencias adicionales |
Fotograma inicial/final | Compatible | No es su uso principal |
Referencia de identidad | Limitado | Más adecuado |
Referencia de movimiento/cámara | No | Sí |
Referencia de audio | No | Sí |
La estructura oficial distingue FL2VA para T2V, I2V y generación condicionada por fotogramas, y Ref2VA para un control más completo mediante referencias de imagen, vídeo y audio.
¿Por qué no usar Ref2VA en cada generación H3?
Más referencias no producen automáticamente más control. Cada imagen, vídeo o audio añade otra relación que H3 debe interpretar.
Desde la perspectiva del flujo de diseño, usa el conjunto mínimo de referencias que comunique con precisión la intención creativa. Así reduces la ambigüedad, el coste de memoria y la complejidad del prompt.
Cómo escribir prompts Ref2V de MiniMax H3 para controlar mejor las referencias
La regla más importante de prompts para H3 es: asigna a cada referencia una responsabilidad explícita.
Separa identidad, movimiento, cámara, voz y sonido
Una instrucción Ref2V estructurada debe aclarar:
- Imagen 1: identidad del personaje o producto
- Imagen 2: iluminación, material o estilo visual
- Vídeo 1: solo movimiento corporal
- Vídeo 2: solo trayectoria de cámara
- Audio 1: características de la voz o temporización
- Paisaje sonoro: audio ambiental
- Música: descríbela por separado del diálogo y del sonido diegético
Esto es más fiable que añadir adjetivos a un prompt. Gestionar referencias se parece más a la dirección artística que a la escritura convencional de prompts.
Usa un compilador de prompts para proyectos Ref2VA complejos
Un flujo experimental revisado para esta guía utilizó un LLM multimodal para clasificar recursos, recopilar decisiones de duración, relación de aspecto, personaje, cámara y sonido, y compilar esas relaciones en un prompt listo para H3.
En proyectos con varios personajes o referencias, esto aporta una capa importante que faltaba entre la dirección creativa y la generación: gestión estructurada del contexto.
Cómo acelerar MiniMax H3 en ComfyUI sin estropear el audio
El flujo H3 útil más rápido no es necesariamente el que tiene menos pasos de muestreo. La previsualización debe conservar calidad suficiente para evaluar lo importante.
Reduce la resolución antes que los pasos de H3
El caso documentado de 20 a 10 pasos es especialmente útil: al probador le pareció que la degradación visual era relativamente limitada, mientras que la del audio era mucho más evidente.
Para evaluar composición, dirección del movimiento y cámara, bajar la resolución suele ser la variable de previsualización más segura. Para diálogo, temporización, detalle facial y sincronización final, usa ajustes más próximos al renderizado previsto.
Prueba SageAttention y las optimizaciones de caché por separado
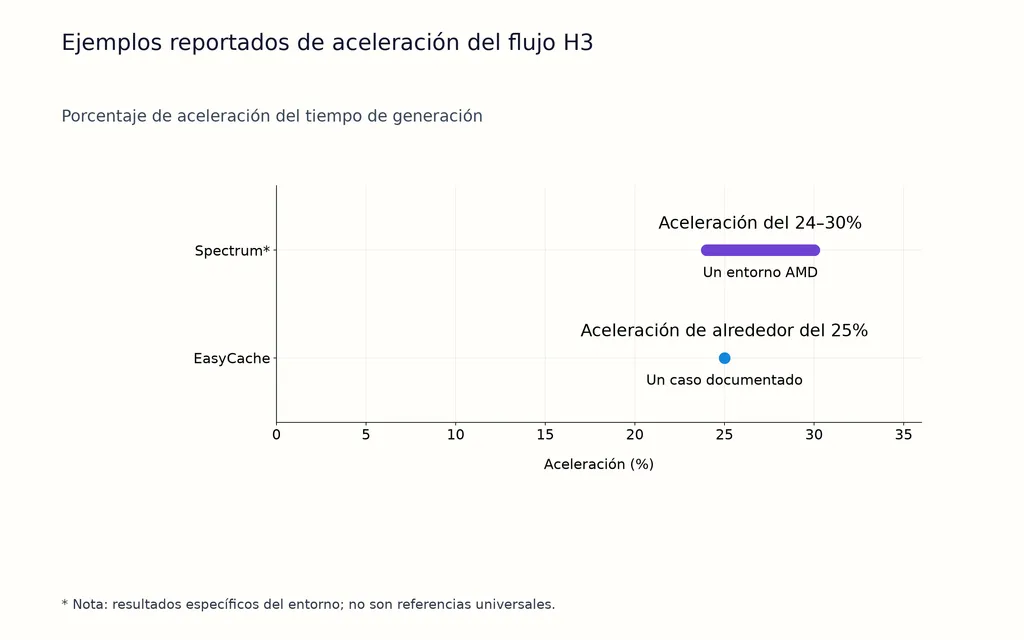
SageAttention figura en la discusión oficial de optimización de H3, mientras que los entornos de la comunidad muestran mejoras reales variables. Se ha informado de una aceleración del 24–30% con Spectrum en un entorno AMD, y un caso con EasyCache comunicó aproximadamente un 25%, pero son observaciones específicas de cada entorno, no referencias universales.
EasyCache también aparece en informes de menor calidad del diálogo o la coherencia. Nunca cambies a la vez SageAttention, caché, muestreador y pasos de muestreo si quieres entender por qué cambió la calidad.
Requisitos de VRAM y RAM de MiniMax H3: ¿qué hardware necesitas?
La planificación de memoria de H3 no puede basarse solo en la VRAM. Los componentes grandes del modelo se mueven entre GPU y memoria del sistema, por lo que la RAM y la gestión del ciclo de vida del modelo pueden ser el verdadero cuello de botella.
Por qué H3 puede quedarse sin memoria incluso con suficiente VRAM
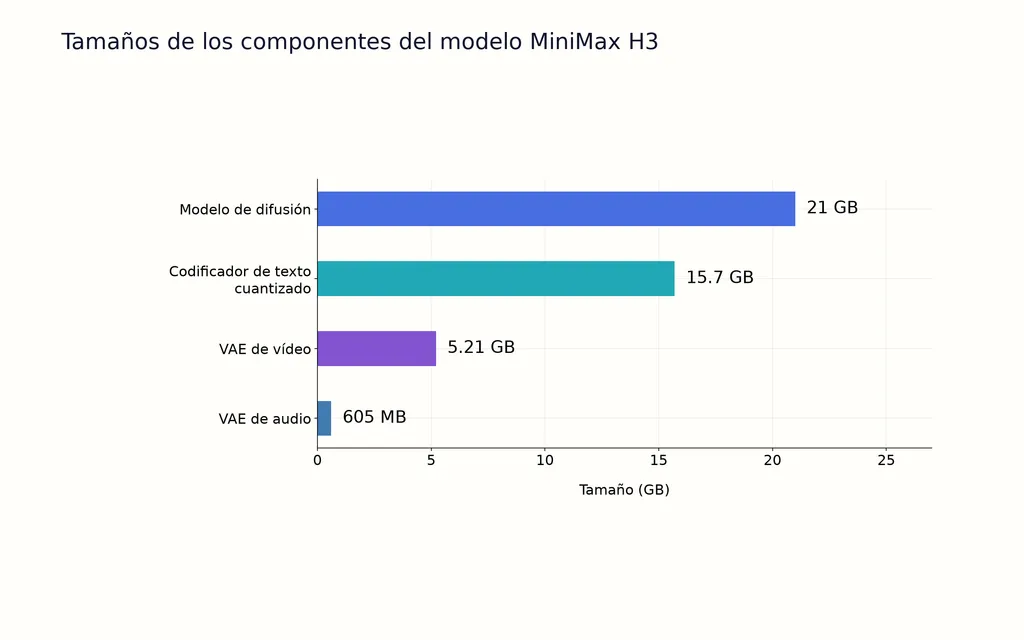
El conjunto de investigación registra tamaños aproximados de paquetes de 21 GB para el modelo de difusión, 15,7 GB para un codificador de texto cuantizado, 5,21 GB para el VAE de vídeo y 605 MB para el VAE de audio.
Por eso, descargar componentes de la memoria y transferirlos entre dispositivos forma parte del flujo, en lugar de ser mantenimiento opcional.
Qué muestran los casos de H3 con 12 y 16 GB
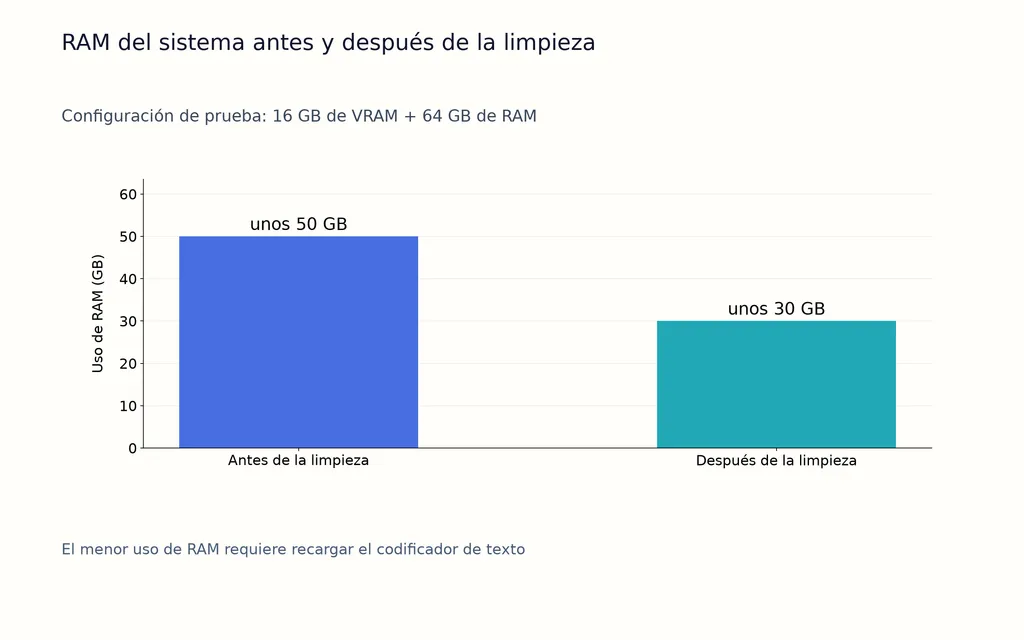
En una configuración documentada de 16 GB de VRAM + 64 GB de RAM, la RAM del sistema alcanzó unos 50 GB antes de la limpieza y bajó a unos 30 GB después, a costa de recargar el codificador de texto.
Otro caso Ref2V con RTX 3060 de 12 GB + 64 GB de RAM se acercó a ocupar toda la RAM del sistema al generar un clip de cinco segundos de aproximadamente 0,35 MP.
No son referencias universales, pero muestran por qué «H3 puede ejecutarse» es distinto de «H3 permite iterar cómodamente».
Cómo resolver el audio ininteligible y la consistencia facial en MiniMax H3
La generación audiovisual nativa de H3 es una gran ventaja, pero el audio y la identidad requieren controles de calidad separados.
Cómo diagnosticar el audio ininteligible de H3
Nuestra revisión de preguntas recurrentes sobre flujos no halló una causa única verificada del audio ininteligible. Los posibles factores incluyen temporización ambigua del diálogo, instrucciones de música no deseadas, caché agresiva y muy pocos pasos de muestreo.
El diagnóstico más seguro consiste en volver al flujo base, definir quién habla y cuándo, separar la música del sonido ambiental, restaurar los ajustes normales de muestreo y reactivar las optimizaciones de rendimiento una a una.
Por qué una mayor resolución de referencia no garantiza la identidad
Un caso detallado de consistencia de identidad siguió observando suavizado o distorsión facial en planos más abiertos o en movimiento, pese a usar Ref2VA, salida a 1344 × 768, una referencia facial adicional de alta resolución, ajustes máximos de detalle de referencia y hasta 20 pasos.
Un mayor detalle de referencia aporta más información de identidad a H3, pero no debe presentarse como una solución garantizada para la consistencia facial.
Cómo crear vídeos MiniMax H3 de más de 15 segundos
El flujo oficial de un solo clip de H3 está limitado a 15 segundos, por lo que una producción más larga se aborda mejor como un problema de continuidad que aumentando simplemente la duración.
Encadena el contexto de movimiento y audio
Un enfoque prometedor es:
Clip A → conservar el estado del movimiento y el audio → Clip B → continuar el contexto → Clip C
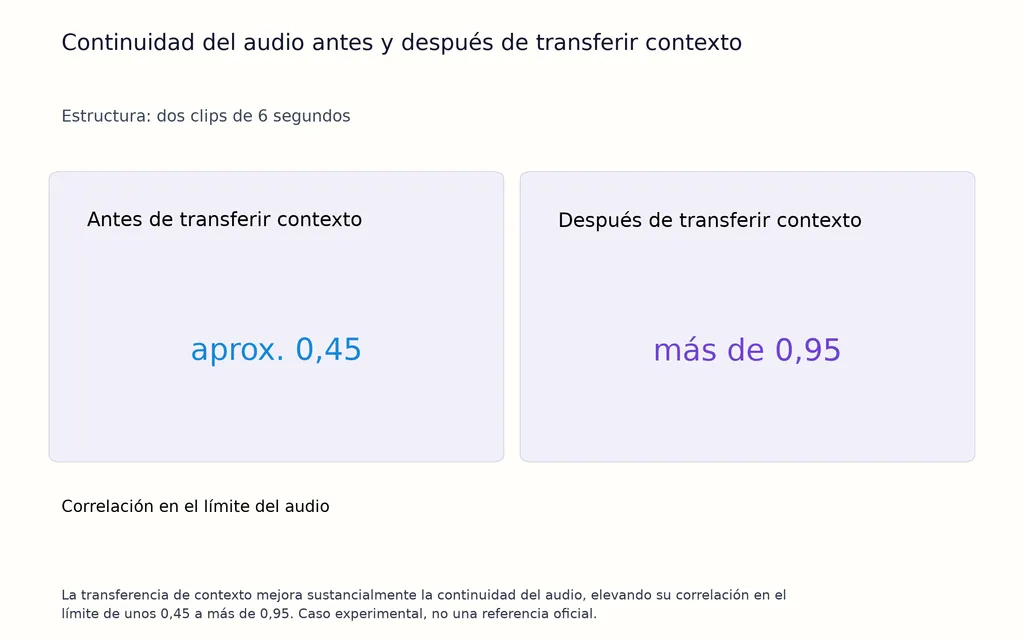
Un caso experimental unió dos clips de seis segundos sin fundido cruzado e informó de una mejora de la correlación en el límite de audio de aproximadamente 0,45 a más de 0,95 tras transferir el contexto.
No es una referencia oficial, pero respalda un principio de producción útil: conserva el estado entre clips en lugar de pedir a cada generación que reconstruya la continuidad desde cero.
MiniMax H3 1080p frente a 2K: ¿ampliación o Regenerate-2K?
En producción local, distingue la generación H3 Base del proceso completo H3 2K.
H3 Base se centra en una etapa de generación con el lado corto de 768 píxeles, mientras que la arquitectura completa de MiniMax incluye una etapa separada H3-Regenerate-2K que reutiliza el contexto original al reconstruir detalles de mayor resolución. Los flujos abiertos locales exponen principalmente H3 Base, por lo que la ampliación convencional sigue siendo una vía práctica de entrega.
Cuándo usar un ampliador
Elige la ampliación de vídeo convencional cuando:
- los fotogramas generados ya funcionan;
- quieres una ampliación predecible;
- la rapidez de entrega importa;
- no quieres otra pasada generativa.
Un caso documentado con RTX 3090 generó un clip de unos 14 segundos y 1 MP en aproximadamente 40 minutos antes de aplicar superresolución basada en RTX.
Cuándo tiene más sentido Regenerate-2K
Elige la regeneración consciente del contexto cuando reconstruir detalles visuales finos a partir de la intención multimodal original importe más que la preservación determinista. No debe confundirse con una ampliación normal de píxeles, y la investigación actual no ofrece una prueba local controlada que demuestre que siempre es superior.
Preguntas frecuentes
¿Puede H3 ejecutarse con 12 GB de VRAM?
Sí, algunas configuraciones de 12 GB pueden ejecutar H3 con cuantización y descarga a otros dispositivos, pero la RAM puede ser el factor limitante. Un sistema documentado con RTX 3060 de 12 GB y 64 GB de RAM rozó el uso total de RAM durante una generación Ref2V corta. El hardware, la cuantización, la resolución y la configuración de nodos pueden cambiar mucho los resultados.
FL2VA o Ref2VA: ¿cuál debería usar?
Usa FL2VA para T2V, I2V y generación con fotograma inicial/final. Usa Ref2VA cuando imágenes, vídeos o audio deban controlar identidad, movimiento, cámara, estilo o voz. Si el plano no necesita control multimodal por referencias, FL2VA suele ser más sencillo y eficiente en memoria.
¿Por qué el audio de H3 se vuelve ininteligible?
No hay una causa única verificada. En los casos de flujos revisados para esta guía, pocos pasos de muestreo, instrucciones ambiguas de diálogo, música no deseada y caché agresiva han coincidido con fallos de audio. Empieza con el flujo estándar, simplifica las instrucciones de audio y reintroduce los cambios de optimización de uno en uno.
Regenerate-2K o un ampliador: ¿cuál es mejor?
Usa un ampliador para una ampliación más rápida y determinista de un clip logrado. Usa Regenerate-2K cuando la prioridad sea reconstruir detalles contextuales. Resuelven problemas diferentes: uno amplía un resultado existente y el otro forma parte de la arquitectura más amplia de regeneración contextual de MiniMax.
Conclusión
El flujo MiniMax H3 de ComfyUI más fiable es un sistema de producción, no un solo grafo: dirige las tareas sencillas a FL2VA, usa Ref2VA solo cuando necesites control multimodal, define los papeles de las referencias antes de generar, previsualiza a menor resolución antes de gastar cómputo en el renderizado final, gestiona RAM y VRAM, valida el audio nativo antes de añadir aceleración agresiva, conserva el contexto al extender clips y elige ampliación o regeneración contextual 2K según el objetivo de entrega. Así, los diseñadores pueden pasar de experimentar con H3 a una producción de vídeo con IA controlada de forma más repetible.
Más del blog de Virse
Flujo de trabajo

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de octubre de 2026 by Yifan Zhao