
Fluxo do MiniMax H3: resolva OOM, áudio incompreensível e renderizações lentas
Vincent11 min de leitura ·
O melhor fluxo do ComfyUI para MiniMax H3 usa FL2VA para T2V, I2V e geração com primeiro/último quadro, muda para Ref2VA quando as referências precisam controlar identidade, movimento, câmera ou voz e separa as prévias rápidas da renderização final. A produção confiável com H3 depende de encaminhamento de modelos, estrutura de referências, gestão de RAM/VRAM e qualidade do áudio nativo, e não de um grafo “perfeito”.
A dificuldade aparece quando os projetos crescem. Várias imagens, referências de movimento, áudio, prompts, prévias e renderizações finais fragmentam rapidamente os fluxos, dificultando preservar a identidade, comparar gerações, controlar a memória e manter a continuidade. Nossa análise de casos de fluxos H3 mostrou que reduzir o custo de iteração sem prejudicar o áudio é uma das decisões de equilíbrio mais importantes da produção.
O Virse resolve essa lacuna mais ampla do fluxo ao trazer agentes de IA para uma tela infinita.Os designers podem organizar recursos, conectar o contexto criativo, executar vários agentes em paralelo e trabalhar com preferências de marca compartilhadas e conhecimentos do projeto. Em vez de substituir designers pela geração em um clique, o Virse ajuda equipes criativas profissionais a tornar a produção assistida por IA mais estruturada, repetível e escalável. MiniMax H3, Seedance 2.5 e Seedance 2.0 já estão disponíveis no Virse, permitindo explorar e comparar vários modelos de vídeo líderes no mesmo fluxo criativo.
Qual é o melhor fluxo do MiniMax H3 no ComfyUI?
Um fluxo do MiniMax H3 pronto para produção deve separar a exploração da renderização final. Renderizar cada seed em resolução máxima antes de saber se a composição, o movimento, a identidade ou a direção de câmera funcionam desperdiça tempo de GPU. A pesquisa analisada para este guia confirma que estas são as principais rotas oficiais do fluxo.
Use um fluxo H3 da prévia ao resultado final
Uma sequência prática é:
- Defina o plano — duração, proporção, sujeito, câmera e restrições visuais indispensáveis.
- Escolha FL2VA ou Ref2VA conforme o tipo de controle necessário.
- Atribua um papel a cada referência antes da geração.
- Gere várias prévias em resolução menor para comparar composição e movimento.
- Selecione o melhor seed e a melhor direção.
- Restaure as configurações de qualidade final para o plano aprovado.
- Amplie ou regenere apenas os resultados aprovados.
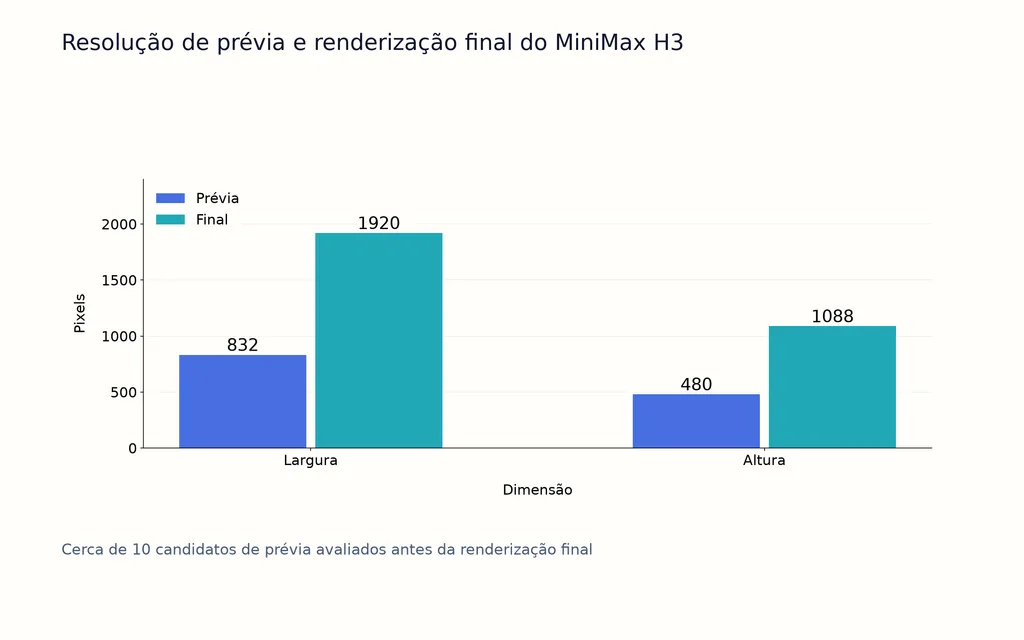
Um fluxo documentado usou prévias de cerca de 832 × 480 antes de uma renderização final em 1920 × 1088, permitindo avaliar primeiro cerca de dez candidatos rápidos. Em outro caso, reduzir a amostragem de 20 para 10 passos produziu mudanças visuais relativamente pequenas, mas piorou claramente o áudio nativo.
A lição prática é reduzir a resolução da prévia antes de diminuir agressivamente os passos, principalmente quando diálogos ou som sincronizado são importantes.
Como configurar o MiniMax H3 no ComfyUI
O fluxo oficial do H3 no ComfyUI é organizado em torno de T2V, I2V e R2V, com FL2VA e Ref2VA atendendo a necessidades diferentes de geração. A pesquisa analisada para este guia confirma que estas são as principais rotas oficiais.
Com qual fluxo H3 você deve começar?
Comece pela rota mais simples que atenda ao plano:
- T2V: FL2VA
- I2V com uma imagem: FL2VA
- Primeiro + último quadro: FL2VA
- Referência de identidade: Ref2VA
- Referência de movimento ou câmera: Ref2VA
- Referência de áudio ou voz: Ref2VA
- Controle combinado de imagem + vídeo + áudio: Ref2VA
Evite carregar as duas grandes ramificações do modelo apenas porque um grafo híbrido permite. A simplicidade do modelo reduz a pressão sobre a memória e facilita diagnosticar falhas.
MiniMax H3 FL2VA e Ref2VA: qual fluxo usar?
FL2VA é a opção padrão eficiente; Ref2VA é o fluxo de controle multimodal.
Necessidade | FL2VA | Ref2VA |
T2V | Melhor opção | Geralmente desnecessário |
I2V | Melhor opção | Use apenas para referências adicionais |
Primeiro/último quadro | Compatível | Não é o uso principal |
Referência de identidade | Limitado | Mais adequado |
Referência de movimento/câmera | Não | Sim |
Referência de áudio | Não | Sim |
A estrutura oficial distingue FL2VA para T2V, I2V e geração condicionada por quadros de Ref2VA para um controle mais amplo por referências de imagem, vídeo e áudio.
Por que não usar Ref2VA em toda geração H3?
Mais referências não geram automaticamente mais controle. Cada entrada de imagem, vídeo ou áudio acrescenta outra relação que o H3 precisa interpretar.
Do ponto de vista do fluxo de design, use o menor conjunto de referências que comunique com precisão a intenção criativa. Isso reduz a ambiguidade, o custo de memória e a complexidade do prompt.
Como escrever prompts MiniMax H3 Ref2V para controlar melhor as referências
A regra mais importante para prompts do H3 é: dê a cada referência uma responsabilidade explícita.
Separe identidade, movimento, câmera, voz e som
Uma instrução Ref2V estruturada deve esclarecer:
- Imagem 1: identidade do personagem ou produto
- Imagem 2: iluminação, material ou estilo visual
- Vídeo 1: apenas movimento corporal
- Vídeo 2: apenas trajetória da câmera
- Áudio 1: características da voz ou temporização
- Paisagem sonora: áudio ambiente
- Música: descreva separadamente do diálogo e do som diegético
Isso é mais confiável do que acrescentar adjetivos ao prompt. A gestão de referências se aproxima mais da direção de arte do que da escrita convencional de prompts.
Use um compilador de prompts para projetos Ref2VA complexos
Um fluxo experimental analisado para este guia usou um LLM multimodal para classificar recursos, coletar decisões de duração, proporção, personagem, câmera e som e compilar essas relações em um prompt pronto para o H3.
Para projetos com vários personagens ou referências, isso cria uma camada importante que faltava entre a direção criativa e a geração: gestão estruturada do contexto.
Como acelerar o MiniMax H3 no ComfyUI sem prejudicar o áudio
O fluxo H3 útil mais rápido não é necessariamente o que tem menos passos de amostragem. Uma prévia precisa manter qualidade suficiente para avaliar as propriedades importantes.
Reduza a resolução antes dos passos do H3
O caso documentado da redução de 20 para 10 passos é especialmente útil: o testador percebeu uma degradação visual relativamente limitada, enquanto a do áudio foi muito mais evidente.
Para avaliar composição, direção do movimento e câmera, reduzir a resolução costuma ser a variável de prévia mais segura. Para diálogo, temporização, detalhes faciais e sincronização final, use configurações mais próximas da renderização pretendida.
Teste SageAttention e otimizações de cache separadamente
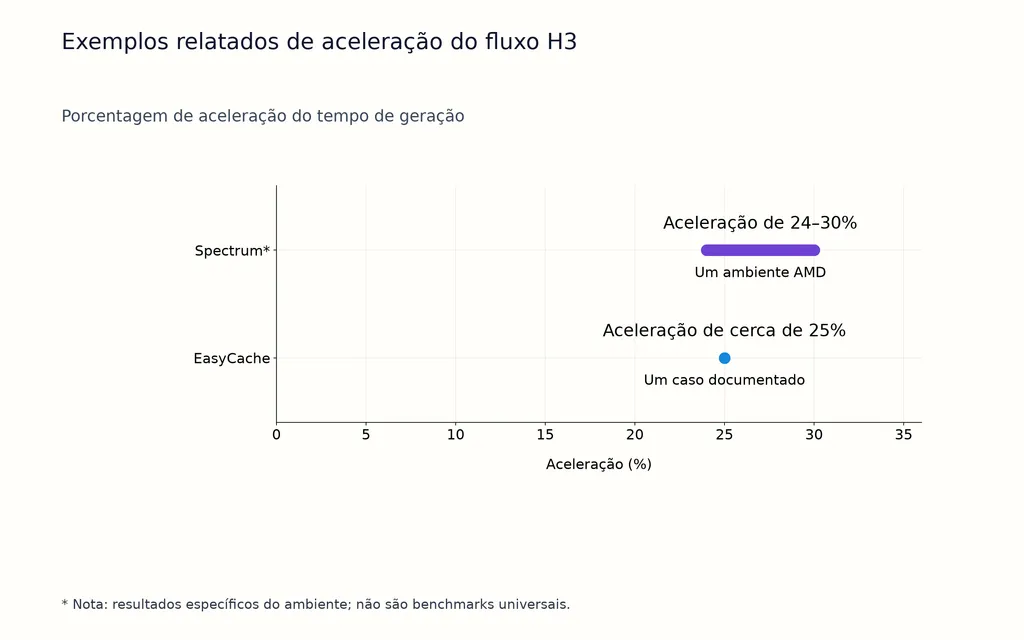
SageAttention aparece na discussão oficial de otimização do H3, enquanto os ambientes da comunidade mostram ganhos reais variados. Foi relatada uma aceleração de cerca de 24–30% com Spectrum em um ambiente AMD, e um caso com EasyCache relatou cerca de 25%, mas são observações específicas do ambiente, não benchmarks universais.
EasyCache também aparece em relatos de piora do diálogo ou da coerência. Nunca mude SageAttention, cache, amostrador e passos de amostragem simultaneamente se quiser entender por que a qualidade mudou.
Requisitos de VRAM e RAM do MiniMax H3: de qual hardware você precisa?
O planejamento de memória do H3 não pode se basear apenas na VRAM. Os grandes componentes do modelo transitam entre GPU e memória do sistema, então a RAM e a gestão do ciclo de vida do modelo podem se tornar o verdadeiro gargalo.
Por que o H3 pode ficar sem memória mesmo com VRAM suficiente
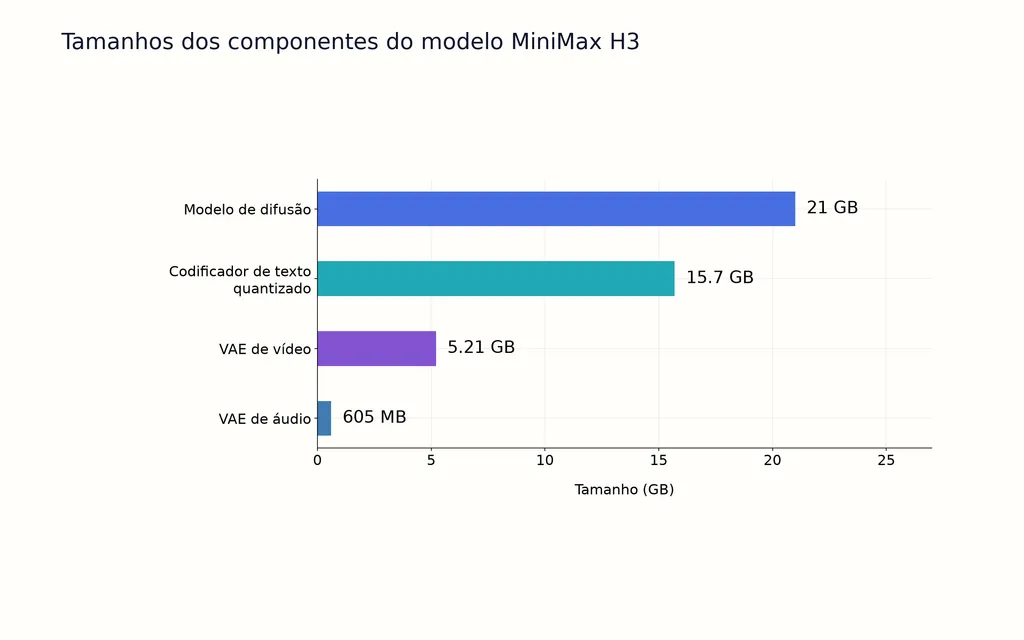
O conjunto de pesquisas registra tamanhos aproximados de pacotes de 21 GB para o modelo de difusão, 15,7 GB para um codificador de texto quantizado, 5,21 GB para o VAE de vídeo e 605 MB para o VAE de áudio.
Por isso, descarregar componentes e transferi-los entre dispositivos faz parte do fluxo, em vez de ser uma limpeza opcional.
O que mostram os casos do H3 com 12 GB e 16 GB
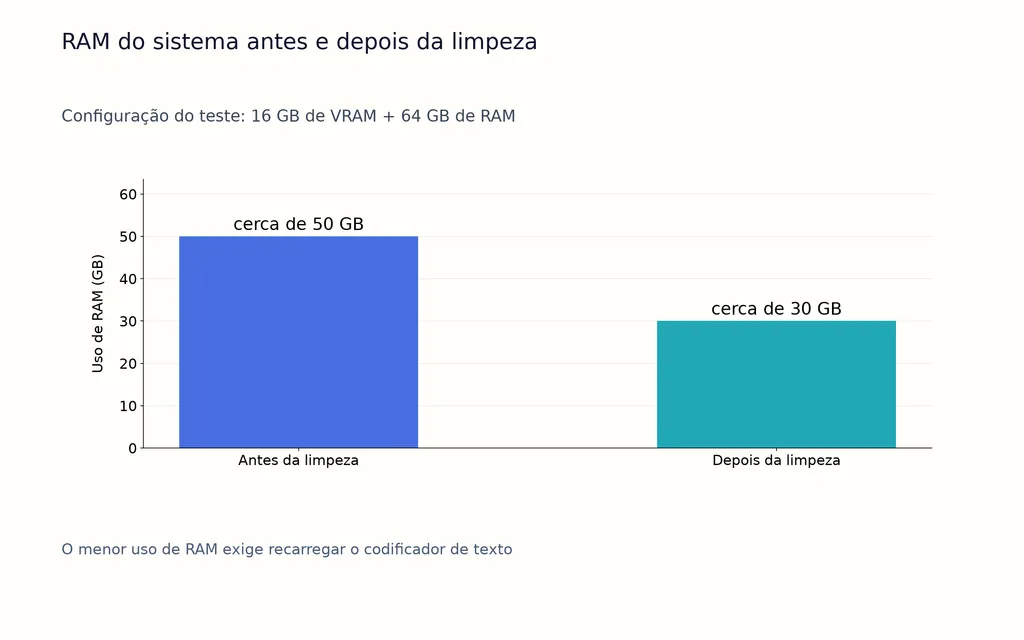
Em uma configuração documentada de 16 GB de VRAM + 64 GB de RAM, a RAM do sistema chegou a cerca de 50 GB antes da limpeza e caiu para cerca de 30 GB depois, ao custo de recarregar o codificador de texto.
Outro caso Ref2V com RTX 3060 de 12 GB + 64 GB de RAM chegou perto de ocupar toda a RAM do sistema ao gerar um clipe de cinco segundos com cerca de 0,35 MP.
Não são benchmarks universais, mas mostram por que “o H3 consegue rodar” é diferente de “é confortável iterar com o H3”.
Como resolver áudio incompreensível e problemas de consistência facial no MiniMax H3
A geração audiovisual nativa do H3 é uma grande vantagem, mas áudio e identidade exigem verificações de qualidade separadas.
Como diagnosticar áudio incompreensível no H3
Nossa análise de dúvidas recorrentes sobre fluxos não encontrou uma causa única verificada para o áudio incompreensível. Possíveis fatores incluem temporização ambígua do diálogo, instruções musicais indesejadas, cache agressivo e pouquíssimos passos de amostragem.
O diagnóstico mais seguro é voltar ao fluxo básico, definir quem fala e quando, separar música de som ambiente, restaurar os ajustes normais de amostragem e reativar as otimizações de desempenho uma por uma.
Por que uma referência de maior resolução não garante a identidade
Um caso detalhado de consistência de identidade ainda observou suavização ou distorção facial em planos mais abertos ou em movimento, apesar de usar Ref2VA, saída em 1344 × 768, uma referência facial adicional em alta resolução, configurações máximas de detalhe da referência e até 20 passos.
Mais detalhes na referência fornecem ao H3 mais informações de identidade, mas não devem ser apresentados como uma solução garantida para a consistência facial.
Como criar vídeos MiniMax H3 com mais de 15 segundos
O fluxo oficial de clipe único do H3 é limitado a 15 segundos, então uma produção mais longa deve ser tratada como um problema de continuidade, e não como um simples aumento de duração.
Encadeie o contexto de movimento e áudio
Uma abordagem promissora é:
Clipe A → preservar o estado do movimento e do áudio → Clipe B → continuar o contexto → Clipe C
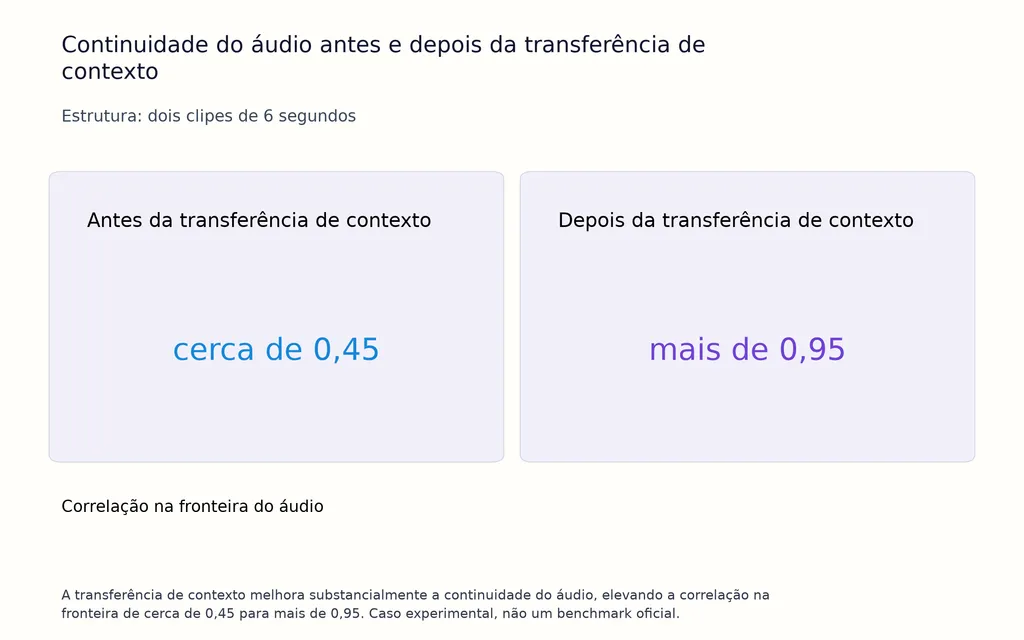
Um caso experimental uniu dois clipes de seis segundos sem transição cruzada e relatou que a correlação na fronteira do áudio melhorou de cerca de 0,45 para mais de 0,95 após transferir o contexto.
Não é um benchmark oficial, mas apoia um princípio útil de produção: preserve o estado entre clipes em vez de pedir a cada geração que reconstrua a continuidade do zero.
MiniMax H3 1080p e 2K: ampliação ou Regenerate-2K?
Na produção local, diferencie a geração H3 Base do pipeline H3 2K completo.
H3 Base se concentra em uma etapa de geração com lado curto de 768 pixels, enquanto a arquitetura completa da MiniMax inclui uma etapa separada H3-Regenerate-2K que reutiliza o contexto original ao reconstruir detalhes em maior resolução. Os fluxos locais abertos expõem principalmente o H3 Base, então a ampliação convencional continua sendo um caminho prático para a entrega.
Quando usar uma ferramenta de ampliação
Escolha a ampliação convencional de vídeo quando:
- os quadros gerados já estão bons;
- você quer uma ampliação previsível;
- a velocidade de entrega é importante;
- você não quer outra etapa generativa.
Um caso documentado com RTX 3090 gerou um clipe de cerca de 14 segundos e 1 MP em aproximadamente 40 minutos antes de aplicar super-resolução baseada em RTX.
Quando Regenerate-2K faz mais sentido
Escolha a regeneração sensível ao contexto quando reconstruir detalhes visuais finos a partir da intenção multimodal original for mais importante do que a preservação determinística. Ela não deve ser confundida com a ampliação comum de pixels, e a pesquisa atual não fornece um benchmark local controlado que prove que ela é sempre superior.
Perguntas frequentes
O H3 pode rodar com 12 GB de VRAM?
Sim, algumas configurações de 12 GB conseguem rodar H3 com quantização e transferência de componentes, mas a RAM pode ser o fator limitante. Um sistema documentado com RTX 3060 de 12 GB e 64 GB de RAM quase atingiu o uso total de RAM durante uma geração Ref2V curta. Hardware, quantização, resolução e configuração dos nós podem alterar bastante os resultados.
FL2VA ou Ref2VA: qual devo usar?
Use FL2VA para T2V, I2V e geração com primeiro/último quadro. Use Ref2VA quando imagens, vídeos ou áudio precisarem controlar identidade, movimento, câmera, estilo ou voz. Se o plano não exigir controle multimodal por referências, FL2VA costuma ser mais simples e eficiente em memória.
Por que o áudio do H3 fica incompreensível?
Não existe uma causa única verificada. Nos casos de fluxos analisados para este guia, poucos passos de amostragem, instruções ambíguas de diálogo, música indesejada e cache agressivo apareceram junto de falhas de áudio. Comece pelo fluxo padrão, simplifique as instruções de áudio e reintroduza as mudanças de otimização uma por vez.
Regenerate-2K ou uma ferramenta de ampliação: qual é melhor?
Use uma ferramenta de ampliação para ampliar de modo mais rápido e determinístico um clipe bem-sucedido. Use Regenerate-2K quando a reconstrução contextual de detalhes for a prioridade. Eles resolvem problemas diferentes: um amplia um resultado existente, enquanto o outro faz parte da arquitetura mais ampla de regeneração sensível ao contexto da MiniMax.
Conclusão
O fluxo MiniMax H3 ComfyUI mais confiável é um sistema de produção, não um único grafo: direcione tarefas simples ao FL2VA, use Ref2VA apenas quando precisar de controle multimodal, defina os papéis das referências antes da geração, faça prévias em resolução menor antes de gastar processamento na renderização final, gerencie RAM junto com VRAM, valide o áudio nativo antes de adicionar aceleração agressiva, preserve o contexto ao estender clipes e escolha ampliação ou regeneração contextual em 2K conforme a entrega desejada. Essa abordagem oferece aos designers uma forma mais repetível de levar o H3 da experimentação para a produção de vídeo com IA controlada.
Mais do blogue da Virse
Fluxo de trabalho

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de outubro de 2026 by Yifan Zhao