
Nativamente multimodal
Texto, imagem, vídeo e áudio aceites através de uma única interface.
O modelo de vídeo nativamente multimodal da Google, que recebe texto, imagens, vídeo e áudio como entrada, disponível na Virse em opções orientadas por fotogramas e por referências.
Abra esta página em um navegador de desktop para começar a criar.
Gemini Omni Flash é o modelo rápido de vídeo da Google, anunciado em junho de 2026, e a parte que vale a pena compreender é o que aceita.
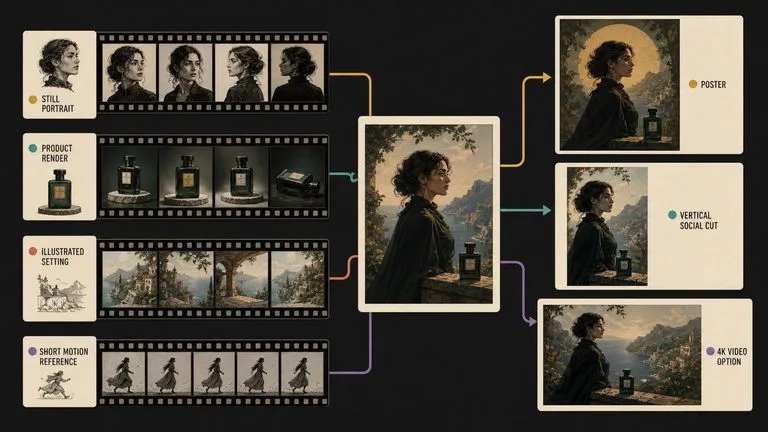
A maioria dos modelos de vídeo recebe uma imagem e um parágrafo. Este é nativamente multimodal: texto, imagens, vídeo e áudio entram pela mesma interface, em vez de adaptadores separados acrescentados posteriormente. É uma propriedade da arquitetura, em vez de uma lista de funcionalidades, e revela-se na coerência com que o modelo concilia entradas que apontam em direções diferentes. A Google também o criou para aperfeiçoamento por conversa, em que um clipe é ajustado continuando a conversa, em vez de reescrever o briefing.
Use Gemini Omni Flash quando as suas entradas são variadas e o seu processo de imagem já pertence à Google. Anime imagens fixas de Nano Banana ou dos modelos de imagem Gemini, oriente planos com material de referência e itere num clipe respondendo-lhe.
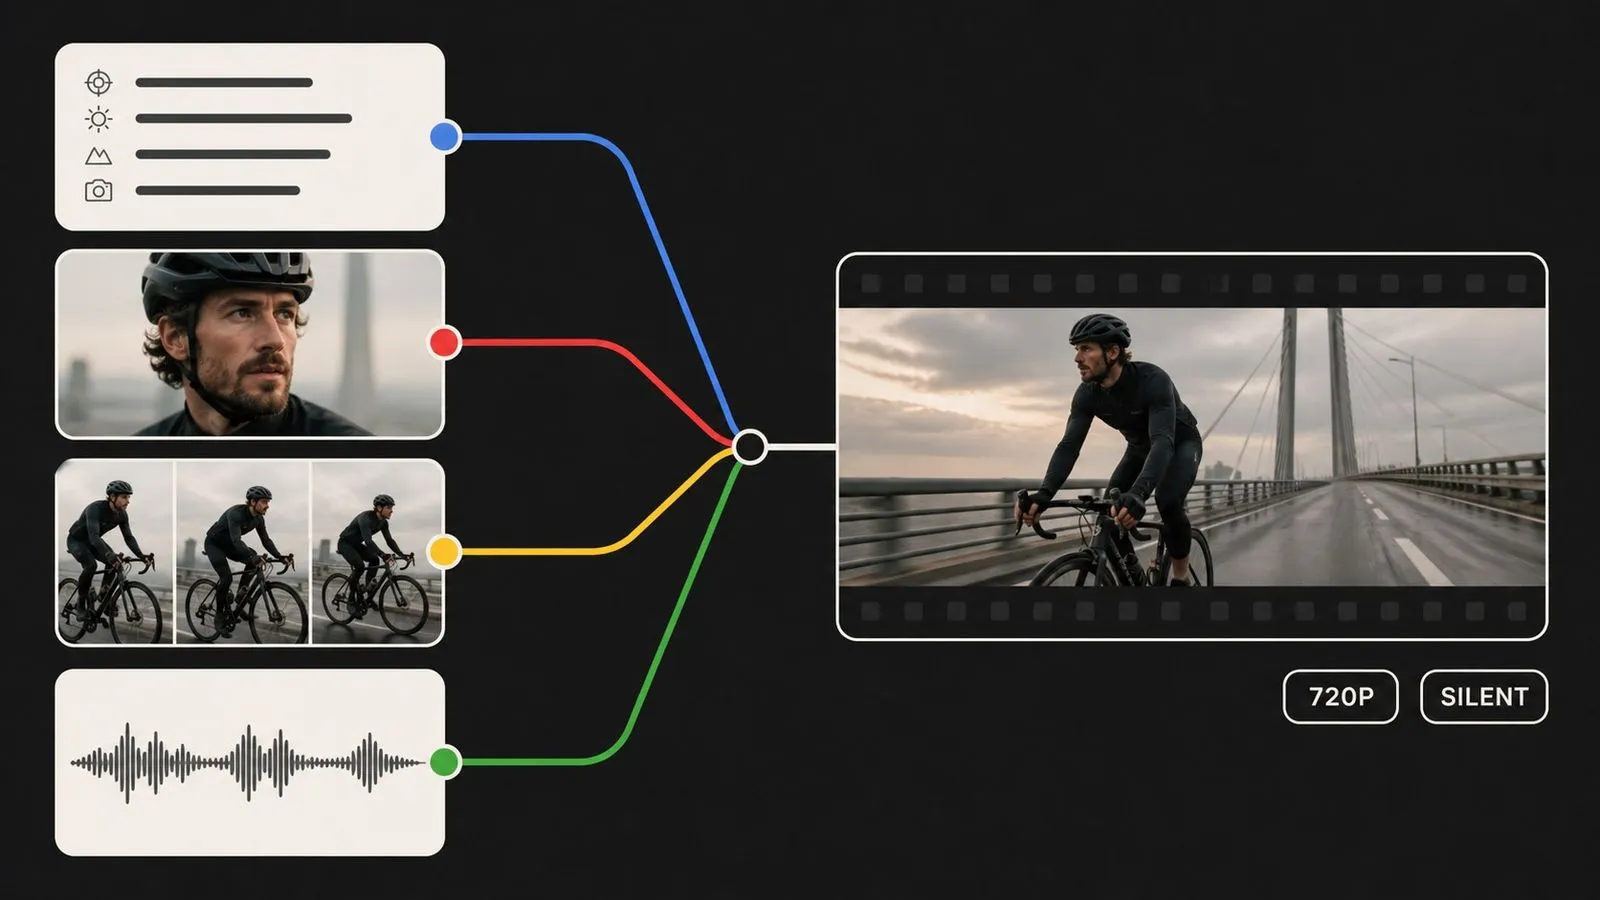
Gemini Omni Flash é um modelo de geração de vídeo com IA desenvolvido pela Google DeepMind, parte da linha Gemini Flash, em que a rapidez de resposta é a prioridade de conceção. Foi anunciado em junho de 2026 como uma opção económica para geração de vídeo e edição de vídeo por conversa.
O modelo assenta em três grandes pontos fortes:
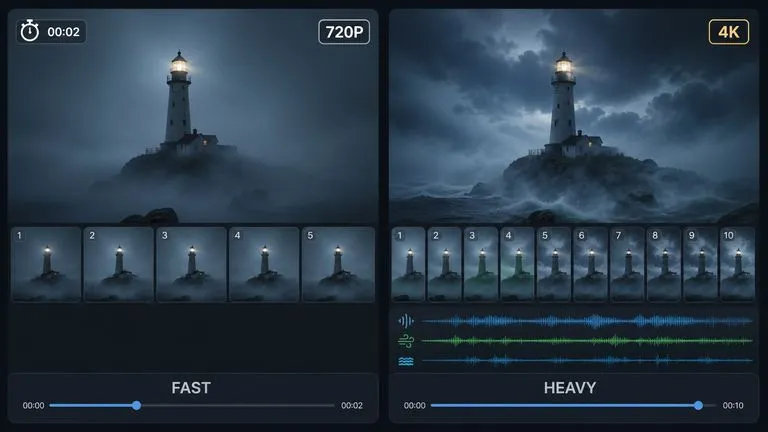
A Virse apresenta duas opções. Gemini Omni Flash recebe um primeiro fotograma, um último fotograma ou ambos, mais um briefing escrito. Gemini Omni Flash Reference trabalha antes a partir de imagens de exemplo fornecidas. A opção disponibilizada na Virse é a configuração 720P, que gera áudio nativo em todas as gerações, pelo que a direção de áudio não faz parte do briefing aqui.
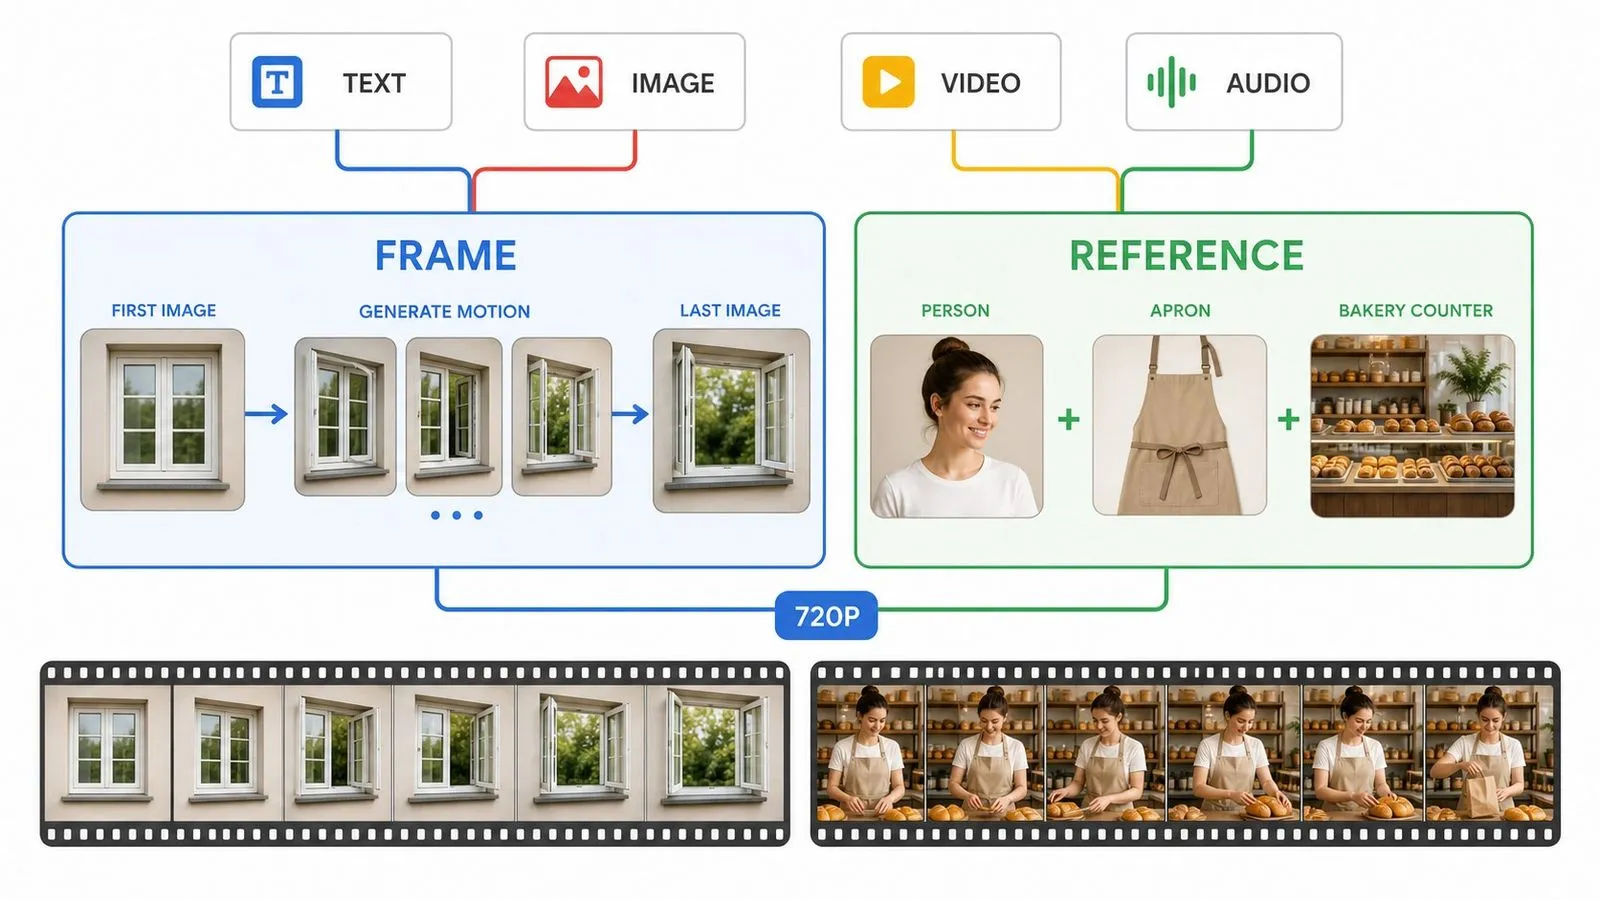
Texto, imagem, vídeo e áudio aceites através de uma única interface.
Orientado por fotogramas e por referências, apresentados separadamente na Virse.
O tamanho disponibilizado na Virse. O áudio é gerado nativamente com a imagem.
Um modelo da linha Flash, o que em vídeo importa mais do que em imagens fixas.
Ajuste um resultado continuando a instrução, em vez de a reescrever.
Um sinal impercetível incorporado em cada clipe gerado.
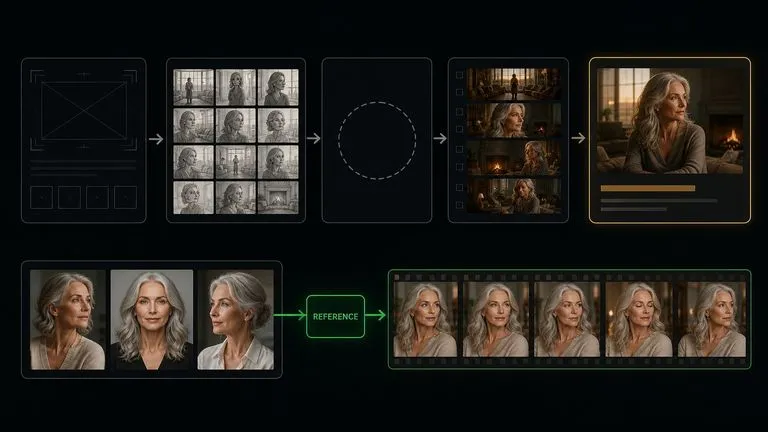
A multimodalidade nativa significa que texto, imagens, vídeo e áudio são tratados pelo mesmo modelo, em vez de passarem por codificadores separados. Entradas que entrariam em conflito num sistema montado a partir de peças são, assim, conciliadas.
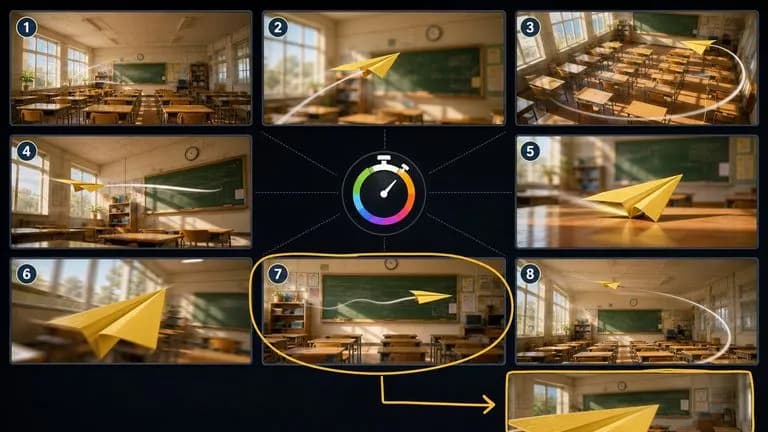
Veo 3.1, o modelo de vídeo mais pesado da Google, é orientado por fotogramas. Gemini Omni Flash acrescenta um percurso com imagens de referência, a única via para esse tipo de controlo de continuidade dentro da família Google.
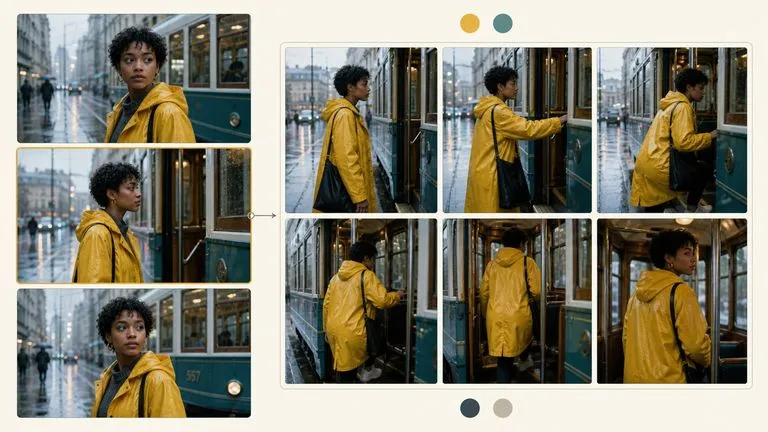
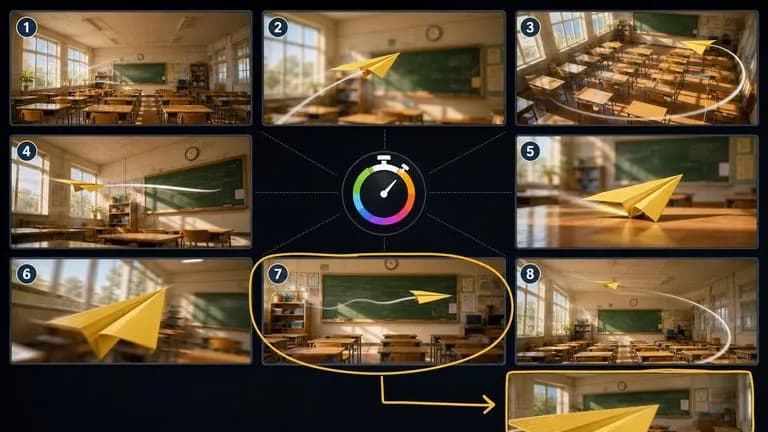
Em vez de reescrever um briefing do zero para corrigir uma coisa, o modelo foi criado para ajustes iterativos: a premissa de conceção é que o primeiro resultado é um ponto de partida.
A linha Flash otimiza a rapidez de resposta. No vídeo, em que uma geração lenta quebra totalmente a concentração, isso importa mais do que nas imagens fixas.
Os fotogramas produzidos por Nano Banana Pro, Nano Banana 2 ou Gemini 2.5 Flash Image vêm da mesma família, mantendo o caráter visual contínuo na passagem da imagem fixa ao movimento.
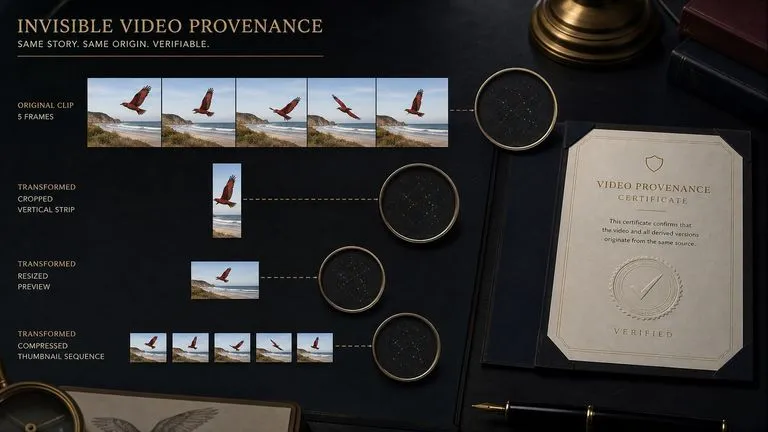
SynthID é incorporado automaticamente em cada clipe, identificando-o como gerado por IA sem nada visível na imagem nem nada para ativar.
Permanecer numa só família de modelos ao longo de um processo parece uma preferência até mudar de fornecedor a meio do projeto e passar uma tarde a perceber por que razão a versão animada não corresponde à imagem fixa. A Virse torna o percurso dentro da mesma família o caminho mais simples. Um fotograma gerado por qualquer modelo de imagem da Google na tela passa diretamente para Gemini Omni Flash sem exportação, pelo que a passagem da imagem fixa ao movimento acontece no mesmo local.
Envie um fotograma de imagem Nano Banana ou Gemini diretamente para o modelo de vídeo na mesma tela.
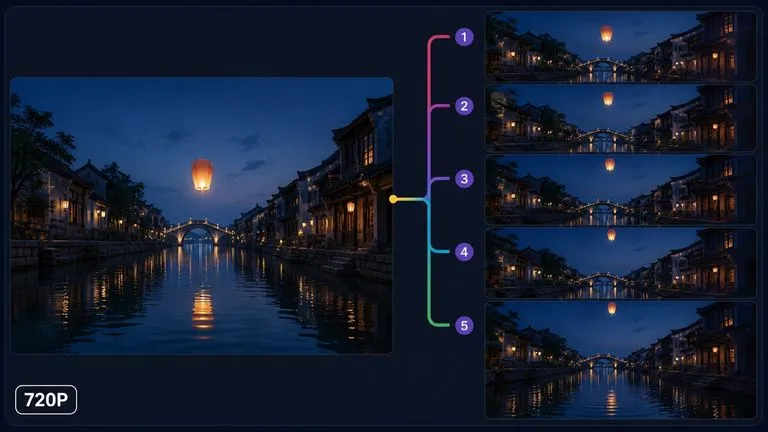
Cada aperfeiçoamento fica ao lado da versão que lhe deu origem, o que permite rever posteriormente um fluxo de trabalho por conversa.
Alterne entre Gemini Omni Flash e mais de 30 outros modelos de imagem e vídeo sem sair da tela nem reescrever o briefing.
Execute o mesmo fotograma no Veo 3.1 ao lado quando precisar de saber se o peso adicional compensa.
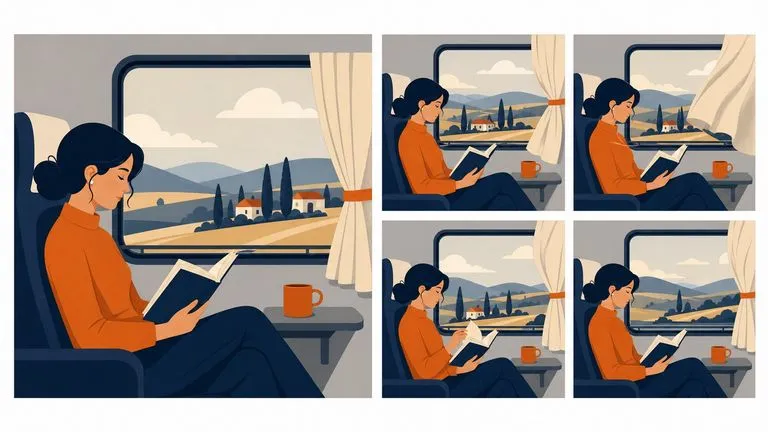
Movimento acrescentado a imagens geradas noutros modelos da família Google.
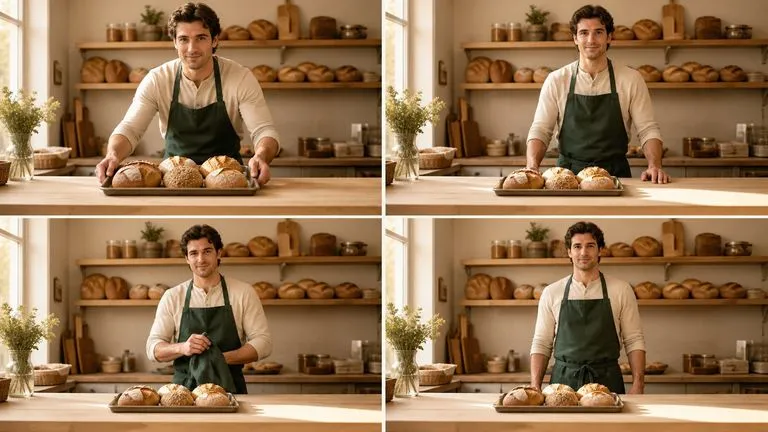
Planos em que um sujeito é definido por imagens de exemplo, em vez de descrito.
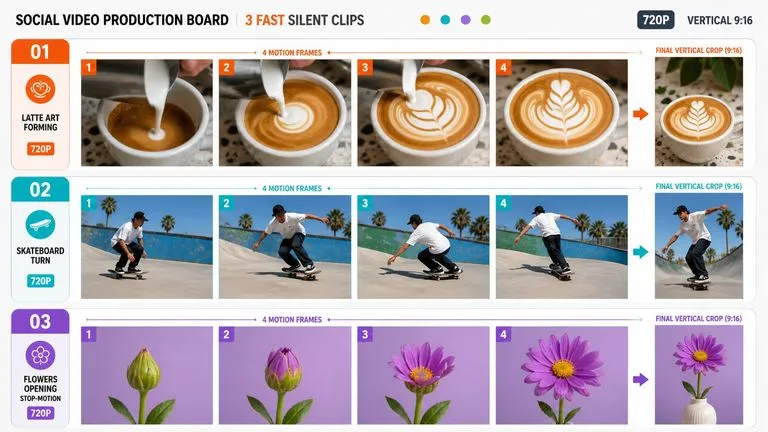
Clipes rápidos em que a rapidez importa mais do que a resolução.
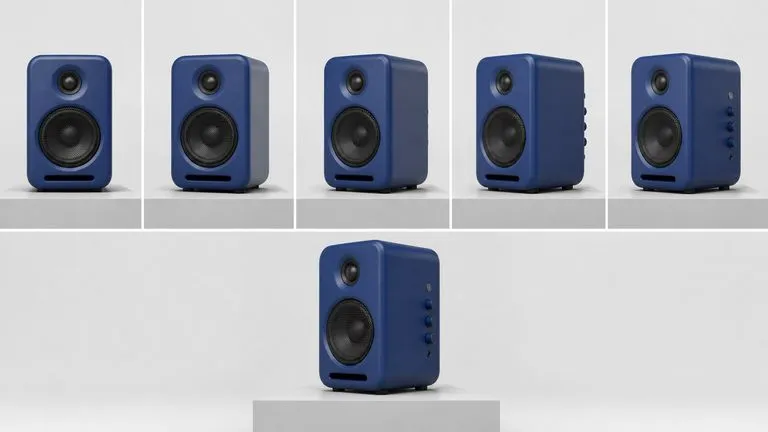
Revelações e rotações simples a partir de um fotograma inicial definido.
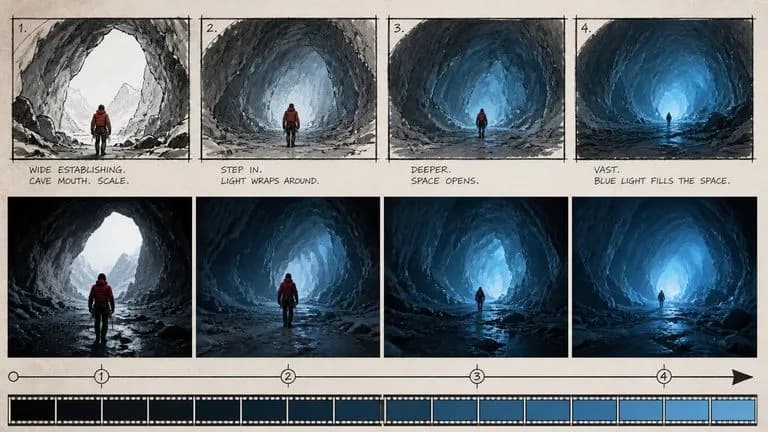
Referência em movimento para uma ideia de plano, antes de assumir qualquer compromisso.
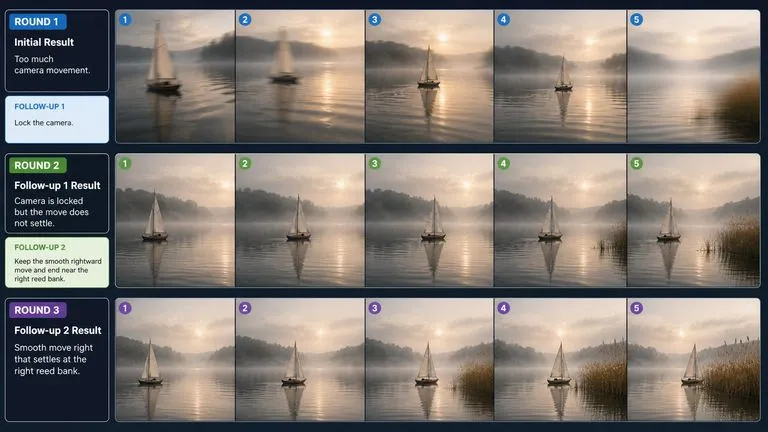
Clipes aperfeiçoados ao longo de várias rondas, em vez de perfeitamente especificados de antemão.
Se tem os fotogramas, use a opção padrão. Se precisa de manter um sujeito entre clipes, use Reference.
Introduza as composições ou o conjunto de exemplos com uma função definida para cada imagem.
Descreva o movimento na cena, o comportamento da câmara e o ritmo. O áudio é gerado com a imagem, por isso vale a pena incluir indicações de diálogo e ambiente.
Ajuste o resultado com uma instrução de seguimento, em vez de reescrever o briefing original.
Um prompt útil para Gemini Omni Flash costuma incluir quatro elementos:
Em vez de escrever
Uma pessoa a abrir uma janela, movimento natural agradável, cinematográfico.
Escreva
Uma pessoa está diante de uma janela de guilhotina, com ambas as mãos no caixilho inferior, vista por trás à altura da cintura. Empurra a janela para cima num único movimento suave até ficar totalmente aberta e depois baixa as mãos. A câmara permanece imóvel durante todo o clipe, sem aproximação nem deslocação. Termine com a janela aberta e os braços ao lado do corpo.
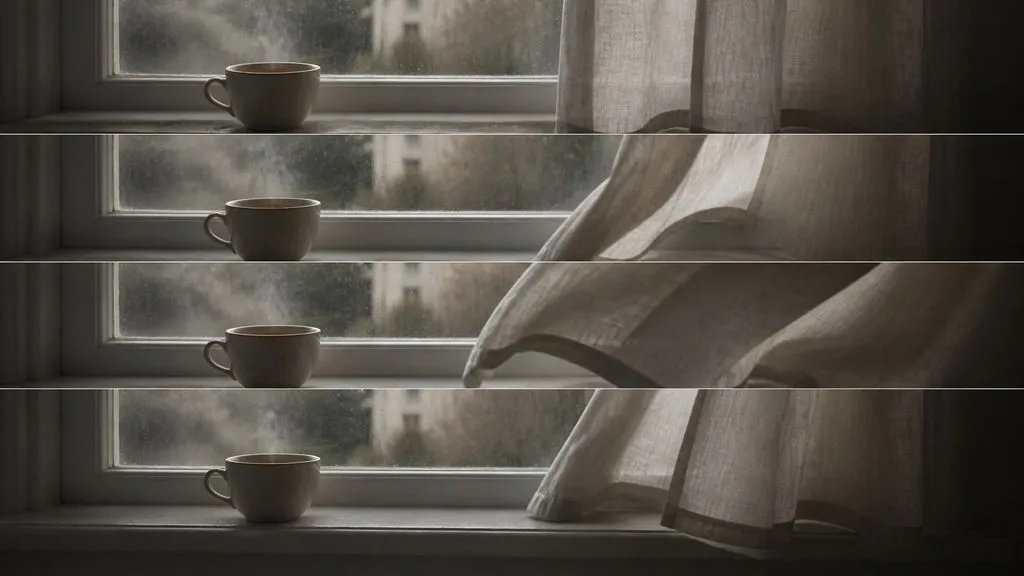
Comece na Imagem 1: uma chávena de chá num peitoril, vapor a subir, cortina imóvel. Uma brisa levanta a cortina pela direita durante a primeira metade do clipe e depois ela assenta. O vapor continua a subir ao longo de todo o clipe. A câmara mantém um plano próximo estático, sem movimento nem cortes. Termine na Imagem 2: cortina assente, chávena inalterada.
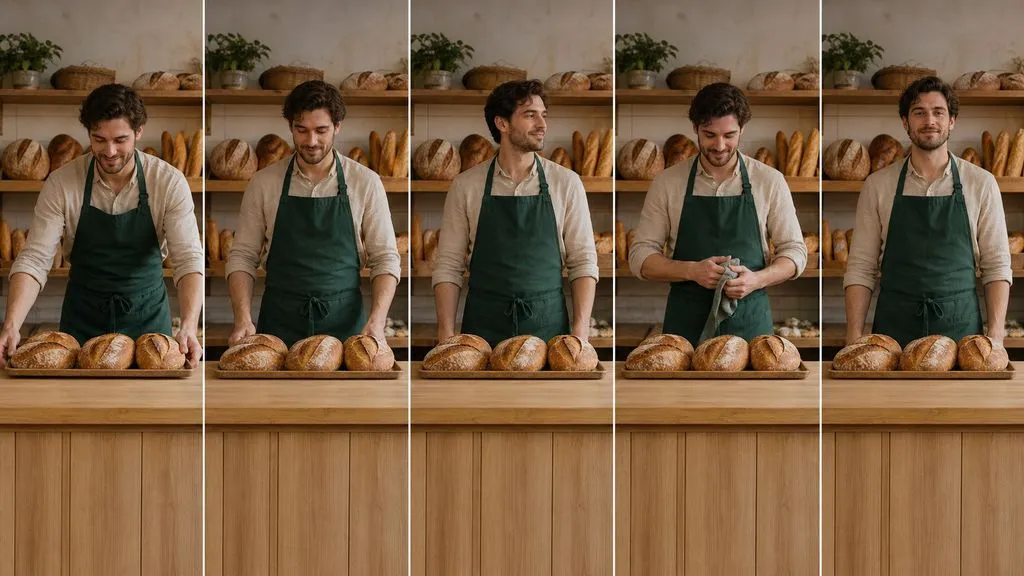
Use a pessoa da Imagem 1, o avental da Imagem 2 e o balcão da padaria da Imagem 3. Ele coloca um tabuleiro de pães no balcão, endireita-se e limpa as mãos ao avental. Um plano médio fixo do lado do cliente do balcão, câmara imóvel. Preserve o rosto, o cabelo e a cor e o corte do avental exatamente como apresentados. Termine com as mãos ao lado do corpo.
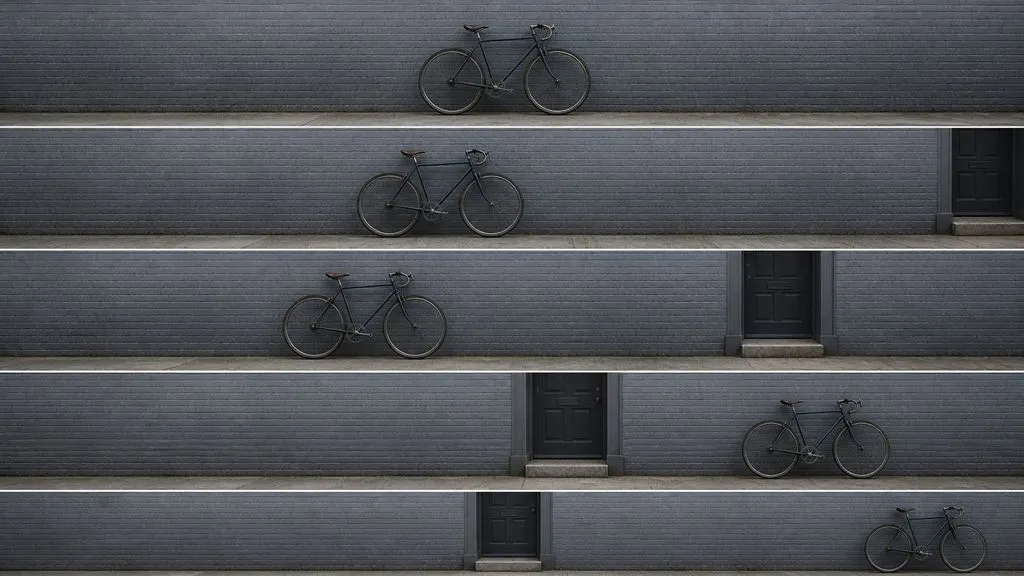
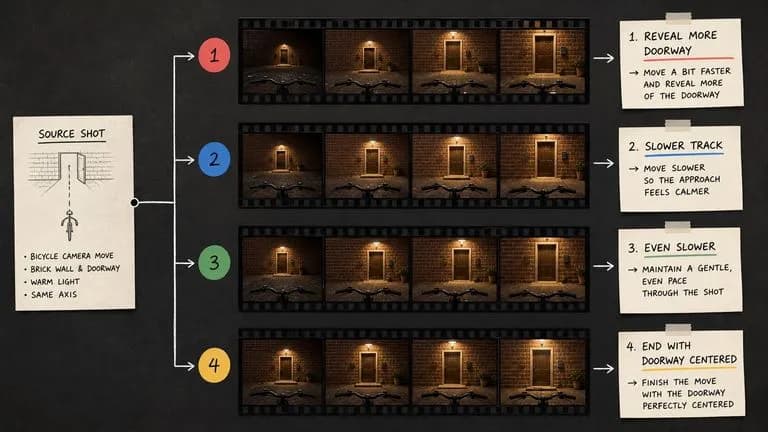
Uma bicicleta encostada a uma parede de tijolo pintada, vista de frente. Nada na cena se move. A câmara desloca-se lentamente para a esquerda a velocidade constante, mantendo a bicicleta no enquadramento e revelando uma entrada à direita dela. Luz uniforme de céu encoberto durante todo o clipe. Termine com a bicicleta na margem direita e a entrada centrada.
| Dimensão | Gemini Omni Flash | Veo 3.1 |
|---|---|---|
| Tipos de entrada | Texto, imagem, vídeo e áudio | Texto e fotogramas |
| Opção por referência | Sim, apresentada separadamente | Não |
| Resultado na Virse | 720P, sem som | 720p a 4K, áudio opcional |
| Objetivo de conceção | Rapidez de resposta | Limite máximo de qualidade |
| Construção de sequências | Aperfeiçoamento por conversa | Extensão de cenas |
| Escolha-o quando | As entradas são variadas ou um sujeito tem de se manter | A peça precisa de duração, áudio ou 4K |
Dê ao movimento um início e um fim claros, em vez de uma descrição em aberto.
Na opção Reference, diga qual imagem fornece o sujeito e qual fornece o cenário.
As imagens de Nano Banana ou Gemini 2.5 Flash Image passam para este modelo sem mudar de caráter visual.
O modelo foi criado para instruções de seguimento. Reescrever todo o briefing desperdiça o que já funcionava.
Prepare imagens de referência e orientações visuais para seu próximo vídeo.
A maioria dos prompts de personagens parece boa para uma pessoa e desmorona-se perante um modelo de imagem, porque a identidade, o mundo e o estilo visual estão espalhados por três frases diferentes em vez de estarem numa só que ele consiga interpretar. Descreva quem são, gere uma versão estruturada e teste-a com uma renderização real diretamente na mesma tela. Os créditos gratuitos cobrem a primeira ronda.
A maioria dos prompts de design falha nos detalhes aborrecidos: proporção errada, cor da marca em falta, nenhuma menção ao texto que tem de caber e onde. Liste o objetivo, o público, o formato e as restrições, e isto escreve um prompt estruturado para que um modelo de imagem consiga realmente acompanhar tudo, começando com créditos Virse gratuitos.
Uma versão de um mood é apenas uma suposição. Dê-lhe uma referência ou um tema escrito e receba algumas leituras diferentes da mesma ideia, com cor, material e imagética compostos em conjunto num só quadro, para haver algo a que reagir em vez de uma página em branco. Os créditos gratuitos são suficientes para começar.
Veo 3.1 da Google DeepMind gera clipes curtos com áudio sincronizado a 48 kHz e estende-os em sequências mais longas, passando os fotogramas finais para a frente.
Gere vídeos cinematográficos de 30 segundos com Seedance 2.5, com áudio sincronizado, referências multimodais e controlo criativo preciso.
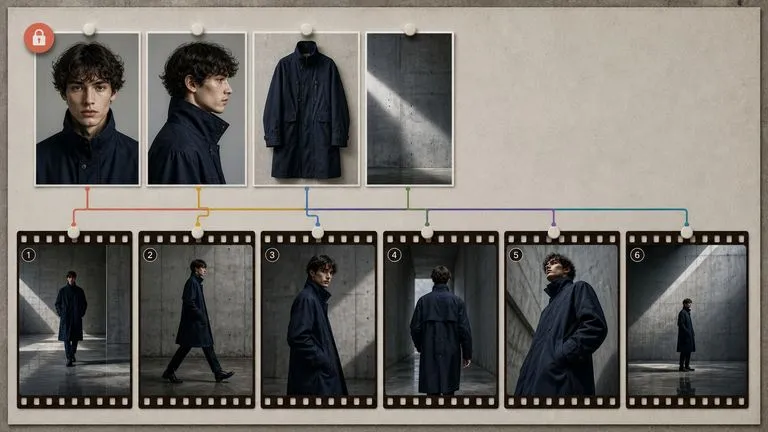
O modelo Hailuo 03 da MiniMax produz vídeo 2K sem som, orientado por um primeiro e um último fotograma ou por um conjunto de imagens de referência.
Anime os fotogramas que os seus modelos de imagem da família Google já produziram ou oriente o plano com um conjunto de referências, sem sair da tela em qualquer dos casos.