
2K nativo, 4K disponível
Resultado padrão em 2K, com 4K disponível para impressão e recortes grandes.
GPT Image 2.0 da OpenAI lê um briefing de cem palavras e tenta cumprir tudo, com controlos independentes de qualidade e resolução de 1K a 4K.
Abra esta página em um navegador de desktop para começar a criar.
GPT Image 2 é o modelo de imagem da OpenAI, e o seu comportamento distintivo é não reduzir uma instrução longa a uma impressão geral.
A maioria dos modelos piora à medida que o briefing aumenta. Acrescente um quinto requisito e o segundo desaparece discretamente; especifique oito objetos e recebe seis. GPT Image 2 foi criado para manter juntas restrições com várias partes, com a OpenAI a indicar uma precisão de cumprimento de instruções de cerca de 98 por cento, e representa texto com precisão próxima do nível do caráter, em vez de aproximar as formas das letras.
Use GPT Image 2 quando a imagem tem requisitos, em vez de apenas uma atmosfera. Crie propostas de embalagens regulamentadas, imagens de produto orientadas por especificações, composições anotadas, naturezas-mortas com vários objetos e tudo o que um revisor vá comparar com uma lista.
GPT Image 2 é um modelo de geração de imagens com IA desenvolvido pela OpenAI, sucessor de GPT Image 1.5 e GPT Image 1 e o modelo que suporta a geração de imagens no ChatGPT. A Virse disponibiliza-o diretamente, com os controlos de qualidade e resolução que a interface de conversa mantém ocultos.
O modelo assenta em três grandes pontos fortes:
GPT Image 2 usa uma arquitetura autorregressiva em vez da abordagem de difusão usada pela maioria dos seus pares, à qual a OpenAI atribui uma geração três a cinco vezes mais rápida do que na versão anterior. O resultado nativo é 2K, com 4K disponível, as proporções vão de 3:1 a 1:3, e a qualidade da renderização pode ser selecionada como baixa, média ou alta, independentemente do tamanho.
Resultado padrão em 2K, com 4K disponível para impressão e recortes grandes.
Baixa, média e alta, escolhidas separadamente do tamanho de saída.
1K, 2K, 3K e 4K, cada um disponível em todos os níveis de qualidade.
Os briefings com várias partes regressam com as partes intactas.
De panoramas largos a imagens verticais altas a partir do mesmo briefing.
Uma abordagem de geração diferente da difusão, à qual é atribuído um ganho de velocidade de 3–5 vezes.
Como o modelo mantém muitas restrições ao mesmo tempo, o detalhe que escreve é o detalhe que recebe. Uma especificação de cem palavras não é esforço desperdiçado aqui, como acontece em modelos que resumem a sua intenção antes de gerar.
Dois controlos em vez de um tornam possíveis tanto um rascunho grande como uma versão final pequena. A maioria dos modelos liga a fidelidade ao tamanho de saída e não permite separá-los.
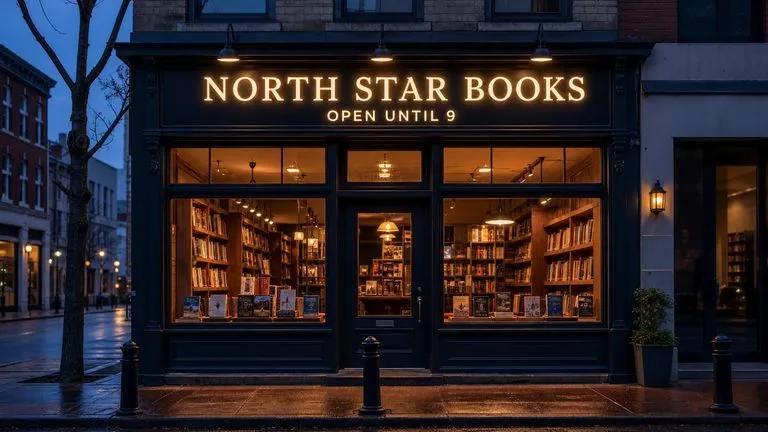
Títulos, rótulos e sinalética surgem legíveis em vez de aproximados, colocando este entre os modelos mais fortes aqui para imagens que contêm palavras.
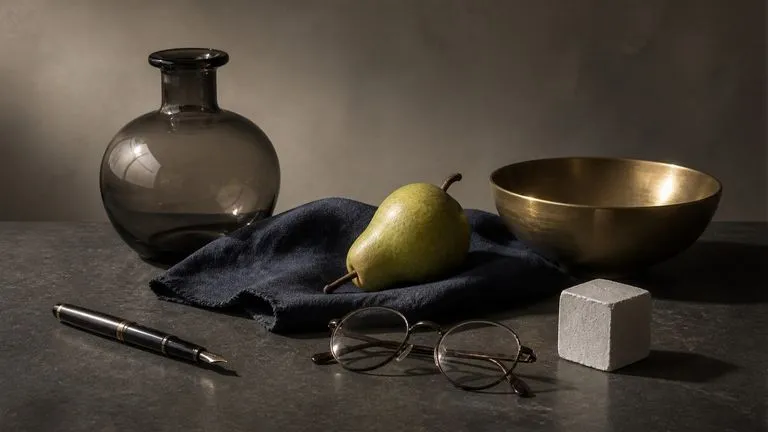
Composições em que vários objetos têm de se relacionar corretamente — assentes em superfícies, projetando sombras correspondentes e partilhando uma direção de luz — mantêm-se coerentes em vez de se tornarem fisicamente absurdas.
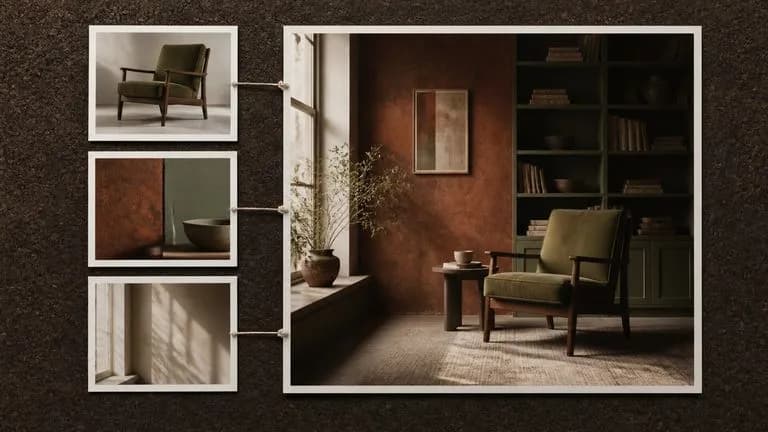
Forneça imagens juntamente com o prompt e o modelo trabalha a partir delas, preservando o que indicar e alterando o que pedir.
O modelo recorre ao mesmo conhecimento subjacente dos seus parentes de texto, o que se revela na forma como lida com objetos, contextos e convenções reais sem que tudo tenha de ser descrito do zero.
Os briefings com requisitos fixos raramente chegam concluídos. São reunidos a partir de uma ficha de especificações, um guia de marca, uma fotografia de referência e três rondas de comentários. A Virse mantém esse material ao lado do resultado. O briefing, as referências que lhe deram origem e cada geração baseada nele ficam numa única tela, pelo que verificar um resultado face aos seus requisitos não implica abrir uma segunda janela.
Coloque a lista de requisitos na tela ao lado da imagem, para que a revisão seja feita face à origem, em vez de recorrer à memória.
Defina a composição no nível baixo e depois execute novamente o briefing idêntico em médio ou alto quando o conteúdo estiver acordado.
Alterne entre GPT Image 2 e mais de 30 outros modelos de imagem e vídeo sem sair da tela nem reescrever o briefing.
Cada ronda de comentários produz uma nova geração ao lado da anterior, mantendo intacto o percurso do primeiro rascunho ao material aprovado.
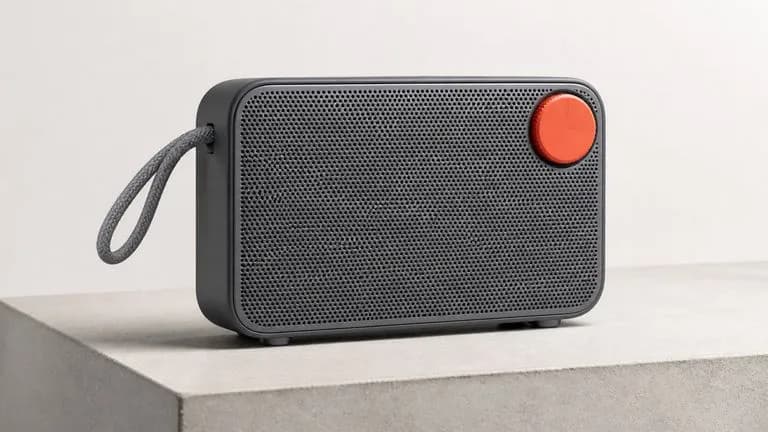
Renderizações que têm de corresponder a uma especificação escrita, até à disposição e ao acabamento.
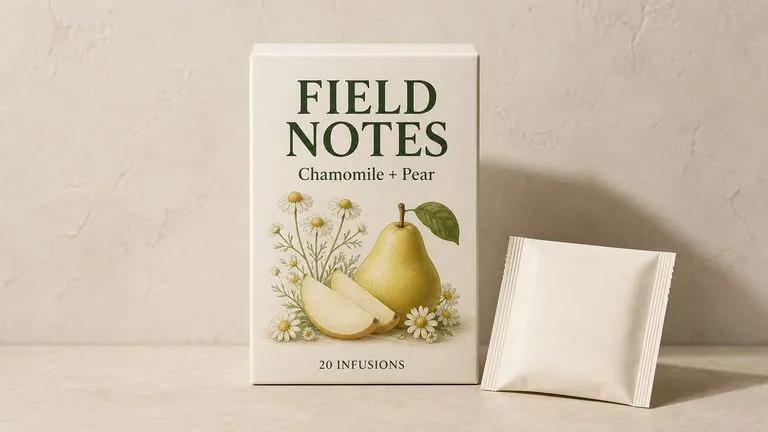
Layouts da frente da embalagem com nomes exatos dos produtos, descritores e texto legalmente obrigatório.
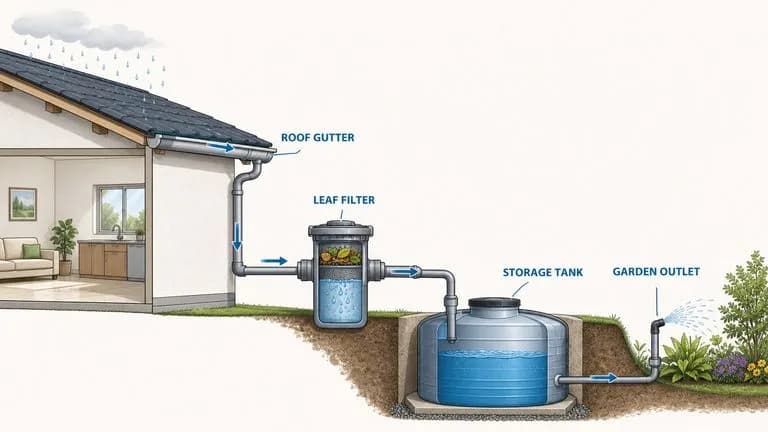
Cortes transversais e gráficos explicativos cujas legendas têm de estar corretas, não ser decorativas.
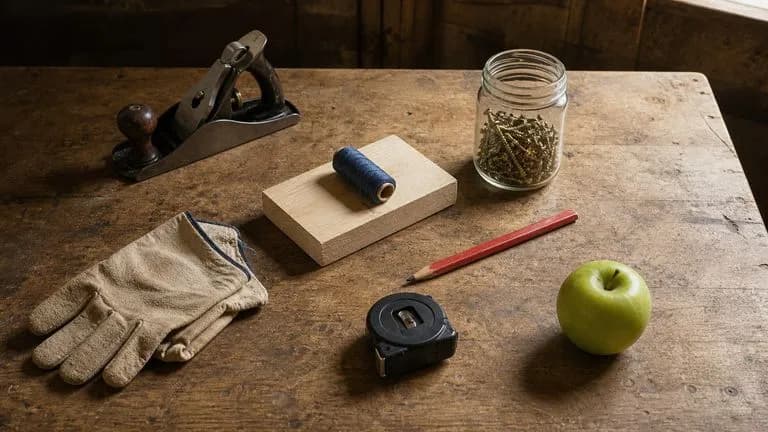
Disposições em que a posição, a escala e a sombra de cada elemento são especificadas.
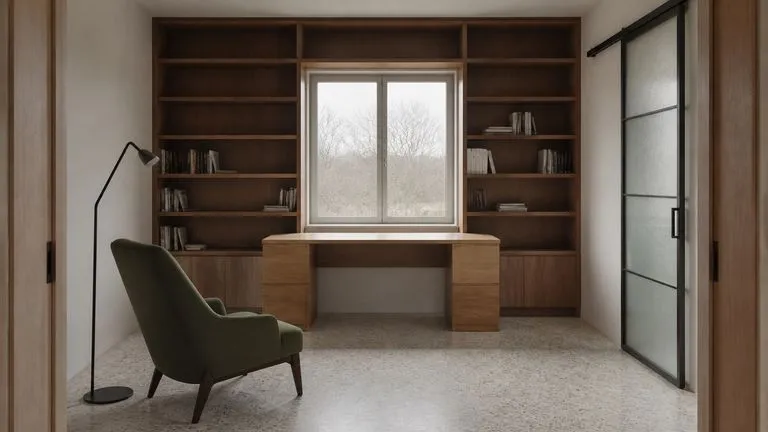
Espaços construídos segundo um plano descrito, em vez de uma atmosfera aproximada.
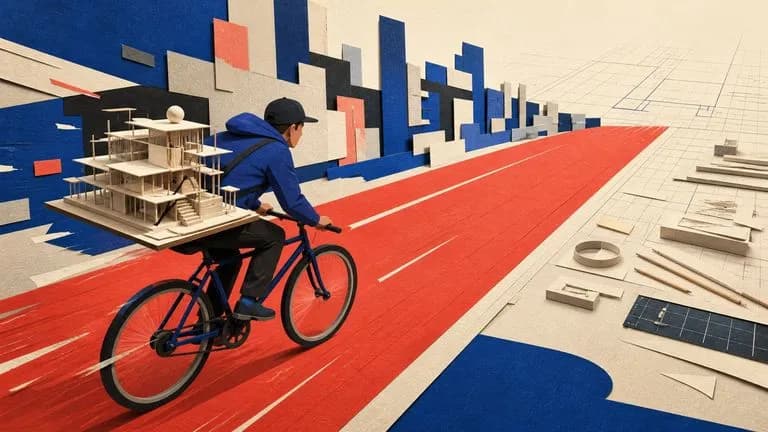
Imagens conceptuais para artigos em que o briefing transmite várias ideias ao mesmo tempo.
Comece no nível mais baixo enquanto ainda decide o que a imagem deve conter.
Enumere todos os elementos, as suas posições e tudo o que tem de ser exato. A extensão é uma vantagem aqui.
Compare item a item, em vez de pela impressão geral, e acrescente a cláusula relativa a tudo o que faltar.
Leve o briefing que funciona para o nível médio ou alto no tamanho pretendido, sem alterações.
Um prompt útil para GPT Image 2 costuma incluir cinco elementos:
Em vez de escrever
Um recanto de leitura acolhedor, quente e convidativo, com bela luz natural.
Escreva
Um assento integrado numa janela saliente, estofado em veludo verde desbotado, com três almofadas diferentes encostadas ao lado esquerdo. Um livro de capa dura está aberto, virado para baixo, no assento. O sol do fim da tarde entra pela direita num ângulo baixo, projetando a sombra da moldura da janela sobre as almofadas. Para lá do vidro, um jardim desfocado. Fotografia de frente a dois metros de distância, com o assento a preencher os dois terços inferiores do enquadramento.
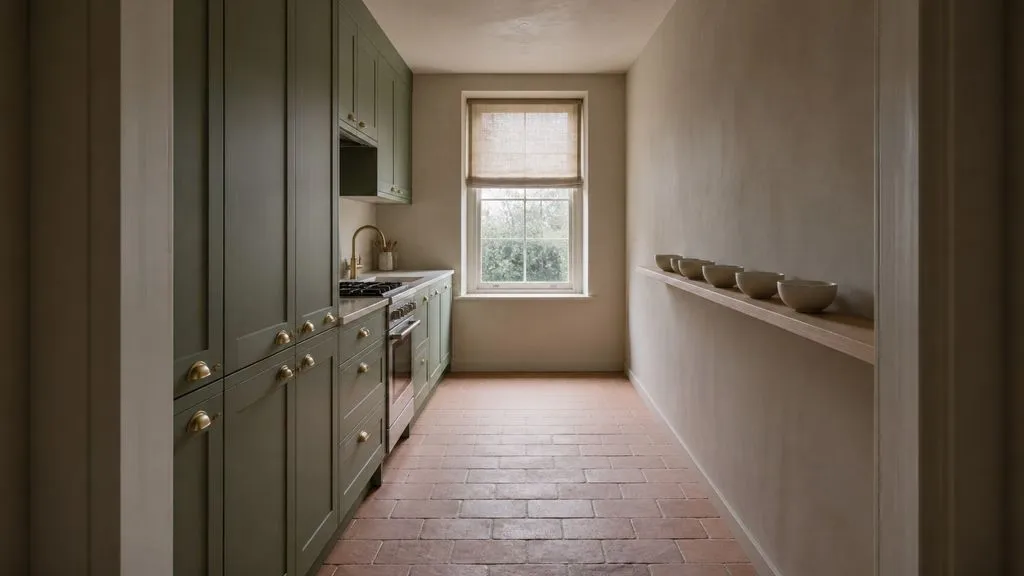
Uma cozinha estreita em corredor fotografada da entrada, de frente, à altura dos olhos. Armários em verde-sálvia mate com puxadores de concha em latão ao longo da parede esquerda. Prateleiras abertas à direita com seis taças de cerâmica branca numa única fila. Uma janela ao fundo com a persiana a meio. Apenas luz natural de céu encoberto vinda da janela, sem luz artificial, sombras suaves. O chão é de ladrilho de terracota não vidrado, disposto em juntas desencontradas.
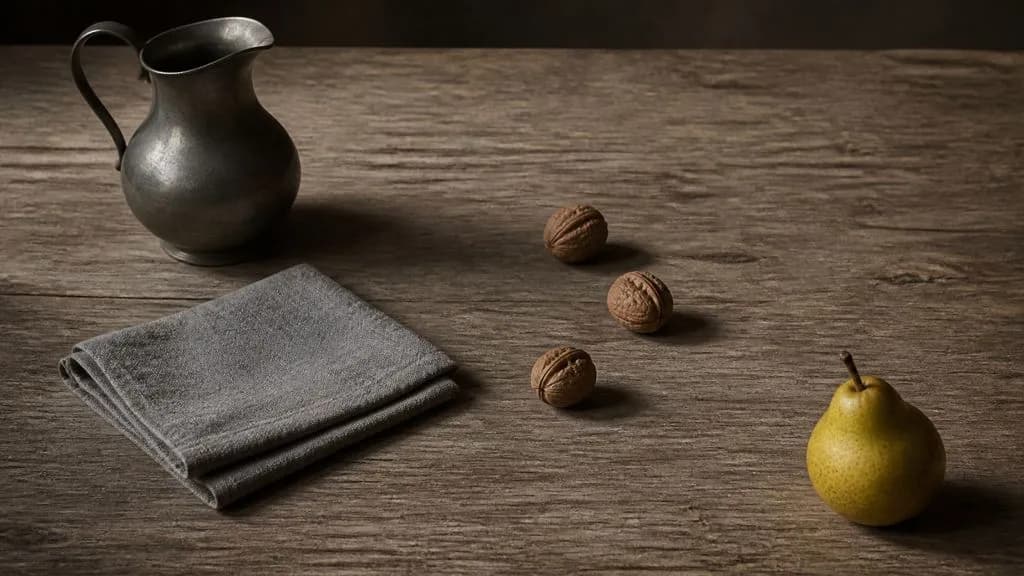
Quatro objetos dispostos numa mesa de carvalho envelhecido, fotografados de cima a 45 graus. Um jarro de estanho ao fundo à esquerda, um pano de linho cinzento dobrado à sua frente, três nozes espalhadas à direita do pano e uma única pera no canto dianteiro direito. Cada objeto projeta uma sombra coerente com uma única fonte de luz no canto superior esquerdo. As nozes estão ligeiramente separadas, sem se tocarem. Paleta suave, contraste contido, veio da madeira visível da esquerda para a direita.
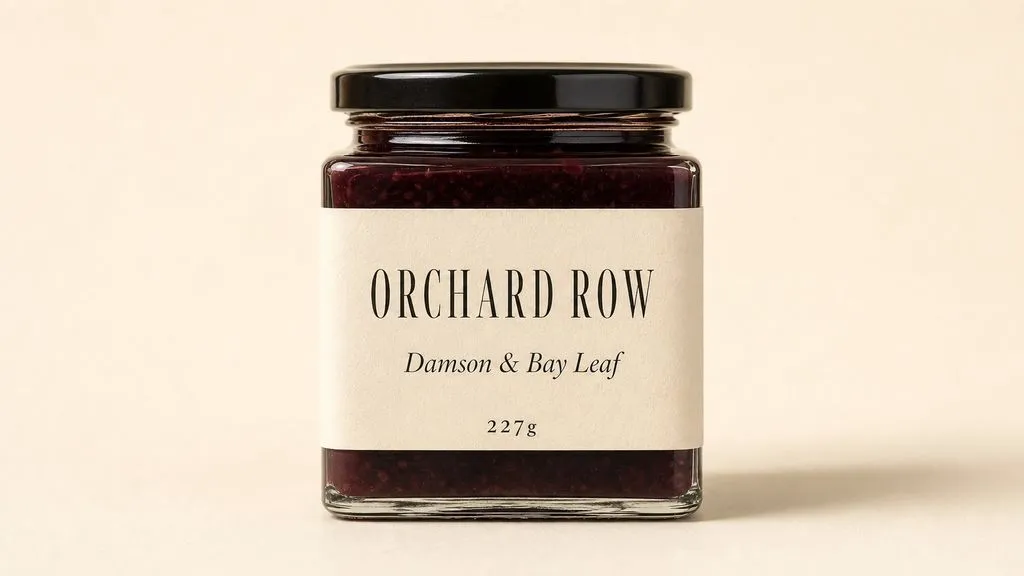
Um frasco retangular de conservas fotografado de frente sobre um fundo creme liso. O rótulo frontal diz ORCHARD ROW num tipo de letra serifado estreito ao longo do terço superior, com "Ameixa e louro" por baixo em itálico a metade do tamanho e "227g" em versaletes na margem inferior. Luz quente e uniforme da frente esquerda, uma sombra suave à direita do frasco. O rótulo ocupa os 60 por cento centrais da altura do frasco, com margens iguais dos dois lados.
| Dimensão | GPT Image 1 | GPT Image 1.5 | GPT Image 2 |
|---|---|---|---|
| Controlo da qualidade | Nenhum | Nenhum | Baixa / Média / Alta |
| Controlo da resolução | Nenhum | Nenhum | 1K / 2K / 3K / 4K |
| Arquitetura | Da era da difusão | Da era da difusão | Autorregressiva |
| Velocidade de geração | Referência | Referência | 3–5 vezes mais rápido do que o antecessor |
| Representação de texto | Aproximada | Melhorada | Próxima do nível do caráter |
| Continua a valer a pena para | Corresponder a um conjunto de materiais existente | Corresponder a um conjunto de materiais existente | Todo o trabalho novo |
Este é um dos raros modelos em que um briefing mais longo devolve uma imagem melhor. O detalhe que omite é detalhe que o modelo escolhe por si.
"Um jarro ao fundo à esquerda" é executável. "Um jarro" deixa a colocação ao acaso, e a colocação costuma ser o tema dos comentários de revisão.
As palavras que devem aparecer na imagem têm de aparecer no prompt. Texto descrito transforma-se em texto inventado.
A qualidade altera o grau de perfeição da renderização; o tamanho altera as dimensões. Alterar ambos de uma vez torna impossível saber qual produziu a diferença.
Explore ferramentas especializadas para criar, editar e preparar recursos de design.
A maioria dos prompts de design falha nos detalhes aborrecidos: proporção errada, cor da marca em falta, nenhuma menção ao texto que tem de caber e onde. Liste o objetivo, o público, o formato e as restrições, e isto escreve um prompt estruturado para que um modelo de imagem consiga realmente acompanhar tudo, começando com créditos Virse gratuitos.
Letras entalhadas em madeira comportam-se de forma diferente sob a luz do que letras fundidas em metal líquido, e nenhum prompt único acerta em ambos por acaso. Escreva o seu texto, indique o material e receba um efeito que mantém o texto intacto enquanto determina como esse material deve realmente captar a luz. Os créditos gratuitos dão-lhe a primeira versão.
Uma página que nunca é construída não custa uma semana de trabalho de um programador. Carregue as suas fotografias de produto e argumentos de venda, e veja o visual da página completa antes de alguém tocar num construtor de páginas, imagem hero, blocos de benefícios, oferta final, tudo num só scroll, e a primeira versão é por nossa conta.
Gere imagens 4K de nível de estúdio com Nano Banana Pro, combinando várias referências e mantendo personagens, produtos e tipografia consistentes.
O Qwen Image 3.0 Pro da Alibaba renderiza a tipografia como linguagem em uma dúzia de sistemas de escrita, mantendo a legibilidade até em dez pixels em layouts densos.
O modelo de segunda geração da Reve AI constrói uma composição de elementos posicionados e individualmente identificáveis antes de renderizar, para que uma disposição especificada regresse devidamente disposta.
Escreva a lista de requisitos, entregue-a por inteiro e reveja o resultado com base na lista, em vez de numa sensação.