
2K natif, 4K disponible
Sortie standard en 2K, avec 4K disponible pour l’impression et les recadrages importants.
GPT Image 2.0 d’OpenAI lit un descriptif de cent mots et tente de l’appliquer entièrement, avec des réglages indépendants de qualité et de résolution allant de 1K à 4K.
Ouvrez cette page sur un navigateur de bureau pour commencer à créer.
GPT Image 2 est le modèle d’image d’OpenAI. Sa caractéristique majeure : une longue instruction n’est pas réduite à une impression générale.
La plupart des modèles perdent en qualité lorsque le descriptif s’allonge. Ajoutez une cinquième exigence et la deuxième disparaît discrètement ; indiquez huit objets et vous en obtenez six. GPT Image 2 est conçu pour maintenir ensemble plusieurs contraintes, avec une précision de suivi des instructions annoncée par OpenAI autour de 98 %, et un texte rendu presque au caractère près plutôt qu’une approximation des lettres.
Utilisez GPT Image 2 lorsque l’image répond à des exigences plutôt qu’à une ambiance. Créez des maquettes d’emballage réglementées, des images de produits guidées par des spécifications, des mises en page annotées, des natures mortes à plusieurs objets et tout résultat qui sera vérifié par rapport à une liste.
GPT Image 2 est un modèle de génération d’images par IA développé par OpenAI, successeur de GPT Image 1.5 et GPT Image 1, qui sous-tend la génération d’images dans ChatGPT. Virse y donne accès directement, avec les réglages de qualité et de résolution que l’interface de discussion masque.
Le modèle repose sur trois atouts majeurs :
GPT Image 2 utilise une architecture autorégressive plutôt que la diffusion adoptée par la plupart de ses pairs, à laquelle OpenAI attribue une génération trois à cinq fois plus rapide que la version précédente. La sortie native est en 2K avec 4K disponible, les formats vont de 3:1 à 1:3, et la qualité du rendu se choisit entre basse, moyenne et haute, indépendamment de la taille.
Sortie standard en 2K, avec 4K disponible pour l’impression et les recadrages importants.
Basse, moyenne et haute, choisies indépendamment de la taille de sortie.
1K, 2K, 3K et 4K, chacune disponible à tous les niveaux de qualité.
Les descriptifs en plusieurs parties donnent des résultats préservant chaque partie.
Des panoramas larges aux formats verticaux élancés à partir du même descriptif.
Une approche différente de la diffusion, créditée d’un gain de vitesse de 3 à 5 fois.
Le modèle conserve de nombreuses contraintes à la fois : les détails écrits se retrouvent dans le résultat. Un descriptif de cent mots n’est pas un effort perdu comme avec les modèles qui résument votre intention avant de générer.
Deux réglages distincts permettent aussi bien une grande ébauche qu’un petit rendu final. La plupart des modèles lient fidélité et taille de sortie sans permettre de les séparer.
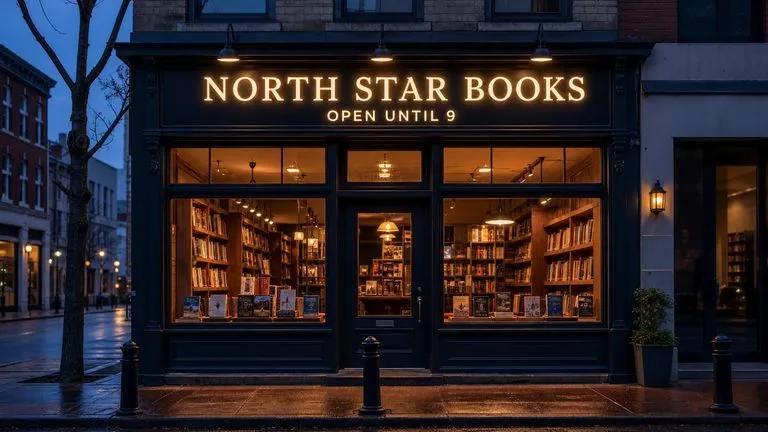
Titres, étiquettes et enseignes ressortent lisibles plutôt qu’approximatifs, ce qui place ce modèle parmi les plus solides ici pour les images contenant des mots.
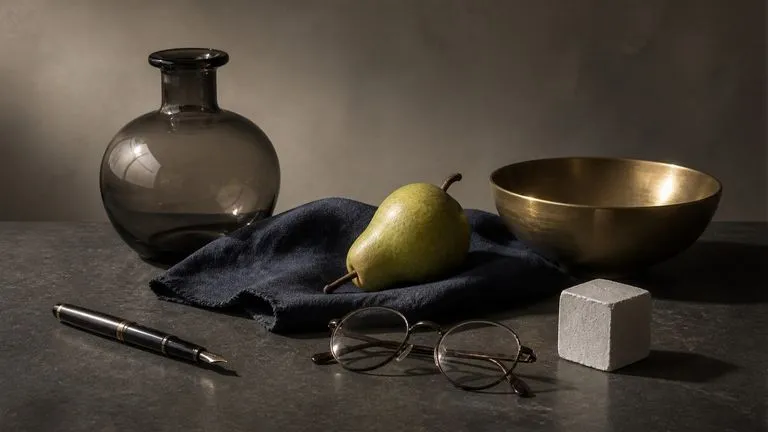
Les compositions où plusieurs objets doivent entretenir des rapports corrects — posés sur des surfaces, projetant des ombres cohérentes et partageant la même direction lumineuse — restent cohérentes sans dériver vers l’absurdité physique.
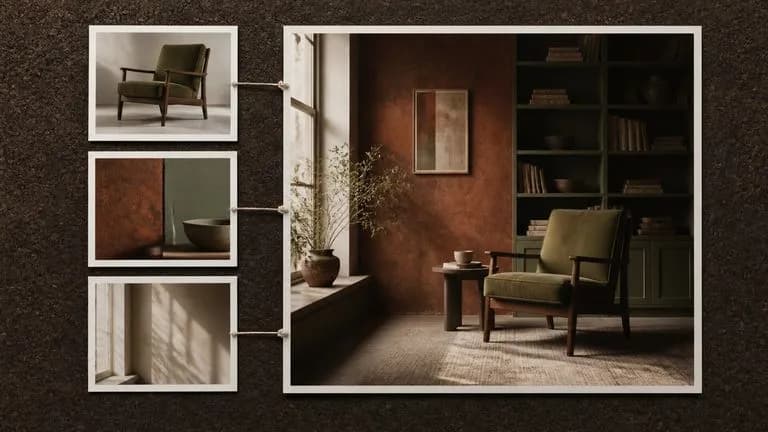
Fournissez des images avec le prompt : le modèle s’appuie dessus, préserve ce que vous nommez et modifie ce que vous demandez.
Le modèle puise dans les mêmes connaissances sous-jacentes que ses homologues textuels. Cela se voit dans sa gestion des objets réels, des contextes et des conventions sans devoir tout décrire de zéro.
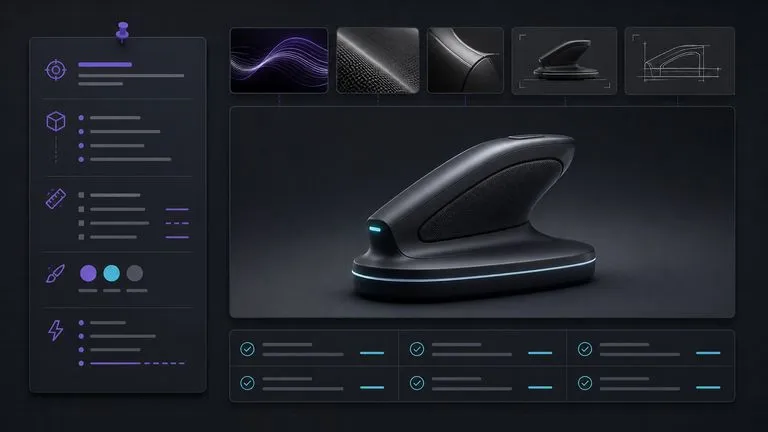
Les descriptifs aux exigences fixes arrivent rarement finalisés. Ils s’assemblent à partir d’une fiche technique, d’une charte de marque, d’une photo de référence et de trois séries de retours. Virse garde ces éléments près du résultat. Le descriptif, les références dont il provient et chaque génération restent sur un même canevas : vérifier un résultat par rapport aux exigences ne nécessite pas d’ouvrir une seconde fenêtre.
Placez la liste des exigences sur le canevas, près de l’image, pour vérifier à partir de la source plutôt que de mémoire.
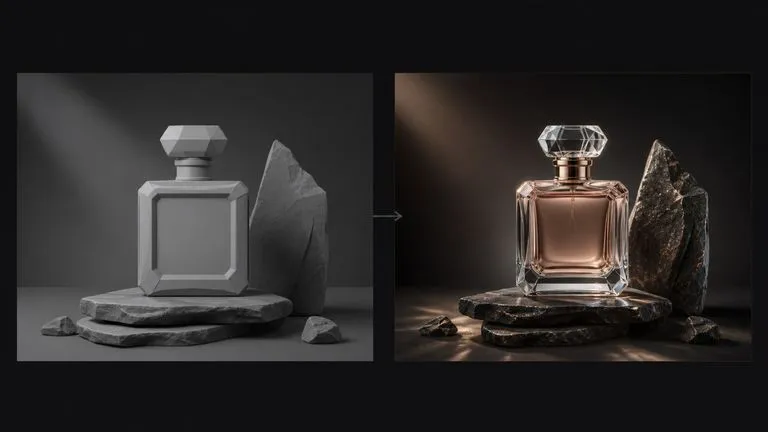
Fixez la composition en qualité basse, puis relancez le même descriptif en qualité moyenne ou haute une fois le contenu validé.
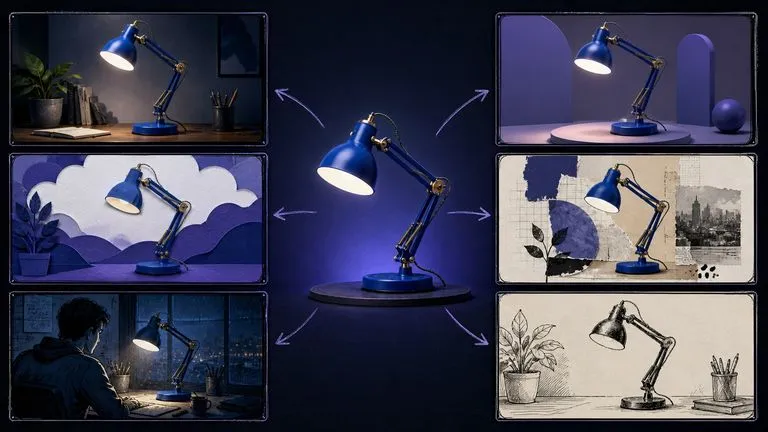
Passez de GPT Image 2 à plus de 30 autres modèles d’image et de vidéo sans quitter le canevas ni réécrire le descriptif.
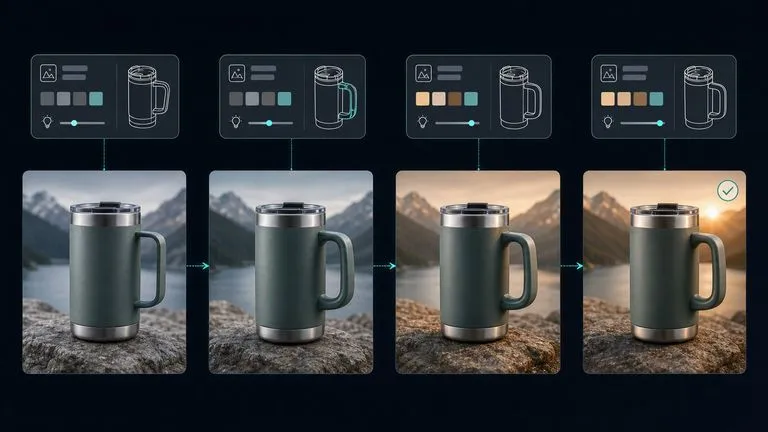
Chaque série de retours produit une nouvelle génération à côté de la précédente : le parcours de la première ébauche au visuel validé reste intact.
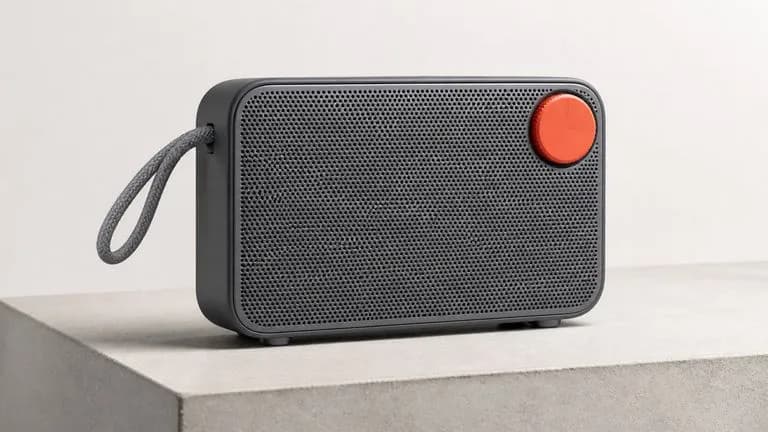
Rendus devant respecter des spécifications écrites jusque dans la disposition et la finition.
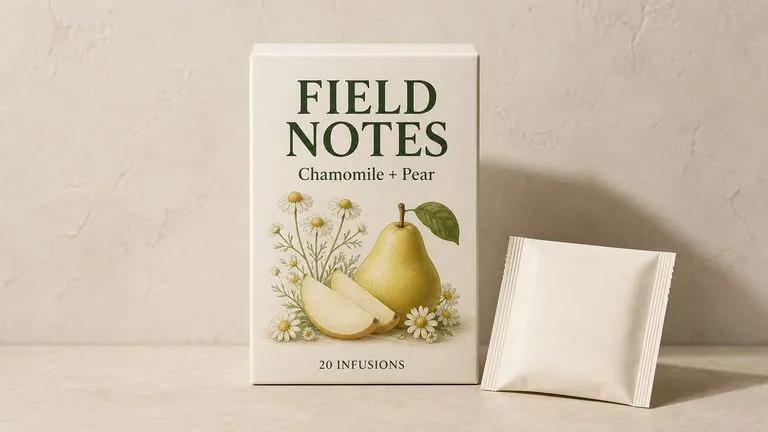
Mises en page de faces avant d’emballage comportant les noms exacts des produits, des descriptifs et les mentions légalement requises.
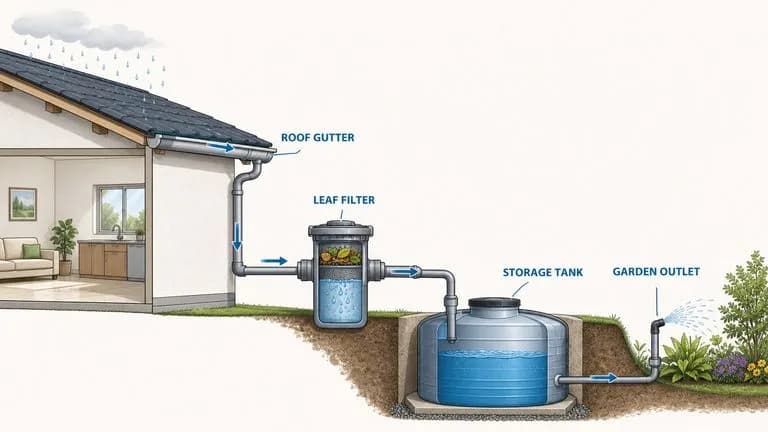
Coupes et schémas explicatifs dont les légendes doivent être exactes, pas décoratives.
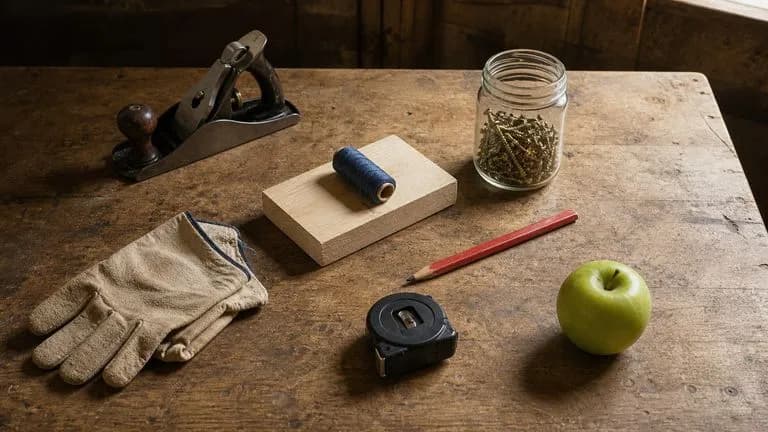
Compositions où la position, l’échelle et l’ombre de chaque élément sont précisées.
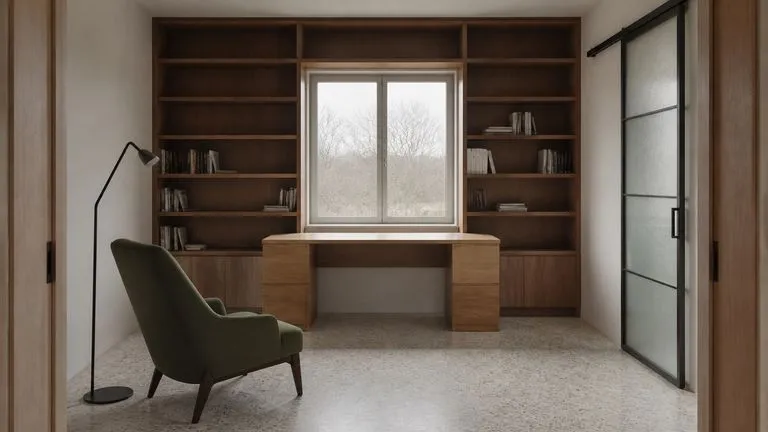
Espaces construits selon un plan décrit plutôt qu’une ambiance approximative.
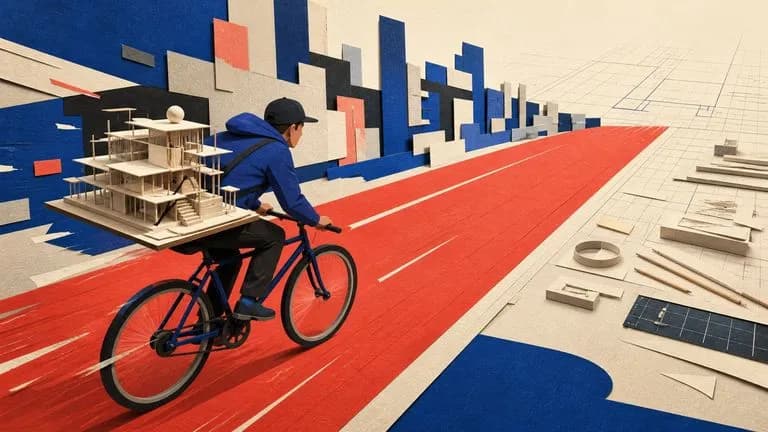
Visuels conceptuels pour des articles dont le descriptif réunit plusieurs idées.
Commencez au niveau le plus bas tant que vous décidez encore du contenu de l’image.
Listez chaque élément, sa position et tout ce qui doit être exact. La longueur est ici un avantage.
Comparez élément par élément plutôt que selon l’impression générale, puis ajoutez une clause pour chaque élément manquant.
Reprenez le descriptif fonctionnel sans le modifier, en qualité moyenne ou haute et à la taille cible.
Un prompt GPT Image 2 utile comprend généralement cinq éléments :
Au lieu d’écrire
Un coin lecture douillet, chaleureux et accueillant, avec une belle lumière naturelle.
Écrivez
Une banquette intégrée dans une fenêtre en saillie, tapissée de velours vert passé, avec trois coussins dépareillés poussés contre le côté gauche. Un livre relié repose ouvert, face contre l’assise. Le soleil de fin d’après-midi entre bas par la droite et projette l’ombre du cadre de fenêtre sur les coussins. Derrière la vitre, un jardin flou. Vue de face à deux mètres, la banquette occupant les deux tiers inférieurs du cadre.
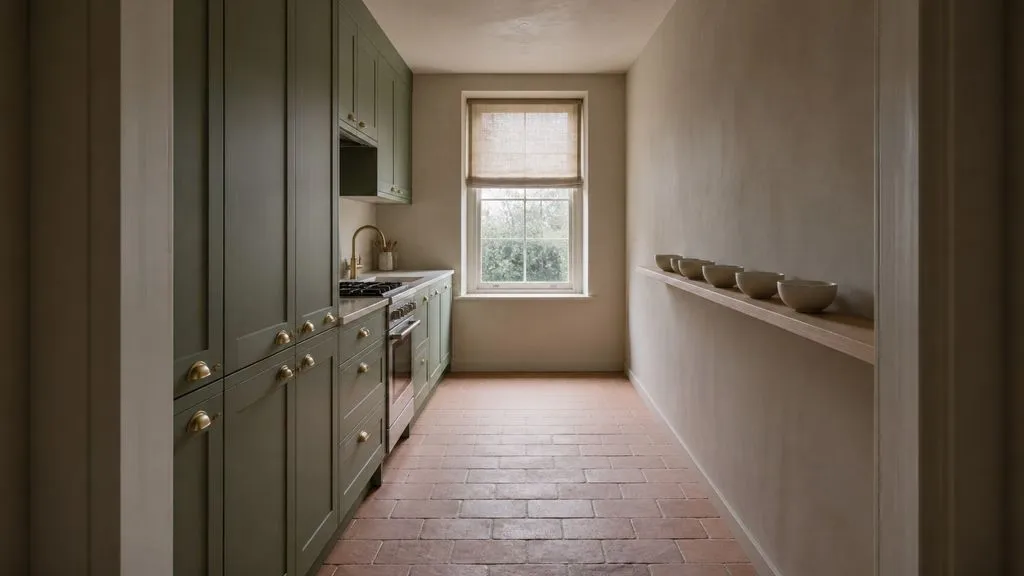
Une cuisine étroite en longueur photographiée depuis l’entrée, de face, à hauteur des yeux. Des meubles vert sauge mat aux poignées coquille en laiton le long du mur gauche. Des étagères ouvertes à droite portant six bols en céramique blanche sur une seule rangée. Une fenêtre au fond avec le store baissé à moitié. Uniquement la lumière d’un ciel couvert par la fenêtre, aucune lumière artificielle, ombres douces. Le sol est carrelé de terre cuite non émaillée à joints décalés.
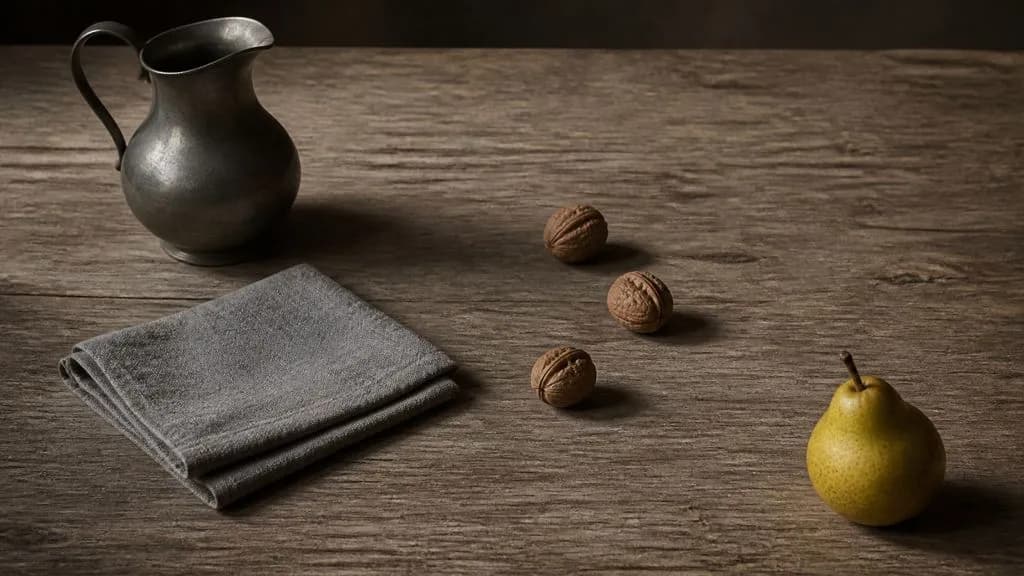
Quatre objets disposés sur une table en chêne patiné, photographiés à 45 degrés au-dessus. Un pichet en étain au fond à gauche, un linge gris en lin plié devant lui, trois noix éparpillées à droite du linge et une seule poire dans le coin avant droit. Chaque objet projette une ombre cohérente avec une source lumineuse unique en haut à gauche. Les noix sont légèrement espacées, sans se toucher. Palette assourdie, contraste modéré, veinage du bois visible de gauche à droite.
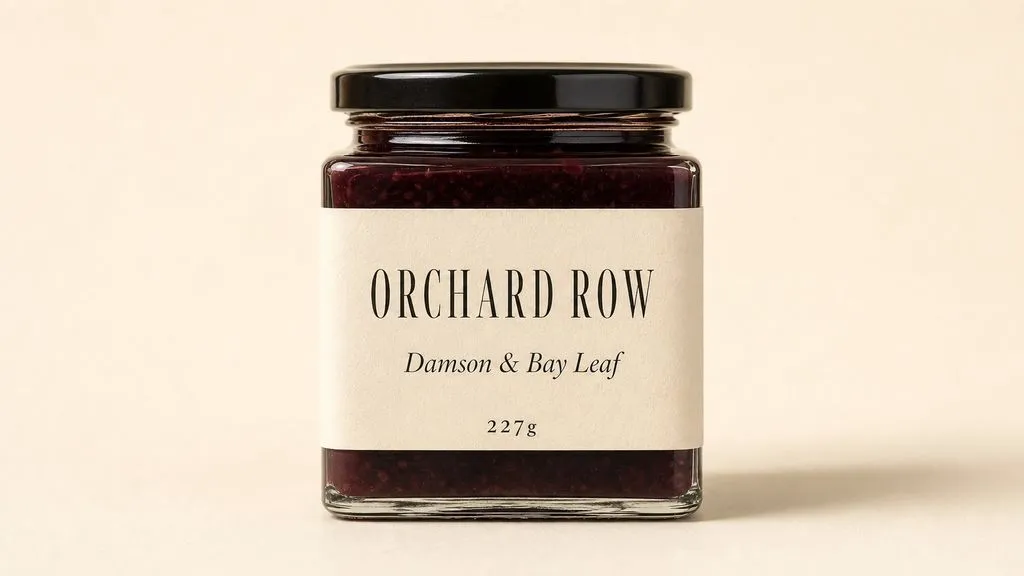
Un bocal rectangulaire de conserve photographié de face sur un fond crème uni. L’étiquette avant porte ORCHARD ROW dans une police étroite à empattement sur le tiers supérieur, puis « Damson & Bay Leaf » en italique à la moitié de cette taille et « 227g » en petites capitales au bord inférieur. Lumière chaude et homogène depuis l’avant gauche, une ombre douce à droite du bocal. L’étiquette occupe les 60 pour cent centraux de la hauteur du bocal, avec des marges égales de chaque côté.
| Critère | GPT Image 1 | GPT Image 1.5 | GPT Image 2 |
|---|---|---|---|
| Réglage de qualité | Aucun | Aucun | Basse / Moyenne / Haute |
| Réglage de résolution | Aucun | Aucun | 1K / 2K / 3K / 4K |
| Architecture | Ère de la diffusion | Ère de la diffusion | Autorégressive |
| Vitesse de génération | Référence de base | Référence de base | 3 à 5 fois plus rapide que son prédécesseur |
| Rendu du texte | Approximatif | Amélioré | Presque au caractère près |
| Reste utile pour | S’accorder à un ensemble de visuels existants | S’accorder à un ensemble de visuels existants | Tous les nouveaux projets |
C’est un des rares modèles où un descriptif plus long donne une meilleure image. Tout détail omis est un détail que le modèle choisit à votre place.
« Un pichet au fond à gauche » est exploitable. « Un pichet » laisse sa place au hasard, alors que le placement concentre souvent les retours de révision.
Les mots devant figurer dans l’image doivent apparaître dans le prompt. Décrire un texte conduit à un texte inventé.
La qualité change la finesse du rendu ; la taille change ses dimensions. Modifier les deux à la fois empêche de savoir lequel a produit la différence.
Découvrez des outils spécialisés pour créer, modifier et préparer vos ressources de design.
La plupart des prompts de design échouent sur les détails ingrats : mauvais ratio d’image, couleur de marque manquante, aucune mention du texte qui doit tenir à tel ou tel endroit. Indiquez l’objectif, l’audience, le format et les contraintes, et cet outil rédige un prompt structuré pour qu’un modèle d’image puisse réellement les prendre tous en compte, en commençant avec des crédits Virse gratuits.
Des lettres sculptées dans le bois réagissent à la lumière différemment de lettres coulées dans du métal liquide, et aucun prompt unique ne réussit les deux par hasard. Saisissez votre texte, indiquez la matière, et obtenez un effet qui préserve le libellé tout en déterminant comment cette matière doit réellement capter la lumière. Les crédits gratuits vous offrent la première version.
Une page qui n’est jamais construite ne coûte pas une semaine de développeur. Importez vos photos produit et vos arguments de vente, puis visualisez la page complète avant que quiconque ne touche à un constructeur de pages : hero shot, blocs de bénéfices, offre finale, le tout dans un seul défilement, et la première version est offerte.
Générez des images 4K de qualité studio avec Nano Banana Pro, en combinant plusieurs références tout en préservant la cohérence des personnages, produits et textes.
Qwen Image 3.0 Pro d’Alibaba rend le texte comme du langage dans une douzaine de systèmes d’écriture, en maintenant sa lisibilité jusqu’à dix pixels dans les compositions denses.
Le modèle de deuxième génération de Reve AI construit une mise en page d’éléments positionnés et individuellement identifiables avant le rendu, pour restituer la disposition demandée.
Écrivez la liste des exigences, transmettez-la entièrement et vérifiez le résultat par rapport à cette liste plutôt qu’à une impression.