
Une seule image d’ouverture
Une seule image constitue toute l’entrée visuelle.
Le modèle vidéo IA Happy Horse 1.0 n’a besoin que d’une image fixe et d’une phrase pour animer l’image que vous avez déjà.
Ouvrez cette page sur un navigateur de bureau pour commencer à créer.
Le modèle vidéo IA Happy Horse demande moins de données que tous les autres modèles vidéo de Virse, et cette simplicité est sa raison d’être.
La plupart des modèles vidéo demandent plus que ce dont vous disposez : une première et une dernière image, plusieurs références aux rôles définis, un descriptif couvrant caméra et conception sonore. Si vous n’avez qu’une image et voulez la voir bouger, ils vous obligent à inventer du matériel absent. Celui-ci part de votre situation réelle : une seule image d’ouverture et une description de la suite.
Utilisez le modèle vidéo IA Happy Horse lorsque le point de départ existe déjà. Animez une photographie, donnez vie à une image générée, testez une idée en mouvement et produisez des clips courts sans assembler d’abord un descriptif.
Happy Horse 1.0 est un modèle de génération vidéo à 15 milliards de paramètres reposant sur un Transformer unifié à flux unique, le premier à générer image et son dans une seule passe d’inférence plutôt qu’en étapes séparées. Il est entré en tête du classement de tests à l’aveugle d’Artificial Analysis en avril 2026 et est publié en code ouvert sous licence commerciale.
Le modèle repose sur trois atouts majeurs :
Les clips durent cinq à huit secondes, avec des formats 16:9, 9:16, 4:3, 21:9 et 1:1. La configuration proposée dans Virse génère l’audio avec l’image, à partir d’une seule image d’ouverture et d’un prompt écrit.
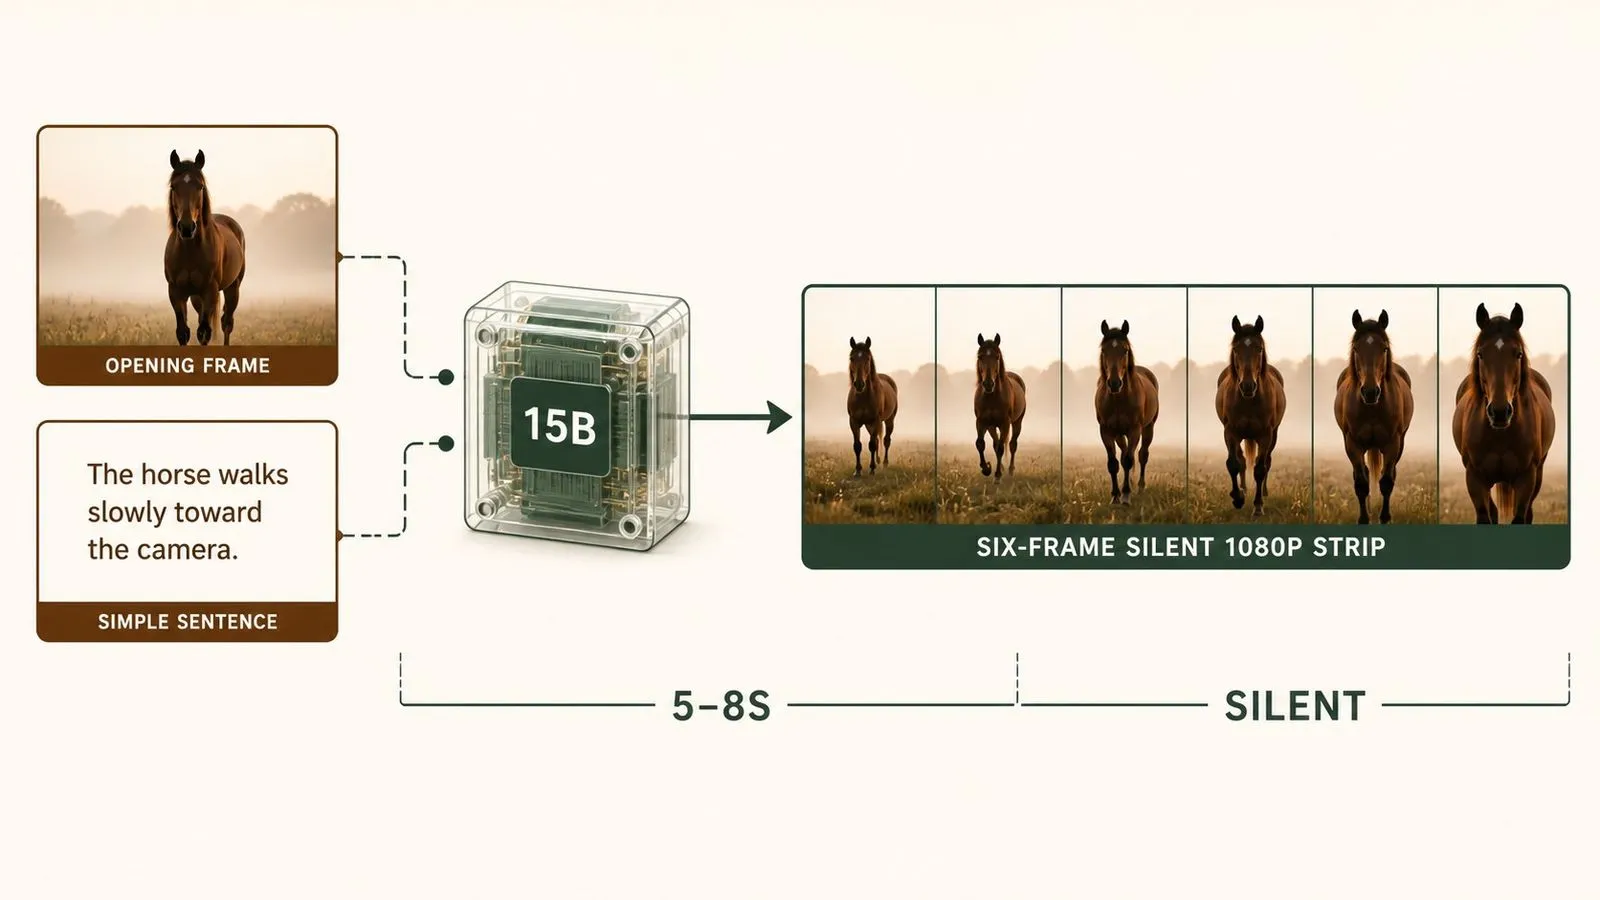
Une seule image constitue toute l’entrée visuelle.
Un Transformer unifié à flux unique plutôt qu’une chaîne à plusieurs étapes.
Image et son générés ensemble dans le modèle sous-jacent.
Sortie Full HD, sans agrandissement artificiel.
Durée du clip en une seule passe.
16:9, 9:16, 4:3, 21:9 et 1:1.
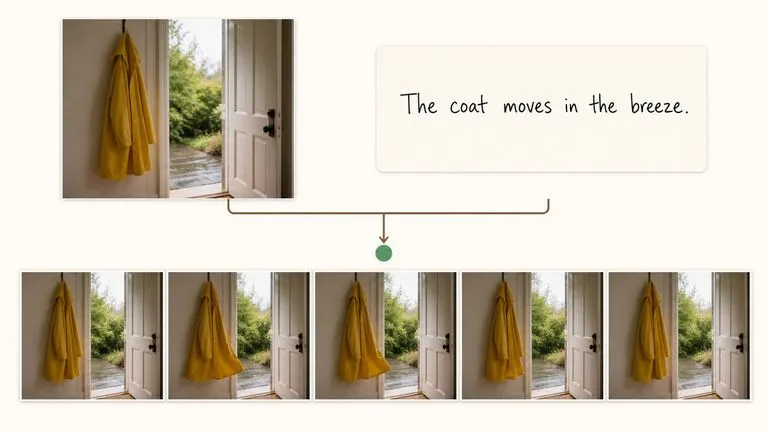
Une image et une phrase suffisent. Aucun ensemble de références à assembler ni image finale à concevoir : c’est le chemin le plus rapide pour voir bouger une image déjà disponible.
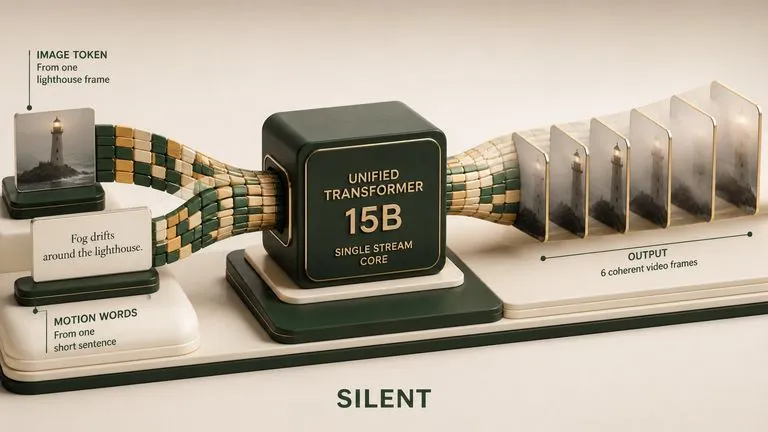
Le modèle a été conçu pour démontrer la génération conjointe d’audio et de vidéo en une passe, plutôt que de produire un clip silencieux puis de le sonoriser ; il a ainsi atteint la tête d’un classement en test à l’aveugle.
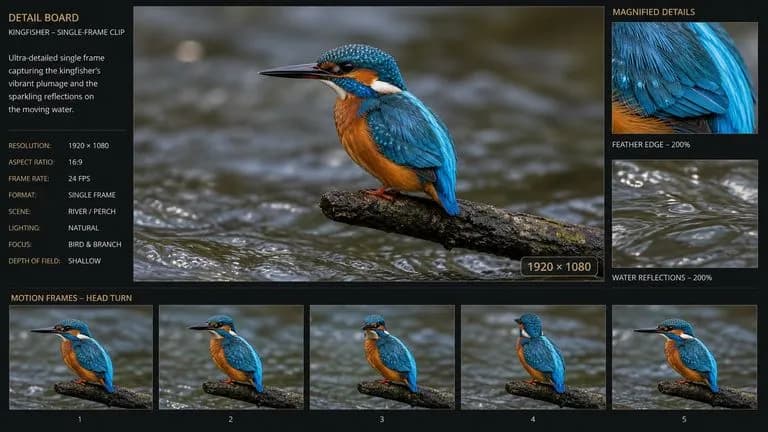
La Full HD sort directement du modèle. Pour un modèle guidé par une seule image, ce plafond dépasse ce que ses exigences d’entrée laissent supposer.
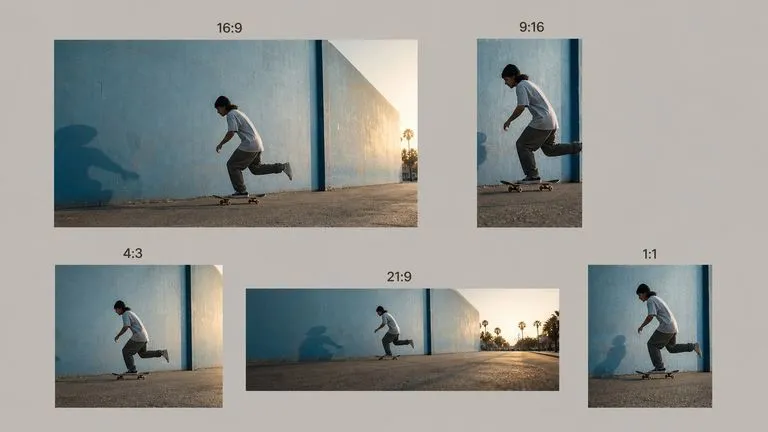
Paysage, vertical, carré et ultralarge à partir du même descriptif : un atout lorsqu’un clip doit paraître à plusieurs endroits.
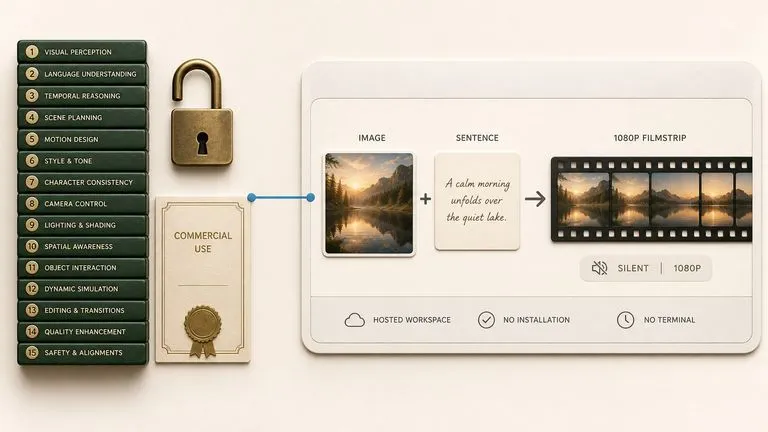
Le modèle est publié ouvertement avec usage commercial autorisé ; dans Virse, il fonctionne comme un service hébergé sans installation.
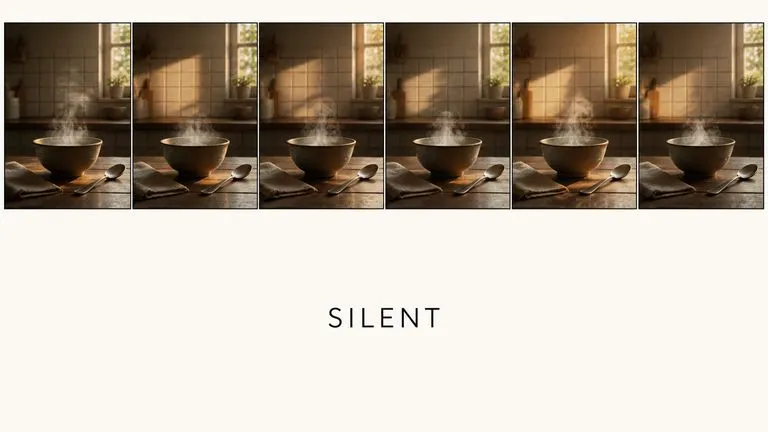
Le son est généré avec l’image dans la même passe, sans option pour le désactiver.
Un modèle à une seule image change ce qui mérite un essai. Lorsque l’entrée est une image déjà disponible, la question n’est plus de savoir s’il faut préparer un descriptif, mais simplement si vous êtes curieux. Virse rend cette curiosité peu coûteuse à satisfaire. Toute image fixe du canevas, générée par un modèle d’image ou importée d’ailleurs, peut être transmise au modèle vidéo IA Happy Horse sans quitter l’espace de travail.
Prenez n’importe quelle image fixe déjà dans l’espace de travail et animez-la sans l’exporter.
Vérifiez si une composition fonctionne en mouvement avant d’investir dans des références pour un modèle plus lourd.
Passez du modèle vidéo IA Happy Horse à plus de 30 autres modèles d’image et de vidéo sans quitter le canevas ni réécrire le descriptif.
Lorsqu’un plan doit finir sur une composition précise, transmettez la même image à un modèle acceptant les deux extrémités.
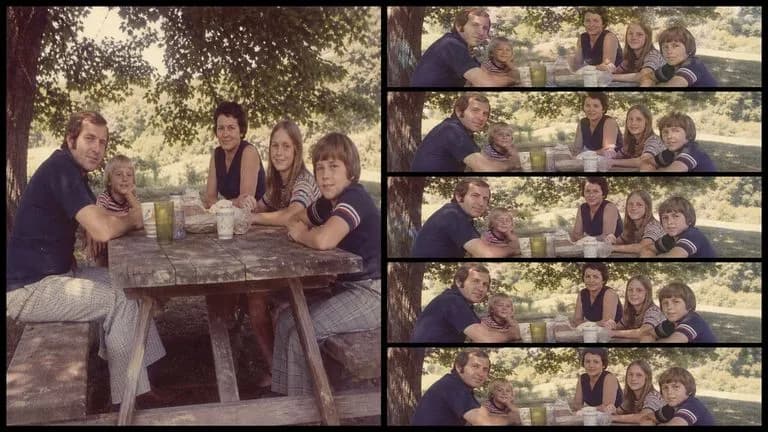
Du mouvement ajouté à une photo produit, un lieu ou un portrait déjà disponible.
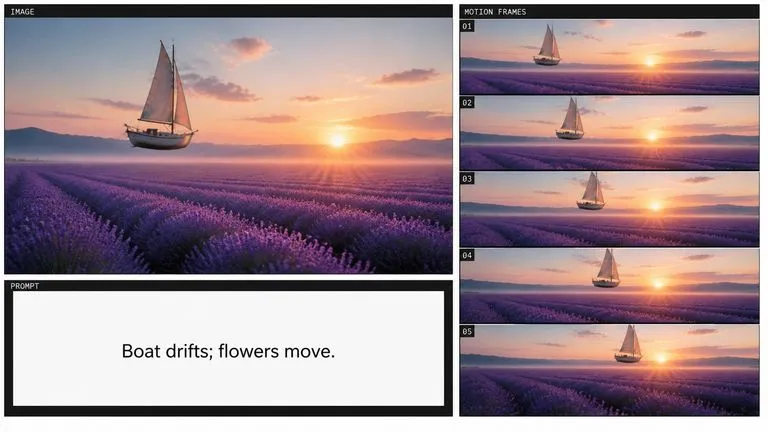
Toute image du canevas transformée en court clip animé.
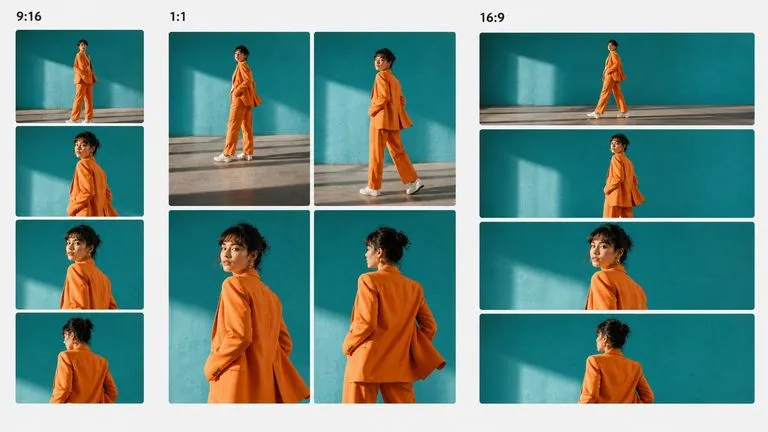
Courte vidéo verticale ou carrée produite à partir d’un seul visuel existant.
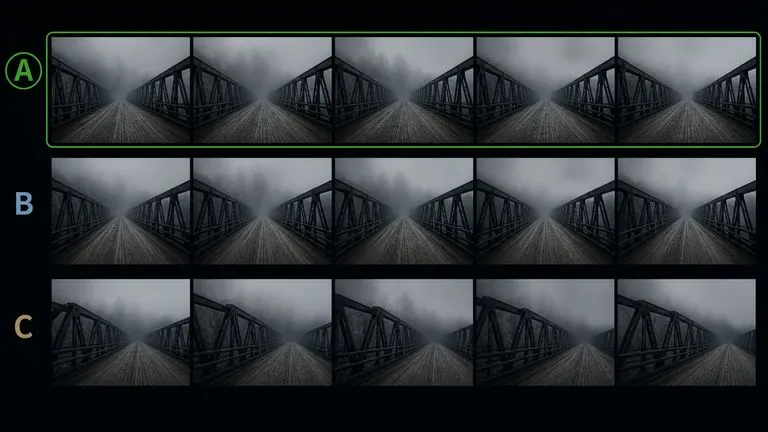
Vérifications rapides du potentiel animé d’une image fixe avant d’aller plus loin.
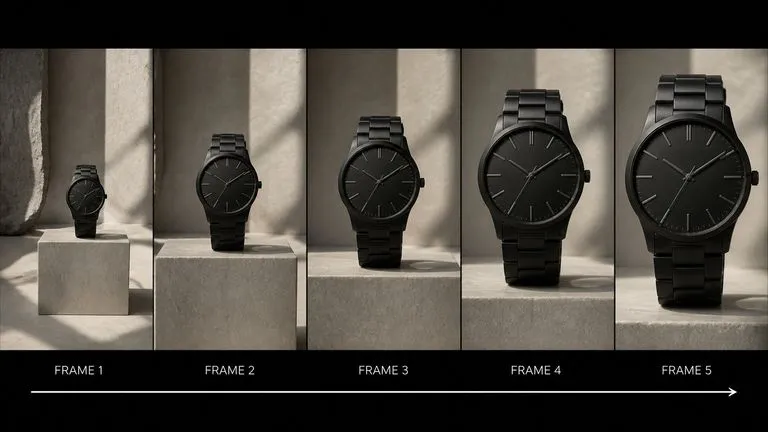
Un rapprochement ou une dérive lents à partir de votre photo produit existante.
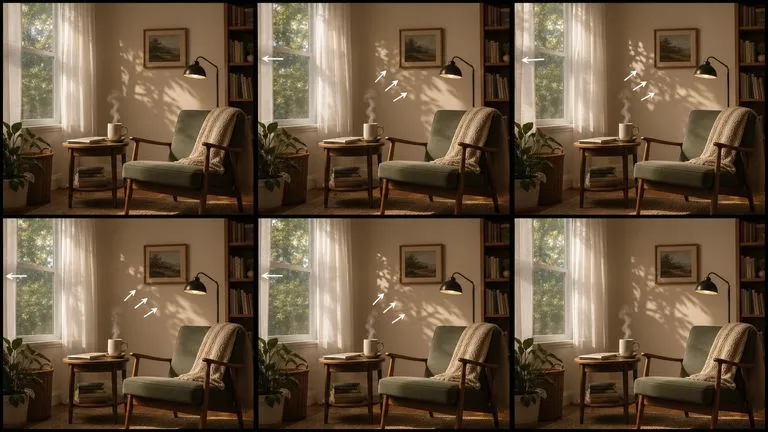
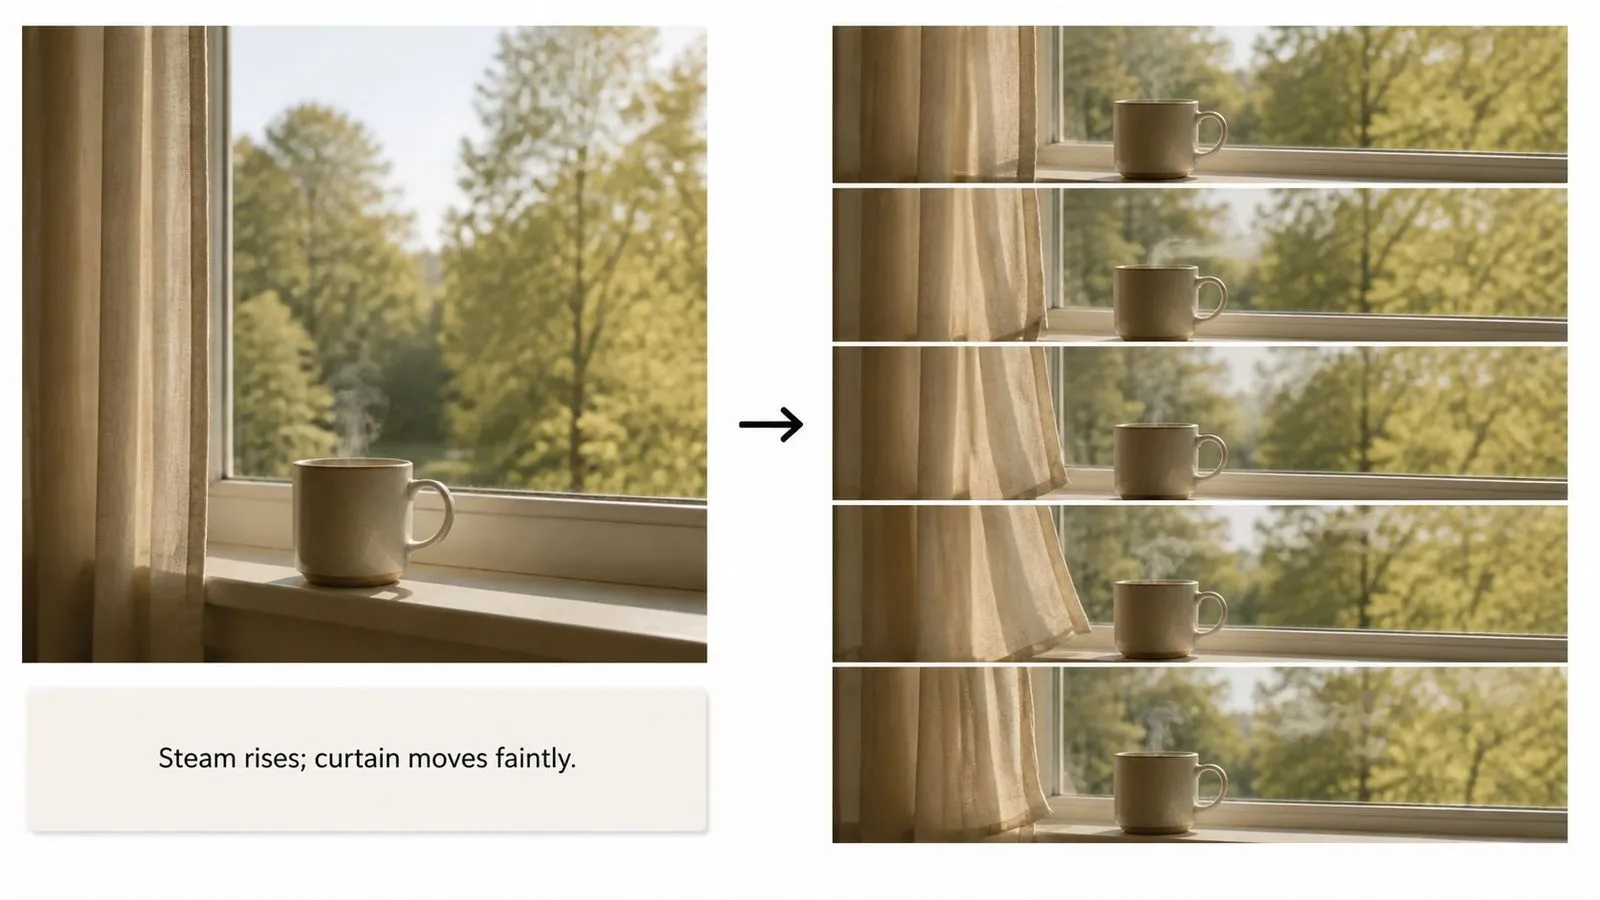
Mouvement ambiant — vapeur, vent, variations lumineuses — ajouté à une scène statique.
Importez une image ou faites-en glisser une depuis un autre endroit du canevas.
Dites ce qui bouge et comment se comporte la caméra. Une action est plus lisible que trois.
Jugez le rythme avant l’image. Les problèmes de cadence viennent du descriptif.
Si le mouvement ne convient pas, réécrivez la clause de mouvement plutôt que de remplacer l’image d’entrée.
Un prompt vidéo IA Happy Horse utile comprend généralement trois éléments :
Au lieu d’écrire
Donne vie à cette image, mouvement cinématographique, magnifique.
Écrivez
La caméra avance lentement et régulièrement vers le centre du cadre. La vapeur monte de la tasse en un filet fin et continu. Rien d’autre ne bouge, sans aucune coupe.
La caméra reste parfaitement immobile. La vapeur monte de la tasse en un filet fin et continu, dérivant légèrement vers la droite. Le rideau au bord du cadre bouge à peine. Rien d’autre ne change dans la scène. Aucune coupe, aucun mouvement de caméra, aucun changement de lumière.
La caméra avance lentement et régulièrement vers le produit au centre du cadre, puis s’arrête avant qu’il remplisse le plan. Le produit ne bouge ni ne tourne. La lumière reste fixe : le reflet se déplace légèrement sur la surface à mesure que le cadre se resserre. Aucune coupe.
La caméra dérive lentement vers la gauche à vitesse constante. L’herbe au premier plan bouge dans un vent léger. L’ombre d’un nuage passe progressivement à mi-distance. L’horizon reste horizontal et rien n’entre dans le cadre. Terminez avec une composition décalée vers la gauche d’un quart de la largeur du cadre.
| Critère | Happy Horse AI Video | Seedance 2.0 |
|---|---|---|
| Entrée visuelle | Une seule image d’ouverture | Images clés ou ensemble de références |
| Contrôle des extrémités | Image d’ouverture uniquement | Première et dernière images |
| Sortie dans Virse | Sans son | Audio généré avec l’image |
| Durée du clip | Cinq à huit secondes | Quatre à quinze secondes |
| Préparation requise | Une image et une phrase | Un descriptif couvrant l’action et le son |
| À choisir lorsque | Vous avez une image et une question | Le plan doit finir à un endroit précis |
L’image définit déjà l’apparence des éléments. Consacrez le prompt à ce qui change.
Cinq à huit secondes permettent une action. Les descriptifs qui en empilent plusieurs les font toutes survenir à la fois, maladroitement.
Nommer les éléments statiques empêche le modèle d’animer la scène entière.
Le son est produit à chaque génération : les indications d’ambiance, d’effets et de dialogue méritent donc de figurer dans le prompt.
Préparez des images de référence et des orientations visuelles pour votre prochaine vidéo.
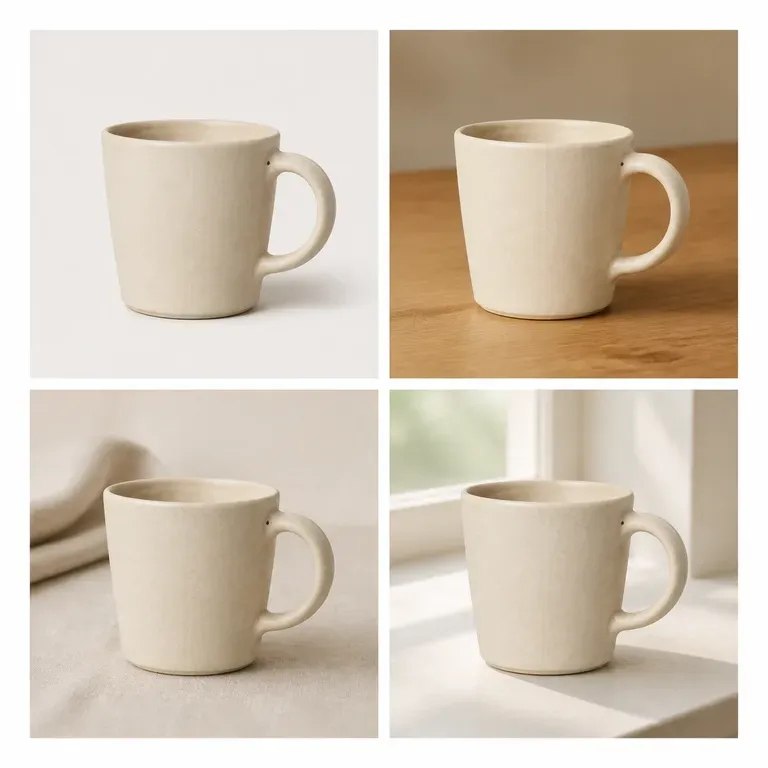
Une variation qui modifie discrètement le produit n’est pas une variation, c’est un produit différent. Importez une image, indiquez si c’est la scène, la couleur ou l’angle qui doit changer, et récupérez une série où tout le reste reste immobile. Les crédits gratuits suffisent pour vérifier si le sujet survit réellement à la série.
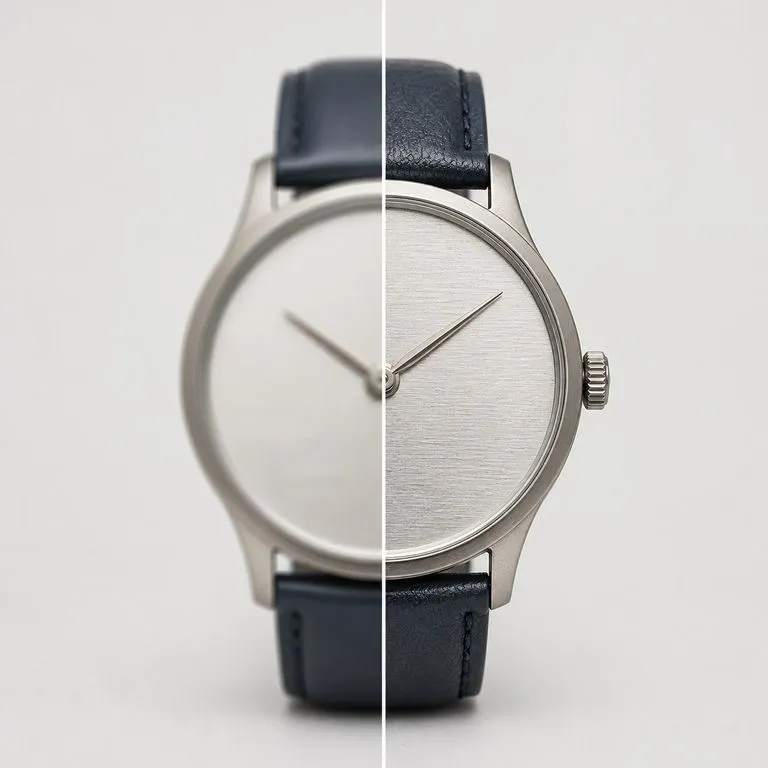
Importez une image qui n’est pas assez bonne pour être utilisée. Il détermine ce qui n’a réellement pas fonctionné, qu’il s’agisse de flou, de bruit, d’artefacts de compression ou simplement d’un nombre insuffisant de pixels, corrige d’abord cela, puis génère l’image à la résolution que vous choisissez.
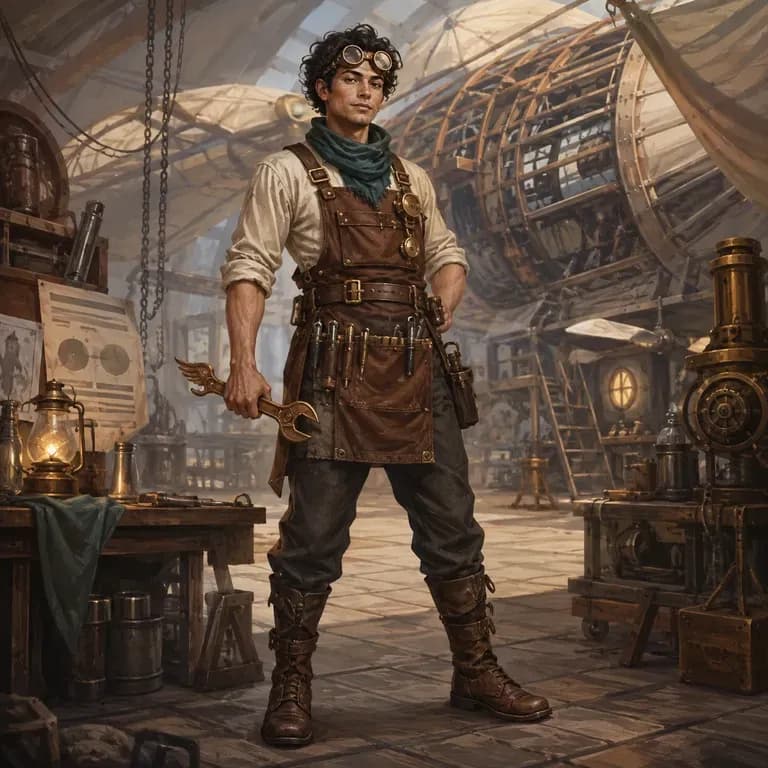
La plupart des prompts de personnages se lisent bien pour une personne, mais s’effondrent face à un modèle d’image, car l’identité, l’univers et le style visuel sont dispersés dans trois phrases différentes au lieu d’être réunis dans une seule qu’il peut analyser. Décrivez qui ils sont, générez une version structurée et testez-la avec un rendu réel directement sur la même toile. Les crédits gratuits couvrent la première série.
Seedance 2.0 de ByteDance produit image et son en une passe à partir d’une première et d’une dernière image ou d’images de référence, de 480P à la 4K native.
Veo 3.1 de Google DeepMind génère de courts clips avec un son synchronisé à 48 kHz et les prolonge en séquences plus longues en réutilisant les images finales.
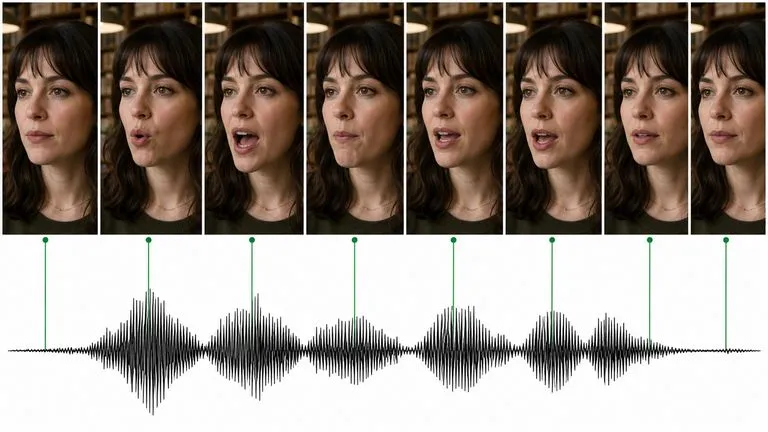
Kling 3.0 de Kuaishou parle — dialogues synchronisés sur les lèvres en cinq langues, une voix différente par personnage et un mode storyboard qui structure toute une séquence.
Une image, une phrase et un clip à regarder avant même d’avoir fini de décider si l’essai en valait la peine.