
Satu Bingkai Pembuka
Satu gambar merupakan seluruh masukan visual.
Model video AI Happy Horse 1.0 membutuhkan satu gambar diam dan satu kalimat, menghasilkan gerakan dari bingkai yang sudah Anda miliki.
Buka halaman ini di peramban desktop untuk mulai berkarya.
Model video AI Happy Horse meminta lebih sedikit masukan daripada model video lain di Virse, dan kesederhanaan itulah alasan memakainya.
Kebanyakan model video meminta lebih banyak daripada yang Anda miliki—bingkai pertama dan terakhir, beberapa referensi dengan peran jelas, arahan kamera dan desain suara. Jika Anda hanya memiliki satu gambar dan ingin melihatnya bergerak, model-model itu mengharuskan Anda mengarang bahan yang belum ada. Model ini mulai dari keadaan Anda: satu bingkai pembuka dan deskripsi kejadian berikutnya.
Gunakan model video AI Happy Horse ketika titik awal sudah tersedia. Animasikan foto, hidupkan gambar buatan, uji apakah ide bekerja sebagai gerakan, dan buat klip pendek tanpa menyusun arahan lebih dahulu.
Happy Horse 1.0 adalah model pembuatan video dengan 15 miliar parameter, dibangun pada Transformer terpadu satu aliran dan yang pertama membuat gambar serta suara dalam satu proses inferensi maju, bukan tahap terpisah. Model masuk peringkat pertama uji buta Artificial Analysis pada April 2026 dan dipublikasikan sebagai sumber terbuka dengan lisensi komersial.
Model ini memiliki tiga keunggulan utama:
Klip berdurasi lima hingga delapan detik, dengan rasio 16:9, 9:16, 4:3, 21:9, dan 1:1. Konfigurasi di Virse membuat audio bersama gambar, dipandu satu bingkai pembuka dan prompt tertulis.
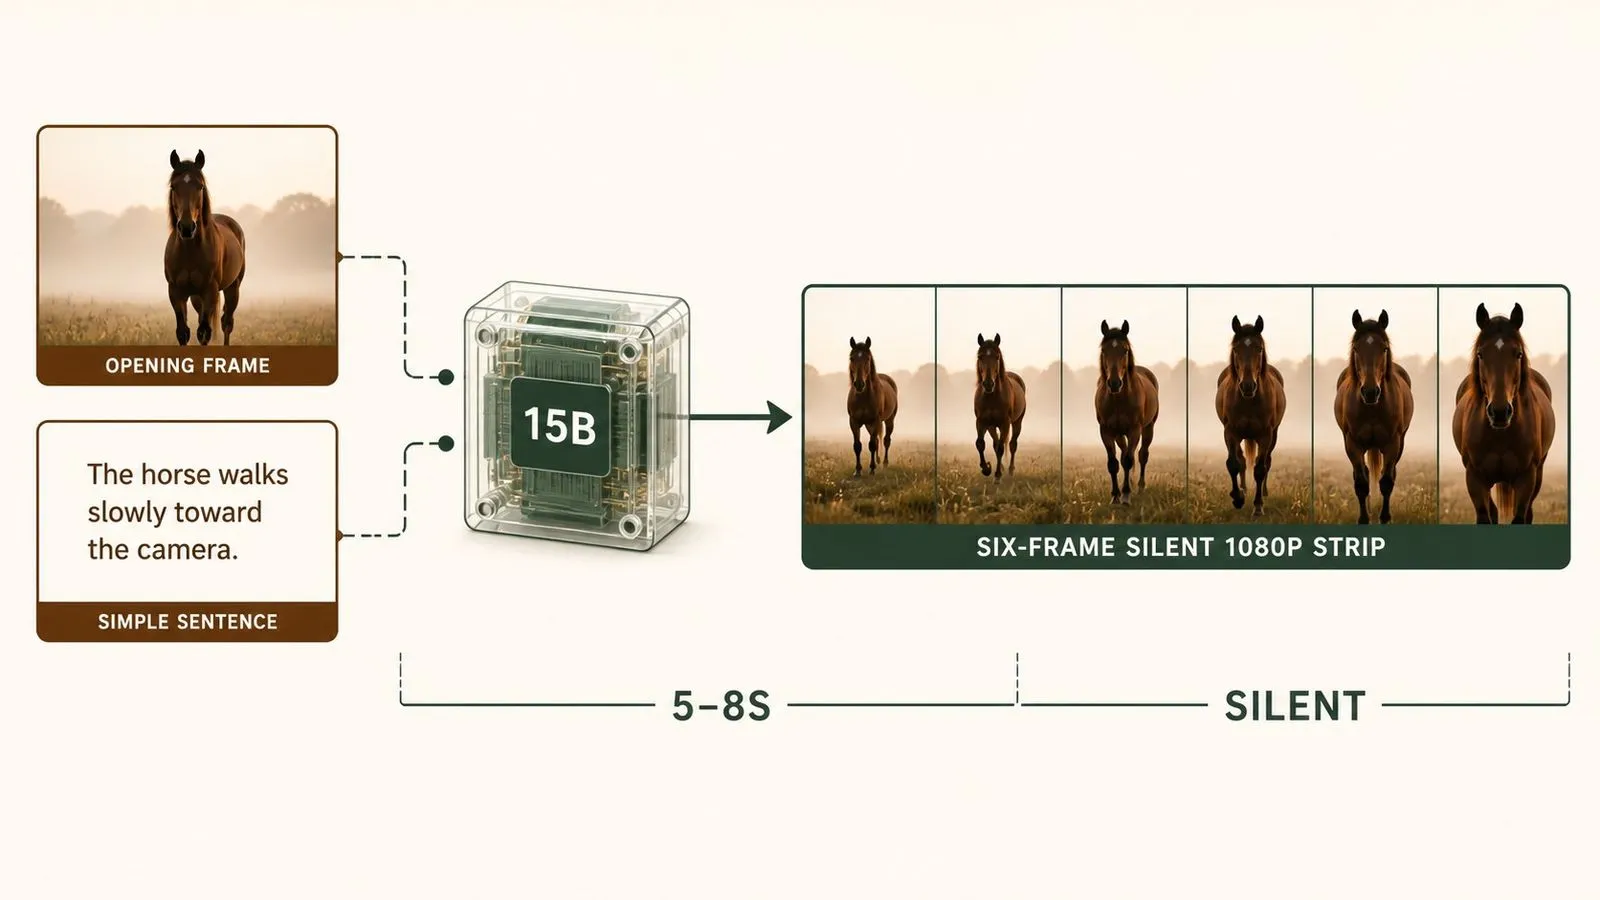
Satu gambar merupakan seluruh masukan visual.
Transformer terpadu satu aliran, bukan alur bertahap.
Gambar dan suara dibuat bersama dalam model dasarnya.
Hasil Full HD, bukan peningkatan ukuran.
Durasi klip dalam satu proses.
16:9, 9:16, 4:3, 21:9, dan 1:1.
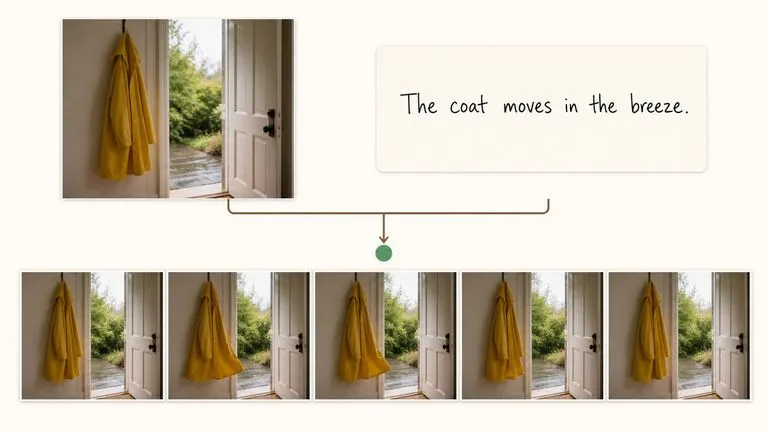
Satu gambar dan satu kalimat adalah seluruh kebutuhannya. Tidak perlu menyusun kumpulan referensi atau merancang bingkai penutup, sehingga inilah jalur tercepat dari memiliki gambar ke melihatnya bergerak.
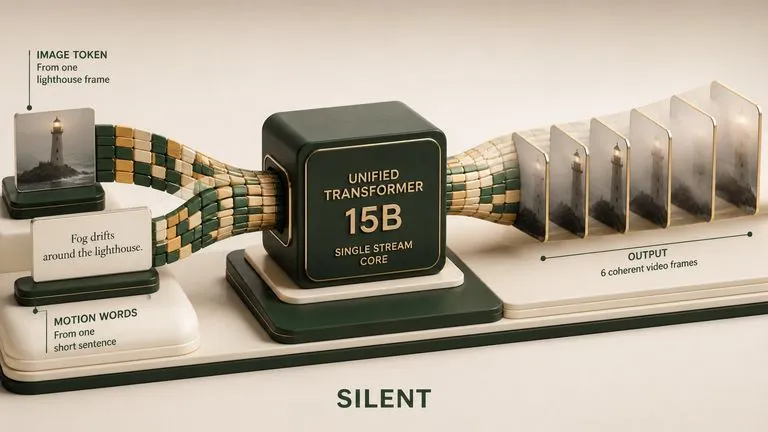
Membuat audio dan video dalam satu proses inferensi maju, bukan menghasilkan klip tanpa suara lalu memberinya musik, adalah kemampuan yang dirancang untuk dibuktikan model ini—dan dengan itu model mencapai puncak papan peringkat uji buta.
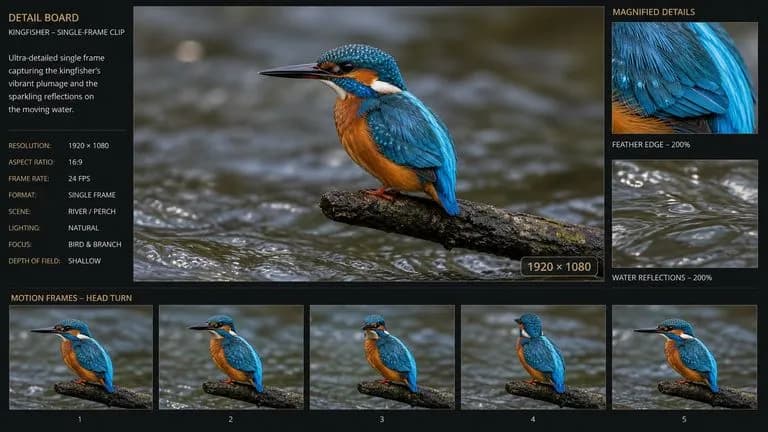
Full HD langsung dihasilkan model. Untuk model yang dipandu satu bingkai, kemampuan ini lebih tinggi daripada yang tampak dari kebutuhan masukannya.
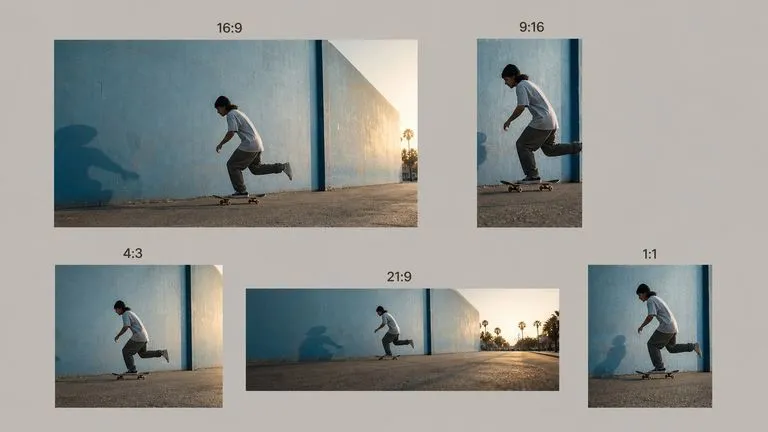
Lanskap, vertikal, persegi, dan ultralebar dari arahan yang sama, penting saat satu klip harus muncul di beberapa tempat.
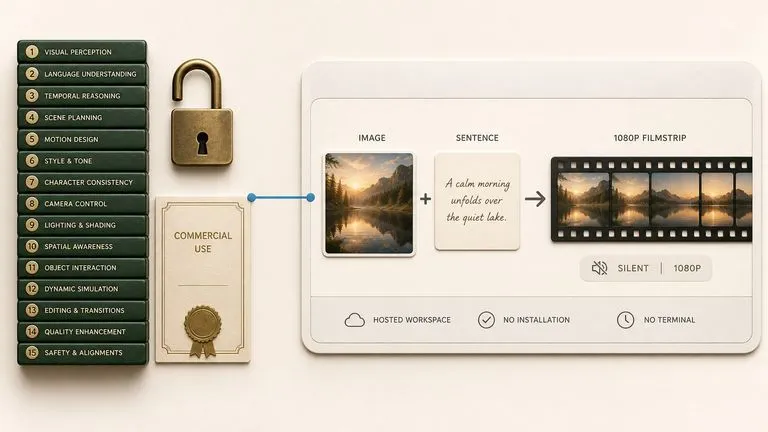
Model dipublikasikan secara terbuka dengan penggunaan komersial diizinkan, tetapi di Virse berjalan sebagai layanan terkelola tanpa instalasi.
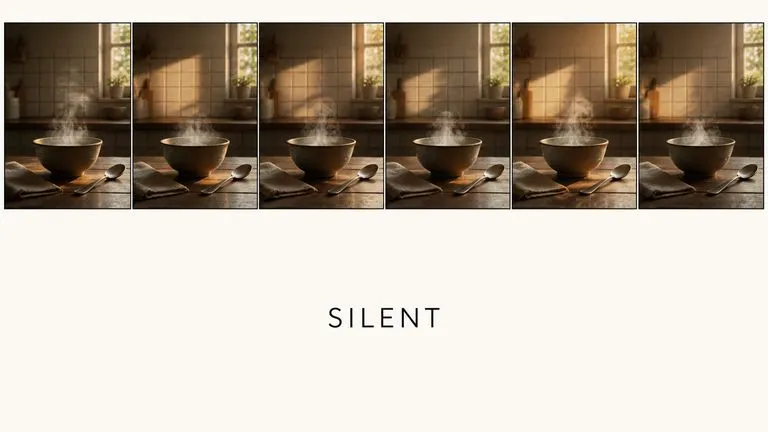
Suara dibuat bersama gambar dalam proses yang sama, tanpa tombol untuk mematikannya.
Model satu bingkai mengubah hal yang layak dicoba. Ketika masukannya gambar yang sudah dimiliki, pertanyaannya bukan lagi apakah perlu menyusun arahan, melainkan apakah Anda penasaran. Virse memudahkan rasa penasaran itu diwujudkan dengan murah. Gambar diam apa pun di kanvas—dibuat model gambar atau diseret dari tempat lain—dapat diserahkan ke model video AI Happy Horse tanpa meninggalkan ruang kerja.
Ambil gambar diam apa pun yang sudah ada di ruang kerja dan gerakkan tanpa mengekspornya terlebih dahulu.
Ketahui apakah komposisi bekerja sebagai gerakan sebelum berinvestasi dalam kumpulan referensi untuk model lebih berat.
Beralih antara model video AI Happy Horse dan lebih dari 30 model gambar serta video lain tanpa meninggalkan kanvas atau menulis ulang arahan.
Jika bidikan harus berakhir pada komposisi tertentu, serahkan bingkai yang sama ke model yang menerima kedua titik ujung.
Gerakan ditambahkan pada foto produk, lokasi, atau potret yang sudah dimiliki.
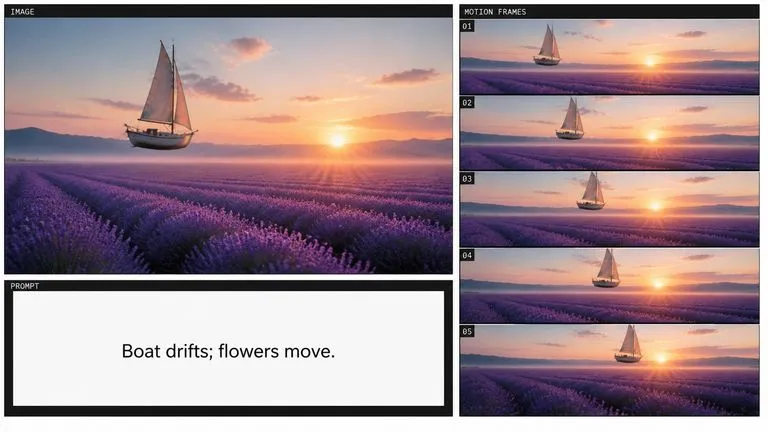
Gambar apa pun di kanvas diubah menjadi klip bergerak pendek.
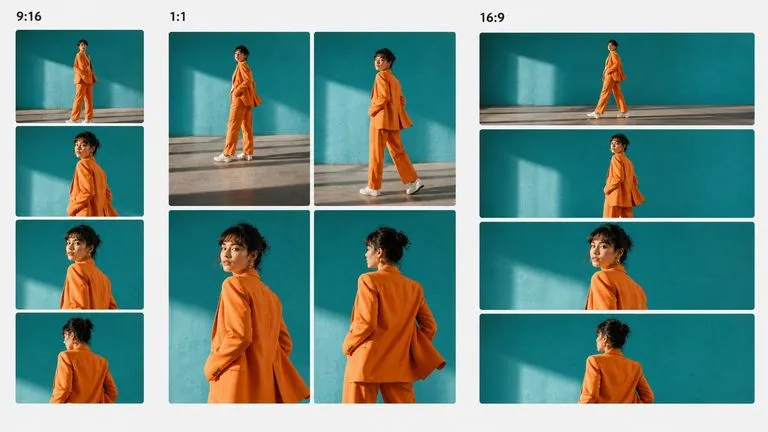
Video vertikal atau persegi pendek dibuat dari satu aset yang sudah ada.
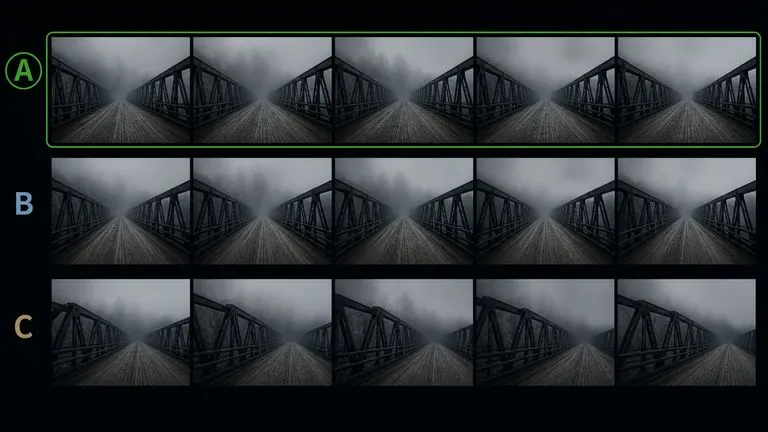
Pemeriksaan cepat apakah gambar diam cocok bergerak sebelum melangkah lebih jauh.
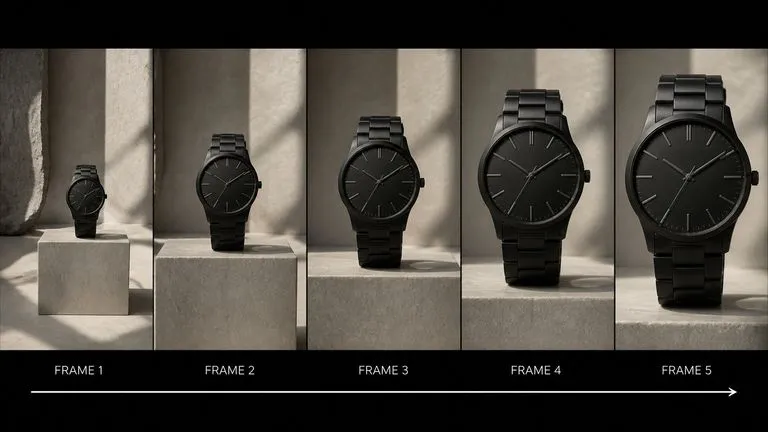
Gerakan maju atau bergeser lambat dari foto produk yang sudah dimiliki.
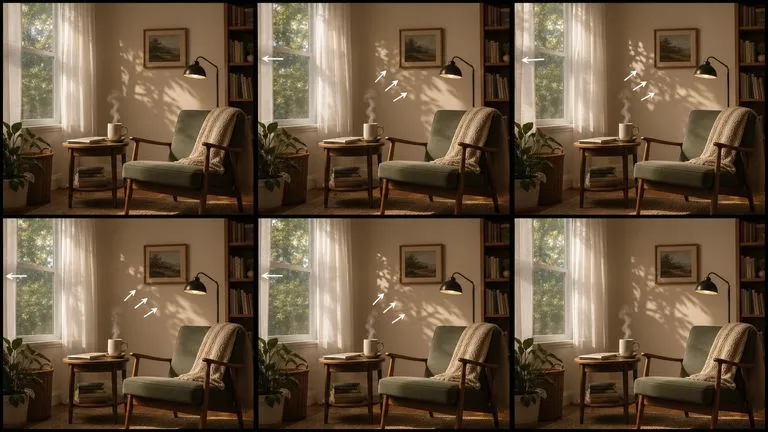
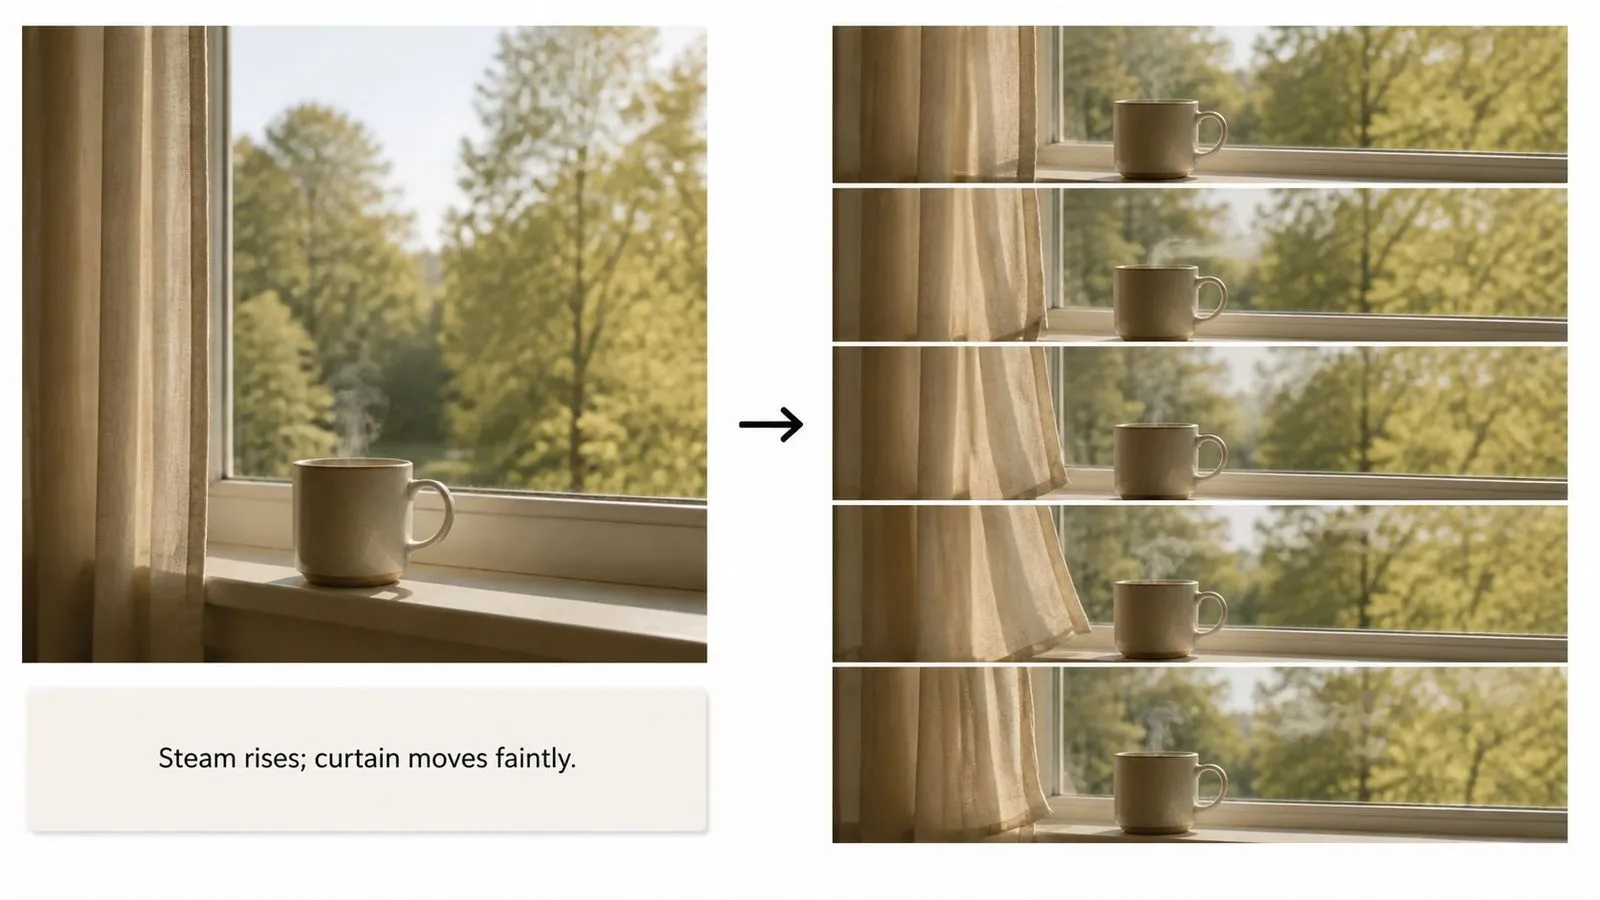
Gerakan suasana—uap, angin, perubahan cahaya—ditambahkan ke adegan statis.
Unggah gambar atau seret dari bagian lain kanvas.
Katakan yang bergerak dan perilaku kamera. Satu aksi lebih jelas daripada tiga.
Nilai tempo sebelum gambar. Masalah ritme berasal dari arahan.
Jika gerakan salah, tulis ulang klausul gerakan, bukan mengganti gambar masukan.
Prompt video AI Happy Horse yang berguna biasanya mencakup tiga unsur:
Alih-alih menulis
Hidupkan gambar ini, gerakan sinematik, indah.
Tulis
Kamera maju perlahan dan stabil ke tengah bingkai. Uap naik dari cangkir dalam aliran tipis berkelanjutan. Tidak ada yang lain bergerak, dan tidak ada potongan.
Kamera tetap benar-benar diam. Uap naik dari cangkir dalam aliran tipis berkelanjutan, sedikit bergeser ke kanan. Tirai di tepi bingkai bergerak samar. Tidak ada bagian lain yang berubah dalam adegan. Tanpa potongan, gerakan kamera, atau perubahan cahaya.
Kamera maju perlahan dan merata ke produk di tengah bingkai, berhenti sebelum produk memenuhi bidikan. Produknya sendiri tidak bergerak atau berputar. Cahaya tetap, sehingga sorotan sedikit bergerak di permukaan saat bingkai menyempit. Tanpa potongan.
Kamera bergeser perlahan ke kiri dengan kecepatan konstan. Rumput di depan bergerak tertiup angin ringan. Bayangan awan perlahan melintasi jarak menengah. Garis cakrawala tetap datar sepanjang klip dan tidak ada yang masuk bingkai. Akhiri dengan komposisi bergeser ke kiri sejauh seperempat lebar bingkai.
| Dimensi | Happy Horse AI Video | Seedance 2.0 |
|---|---|---|
| Masukan visual | Satu bingkai pembuka | Bingkai atau kumpulan referensi |
| Kontrol titik ujung | Hanya bingkai pembuka | Bingkai pertama dan terakhir |
| Hasil di Virse | Tanpa suara | Audio dibuat bersama gambar |
| Durasi klip | Lima hingga delapan detik | Empat hingga lima belas detik |
| Persiapan yang diperlukan | Satu gambar dan satu kalimat | Arahan mencakup aksi dan suara |
| Pilih ketika | Anda punya satu gambar dan satu pertanyaan | Bidikan harus berakhir pada komposisi tertentu |
Bingkai sudah menetapkan penampilan benda. Gunakan prompt untuk hal yang berubah.
Lima hingga delapan detik memuat satu kejadian. Arahan dengan beberapa kejadian membuat semuanya terjadi sekaligus dengan buruk.
Menyebut elemen statis mencegah model menggerakkan seluruh adegan.
Suara dirender pada setiap pembuatan, jadi petunjuk suasana, efek, dan dialog dalam prompt layak ditulis.
Siapkan gambar referensi dan arah visual untuk video Anda berikutnya.
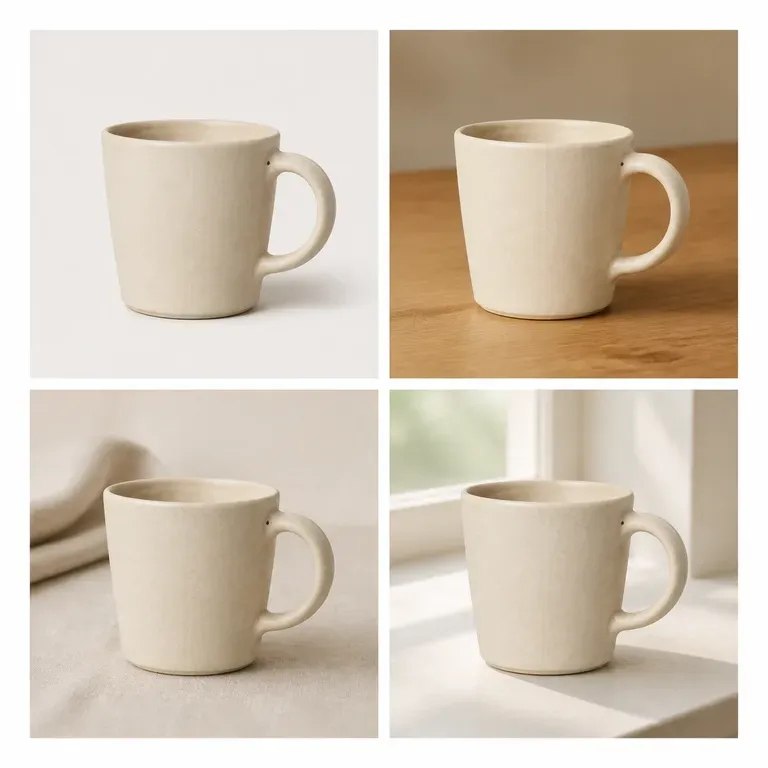
Variasi yang diam-diam mengubah produk bukanlah variasi, melainkan produk yang berbeda. Unggah satu gambar, tentukan apakah adegan, warna, atau sudut yang harus berubah, dan dapatkan kembali satu batch yang mempertahankan semua hal lainnya. Kredit gratis cukup untuk menguji apakah subjek benar-benar tetap konsisten di seluruh batch.
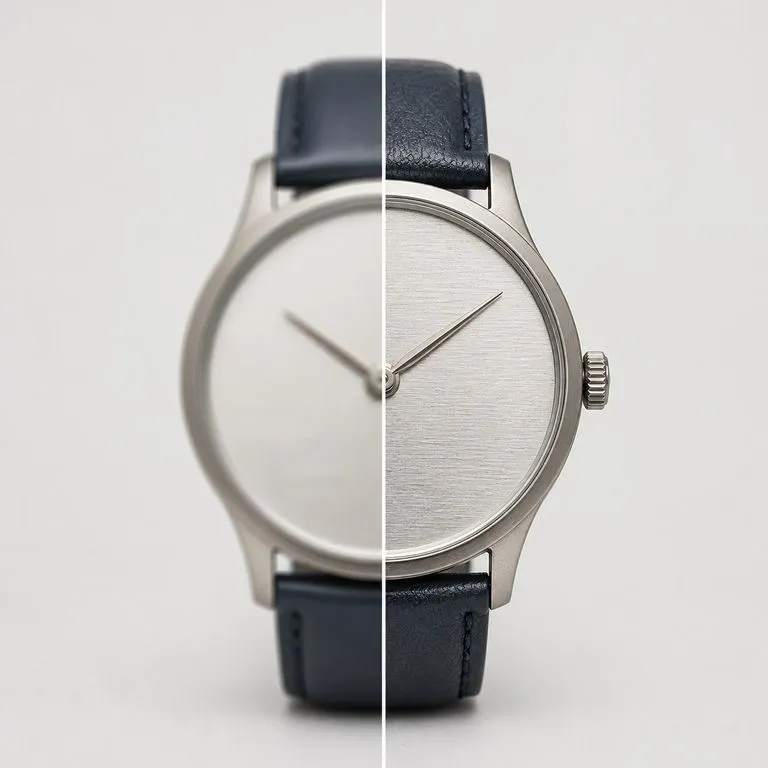
Unggah gambar yang belum cukup baik untuk digunakan. Alat ini mencari tahu apa yang sebenarnya bermasalah, apakah itu blur, derau, artefak kompresi, atau sekadar piksel yang tidak cukup, memperbaikinya terlebih dahulu, lalu merender pada resolusi yang Anda pilih.
Sebagian besar prompt karakter terbaca baik oleh manusia tetapi berantakan bagi model gambar, karena identitas, dunia, dan gaya visual tersebar di tiga kalimat berbeda, bukan dalam satu bentuk yang dapat dipahami. Jelaskan siapa mereka, hasilkan versi terstruktur, dan uji dengan render nyata langsung di kanvas yang sama. Kredit gratis mencakup putaran pertama.
Seedance 2.0 dari ByteDance menghasilkan gambar dan suara dalam satu proses, dari bingkai pertama dan terakhir atau gambar referensi, pada ukuran 480P hingga 4K native.
Veo 3.1 dari Google DeepMind menghasilkan klip pendek dengan audio 48kHz yang tersinkronisasi dan memperpanjangnya menjadi rangkaian yang lebih panjang dengan meneruskan frame penutup ke depan.
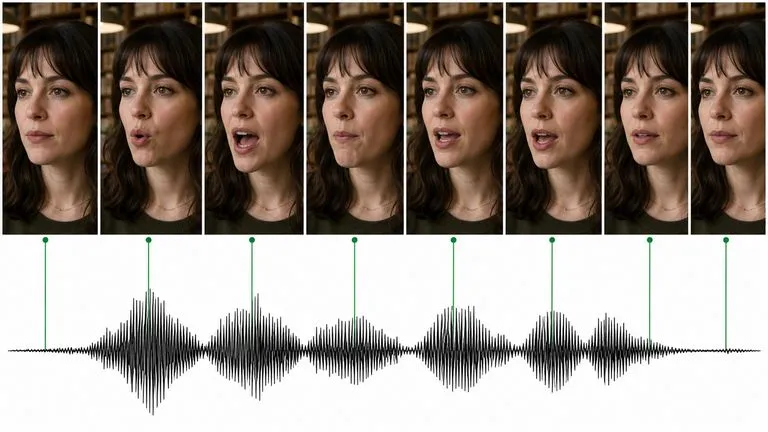
Kling 3.0 dari Kuaishou dapat berbicara — dialog tersinkronisasi bibir dalam lima bahasa, suara berbeda untuk tiap karakter, dan mode storyboard yang menyusun keseluruhan rangkaian.
Satu gambar, satu kalimat, dan klip yang sudah bisa Anda lihat sebelum selesai memutuskan apakah layak dicoba.