
Um único fotograma inicial
Uma imagem é toda a entrada visual.
O modelo de vídeo com IA Happy Horse 1.0 precisa de uma imagem fixa e uma frase, produzindo movimento a partir do fotograma que já tem.
Abra esta página em um navegador de desktop para começar a criar.
O modelo de vídeo com IA Happy Horse pede menos entradas do que qualquer outro modelo de vídeo da Virse, e essa limitação é a razão para o usar.
A maioria dos modelos de vídeo quer mais de si do que aquilo que tem: um primeiro e um último fotograma, várias imagens de referência com funções definidas, um briefing que abrange o comportamento da câmara e o desenho de som. Quando tem exatamente uma imagem e quer vê-la mover-se, esses modelos obrigam-no a inventar material que não possui. Este começa onde realmente está: um único fotograma inicial e uma descrição do que acontece a seguir.
Use o modelo de vídeo com IA Happy Horse quando o ponto de partida já existe. Anime uma fotografia, dê vida a uma imagem fixa gerada, teste se uma ideia funciona em movimento e produza clipes curtos sem primeiro reunir um briefing.
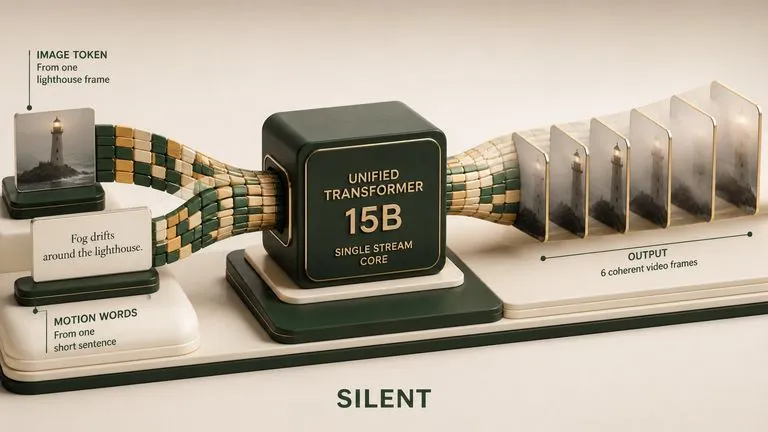
Happy Horse 1.0 é um modelo de geração de vídeo com 15 mil milhões de parâmetros, construído sobre um Transformer unificado de fluxo único, e o primeiro a gerar imagem e som numa única passagem de inferência, em vez de etapas separadas. Entrou em primeiro lugar na classificação de testes cegos da Artificial Analysis em abril de 2026 e é publicado em código aberto sob uma licença comercial.
O modelo assenta em três grandes pontos fortes:
Os clipes duram cinco a oito segundos, com proporções que abrangem 16:9, 9:16, 4:3, 21:9 e 1:1. A configuração disponibilizada na Virse gera áudio com a imagem, orientada por um único fotograma inicial e um prompt escrito.
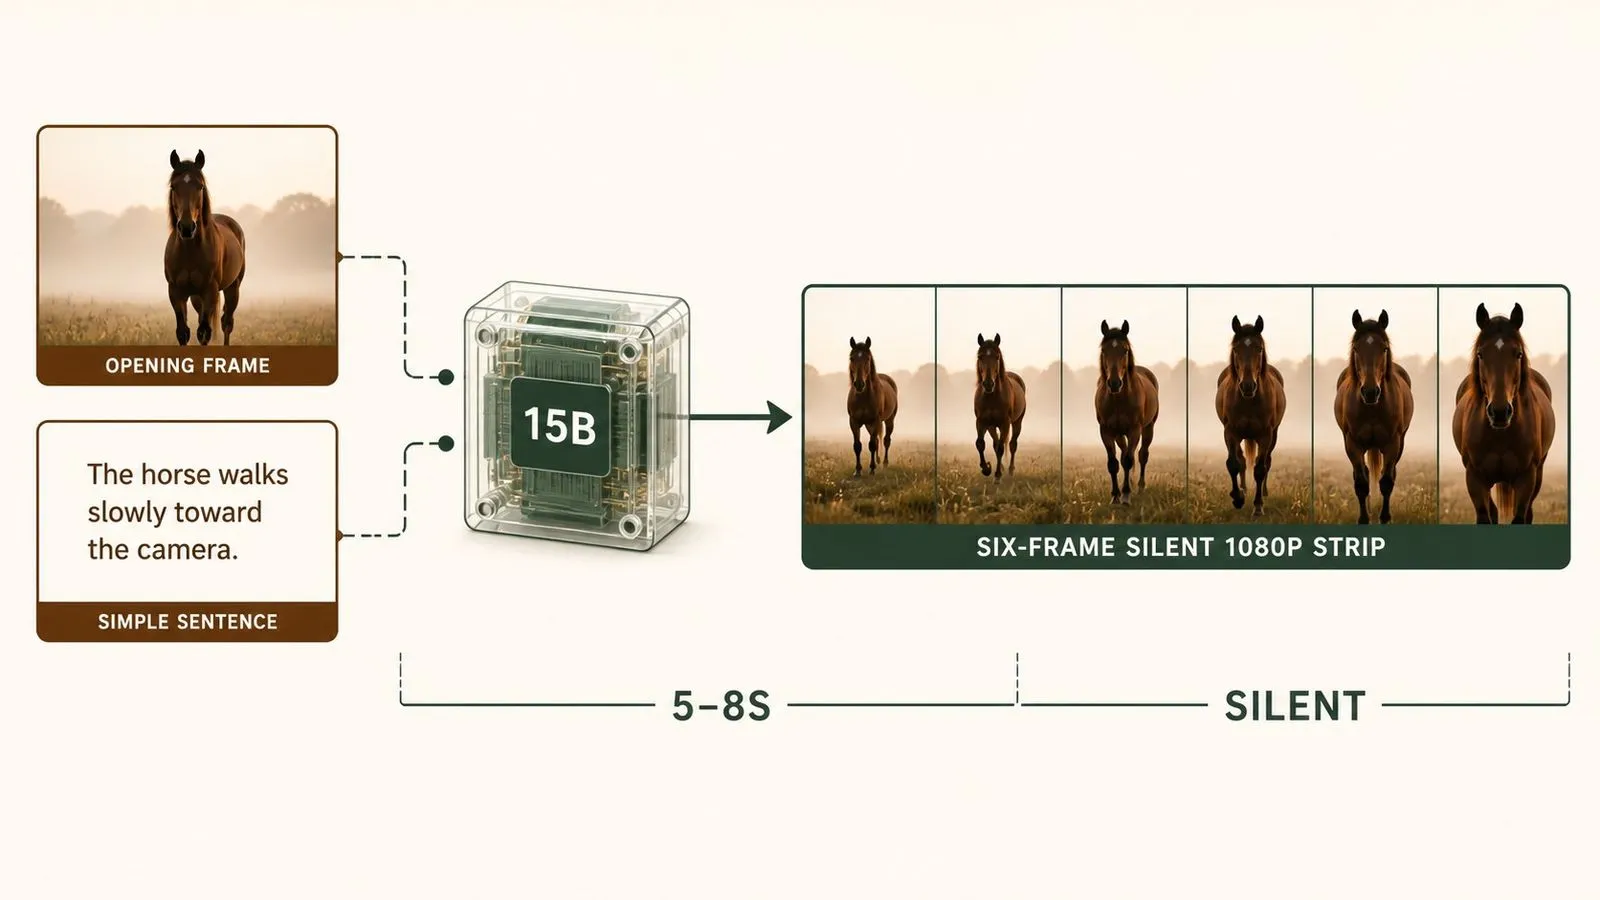
Uma imagem é toda a entrada visual.
Um Transformer unificado de fluxo único, em vez de um processo por etapas.
Imagem e som gerados em conjunto no modelo subjacente.
Resultado em Full HD, em vez de uma ampliação.
Duração do clipe numa só passagem.
16:9, 9:16, 4:3, 21:9 e 1:1.
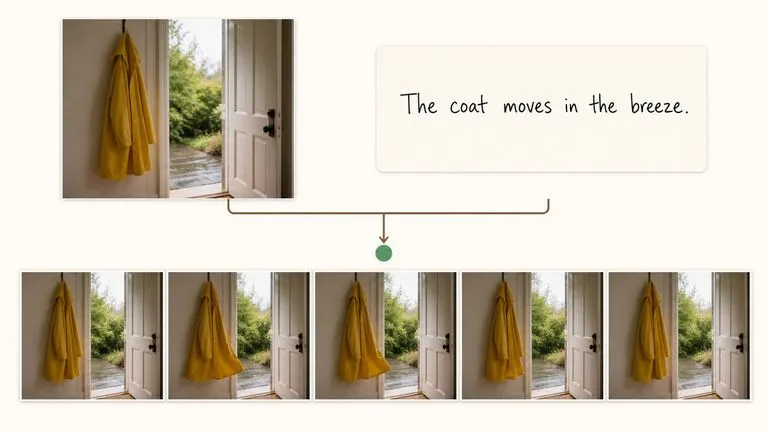
Uma imagem e uma frase são tudo o que é necessário. Não há conjunto de referências para reunir nem fotograma final para conceber, tornando esta a via mais rápida entre ter uma imagem e vê-la mover-se.
Gerar áudio e vídeo numa única passagem de inferência, em vez de produzir um clipe sem som e adicionar-lhe música depois, é o que o modelo foi criado para demonstrar, e chegou ao topo de uma classificação de testes cegos ao fazê-lo.
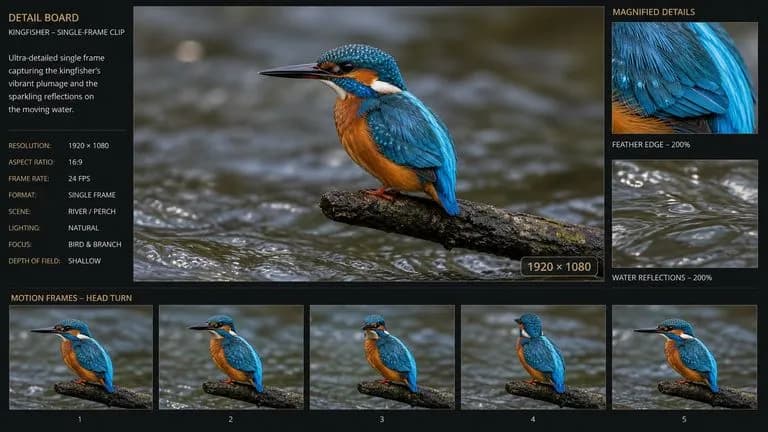
O Full HD sai diretamente do modelo. Para um modelo orientado por um único fotograma, é um limite máximo superior ao que o requisito de entrada sugere.
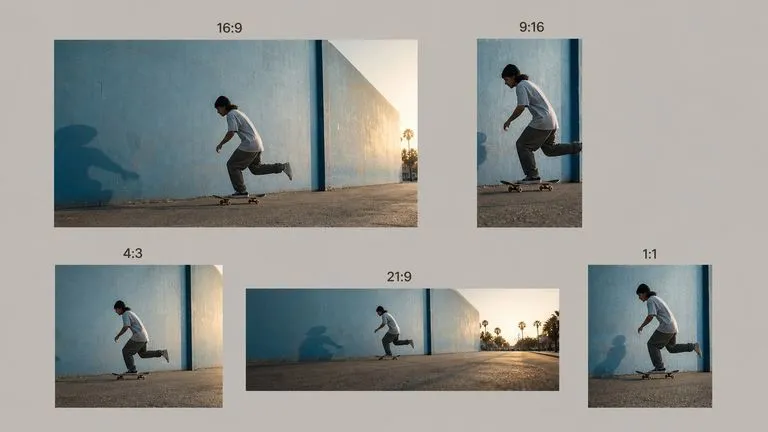
Formato horizontal, vertical, quadrado e ultralargo a partir do mesmo briefing, o que importa quando um clipe tem de aparecer em vários lugares.
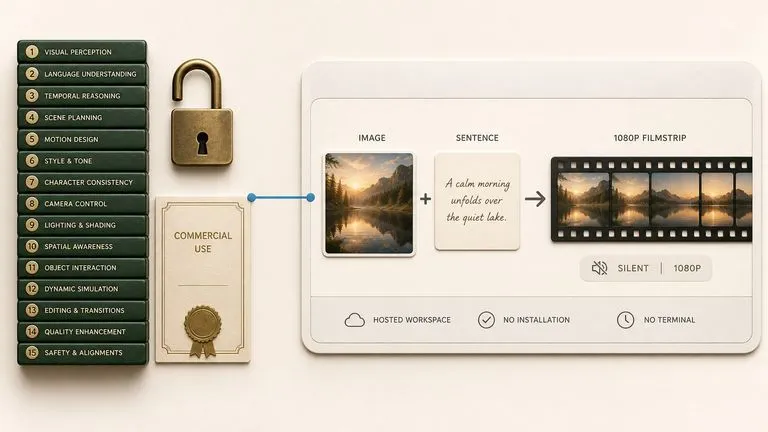
O modelo é publicado abertamente com utilização comercial permitida, embora na Virse funcione como serviço alojado, sem nada para instalar.
O som é gerado com a imagem na mesma passagem e não existe um interruptor para o desligar.
Um modelo de um só fotograma muda o que vale a pena experimentar. Quando a entrada é uma imagem que já tem, a questão deixa de ser se deve construir um briefing e passa simplesmente a ser se tem curiosidade. A Virse torna pouco dispendioso agir sobre essa curiosidade. Qualquer imagem fixa na tela — gerada por um modelo de imagem ou arrastada de outro lugar — pode ser entregue ao modelo de vídeo com IA Happy Horse sem sair do espaço de trabalho.
Pegue em qualquer imagem fixa já no espaço de trabalho e ponha-a em movimento sem primeiro a exportar.
Descubra se uma composição funciona em movimento antes de investir num conjunto de referências para um modelo mais pesado.
Alterne entre o modelo de vídeo com IA Happy Horse e mais de 30 outros modelos de imagem e vídeo sem sair da tela nem reescrever o briefing.
Quando um plano tem de terminar numa composição específica, entregue o mesmo fotograma a um modelo que aceite ambos os extremos.
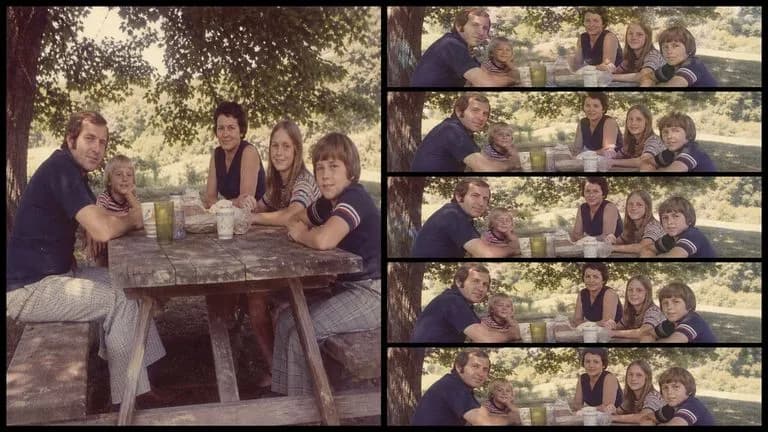
Movimento acrescentado a uma fotografia de produto, de local ou a um retrato que já tem.
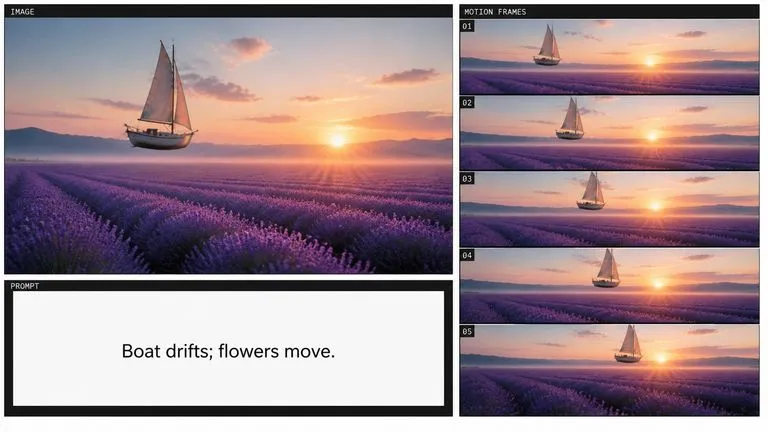
Qualquer imagem da tela transformada num clipe curto em movimento.
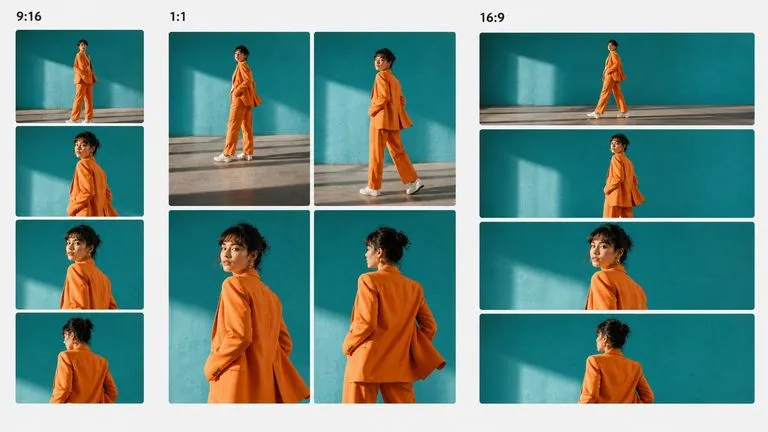
Vídeo curto vertical ou quadrado produzido a partir de um único material existente.
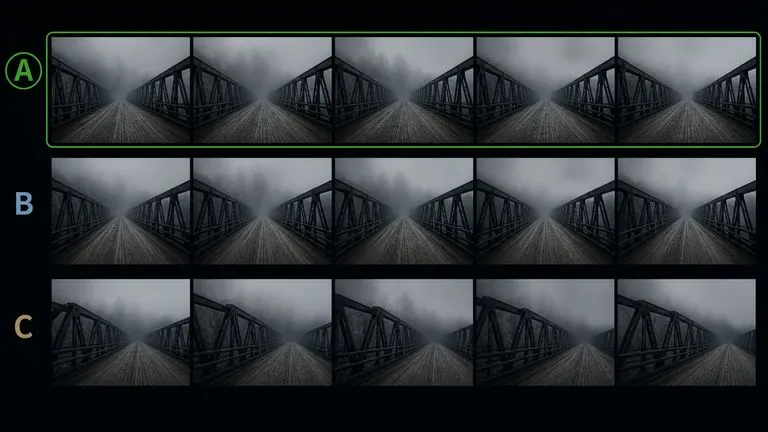
Verificações rápidas de como uma imagem fixa funciona em movimento, antes de avançar mais.
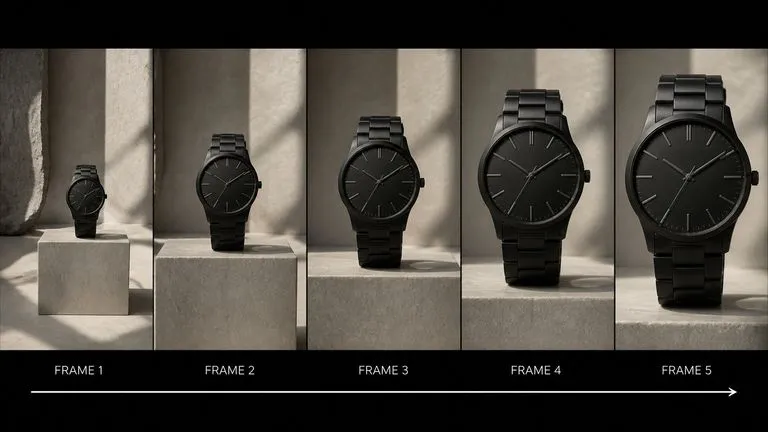
Uma aproximação ou deslocação lenta que parte da fotografia de produto que já tem.
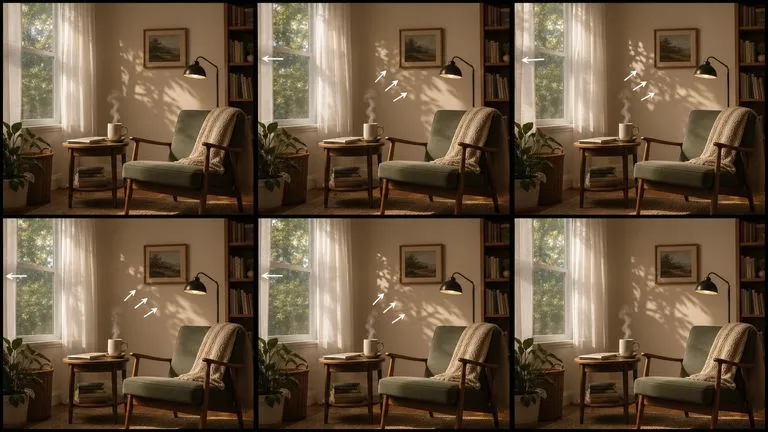
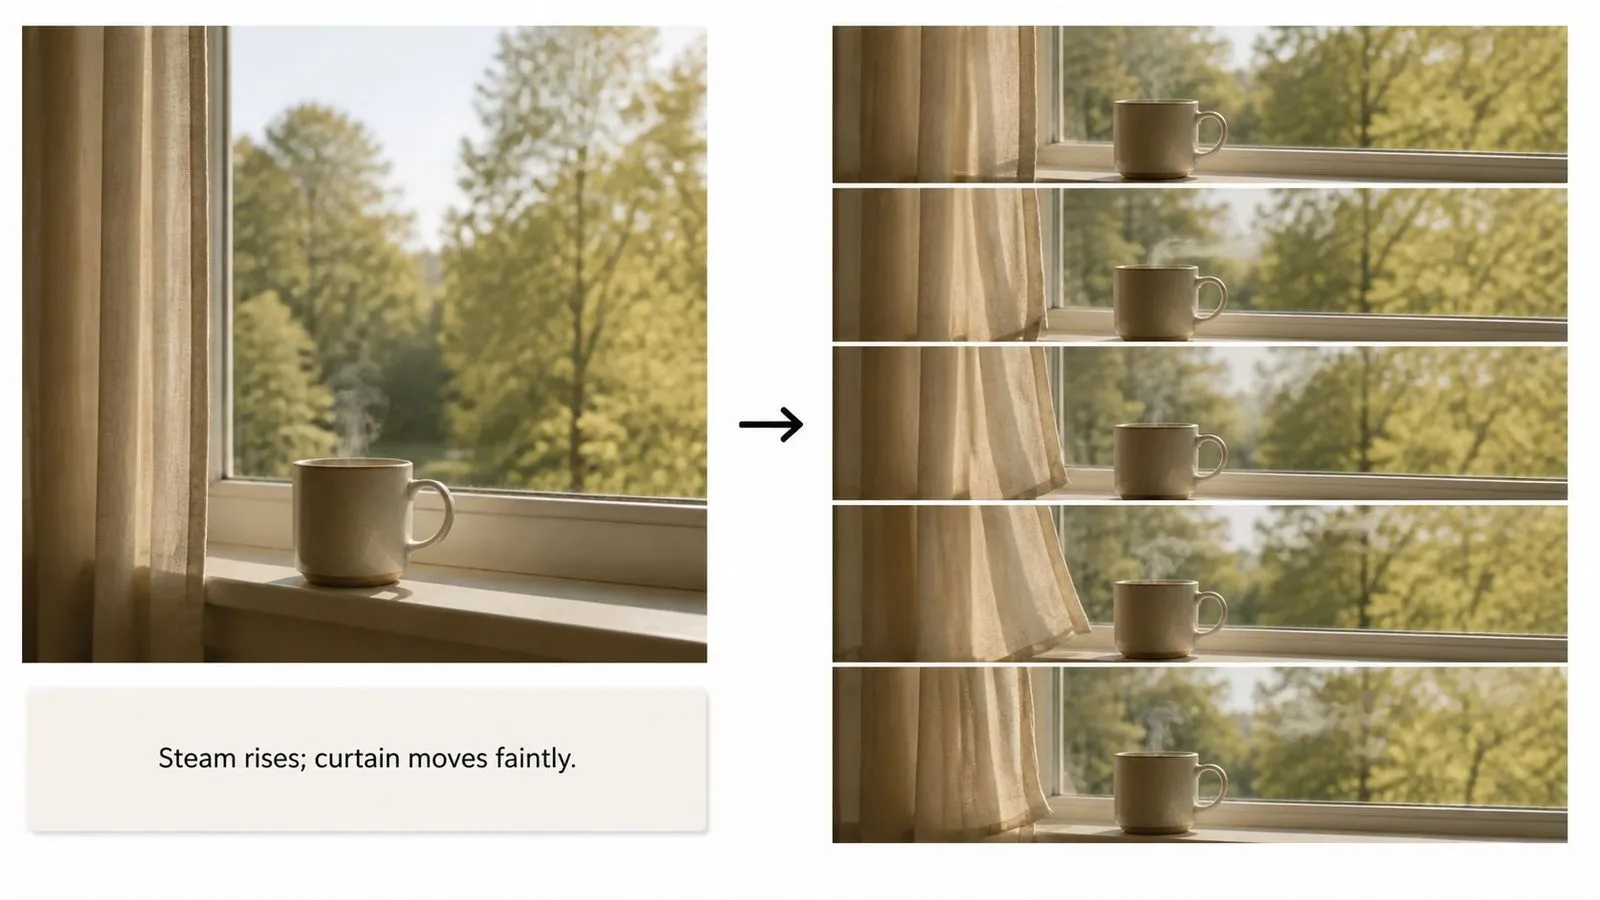
Movimento ambiente — vapor, vento, mudanças de luz — acrescentado a uma cena estática.
Carregue uma imagem ou arraste uma de outro ponto da tela.
Diga o que se move e como a câmara se comporta. Uma ação é mais clara do que três.
Avalie o ritmo antes da imagem. Os problemas de ritmo vêm do briefing.
Quando o movimento está errado, reescreva a cláusula do movimento, em vez de substituir a imagem de entrada.
Um prompt útil de vídeo com IA Happy Horse costuma incluir três elementos:
Em vez de escrever
Dê vida a esta imagem, movimento cinematográfico, bonito.
Escreva
A câmara aproxima-se lenta e continuamente do centro do enquadramento. O vapor sobe da chávena num fio fino e contínuo. Nada mais se move e não há cortes.
A câmara permanece completamente imóvel. O vapor sobe da caneca num fio fino e contínuo, desviando-se ligeiramente para a direita. A cortina na margem do enquadramento move-se ligeiramente. Nada mais na cena muda. Sem cortes, sem movimento de câmara, sem mudança de luz.
A câmara aproxima-se lenta e uniformemente do produto no centro do enquadramento, parando antes de este preencher o plano. O produto em si não se move nem roda. A luz mantém-se fixa, pelo que o brilho se desloca ligeiramente pela superfície à medida que o enquadramento aperta. Sem cortes.
A câmara desloca-se lentamente para a esquerda a velocidade constante. A relva em primeiro plano move-se com um vento leve. A sombra das nuvens passa gradualmente pela distância intermédia. A linha do horizonte mantém-se nivelada durante todo o clipe e nada entra no enquadramento. Termine com a composição deslocada um quarto da largura do enquadramento para a esquerda.
| Dimensão | Happy Horse AI Video | Seedance 2.0 |
|---|---|---|
| Entrada visual | Um único fotograma inicial | Fotogramas ou um conjunto de referências |
| Controlo dos fotogramas inicial e final | Apenas fotograma inicial | Primeiro e último fotograma |
| Resultado na Virse | Sem som | Áudio gerado com a imagem |
| Duração do clipe | Cinco a oito segundos | Quatro a quinze segundos |
| Preparação necessária | Uma imagem e uma frase | Um briefing que abrange ação e som |
| Escolha-o quando | Tem uma imagem e uma pergunta | O plano tem de terminar num ponto específico |
O fotograma já estabelece o aspeto das coisas. Use o prompt para o que muda.
Cinco a oito segundos comportam uma única ação. Briefings que acumulam várias produzem-nas todas ao mesmo tempo, mal.
Indicar os elementos estáticos é o que impede o modelo de animar a cena inteira.
O som é gerado em todas as gerações, por isso vale a pena escrever indicações de ambiente, efeitos e diálogo no prompt.
Prepare imagens de referência e orientações visuais para seu próximo vídeo.
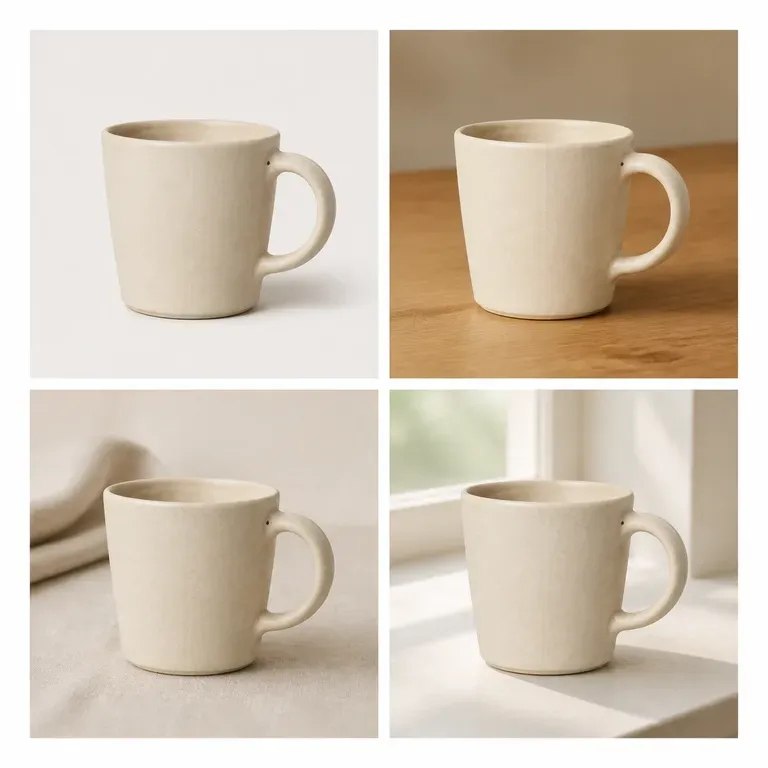
Uma variação que altera discretamente o produto não é uma variação, é um produto diferente. Carregue uma imagem, diga se é o cenário, a cor ou o ângulo que deve mudar, e receba um conjunto em que tudo o resto permanece igual. Os créditos gratuitos são suficientes para testar se o motivo realmente se mantém ao longo do conjunto.
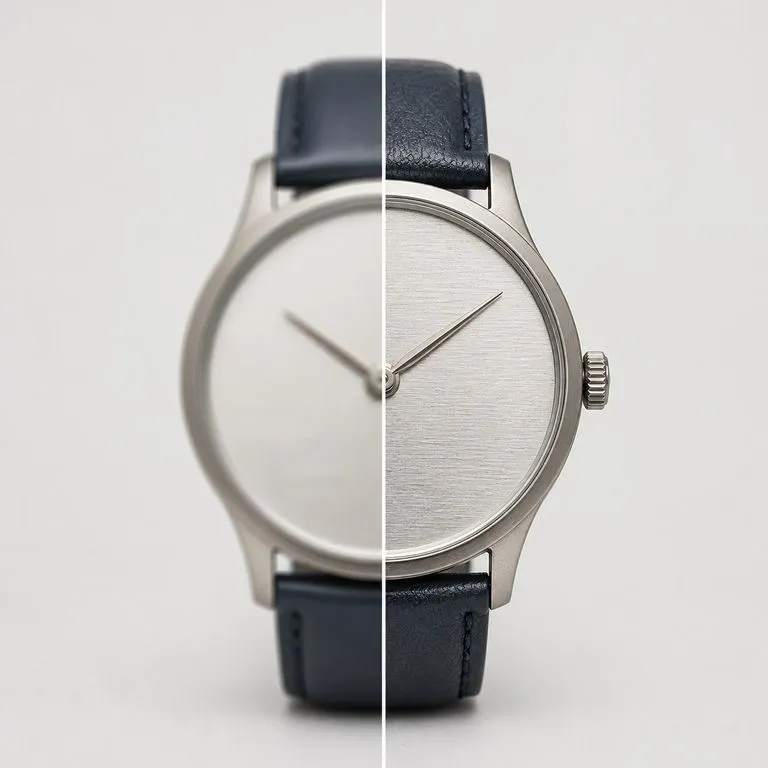
Carregue uma imagem que não tem qualidade suficiente para ser usada. Deteta o que correu mal, seja desfoque, ruído, artefactos de compressão ou simplesmente poucos píxeis, repara isso primeiro e depois renderiza na resolução que escolher.
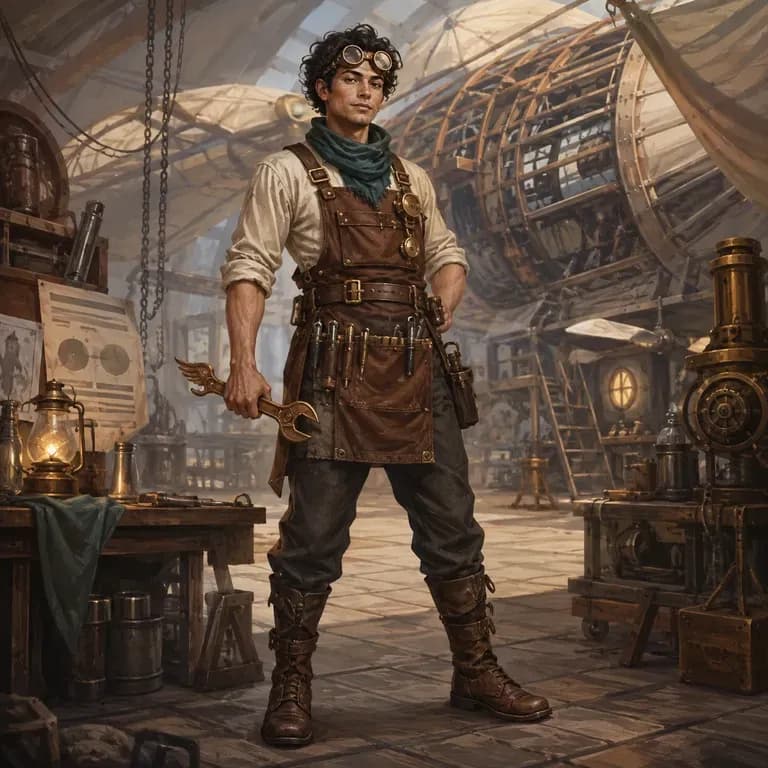
A maioria dos prompts de personagens parece boa para uma pessoa e desmorona-se perante um modelo de imagem, porque a identidade, o mundo e o estilo visual estão espalhados por três frases diferentes em vez de estarem numa só que ele consiga interpretar. Descreva quem são, gere uma versão estruturada e teste-a com uma renderização real diretamente na mesma tela. Os créditos gratuitos cobrem a primeira ronda.
Seedance 2.0 da ByteDance produz imagem e som numa passagem, a partir de um primeiro e último fotograma ou de imagens de referência, em tamanhos de 480P a 4K nativo.
Veo 3.1 da Google DeepMind gera clipes curtos com áudio sincronizado a 48 kHz e estende-os em sequências mais longas, passando os fotogramas finais para a frente.
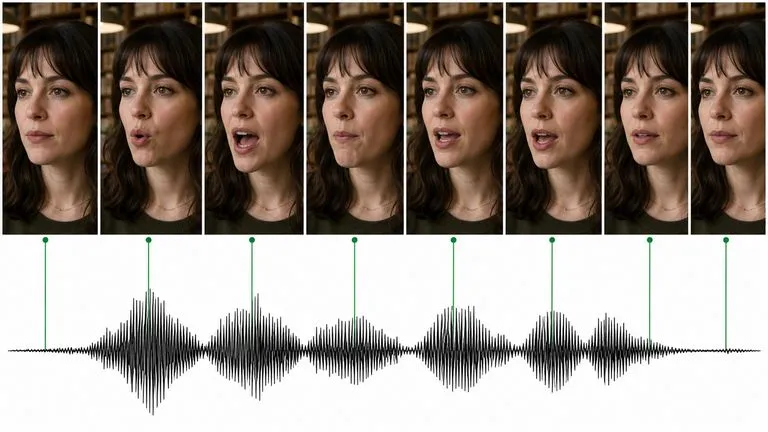
O Kling 3.0 da Kuaishou fala — diálogo sincronizado com os lábios em cinco idiomas, uma voz diferente por personagem e um modo de storyboard que estrutura uma sequência completa.
Uma imagem, uma frase e um clipe que pode observar antes de acabar de decidir se valia a pena experimentar.