
Flux MiniMax H3 : résoudre les erreurs OOM, l’audio incompréhensible et les rendus lents
Vincent11 min de lecture ·
Le meilleur flux ComfyUI pour MiniMax H3 utilise FL2VA pour T2V, I2V et la génération avec première et dernière images, passe à Ref2VA lorsque les références doivent contrôler l’identité, le mouvement, la caméra ou la voix, et sépare les aperçus rapides du rendu final. Une production H3 fiable repose sur l’orientation vers le bon modèle, la structure des références, la gestion RAM/VRAM et la qualité de l’audio natif, plutôt que sur un graphe « parfait ».
La difficulté apparaît quand les projets prennent de l’ampleur. Images multiples, références de mouvement, audio, prompts, aperçus et rendus finaux fragmentent rapidement les flux, compliquant le maintien de l’identité, la comparaison des générations, le contrôle de la mémoire et la continuité. Notre analyse de cas de flux H3 montre que réduire le coût des itérations sans dégrader l’audio est l’un des compromis de production les plus importants.
Virse répond à ce manque plus général en intégrant des agents IA dans un canevas infini.Les designers peuvent organiser les ressources, relier le contexte créatif, exécuter plusieurs agents en parallèle et travailler à partir des préférences de marque partagées et des connaissances du projet. Au lieu de remplacer les designers par une génération en un clic, Virse aide les équipes créatives professionnelles à rendre la production assistée par IA plus structurée, reproductible et évolutive. MiniMax H3, Seedance 2.5 et Seedance 2.0 sont désormais disponibles sur Virse, pour explorer et comparer plusieurs modèles vidéo de premier plan dans un même flux créatif.
Quel est le meilleur flux MiniMax H3 dans ComfyUI ?
Un flux MiniMax H3 prêt pour la production doit séparer l’exploration du rendu final. Calculer chaque graine en pleine résolution avant de savoir si la composition, le mouvement, l’identité ou la direction de caméra conviennent gaspille du temps GPU. Les recherches examinées pour ce guide confirment qu’il s’agit des principales voies officielles du flux.
Adopter un flux H3 allant de l’aperçu au rendu final
Voici une séquence pratique :
- Définir le plan — durée, format, sujet, caméra et contraintes visuelles non négociables.
- Choisir FL2VA ou Ref2VA selon le type de contrôle requis.
- Attribuer un rôle à chaque référence avant la génération.
- Générer plusieurs aperçus à résolution réduite pour comparer composition et mouvement.
- Sélectionner la meilleure graine et orientation.
- Rétablir les réglages de qualité finale pour le plan validé.
- Agrandir ou régénérer uniquement les résultats validés.
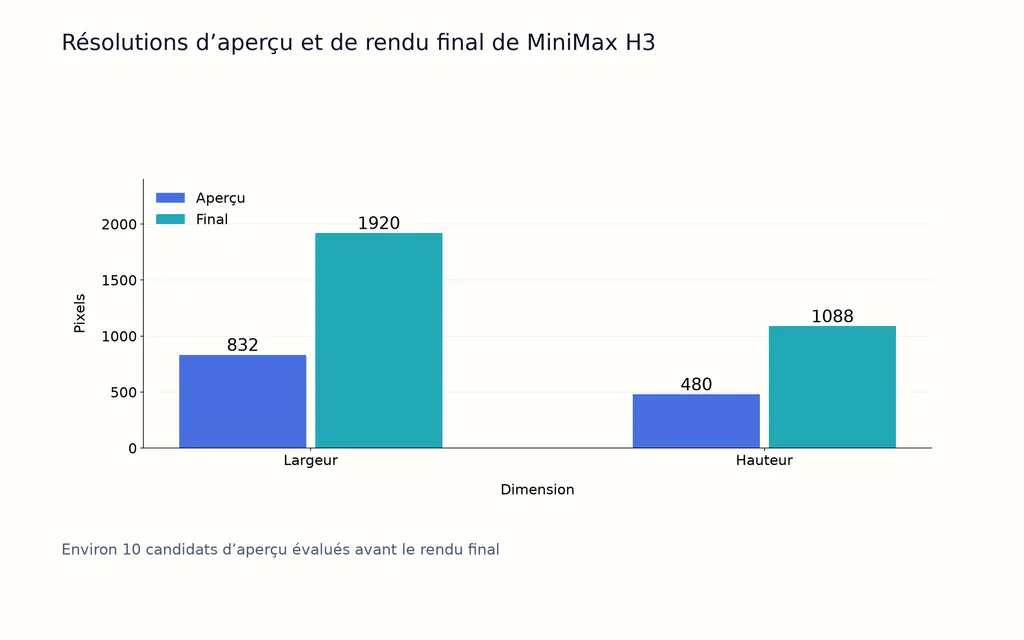
Un flux documenté utilisait des aperçus d’environ 832 × 480 avant un rendu final en 1920 × 1088, afin d’évaluer d’abord une dizaine de candidats rapides. Dans un autre cas, réduire l’échantillonnage de 20 à 10 étapes a produit des changements visuels relativement modestes, mais un audio natif nettement moins bon.
La leçon pratique est de réduire la résolution des aperçus avant de diminuer fortement les étapes, surtout lorsque le dialogue ou le son synchronisé compte.
Comment configurer MiniMax H3 dans ComfyUI
Le flux H3 officiel de ComfyUI s’articule autour de T2V, I2V et R2V, FL2VA et Ref2VA répondant à différents besoins de génération. Les recherches examinées pour ce guide confirment qu’il s’agit des principales voies officielles.
Par quel flux H3 commencer ?
Commencez par la voie la plus simple qui répond aux besoins du plan :
- T2V : FL2VA
- I2V avec une seule image : FL2VA
- Première + dernière image : FL2VA
- Référence d’identité : Ref2VA
- Référence de mouvement ou de caméra : Ref2VA
- Référence audio ou vocale : Ref2VA
- Contrôle combiné image + vidéo + audio : Ref2VA
Évitez de charger les deux grandes branches du modèle simplement parce qu’un graphe hybride le permet. Un modèle plus simple réduit la pression mémoire et facilite le diagnostic des échecs.
MiniMax H3 FL2VA et Ref2VA : quel flux utiliser ?
FL2VA est le choix efficace par défaut ; Ref2VA est le flux de contrôle multimodal.
Besoin | FL2VA | Ref2VA |
T2V | Meilleur choix | Généralement inutile |
I2V | Meilleur choix | Uniquement avec des références supplémentaires |
Première / dernière image | Pris en charge | Pas l’usage principal |
Référence d’identité | Limité | Mieux adapté |
Référence de mouvement / caméra | Non | Oui |
Référence audio | Non | Oui |
La structure officielle distingue FL2VA pour T2V, I2V et la génération conditionnée par des images, de Ref2VA pour un contrôle plus riche par références image, vidéo et audio.
Pourquoi ne pas utiliser Ref2VA pour chaque génération H3 ?
Davantage de références ne signifie pas automatiquement davantage de contrôle. Chaque image, vidéo ou entrée audio ajoute une relation que H3 doit interpréter.
Du point de vue du flux de design, utilisez le plus petit ensemble de références communiquant précisément l’intention créative. Cela réduit l’ambiguïté, le coût mémoire et la complexité du prompt.
Comment rédiger des prompts MiniMax H3 Ref2V pour mieux contrôler les références
La règle essentielle pour les prompts H3 est : attribuez à chaque référence une responsabilité explicite.
Séparer identité, mouvement, caméra, voix et son
Une instruction Ref2V structurée doit préciser :
- Image 1 : identité du personnage ou du produit
- Image 2 : éclairage, matériau ou style visuel
- Vidéo 1 : mouvement du corps uniquement
- Vidéo 2 : trajectoire de caméra uniquement
- Audio 1 : caractéristiques vocales ou timing
- Paysage sonore : audio ambiant
- Musique : la décrire séparément du dialogue et des sons diégétiques
C’est plus fiable que d’ajouter des adjectifs au prompt. La gestion des références s’apparente davantage à la direction artistique qu’à la rédaction classique de prompts.
Utiliser un compilateur de prompts pour les projets Ref2VA complexes
Un flux expérimental examiné pour ce guide utilisait un LLM multimodal pour classer les ressources, recueillir les choix de durée, format, personnage, caméra et son, puis compiler ces relations en un prompt prêt pour H3.
Pour les projets à plusieurs personnages ou références, cela apporte une couche importante qui manquait entre direction créative et génération : la gestion structurée du contexte.
Comment accélérer MiniMax H3 dans ComfyUI sans dégrader l’audio
Le flux H3 utile le plus rapide n’est pas nécessairement celui qui comporte le moins d’étapes d’échantillonnage. Un aperçu doit rester assez bon pour juger les propriétés importantes.
Réduire la résolution avant les étapes H3
Le cas documenté du passage de 20 à 10 étapes est particulièrement utile : le testeur jugeait la dégradation visuelle relativement limitée, alors que l’audio se dégradait bien plus nettement.
Pour évaluer la composition, la direction du mouvement et la caméra, réduire la résolution est généralement le réglage d’aperçu le plus sûr. Pour le dialogue, le timing, les détails du visage et la synchronisation finale, utilisez des réglages plus proches du rendu prévu.
Tester SageAttention et les optimisations de cache séparément
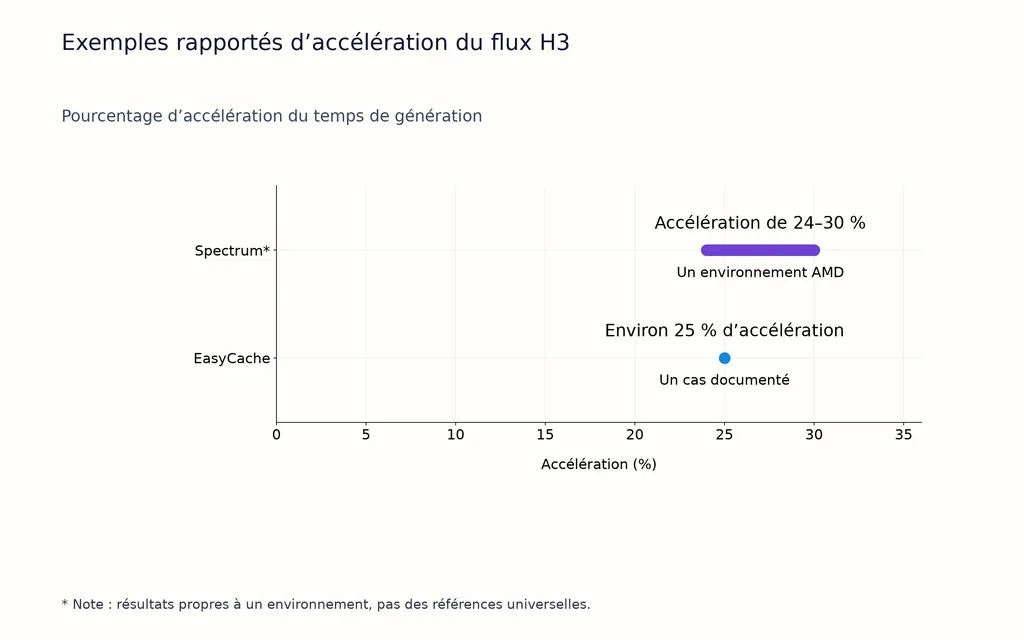
SageAttention figure dans les discussions officielles sur l’optimisation H3, tandis que les environnements communautaires montrent des gains réels variables. Spectrum a fait l’objet d’un rapport d’environ 24–30 % d’accélération dans un environnement AMD, et un cas EasyCache d’environ 25 %, mais ces observations dépendent de l’environnement et ne sont pas des références universelles.
EasyCache apparaît aussi dans des rapports signalant un dialogue ou une cohérence moins bons. Ne changez jamais simultanément SageAttention, le cache, l’échantillonneur et le nombre d’étapes si vous voulez comprendre pourquoi la qualité a changé.
Besoins en VRAM et RAM de MiniMax H3 : quel matériel faut-il ?
La planification mémoire de H3 ne peut pas reposer uniquement sur la VRAM. Les gros composants du modèle passent du GPU à la mémoire système ; la RAM et la gestion du cycle de vie du modèle peuvent donc devenir le véritable goulot d’étranglement.
Pourquoi H3 peut manquer de mémoire malgré une VRAM suffisante
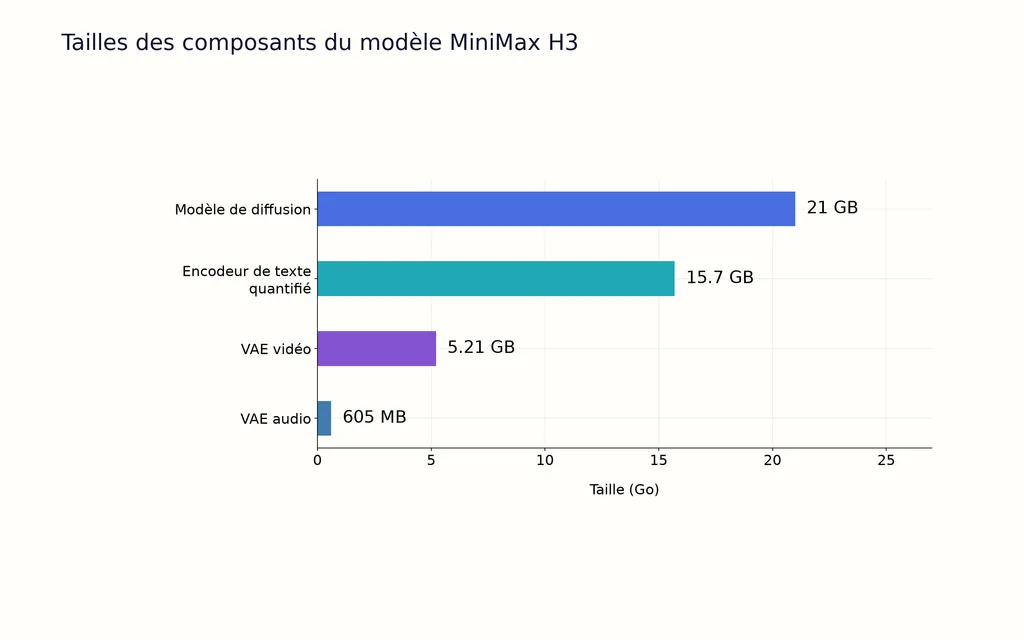
Les recherches consignent des tailles approximatives de paquets de 21 Go pour le modèle de diffusion, 15,7 Go pour un encodeur de texte quantifié, 5,21 Go pour le VAE vidéo et 605 Mo pour le VAE audio.
Le déchargement et le transfert des composants font donc partie du flux, et ne sont pas un simple entretien facultatif.
Ce que montrent les cas H3 avec 12 et 16 Go
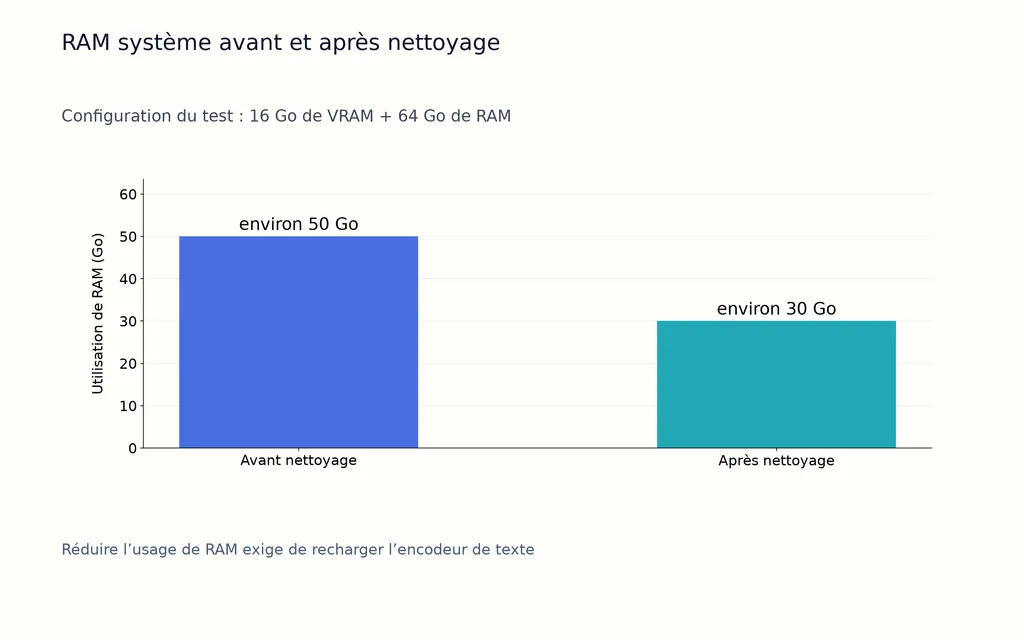
Dans une configuration documentée de 16 Go de VRAM + 64 Go de RAM, la RAM système atteignait environ 50 Go avant nettoyage, puis descendait à environ 30 Go, au prix d’un rechargement de l’encodeur de texte.
Un autre cas Ref2V avec RTX 3060 12 Go + 64 Go de RAM approchait la saturation de la RAM système en générant un clip de cinq secondes d’environ 0,35 MP.
Ce ne sont pas des références universelles, mais ces cas montrent pourquoi « H3 peut fonctionner » diffère de « H3 permet d’itérer confortablement ».
Comment résoudre l’audio incompréhensible et les problèmes de cohérence du visage dans MiniMax H3
La génération audiovisuelle native de H3 est un atout majeur, mais l’audio et l’identité nécessitent des contrôles qualité séparés.
Comment diagnostiquer l’audio incompréhensible de H3
Notre analyse des questions récurrentes sur les flux n’a pas trouvé de cause unique vérifiée à l’audio incompréhensible. Les facteurs possibles comprennent un timing de dialogue ambigu, des consignes musicales indésirables, un cache agressif et très peu d’étapes d’échantillonnage.
Le diagnostic le plus sûr consiste à revenir au flux de base, définir qui parle et quand, séparer musique et sons ambiants, rétablir les réglages normaux d’échantillonnage, puis réactiver les optimisations une à une.
Pourquoi une référence de résolution supérieure ne garantit pas l’identité
Un cas détaillé de cohérence d’identité observait encore un adoucissement ou une déformation du visage dans les plans larges ou en mouvement, malgré Ref2VA, une sortie en 1344 × 768, une référence faciale supplémentaire haute résolution, un niveau maximal de détail des références et jusqu’à 20 étapes.
Un détail de référence accru donne davantage d’informations d’identité à H3, mais ne doit pas être présenté comme une solution garantie à la cohérence du visage.
Comment créer des vidéos MiniMax H3 de plus de 15 secondes
Le flux officiel H3 à clip unique est limité à 15 secondes ; une production plus longue doit donc être traitée comme un problème de continuité, plutôt que comme une simple augmentation de durée.
Enchaîner le contexte du mouvement et de l’audio
Une approche prometteuse est :
Clip A → préserver l’état du mouvement et de l’audio → Clip B → poursuivre le contexte → Clip C
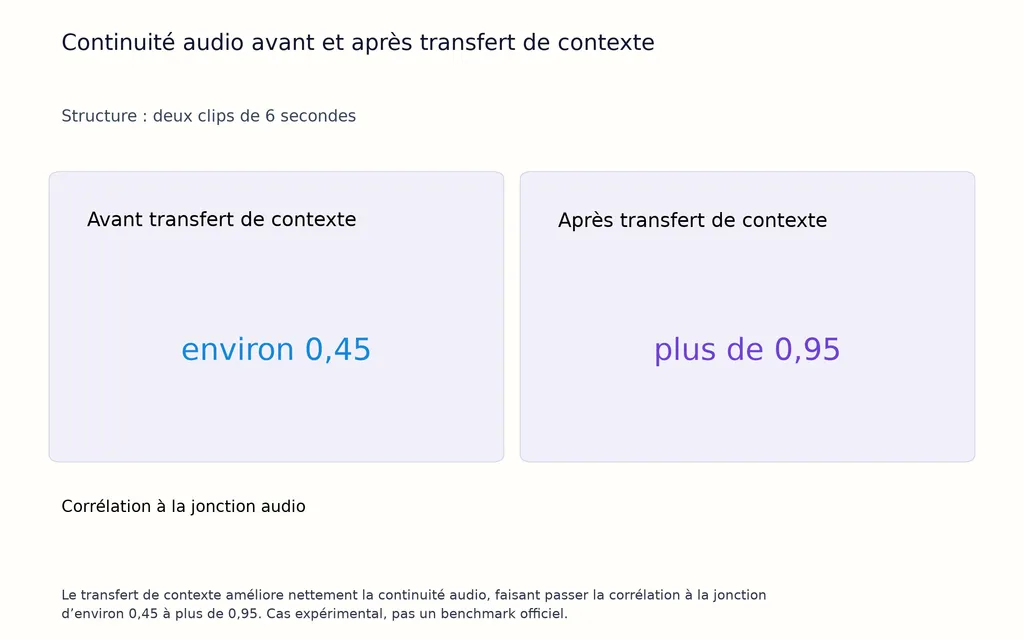
Un cas expérimental a joint deux clips de six secondes sans fondu enchaîné et signalé une amélioration de la corrélation à la jonction audio, d’environ 0,45 à plus de 0,95, après transfert du contexte.
Ce n’est pas un benchmark officiel, mais cela étaye un principe de production utile : préserver l’état entre les clips au lieu de demander à chaque génération de reconstruire la continuité de zéro.
MiniMax H3 1080p et 2K : agrandissement ou Regenerate-2K ?
En production locale, distinguez la génération H3 Base du pipeline H3 2K complet.
H3 Base est centré sur une étape de génération au petit côté de 768 pixels, tandis que l’architecture complète de MiniMax comprend une étape distincte H3-Regenerate-2K qui réutilise le contexte original pour reconstruire les détails en plus haute résolution. Les flux locaux ouverts donnent surtout accès à H3 Base ; l’agrandissement classique reste donc une voie pratique de livraison.
Quand utiliser un outil d’agrandissement
Choisissez l’agrandissement vidéo classique lorsque :
- les images générées sont déjà réussies ;
- vous souhaitez un agrandissement prévisible ;
- la rapidité de livraison compte ;
- vous ne voulez pas d’une nouvelle passe générative.
Un cas documenté avec RTX 3090 a généré un clip d’environ 14 secondes à 1 MP en quelque 40 minutes avant d’appliquer une super-résolution basée sur RTX.
Quand Regenerate-2K est plus pertinent
Choisissez une régénération sensible au contexte lorsque reconstruire de fins détails visuels à partir de l’intention multimodale originale compte davantage que la préservation déterministe. Il ne faut pas la confondre avec un simple agrandissement des pixels, et les recherches actuelles n’offrent pas de benchmark local contrôlé prouvant sa supériorité systématique.
Questions fréquentes
H3 peut-il fonctionner avec 12 Go de VRAM ?
Oui, certaines configurations de 12 Go peuvent exécuter H3 avec quantification et déport de composants, mais la RAM peut devenir limitante. Un système documenté avec RTX 3060 12 Go et 64 Go de RAM approchait la saturation de RAM lors d’une courte génération Ref2V. Matériel, quantification, résolution et configuration des nœuds peuvent modifier sensiblement les résultats.
FL2VA ou Ref2VA : lequel utiliser ?
Utilisez FL2VA pour T2V, I2V et la génération avec première/dernière image. Utilisez Ref2VA lorsque images, vidéos ou audio doivent contrôler identité, mouvement, caméra, style ou voix. Si le plan n’exige pas de contrôle multimodal par références, FL2VA est généralement plus simple et plus économe en mémoire.
Pourquoi l’audio de H3 devient-il incompréhensible ?
Il n’existe aucune cause unique vérifiée. Parmi les cas de flux examinés pour ce guide, un faible nombre d’étapes, des consignes de dialogue ambiguës, une musique indésirable et un cache agressif ont tous accompagné des échecs audio. Partez du flux standard, simplifiez les consignes audio et réintroduisez les optimisations une à une.
Regenerate-2K ou un outil d’agrandissement : lequel est préférable ?
Utilisez un outil d’agrandissement pour agrandir plus vite et de façon plus déterministe un clip réussi. Utilisez Regenerate-2K lorsque la reconstruction contextuelle des détails est prioritaire. Ils résolvent des problèmes différents : l’un agrandit un résultat existant, l’autre appartient à l’architecture plus large de régénération sensible au contexte de MiniMax.
Conclusion
Le flux MiniMax H3 ComfyUI le plus fiable est un système de production, pas un graphe unique : orienter les tâches simples vers FL2VA, n’utiliser Ref2VA que lorsque le contrôle multimodal est nécessaire, définir les rôles des références avant génération, prévisualiser à résolution réduite avant de consacrer du calcul au rendu final, gérer RAM et VRAM, valider l’audio natif avant toute accélération agressive, préserver le contexte lors des prolongements et choisir agrandissement ou régénération contextuelle 2K selon la livraison visée. Cette approche aide les designers à passer plus reproductiblement de l’expérimentation H3 à une production vidéo IA maîtrisée.
Plus d’articles du blog Virse
Flux de travail

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 octobre 2026 by Yifan Zhao
Flux de travail

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 octobre 2026 by Yifan Zhao
Flux de travail

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 octobre 2026 by Yifan Zhao