
MiniMax H3 sur Reddit : avis d’utilisateurs après des essais en local
 Yifan Zhao14 min de lecture ·
Les retours Reddit sur MiniMax H3 sont très positifs sur le respect des prompts, les mouvements complexes, la génération par références, l’audio natif et la possibilité d’exécuter localement un puissant modèle vidéo multimodal. Ces qualités rejoignent les constats de notre test de MiniMax H3. Les critiques reviennent aussi régulièrement : génération lente, besoins VRAM/RAM difficiles à comprendre, perte de détails avec Ref2Vid, dégradation des sujets éloignés et compromis de qualité liés aux optimisations.
Les échanges les plus utiles ne demandent pas seulement si H3 peut produire une démo impressionnante. Ils vérifient sa maîtrise des actions difficiles, de l’occlusion, des références, de l’audio, des clips longs et des générations locales répétées, des défis également abordés dans le transfert de mouvement MiniMax H3 et les workflows pratiques MiniMax H3. Les recherches réunies montrent aussi pourquoi les performances doivent être considérées comme des tests individuels, et non des benchmarks standardisés : matériel, résolution, étapes, quantification, cache, références et RAM varient fortement selon les workflows.
Cette distinction compte pour les designers. Un modèle qui produit un beau clip est intéressant ; un modèle qui exécute régulièrement une direction artistique sans perdre identité, détails ou rapidité de travail est utile. H3 prend donc davantage de sens au sein d’un workflow de design avec l’IA reproductible que comme outil de génération isolé.
Que pensent globalement les utilisateurs de Reddit de MiniMax H3 ?
Le sentiment général se résume à impressionnés, mais encore très expérimentaux dans leurs usages.
Les utilisateurs louent quatre domaines : suivi des instructions, mouvement et interactions physiques, références multimodales et audio intégré. En parallèle, les échanges actuels les plus visibles citent des défauts récurrents : aspect ralenti, flou pâteux et musique de fond indésirable. Un autre fil indique que les personnes deviennent difficiles à reconnaître dans des plans plus larges ou éloignés.
L’enthousiasme dépasse la vidéo classique. H3 est expérimenté pour la retouche et la génération d’images, les concepts d’affiches, tableaux de bord, infographies, voix, bruitages et contenus guidés par références.
Le verdict communautaire est donc plus nuancé que « H3 offre la meilleure qualité ». Son principal attrait est de réunir dans un système multimodal des capacités qui nécessitaient auparavant plusieurs modèles.
Performances de MiniMax H3 sur Reddit : VRAM, vitesse et essais GPU locaux
Les performances locales constituent un sujet majeur, car « Mon GPU peut-il le faire tourner ? » reçoit des réponses très différentes selon le sens donné à « tourner ».
GPU et mémoire | Test Reddit | Temps rapporté |
|---|---|---|
RTX 4090 Laptop 16 Go | 960×540, 5 s, 20 étapes | 182 s |
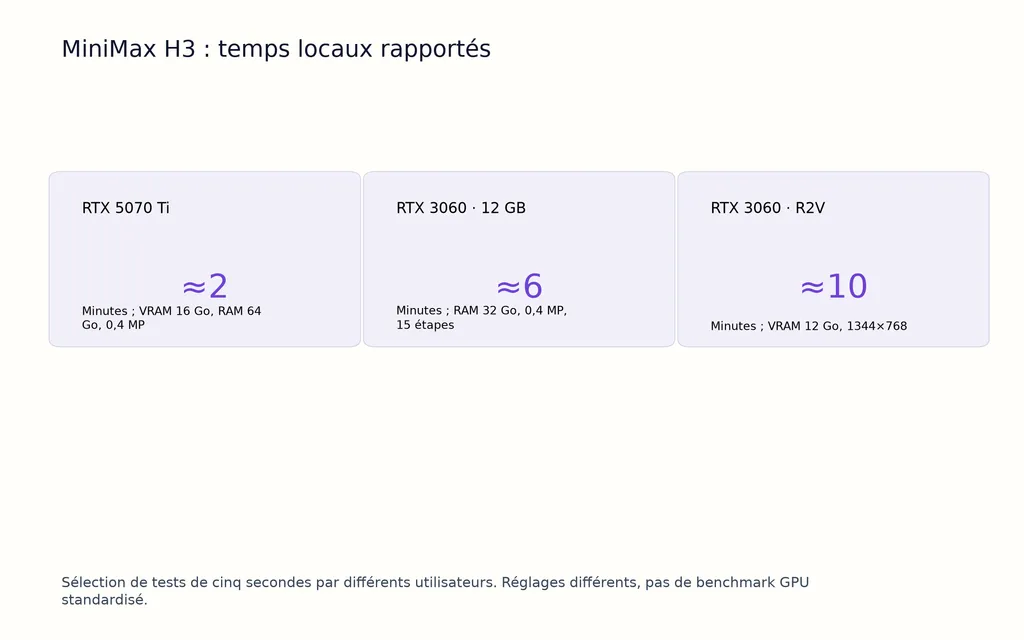
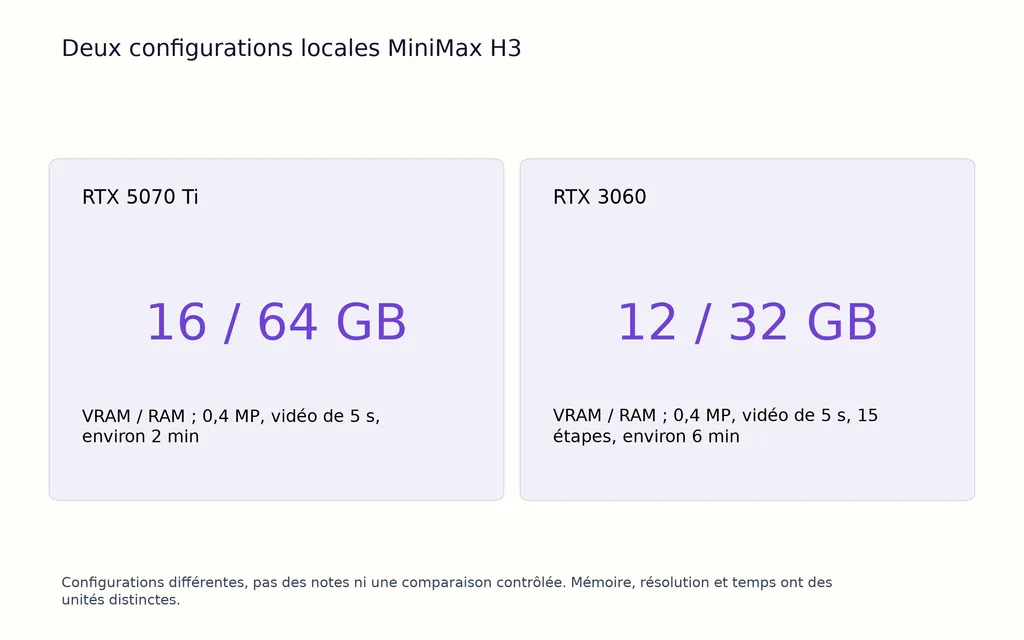
RTX 5070 Ti 16 Go + 64 Go de RAM | 0,4 MP, 5 / 10 / 15 s | Environ 2 / 4,5 / 7 min |
RTX 3060 12 Go + 32 Go de RAM | 0,4 MP, 5 s, 15 étapes | Environ 6 min |
RTX 3060 12 Go | 1344×768, 5 s en R2V | Environ 10 min |
RTX 3070 8 Go + 32 Go de RAM | 0,4 MP, 5 s en I2V | Environ 9–10 min |
RTX 3060 Laptop 6 Go + 32 Go de RAM | 480p, 5 s | Environ 700 s |
6 Go de VRAM + 16 Go de RAM | 0,2 MP, 5 s en T2V | 51 min 07 s |
Ces résultats montrent que H3 peut fonctionner avec peu de VRAM, mais la compatibilité minimale ne garantit pas une itération productive.
MiniMax H3 avec 12 Go de VRAM permet déjà d’expérimenter
Un utilisateur de RTX 3060 12 Go a généré un clip R2V de cinq secondes en 1344×768 en environ 10 minutes avec Turbo LoRA et SageAttention. Un autre essai sur 12 Go a rapporté environ six minutes pour cinq secondes à 0,4 MP et 15 étapes.
Les 12 Go sont donc intéressants : ils correspondent à du matériel grand public courant et permettent de vrais essais, au-delà d’une génération unique prouvant la faisabilité.
MiniMax H3 avec 6 Go montre pourquoi « pris en charge » peut induire en erreur
Avec 6 Go, une génération peut réussir, mais l’expérience change fortement. Un essai a demandé 51 minutes et 7 secondes pour un clip T2V de cinq secondes à 0,2 MP ; la génération par références restait infructueuse.
Pour créer, le nombre d’itérations par heure est donc plus pertinent que le minimum de VRAM. Les équipes qui hésitent entre calcul local et accès hébergé devraient aussi examiner les tarifs MiniMax H3 en plus des capacités matérielles.
Pourquoi Reddit apprécie les prompts, le mouvement et la cohérence de MiniMax H3
Les éloges qualitatifs les plus marqués concernent sa capacité à exécuter des instructions détaillées.
C’est important, car une vidéo IA paraît souvent convaincante jusqu’à ce qu’un prompt exige plusieurs contraintes simultanées : action précise, identité persistante, contact physique, timing, son et caméra. Un prompt MiniMax H3 structuré devient particulièrement précieux à mesure que ces contraintes s’accumulent.
Cas MiniMax H3 : chat, couverture et physique du tissu
Un utilisateur de RTX 5090 a volontairement demandé à un chat de ramper sous une couverture épaisse, de disparaître, de déformer couverture et matelas, puis de ressortir.
L’essai testait l’occlusion, la permanence des objets, la physique du tissu, le contact et l’identité. Selon l’utilisateur, H3 préservait mieux le visage, le motif du pelage et la couleur des yeux que ses essais LTX 2.3 précédents, qui donnaient des comportements figés ou des déformations évoquant une fonte.
Pour l’animation professionnelle et le contenu produit, cela compte plus qu’une belle première image. Les objets doivent conserver leur identité après mouvement et interaction.
Les prompts détaillés de H3 peuvent devenir un goulot d’étranglement
Le bon respect des prompts a un effet inattendu : les créateurs passent davantage de temps à préciser leurs attentes.
Un développeur d’assistant de prompts H3 a constaté que définir caméra, éclairage, composition, timing et actions pouvait prendre plus longtemps que générer la vidéo.
Pour le workflow de design, cela suggère que de meilleurs modèles ne suppriment pas la direction artistique : ils renforcent l’intérêt des systèmes capables de la structurer et de la réutiliser.
Retours Reddit sur R2V de MiniMax H3 : la vidéo par références est-elle fiable ?
La vidéo par références est l’un des grands attraits de H3, mais aussi l’un des workflows les plus irréguliers dans les essais Reddit.
Une configuration RTX 3060 12 Go a terminé du R2V en 1344×768 en environ 10 minutes. Pourtant, un autre utilisateur de RTX 5070 Ti 16 Go a rapporté qu’une tâche R2V de six secondes prenait des heures, alors qu’une génération I2V plus simple était bien plus rapide.
Ref2Vid de MiniMax H3 peut perdre beaucoup de détails
Plusieurs utilisateurs décrivent R2V comme plus flou ou plus chargé d’artefacts qu’I2V. Une discussion récente indique que passer la taille des références de match à max peut améliorer la qualité, mais avec un coût de génération important.
Une autre comparaison a montré une dégradation visible des références chez certains, tandis que d’autres obtenaient des résultats plus propres avec plusieurs références, des prompts enrichis et des rapports d’aspect mieux alignés.
La leçon est importante : la qualité des références H3 dépend fortement de la construction du workflow, pas seulement du modèle.
Synchronisation labiale et visages éloignés restent des faiblesses
Les questions réelles mentionnent aussi scintillement des yeux, visages flous, déformations lors de la synchronisation labiale image et audio, et personnages éloignés pixellisés même en haute résolution.
Pour la création commerciale, la fidélité aux références est donc un meilleur critère qu’une qualité cinématographique générale.
Optimiser MiniMax H3 sur Reddit : SageAttention, EasyCache et quantification
La lenteur de H3 a suscité un écosystème actif autour de SageAttention, EasyCache, Turbo LoRA, INT8, FP4, GGUF, des aperçus basse résolution et de l’agrandissement après génération.
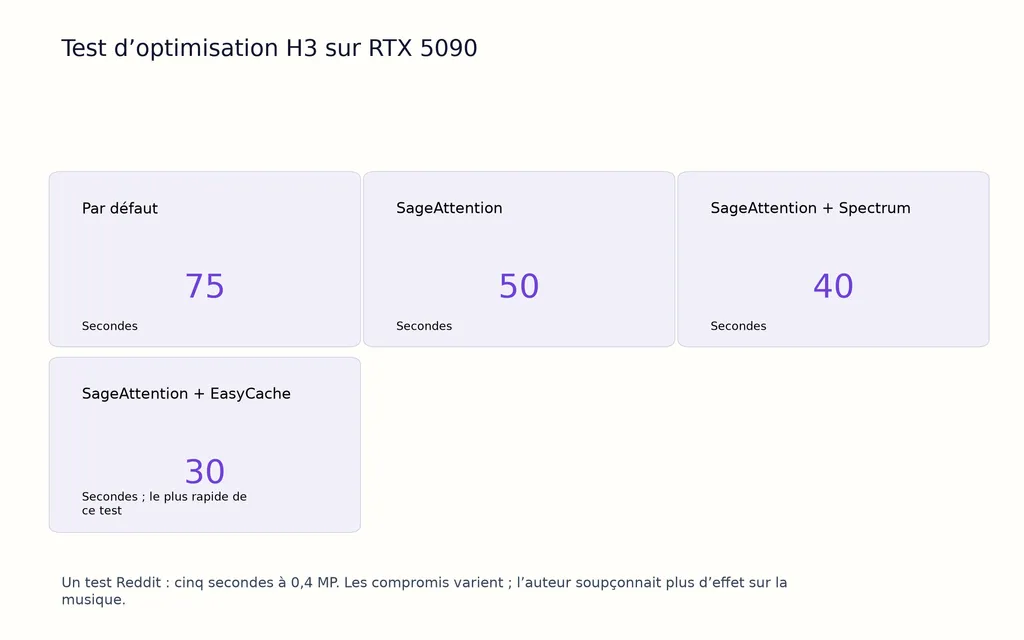
Cas MiniMax H3 : une RTX 5090 passe de 75 à 30 secondes
Un essai récent a généré cinq secondes à 0,4 MP sur une RTX 5090. L’inférence par défaut prenait 75 secondes, SageAttention l’a réduite à 50 secondes, SageAttention avec Spectrum à 40 secondes et SageAttention avec EasyCache à 30 secondes.
L’auteur n’a pas remarqué de dégradation visuelle évidente, mais soupçonnait un effet d’EasyCache plus perceptible sur la musique que sur les dialogues.
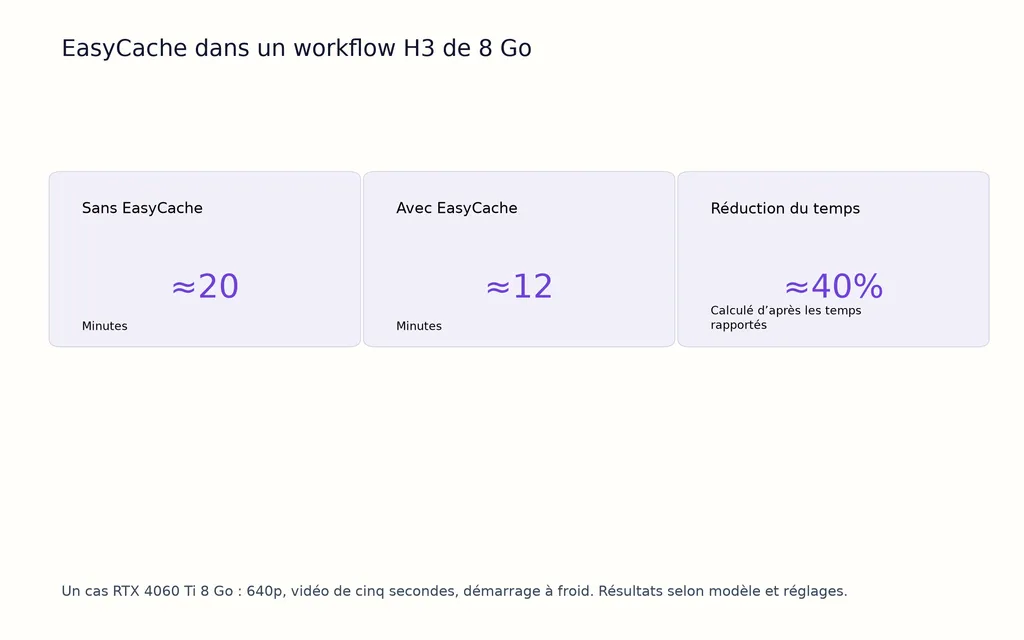
Cas MiniMax H3 : EasyCache réduit d’environ 40 % un workflow de 8 Go
Un autre essai sur RTX 4060 Ti 8 Go a rapporté qu’une génération à froid de cinq secondes en 640p passait d’environ 20 à 12 minutes après ajout d’EasyCache. D’après ces valeurs, le temps diminuait d’environ 40 %.
Pour les créateurs avec peu de VRAM, l’optimisation peut faire la différence entre une démo et un outil d’itération utilisable.
Un workflow pratique consiste donc à prévisualiser à bas coût et ne finaliser que les choix retenus : faible résolution et forte accélération pour explorer, puis réglages de qualité plus prudents pour les concepts sélectionnés.
Cas MiniMax H3 sur Reddit au-delà de la vidéo classique
Certains retours très utiles viennent de créateurs qui détournent volontairement le modèle de son usage évident.
MiniMax H3 pour générer affiches, tableaux de bord et infographies
Un essai ComfyUI générait une séquence courte puis en extrayait une image, traitant H3 comme un pseudo-modèle d’image.
Le créateur a testé portraits, affiches, maquettes de magazines, tableaux de bord, infographies, graphiques, typographie et visuels de fantasy. H3 comprenait utilement hiérarchie, palettes, icônes et direction artistique détaillée, mais fautes, faux microtextes, données graphiques erronées et artefacts du VAE vidéo exigeaient toujours une vérification humaine.
H3 est donc intéressant pour l’exploration de concepts, sans être fiable pour une typographie finale ou une visualisation de données.
MiniMax H3 pour l’audio et le bruitage presque en temps réel
Un autre utilisateur a réduit l’image à 32×32 pixels pour générer surtout de l’audio. Sur RTX 5090, de nombreux essais produisaient plus de secondes d’audio que de secondes de calcul. Il jugeait environ 45 secondes plus fiables, les dialogues de 60 secondes commençant à perdre leur cohérence.
Cela permet d’explorer voix et effets sonores à bas coût, de choisir un audio, puis de le réutiliser comme référence pour la génération visuelle finale.
Cas MiniMax H3 : 15 secondes avec plusieurs plans
Un essai haut de gamme sur RTX PRO 6000 Blackwell 96 Go a généré une séquence multi-plans d’environ 1 MP et 15 secondes en 23 minutes, avec diffusion et encodage texte BF16. Le créateur déclarait avoir obtenu l’essentiel de la séquence en une génération, sans réparer les images ni remplacer les cartons de texte avant l’agrandissement final.
Plus largement, il faut évaluer le rendu par rapport au temps total du workflow, pas seulement à l’inférence.
MiniMax H3, LTX 2.3 et Wan : que préfère Reddit ?
Reddit ne désigne aucun gagnant universel entre MiniMax H3, LTX 2.3 et Wan.
Dans un essai à prompt identique, le créateur indiquait que H3 prenait environ trois fois plus de temps que LTX 2.3, mais préférait son résultat et souhaitait des workflows Turbo plus rapides. Dans une autre comparaison par vidéo de référence, les commentaires préféraient le jeu et les réactions de H3, tout en soulignant l’intérêt d’un prompt propre au modèle, détaillé comme un storyboard, plutôt qu’identique entre modèles.
Wan reste un point de comparaison local important. Un utilisateur avec 12 Go de VRAM et 16 Go de RAM a produit du R2V en 640×480 en 13 minutes et appréciait que son poste reste utilisable pendant la génération H3, contrairement à son ancien workflow Wan.
Le choix doit donc suivre les besoins du workflow : LTX peut être préférable pour la vitesse ; H3 devient intéressant lorsque direction détaillée, références, jeu, mouvement ou audio intégré priment.
Quels problèmes MiniMax H3 reviennent le plus sur Reddit ?
Six limites reviennent particulièrement souvent dans les recherches.
Vitesse de génération : une tâche de cinq secondes peut prendre quelques minutes ou plus de 50 minutes, certains workflows R2V demandant des heures.
Complexité VRAM/RAM : les utilisateurs hésitent entre INT8, FP4, GGUF, déchargement mémoire et checkpoints.
Dégradation des références : R2V peut lisser les détails ou introduire des artefacts malgré des sources propres.
Flou du VAE : un essai contrôlé d’encodage/décodage montrait déjà une perte de détails du visage et de la peau avant la diffusion ; dans ce workflow, contourner le problème par une résolution supérieure pouvait multiplier le temps par environ 3 à 5.
Plans larges : les gros plans tiennent mieux que les sujets éloignés ou en pied, parfois pixellisés ou méconnaissables.
Artefacts de mouvement et d’audio : les retours citent un aspect ralenti indésirable, des images pâteuses et une musique de fond générée sans demande.
Ces limites expliquent le passage de « H3 peut-il générer cela ? » à « Comment rendre H3 utilisable de façon reproductible ? ».
FAQ MiniMax H3 sur Reddit : les vraies questions
MiniMax H3 peut-il tourner avec 8 Go de VRAM ?
Oui. Des utilisateurs l’ont fait fonctionner sur des GPU de 8 Go, dont une RTX 3070 produisant cinq secondes I2V à 0,4 MP en environ 9–10 minutes. Toutefois, 32 Go de RAM, quantification, déchargement et optimisation peuvent être essentiels. Une configuration 8 Go est exploitable, mais demande des réglages importants.
Quel modèle MiniMax H3 utiliser avec 12 Go de VRAM ?
La communauté n’a pas de réponse unique pour tous les workflows. Certains conseillent INT8 optimisé pour certaines configurations 12 Go ; Turbo LoRA et SageAttention ont aussi donné des résultats pratiques. Les observations les plus probantes montrent des générations de cinq secondes en environ 6–10 minutes avec des réglages adaptés.
Pourquoi R2V de MiniMax H3 est-il beaucoup plus lent qu’I2V ?
R2V traite des images, vidéos et parfois audios de référence supplémentaires, augmentant mémoire et calcul. Face aux ralentissements extrêmes, les utilisateurs essaient des références plus courtes, moins définies, redimensionnées avant conditionnement et moins de déchargement mémoire. Les recherches comprennent un cas de 5070 Ti où six secondes R2V prenaient des heures.
Pourquoi Ref2Vid de MiniMax H3 est-il parfois moins bon qu’I2V ?
Redimensionnement, rapport d’aspect, complexité du conditionnement et reconstruction VAE peuvent intervenir. Mieux préparer les références et enrichir les prompts peut aider, mais aucune correction n’est universelle. Il faut tester Ref2Vid séparément, sans supposer un transfert automatique de la qualité I2V.
EasyCache, SageAttention ou Turbo LoRA réduisent-ils la qualité H3 ?
Ils peuvent créer des compromis variables selon la configuration. Certains essais rapportent de forts gains sans perte visuelle évidente, d’autres s’inquiètent des détails ou de l’audio. En production, accélérez fortement les aperçus puis comparez les générations finales retenues avec des réglages moins compressés.
Pourquoi les visages MiniMax H3 semblent-ils parfois flous ou plastiques ?
Une partie du problème peut venir du VAE. Un essai contrôlé d’encodage/décodage perdait déjà des détails du visage et de la peau sans diffusion. Les références et la synchronisation labiale peuvent ajouter scintillement ou déformation ; résolution supérieure, références soignées et inspection finale restent importantes.
MiniMax H3 peut-il dépasser 15 secondes sans dérive des personnages ?
Les utilisateurs expérimentent des clips plus longs et des continuations ; certains rapportent des générations réussies de 10 secondes. Toutefois, les recherches communautaires disponibles ne démontrent pas une identité durablement fiable au-delà du workflow habituel de vidéo courte. Pour la production, des segments courts et contrôlés restent plus prudents.
Peut-on utiliser MiniMax H3 pour le design et l’image ?
À titre expérimental, oui. Des utilisateurs ont extrait des images de séquences courtes pour créer affiches, tableaux de bord, magazines, infographies, portraits et autres visuels fixes. Sa réponse aux consignes artistiques détaillées est prometteuse, mais texte, données et petits détails graphiques exigent encore une vérification humaine.
Verdict Reddit sur MiniMax H3 : faut-il l’utiliser ?
MiniMax H3 mérite des essais sérieux si contrôle, mouvement, références, génération multimodale et souplesse locale comptent davantage que la vitesse brute d’inférence. Les tests Reddit montrent des tâches exigeantes sur du matériel étonnamment accessible, mais l’expérience s’améliore nettement avec davantage de VRAM, de RAM et d’optimisation.
La conclusion la plus intéressante révèle une évolution du design IA : la qualité du modèle n’est plus le seul obstacle. Il faut aussi organiser les références, réutiliser la direction, comparer les itérations, coordonner les tâches et conserver le contexte du projet.
C’est là qu’interviennent les systèmes centrés sur le workflow. Virse se positionne par exemple autour d’un canevas où l’IA assiste les designers professionnels, plusieurs agents partagent le contexte et les préférences d’équipe ou connaissances de marque persistent, sans repartir à chaque fois d’un prompt vide. Le lien avec H3 n’est pas de remplacer le modèle, mais de rendre les modèles toujours plus capables utiles dans un processus créatif structuré.
Le signal le plus fort des retours Reddit n’est donc pas simplement « une meilleure vidéo IA ». Les utilisateurs veulent un modèle qui comprenne une direction créative exigeante et un workflow qui rende cette capacité rapide, reproductible et maîtrisable.
Plus d’articles du blog Virse
Inspiration
What Is Layout Design? Principles, Grids, Hierarchy & Real Examples
7 octobre 2026 by Yifan Zhao
Inspiration
What Are Design Principles? 9 Rules That Make Good Design Easier to Explain
23 septembre 2026 by Yifan Zhao
Inspiration
What Is an AI-Powered Design System for Brands?
8 août 2026 by Vincent