MiniMax H3 Reddit 리뷰: 로컬 테스트 후 실제 사용자 평가
 Yifan Zhao12분 읽기 ·
MiniMax H3에 관한 Reddit 반응은 프롬프트 준수, 복잡한 동작, 참조 기반 생성, 네이티브 오디오, 강력한 멀티모달 영상 모델을 로컬에서 실행할 수 있다는 점에 매우 긍정적입니다. 이는 기존 MiniMax H3 리뷰의 전반적인 결과와도 맞닿습니다. 불만도 일관됩니다. 생성이 느리고 VRAM·RAM 요구 사항이 혼란스러우며, Ref2Vid에서 세부가 사라지고 먼 피사체가 자주 손상되며 최적화가 품질 타협을 요구할 수 있습니다.
유용한 Reddit 논의는 인상적인 데모를 만들 수 있는지만 묻지 않습니다. 어려운 행동, 가림, 참조, 오디오, 긴 클립, 반복 로컬 생성에서도 제어가 유지되는지 시험합니다. 이는 MiniMax H3 모션 전이와 실용적인 MiniMax H3 워크플로에서도 다루는 과제입니다. 이번 조사 자료는 성능 수치를 표준 벤치마크가 아닌 개별 사용자 테스트로 봐야 하는 이유도 보여 줍니다. 하드웨어, 해상도, 스텝, 양자화, 캐시, 참조, RAM이 크게 다르기 때문입니다.
이 차이는 디자이너에게 중요합니다. 좋은 클립 하나를 만드는 모델은 흥미롭지만, 정체성·세부·작업 속도를 망치지 않고 아트 디렉션을 반복 수행하는 모델은 실용적입니다. 따라서 H3는 독립 생성 도구보다 반복 가능한 AI 디자인 워크플로 안에서 더 의미가 있습니다.
Reddit 사용자는 MiniMax H3를 전반적으로 어떻게 평가하나요?
전반적인 분위기는 감탄하지만 여전히 실험적인 사용이 많다고 요약할 수 있습니다.
사용자는 지시 준수, 움직임과 물리적 상호작용, 멀티모달 참조, 통합 오디오를 반복해서 칭찬합니다. 동시에 주목받는 논의에서는 슬로모션처럼 보이는 출력, 번진 흐림, 원치 않는 배경음악이 지적됩니다. 다른 글은 인물이 넓거나 먼 샷으로 이동하면 알아보기 어려워진다고 보고합니다.
관심은 일반 영상 생성을 넘어섭니다. H3는 이미지 편집 및 생성, 포스터 콘셉트, 대시보드, 인포그래픽, 음성, 폴리 효과음, 참조 기반 콘텐츠에도 실험적으로 쓰이고 있습니다.
커뮤니티 평가는 ‘H3 품질이 최고’보다 복합적입니다. 가장 큰 매력은 이전에 여러 모델이 필요했던 능력을 하나의 멀티모달 시스템에서 탐색할 수 있다는 점입니다.
Reddit의 MiniMax H3 성능: VRAM·속도·로컬 GPU 테스트
로컬 성능은 큰 화제입니다. ‘내 GPU에서 실행되나요?’라는 질문은 실행의 의미에 따라 답이 크게 달라지기 때문입니다.
GPU 및 메모리 | Reddit 테스트 | 보고 시간 |
|---|---|---|
RTX 4090 Laptop 16GB | 960×540, 5초, 20스텝 | 182초 |
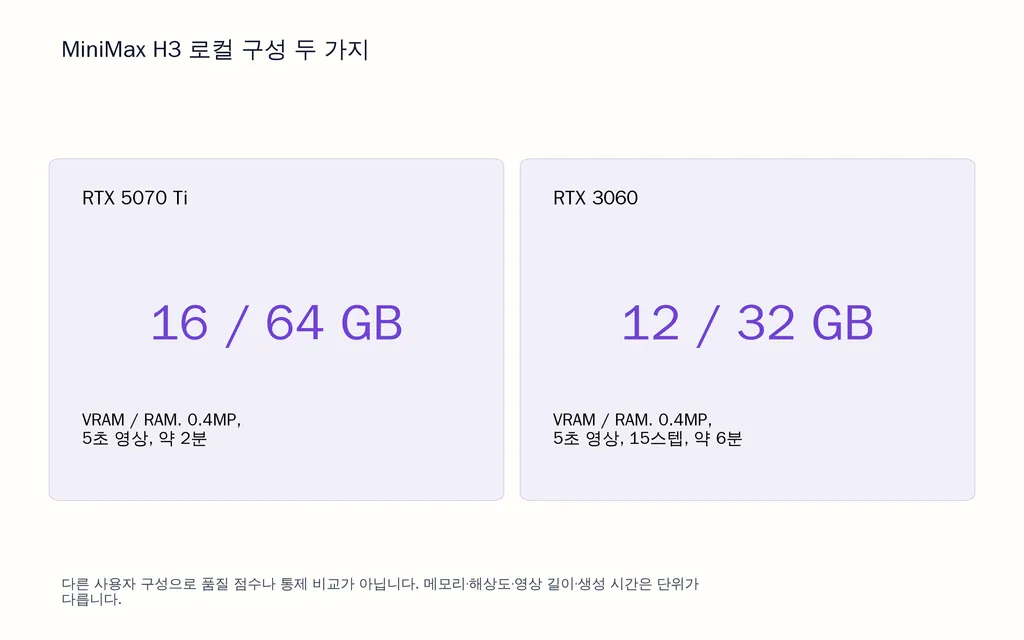
RTX 5070 Ti 16GB + RAM 64GB | 0.4MP, 5 / 10 / 15초 | 약 2 / 4.5 / 7분 |
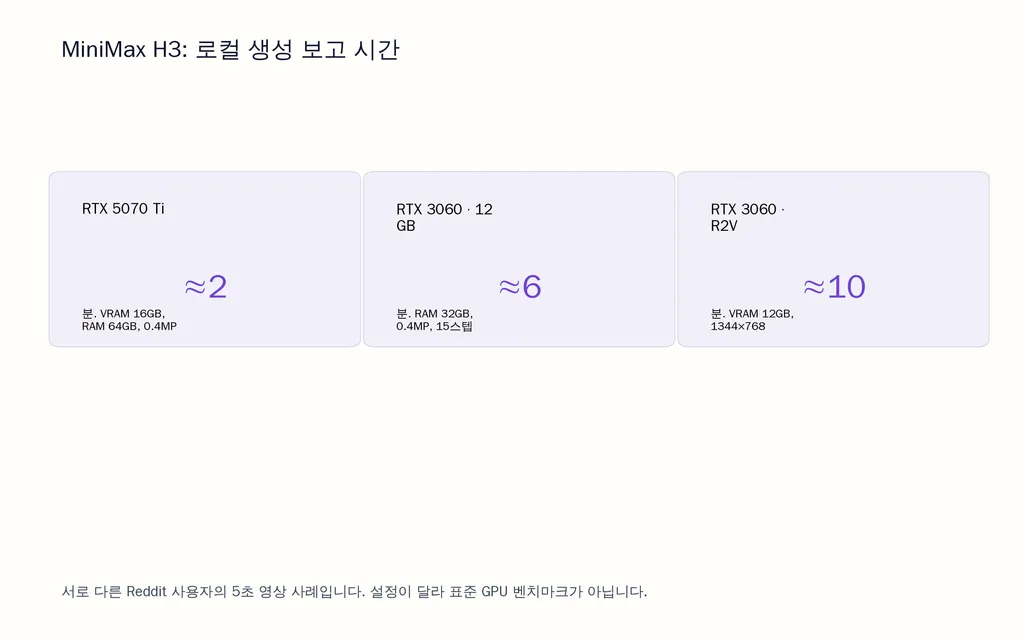
RTX 3060 12GB + RAM 32GB | 0.4MP, 5초, 15스텝 | 약 6분 |
RTX 3060 12GB | 1344×768, 5초 R2V | 약 10분 |
RTX 3070 8GB + RAM 32GB | 0.4MP, 5초 I2V | 약 9~10분 |
RTX 3060 Laptop 6GB + RAM 32GB | 480p, 5초 | 약 700초 |
VRAM 6GB + RAM 16GB | 0.2MP, 5초 T2V | 51분 07초 |
이 결과는 H3가 적은 VRAM에서도 실행되지만 최소 호환성과 생산적인 반복 작업은 다르다는 점을 보여 줍니다.
VRAM 12GB의 MiniMax H3는 이미 실험에 쓸 수 있습니다
RTX 3060 12GB 사용자는 Turbo LoRA와 SageAttention으로 1344×768의 5초 R2V 클립을 약 10분에 생성했습니다. 다른 12GB 테스트는 0.4MP·15스텝의 5초 영상을 약 6분에 만들었다고 보고했습니다.
12GB는 일반 소비자용 하드웨어에 해당하면서, 한 번의 생성으로 가능성을 입증하는 수준을 넘어 실제 실험을 할 만큼 빠르다는 점에서 주목할 만합니다.
VRAM 6GB의 H3가 보여 주는 ‘지원’이라는 표현의 한계
6GB에서도 생성에 성공할 수 있지만 경험은 크게 달라집니다. 한 테스트는 0.2MP의 5초 T2V에 51분 7초가 걸렸고, 참조 생성은 계속 실패했습니다.
창작에서는 최소 VRAM보다 시간당 반복 횟수가 더 유용한 지표입니다. 로컬 연산과 호스팅 서비스를 비교하는 팀은 하드웨어 성능과 함께 MiniMax H3 가격도 고려해야 합니다.
Reddit이 MiniMax H3의 프롬프트 준수·동작·일관성을 칭찬하는 이유
가장 강한 정성적 호평은 상세 지시를 실행하는 능력에 집중됩니다.
AI 영상은 특정 행동, 지속되는 정체성, 물리 접촉, 타이밍, 소리, 카메라를 동시에 요구하기 전까지 그럴듯해 보이기 쉽습니다. 이런 제약이 쌓일수록 체계적인 MiniMax H3 프롬프트가 중요해집니다.
MiniMax H3 사례: 고양이·담요·천의 물리 표현
RTX 5090 사용자는 고양이가 두꺼운 담요 밑으로 기어 들어가 사라지고, 담요와 매트리스를 변형한 뒤 다시 나오도록 의도적으로 요청했습니다.
실험은 가림, 물체 영속성, 천의 물리 표현, 접촉, 정체성을 시험했습니다. 사용자는 H3가 이전 LTX 2.3 시도보다 고양이 얼굴, 털무늬, 눈 색을 잘 유지했다고 보고했습니다. 이전 시도에서는 녹아내리거나 멈춘 듯한 모습이 나왔습니다.
전문 애니메이션과 제품 콘텐츠에서는 예쁜 첫 프레임보다 중요합니다. 물체는 움직이고 상호작용한 뒤에도 자기 모습을 유지해야 합니다.
상세한 H3 프롬프트 자체가 병목이 될 수 있습니다
높은 프롬프트 준수에는 예상 밖의 결과가 있습니다. 창작자가 원하는 것을 명시하는 데 더 많은 시간을 쓰게 됩니다.
H3용 프롬프트 도우미 개발자는 카메라, 조명, 구도, 타이밍, 행동을 정하는 시간이 영상 생성보다 길어질 수 있다고 관찰했습니다.
디자인 관점에서 더 좋은 모델이 아트 디렉션을 없애지는 않습니다. 이를 구조화하고 재사용하는 시스템의 가치를 높입니다.
MiniMax H3 R2V Reddit 평가: 참조 기반 영상은 얼마나 안정적인가요?
참조 기반 영상은 H3의 강한 매력이면서 Reddit 테스트에서 가장 일관성이 낮은 워크플로 중 하나입니다.
RTX 3060 12GB 구성은 1344×768 R2V를 약 10분에 완료했습니다. 반면 RTX 5070 Ti 16GB 사용자는 6초 R2V에 몇 시간이 걸렸다고 했습니다. 더 단순한 I2V는 훨씬 빨랐습니다.
MiniMax H3 Ref2Vid는 세부를 크게 잃을 수 있습니다
여러 사용자는 R2V가 I2V보다 흐리거나 아티팩트가 많다고 설명합니다. 최근 논의에서는 참조 이미지 크기를 match에서 max로 바꾸면 품질이 개선되지만 생성 시간이 크게 늘어날 수 있다고 했습니다.
다른 비교에서는 일부 사용자의 참조 세부가 눈에 띄게 손상됐지만, 여러 참조, 확장 프롬프트, 더 정확한 종횡비 정렬로 훨씬 깔끔한 결과를 얻은 사용자도 있었습니다.
중요한 교훈은 H3 참조 품질이 모델 능력뿐 아니라 워크플로 구성에 크게 좌우된다는 점입니다.
립싱크와 먼 얼굴은 여전히 약점입니다
실제 질문에는 눈 깜빡임 불안정, 흐린 얼굴, 이미지·오디오 립싱크의 변형, 고해상도에서도 먼 인물이 픽셀처럼 보이는 문제가 포함됩니다.
상업 창작에서는 일반적인 영화 같은 품질보다 참조 충실도가 더 나은 평가 기준입니다.
Reddit의 MiniMax H3 최적화: SageAttention·EasyCache·양자화
H3 속도 문제는 SageAttention, EasyCache, Turbo LoRA, INT8, FP4, GGUF, 저해상도 미리보기, 생성 후 확대를 중심으로 활발한 최적화 생태계를 만들었습니다.
MiniMax H3 사례: RTX 5090에서 75초를 30초로 단축
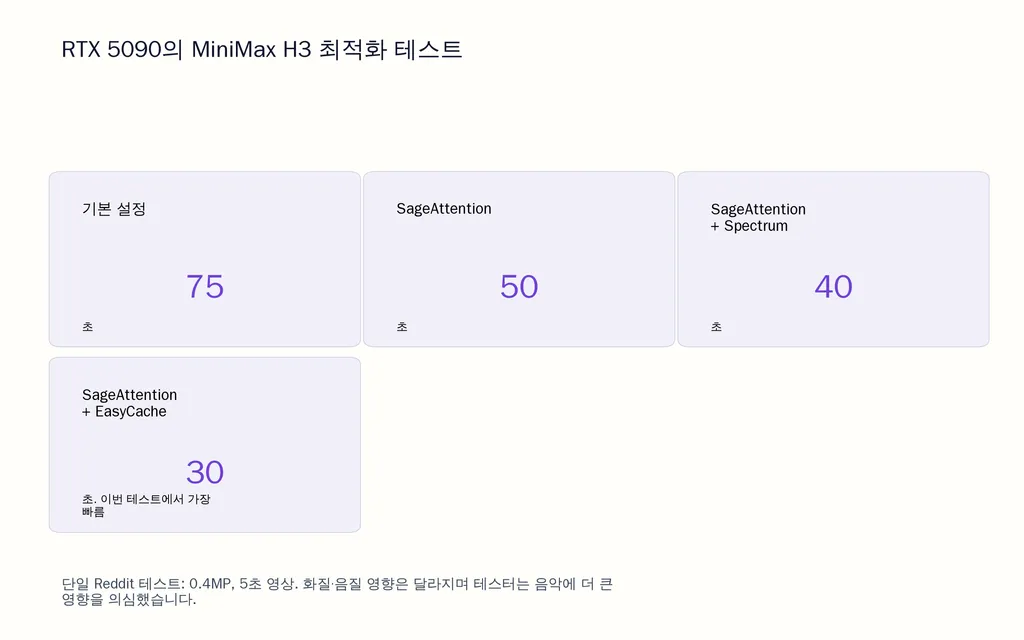
최근 한 테스트는 RTX 5090에서 0.4MP의 5초 영상을 생성했습니다. 기본 추론은 75초, SageAttention은 50초, SageAttention과 Spectrum은 40초, SageAttention과 EasyCache는 30초가 걸렸습니다.
테스터는 뚜렷한 시각적 손실을 보지 못했지만, EasyCache가 대사보다 음악의 음질에 더 큰 영향을 줄 수 있다고 추측했습니다.
MiniMax H3 사례: EasyCache로 8GB 워크플로 시간 약 40% 절감
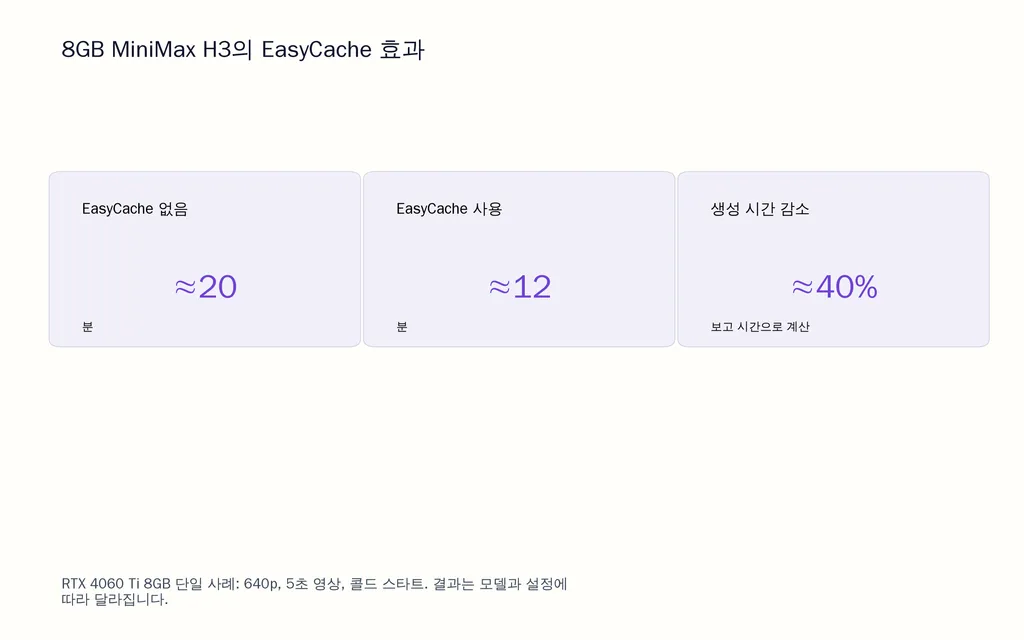
별도 RTX 4060 Ti 8GB 테스트에서는 EasyCache 추가 후 콜드 스타트 기준 640p의 5초 생성이 약 20분에서 12분으로 줄었다고 보고했습니다. 이 수치로 계산하면 약 40% 감소입니다.
VRAM이 적은 창작자에게 최적화는 H3가 데모인지 실용적인 반복 도구인지를 결정할 수 있습니다.
실용적인 방식은 저렴하게 미리 보고 선택한 것만 마무리하는 것입니다. 탐색에서는 해상도를 낮추고 더 강하게 가속한 뒤, 선택한 콘셉트는 품질을 보수적으로 유지하는 설정으로 렌더링하세요.
일반 영상 생성을 넘어선 Reddit의 MiniMax H3 사례
가치 있는 평가 중 일부는 모델의 뻔한 용도를 벗어나 의도적으로 실험한 창작자에게서 나옵니다.
포스터·대시보드·인포그래픽 생성기로서의 MiniMax H3
한 ComfyUI 실험은 짧은 시퀀스를 생성하고 한 프레임을 추출해 H3를 유사 이미지 모델로 사용했습니다.
창작자는 초상화, 포스터, 잡지 레이아웃, 대시보드, 인포그래픽, 차트, 타이포그래피, 판타지 키아트를 시험했습니다. H3는 계층, 색상, 아이콘, 상세 연출을 유용하게 이해했지만 오탈자, 가짜 작은 글자, 잘못된 차트 데이터, 영상 VAE 아티팩트는 여전히 사람이 확인해야 했습니다.
따라서 H3는 콘셉트 탐색에 흥미롭지만 최종 타이포그래피나 데이터 시각화를 믿고 맡길 수는 없습니다.
준실시간 오디오·폴리 생성기로서의 MiniMax H3
다른 사용자는 출력을 32×32픽셀로 줄이고 H3를 주로 오디오에 사용했습니다. RTX 5090의 여러 테스트에서 생성 시간보다 긴 오디오가 나왔습니다. 약 45초가 더 안정적이었고 60초 대사는 일관성을 잃기 시작했다고 합니다.
목소리나 효과음을 저렴하게 탐색하고, 오디오를 선택한 뒤, 최종 시각 생성에 참조로 다시 사용하는 흐름을 만들 수 있습니다.
MiniMax H3 사례: 15초 멀티샷 생성
고급 RTX PRO 6000 Blackwell 96GB 테스트에서는 BF16 확산 및 텍스트 인코딩으로 약 1MP의 15초 멀티샷 시퀀스를 23분에 생성했습니다. 창작자는 최종 확대 전에 프레임 수리나 텍스트 카드 교체 없이 대부분의 요구 장면을 한 번에 만들었다고 보고했습니다.
더 넓은 교훈은 추론만 보지 말고 전체 워크플로 시간을 기준으로 렌더 시간을 평가해야 한다는 점입니다.
MiniMax H3·LTX 2.3·Wan: Reddit은 무엇을 선호하나요?
Reddit에서 MiniMax H3, LTX 2.3, Wan 중 보편적인 승자는 드러나지 않습니다.
동일 프롬프트 비교에서 창작자는 H3에 LTX 2.3의 약 세 배 시간이 걸렸지만 H3 결과를 선호했고 더 빠른 Turbo형 워크플로를 원했습니다. 다른 참조 영상 비교에서도 H3의 연기와 반응을 선호했지만, 모델마다 같은 프롬프트를 쓰기보다 H3에 맞는 상세한 스토리보드형 지시가 유리하다고 강조했습니다.
Wan은 여전히 중요한 로컬 비교 대상입니다. VRAM 12GB와 RAM 16GB 사용자는 640×480 R2V를 13분에 생성했고, 이전 Wan 흐름과 달리 H3 생성 중에도 워크스테이션을 쓸 수 있다는 점을 높이 평가했습니다.
모델 선택은 작업 요구를 따라야 합니다. 속도가 우선이면 LTX가 나을 수 있고, 상세 연출·참조·연기·움직임·통합 오디오가 중요하면 H3가 매력적입니다.
Reddit 사용자가 꼽는 MiniMax H3의 가장 큰 문제
조사에서 여섯 가지 한계가 가장 자주 반복됩니다.
생성 속도: 5초 작업이 몇 분에서 50분 이상 걸리며 일부 R2V는 몇 시간이 필요합니다.
VRAM·RAM 복잡성: INT8, FP4, GGUF, 오프로딩 전략, 체크포인트 선택이 어렵습니다.
참조 손상: 원본이 깨끗해도 R2V가 세부를 흐리거나 아티팩트를 만들 수 있습니다.
VAE 흐림: 통제된 VAE 인코딩·디코딩 실험에서는 확산 전에 얼굴과 피부 세부가 줄었습니다. 해당 워크플로에서 해상도를 높여 우회하면 생성 시간이 약 3~5배가 될 수 있었습니다.
와이드샷 품질: 클로즈업이 먼 인물이나 전신보다 잘 유지되며 후자는 픽셀화되거나 알아보기 어려울 수 있습니다.
동작·오디오 아티팩트: 원치 않는 슬로모션, 번진 프레임, 요청하지 않은 배경음악이 보고됩니다.
이 한계 때문에 논의는 ‘H3가 만들 수 있나?’에서 ‘H3를 어떻게 반복적으로 실용화하나?’로 옮겨가고 있습니다.
MiniMax H3 Reddit FAQ: 사용자의 실제 질문
MiniMax H3를 VRAM 8GB에서 실행할 수 있나요?
네. RTX 3070으로 0.4MP의 5초 I2V를 약 9~10분에 생성한 사례 등 8GB GPU 성공 사례가 있습니다. 다만 RAM 32GB, 양자화, 오프로딩, 최적화가 핵심일 수 있습니다. 8GB는 사용 가능하지만 많은 조정이 필요한 구성입니다.
VRAM 12GB에는 어떤 MiniMax H3 모델이 좋나요?
모든 워크플로에 맞는 단일 답은 없습니다. 일부 12GB 구성에는 최적화 INT8이 권장되며 Turbo LoRA와 SageAttention도 실용적인 결과를 냈습니다. 비교적 확실한 근거는 적절한 설정에서 12GB 시스템이 5초 영상을 약 6~10분에 생성할 수 있다는 점입니다.
MiniMax H3 R2V가 I2V보다 훨씬 느린 이유는 무엇인가요?
R2V는 추가 이미지·영상·경우에 따라 오디오 참조를 처리해 메모리와 연산량이 늘어납니다. 극단적으로 느릴 때 사용자는 참조 단축, 참조 해상도 축소, 컨디셔닝 전 크기 변경, 오프로딩 감소를 시험합니다. 조사에는 5070 Ti의 6초 R2V가 몇 시간 걸린 사례도 있습니다.
MiniMax H3 Ref2Vid가 I2V보다 나빠 보일 때가 있는 이유는 무엇인가요?
참조 크기 조정, 종횡비 불일치, 컨디셔닝 복잡성, VAE 재구성이 영향을 줄 수 있습니다. 참조 준비와 프롬프트 확장으로 개선된 보고는 있지만 보편적인 해결책은 없습니다. I2V 품질이 자동으로 이어진다고 가정하지 말고 별도 워크플로로 시험해야 합니다.
EasyCache·SageAttention·Turbo LoRA는 H3 품질을 낮추나요?
설정별로 다른 타협이 생길 수 있습니다. 일부 테스트는 뚜렷한 시각 손실 없이 큰 가속을 보고하지만 다른 테스트는 미세 세부나 음질을 우려합니다. 제작에서는 미리보기를 적극 가속하고 최종 선택본을 압축이 덜한 설정과 비교하세요.
MiniMax H3 얼굴이 흐리거나 플라스틱처럼 보이는 이유는 무엇인가요?
일부 원인은 VAE일 수 있습니다. 통제된 인코딩·디코딩 시험은 확산 모델 없이도 얼굴과 피부 세부 손실을 보였습니다. 참조 흐름과 립싱크가 깜빡임이나 변형을 더할 수 있으므로 높은 해상도, 신중한 참조 준비, 결과 검수가 중요합니다.
MiniMax H3는 15초를 넘어도 캐릭터를 유지할 수 있나요?
사용자는 긴 클립과 연속 생성을 적극 시험하며 일부는 10초 생성 성공을 보고합니다. 하지만 현재 커뮤니티 조사로는 일반적인 짧은 영상 흐름을 넘는 장기 정체성 일관성이 입증되지 않았습니다. 제작에서는 짧고 제어된 구간이 더 안전한 선택입니다.
MiniMax H3를 디자인과 이미지 생성에 쓸 수 있나요?
실험적으로 가능합니다. 짧은 시퀀스에서 프레임을 추출해 포스터 콘셉트, 대시보드, 잡지, 인포그래픽, 인물화 등 정적인 디자인을 만들었습니다. 상세 아트 디렉션 반응은 유망하지만 텍스트 정확도, 차트 데이터, 작은 그래픽 세부는 사람이 검증해야 합니다.
MiniMax H3 Reddit 결론: 사용할 가치가 있나요?
순수 추론 속도보다 제어, 움직임, 참조, 멀티모달 생성, 로컬 작업의 유연성을 중시하는 창작자라면 MiniMax H3를 진지하게 시험할 가치가 있습니다. Reddit 테스트는 의외로 접근하기 쉬운 하드웨어에서 어려운 과제를 수행함을 보여 주지만, VRAM·RAM·최적화가 좋아질수록 경험도 크게 개선됩니다.
더 흥미로운 결론은 AI 디자인의 전반적인 변화입니다. 모델 품질만이 병목은 아닙니다. 참조 정리, 연출 재사용, 반복 결과 비교, 작업 조율, 프로젝트 맥락 보존도 필요합니다.
여기서 워크플로 중심 시스템이 중요해집니다. 예를 들어 Virse는 AI가 전문 디자이너를 돕는 캔버스형 디자인을 지향하며, 여러 에이전트가 맥락을 공유하고 팀 선호나 브랜드 지식을 계속 유지해 매번 빈 프롬프트로 시작하지 않도록 합니다. H3와의 관계는 모델 대체가 아니라 더 강해진 모델을 체계적인 창작 과정에 넣어 유용하게 만드는 데 있습니다.
따라서 Reddit 반응의 가장 강한 신호는 단순히 ‘더 좋은 AI 영상’이 아닙니다. 사용자는 까다로운 창작 지시를 이해하는 모델과, 그 능력을 빠르고 반복 가능하며 통제 가능하게 만드는 워크플로를 원합니다.