
Génération et retouche d’images avec MiniMax H3 : pourquoi un modèle vidéo peut aussi servir de modèle d’image
 Yifan Zhao13 min de lecture ·
MiniMax H3 peut générer et retoucher des images fixes, car le T2I et la retouche I2I faisaient déjà partie de son entraînement multimodal, même si H3 est actuellement surtout connu comme modèle vidéo. La documentation de lancement de H3 par MiniMax inclut explicitement le T2I, le T2V, la référence et la retouche généralisées, la référence et la retouche I2I, ainsi que la référence et la retouche I2V. La génération d’images avec H3 ne se résume donc pas à extraire par chance une belle image d’une vidéo ; comprendre comment utiliser MiniMax H3 aide à situer ces capacités dans les flux de travail réels.
La difficulté consiste à transformer cette capacité sous-jacente en une image fixe prête pour la production. Parmi les flux H3 et les questions d’utilisateurs examinés, le modèle s’est montré particulièrement intéressant pour la composition, l’identité des personnages, le contrôle multiréférence, les changements de caméra et les retouches complexes ; les visages éloignés, les textures fines et la finition au pixel près restaient moins fiables. Un flux structuré de prompts MiniMax H3 peut aider à maîtriser ces variables plus délibérément. L’enjeu dépasse la création d’une image : il s’agit de préserver l’intention créative entre références, révisions, images et mouvement.
Virse repose sur ce flux multimodèle. Son expérience actuelle réunit plus de 50 modèles sur un même canevas visuel, avec des outils tels que Nano Banana 2, GPT Image 2, Seedance 2.0 et MiniMax H3 au sein de son écosystème. Au lieu de déplacer références et résultats entre des fenêtres de prompts isolées, les designers peuvent conserver le contexte visuel, comparer les directions et passer des modèles d’image aux modèles vidéo dans un même flux de conception avec l’IA, soutenu par des flux créatifs multiagents.
MiniMax H3 est-il un modèle d’image ou de vidéo ?
Il convient de voir H3 comme un modèle de génération multimodal généraliste dont les checkpoints H3 actuellement publiés sont principalement conçus pour produire de la vidéo et de l’audio.
Cette distinction entre les capacités du modèle et la sortie du produit explique pourquoi la génération d’images avec H3 semble d’abord contradictoire.
H3 a été entraîné à générer des images et des vidéos
MiniMax n’a pas entraîné H3 uniquement à la prédiction vidéo. Le périmètre de préentraînement publié comprend la génération d’images et la retouche I2I, en plus des tâches vidéo, audio, de référence et intermodales.
Cela suggère une autre architecture pour l’IA créative : plutôt que de traiter le T2I, l’I2I, le T2V et le contrôle des références comme des problèmes entièrement distincts, H3 apprend les relations entre le contexte multimodal et la sortie cible.
Cependant, la fiche publique de H3 décrit actuellement H3-Base-FL2VA et H3-Base-Ref2VA comme produisant de la vidéo et de l’audio. Cela signifie que les capacités issues du préentraînement sont plus larges que la principale voie de sortie exposée par les checkpoints H3 publiés.
Niveau | Ce que prend en charge H3 |
|---|---|
Préentraînement | T2I, T2V, retouche I2I et tâches de référence multimodale |
Checkpoints H3 publics | Principalement des sorties vidéo et audio |
Flux d’images fixes | Génération et retouche à une seule image ou à un nombre minimal d’images |
Principale opportunité | Mieux intégrer les capacités d’image de H3 dans des produits |
Comment fonctionne la génération d’une image unique avec MiniMax H3 ?
Les flux utiles d’images fixes avec H3 ne visent pas une vidéo ordinaire comme produit final. Ils réduisent au minimum la génération temporelle afin de produire ou d’extraire efficacement une image fixe contrôlée.
Certains flux visent une configuration à une seule image, tandis que d’autres génèrent un paquet minimal d’images et décodent la meilleure image fixe. Cette description est techniquement plus exacte que l’idée selon laquelle tous les flux d’image H3 fonctionnent exactement de la même façon.
Pourquoi la conception du flux d’image unique compte
Un processus pratique d’images fixes avec H3 comprend généralement :
- Fournir du texte, une image source ou plusieurs références.
- Définir la relation entre ces entrées et le résultat souhaité.
- Réduire la génération temporelle inutile.
- Décoder le résultat pour l’utiliser comme image fixe.
- Affiner uniquement les textures ou les visages encore problématiques, si nécessaire.
Pour les designers, H3 devient ainsi un outil pratique pour le concept art, les fiches de personnages, les storyboards, les visuels de campagne, les scènes de produits et la retouche contrôlée. Ces usages expliquent aussi où MiniMax H3 est le plus pertinent dans une chaîne créative plus large.
Pourquoi le VAE visuel de H3 compte pour la qualité d’image
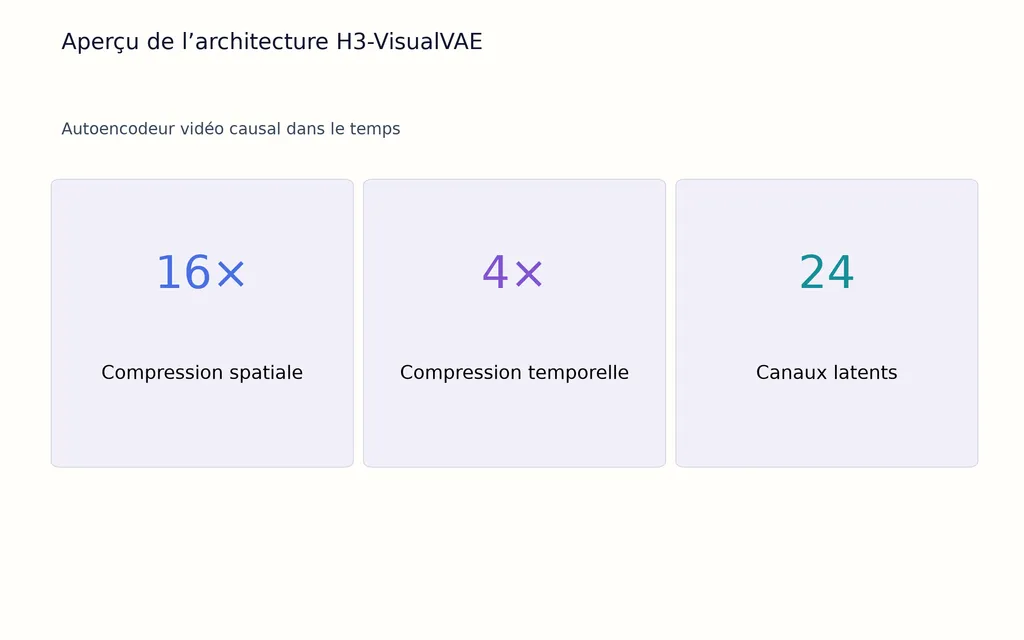
H3-VisualVAE est officiellement décrit comme un autoencodeur vidéo causal dans le temps, avec une compression spatiale de 16×, une compression temporelle de 4× et 24 canaux latents. C’est un contexte important pour évaluer une image statique.
Cela ne signifie pas que le VAE est seul responsable de tous les problèmes de qualité, mais aide à comprendre l’importance de la configuration des images et de la stratégie de décodage. Un processus optimisé pour la représentation temporelle ne l’est pas automatiquement pour toutes les exigences de l’image fixe, notamment les cheveux, la peau, les tissus, la typographie et les petits visages.
Que permet la retouche d’images MiniMax H3 dans les flux réels ?
La retouche d’images avec H3 est surtout utile lorsqu’il faut modifier une propriété significative tout en en préservant plusieurs autres.
Notre recherche a couvert des flux de changement de vêtements et d’âge, d’ajustement corporel, de remplacement de lieu, de changement de caméra, de contrôle de pose, de stylisation, de retouche de pose guidée par la profondeur, de fiches de personnages et de variantes de storyboards.
Étude de cas : modification locale, préservation globale
Prenons un visuel de mode dont le designer souhaite uniquement changer la tenue.
Une retouche réussie doit préserver :
- l’identité ;
- l’expression du visage ;
- la position du corps ;
- l’angle de caméra ;
- l’éclairage ;
- l’environnement ;
- les objets non concernés.
C’est plus difficile que de générer une image de remplacement visuellement similaire. Le modèle doit comprendre ce qui est modifiable et ce qui a déjà été validé.
Ce principe de modification locale avec préservation globale est l’une des façons les plus utiles d’envisager la retouche H3 pour le design professionnel.
Étude de cas : retouche en 1920 × 1088 en environ huit secondes
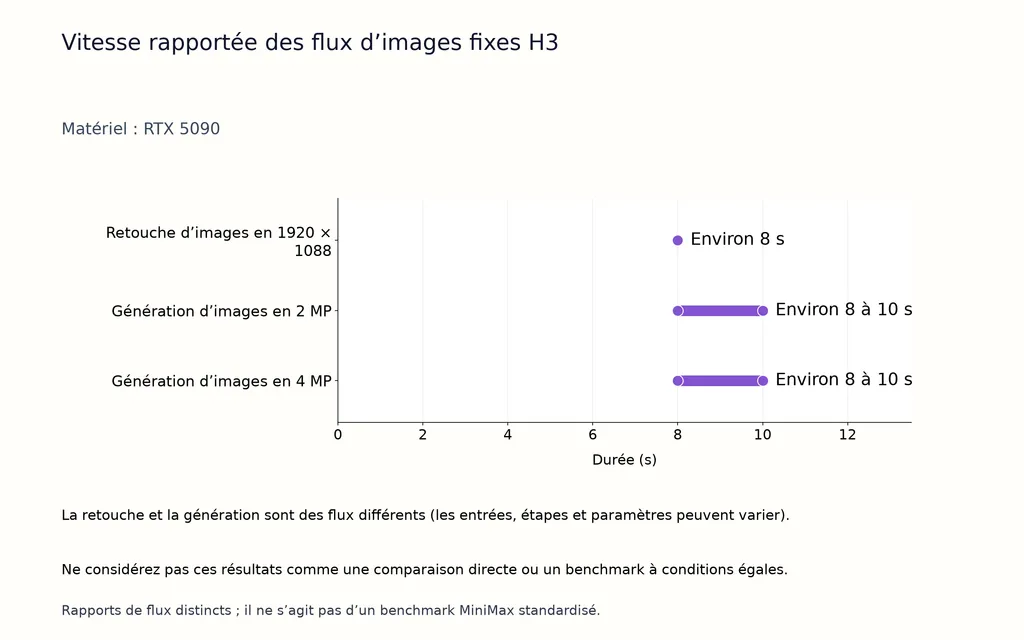
Un flux sur RTX 5090 inclus dans notre recherche rapportait environ huit secondes pour de nombreuses retouches d’une image unique en 1920 × 1088, notamment des tâches de vêtements, d’âge, de corps, de lieu, de caméra et de fiches de personnages.
Il ne s’agit pas d’un benchmark officiel de MiniMax. Le matériel, la précision, le VAE, la configuration du flux et la complexité de la tâche influent tous sur la latence.
Ce cas montre en revanche que la retouche H3 peut être assez rapide pour une exploration visuelle itérative, où le designer doit comparer de nombreuses variantes contrôlées plutôt qu’attendre un seul rendu final.
Que valent la retouche multiréférence et la cohérence des personnages de H3 ?
Le contrôle multiréférence est l’un des principaux atouts de H3 pour les flux d’image et de design.
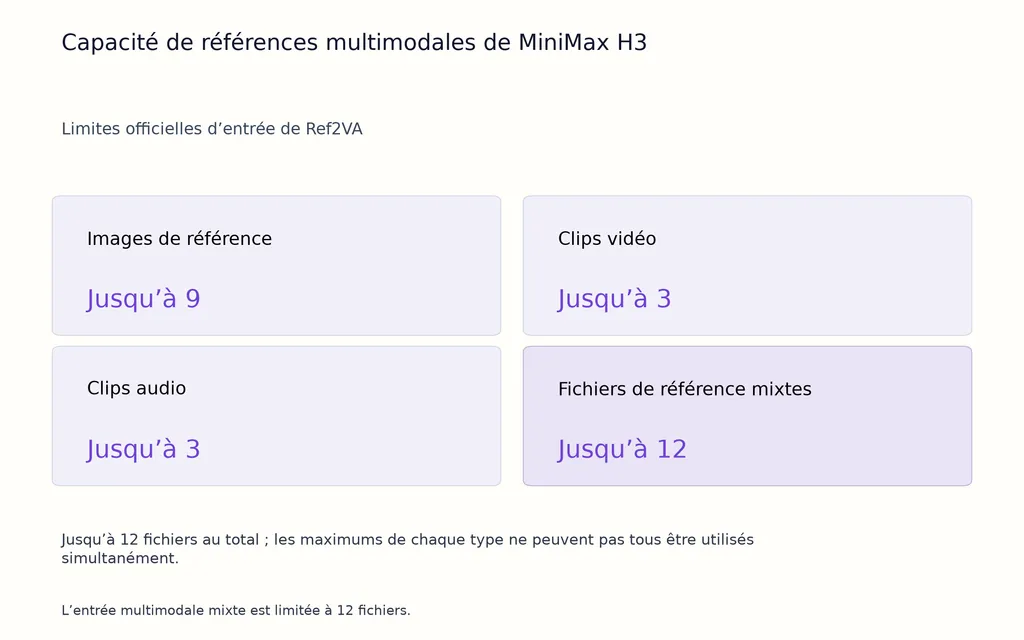
La spécification officielle Ref2VA de MiniMax prend en charge jusqu’à neuf images de référence, ainsi que jusqu’à trois clips vidéo et trois clips audio. L’entrée mixte de références multimodales est limitée à 12 fichiers.
Une référence peut contrôler l’identité, une autre le style
L’intérêt n’est pas simplement d’importer neuf images, mais d’attribuer différents rôles créatifs aux références.
Référence | Rôle créatif |
|---|---|
Image 1 | Identité du personnage |
Image 2 | Vêtements |
Image 3 | Produit |
Image 4 | Éclairage |
Image 5 | Orientation stylistique |
Un prompt ou une couche de contexte peut ensuite décrire comment ces ressources doivent interagir. Une structure claire de prompt de design avec l’IA devient particulièrement utile lorsque plusieurs références doivent assumer des rôles distincts.
Pour les personnages, cela offre une alternative à l’entraînement immédiat d’une LoRA. Le conditionnement par références peut être plus rapide pour les storyboards, l’exploration de campagnes, les fiches de personnages et les petites productions, tandis que LoRA reste utile lorsqu’une équipe doit reproduire très fidèlement une identité sur une série beaucoup plus vaste.
Où la génération d’images H3 est-elle la plus forte ?
Notre analyse suggère que les meilleures capacités d’image de H3 sont sémantiques plutôt que purement liées aux pixels.
Le modèle devient particulièrement intéressant lorsque plusieurs contraintes doivent coexister : identité, caméra, relations spatiales, références, éclairage, composition et direction créative explicite.
Composition, direction artistique et compréhension spatiale
Dans les flux comparatifs examinés, H3 se distinguait souvent par :
- la composition complexe ;
- la fidélité aux références ;
- le positionnement des personnages ;
- l’interprétation de la caméra ;
- les relations spatiales ;
- le respect de la direction artistique.
Certaines comparaisons individuelles préféraient la composition de H3 à celle des flux GPT Image, tandis que d’autres tests préféraient la retouche basée sur Flux pour la qualité finale.
Il ne s’agit pas de benchmarks standardisés. L’enseignement pratique est plus utile : testez H3 lorsque comprendre le brief est plus difficile que peaufiner les pixels.
Comment H3 gère-t-il la typographie et le graphisme ?
Les flux d’images fixes H3 ont aussi été explorés pour les affiches, les mises en page de magazine, les tableaux de bord, les infographies et d’autres compositions graphiques structurées.
Sa valeur dépasse ainsi les images cinématographiques. Une bonne composition et une solide compréhension du contexte peuvent aider à établir la hiérarchie, le placement et la direction visuelle.
La typographie est une autre question. Notre analyse a aussi relevé des déformations récurrentes du texte, surtout lorsque le résultat dépend de petits caractères ou d’un libellé exact. H3 est donc plus convaincant pour explorer une mise en page et une direction visuelle que pour valider automatiquement la typographie finale. Le texte de production doit toujours être vérifié ou reconstruit dans un environnement de design éditable.
Pourquoi les images H3 sont-elles floues ou faibles sur les visages éloignés ?
Les limites récurrentes des images fixes H3 dans notre recherche étaient le flou, les textures brouillées, la peau d’aspect plastique, les visages éloignés peu réussis, les petits visages déformés, les arrière-plans mous et le texte incohérent.
Ces problèmes révèlent une distinction importante en production :
Une composition peut être sémantiquement correcte sans être prête à livrer.
Étude de cas : génération d’images H3 en 2 MP ou 4 MP
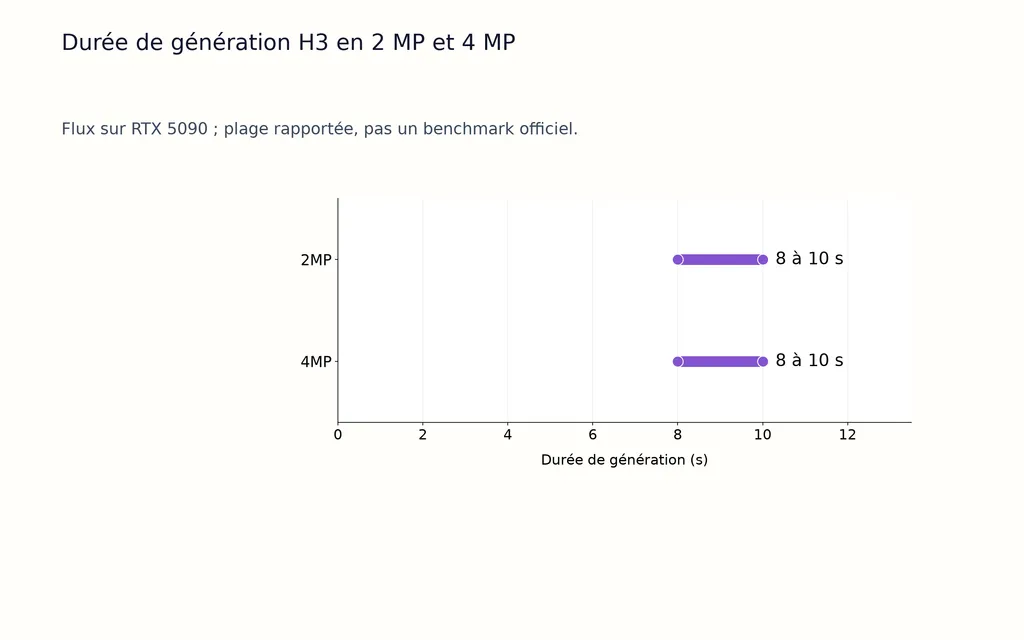
Un flux sur RTX 5090 utilisé de longue date dans notre recherche avait généré des milliers d’images fixes H3 et rapportait environ 8 à 10 secondes pour les générations en 2 MP et 4 MP avec sa configuration.
Augmenter la résolution vers 4 MP a réduit certaines déformations faciales, mais les problèmes de visages éloignés et de manque de netteté des arrière-plans n’ont pas été entièrement résolus.
Ce résultat est précieux, car il montre pourquoi demander davantage de pixels ne suffit pas. La résolution aide, mais le comportement du VAE, l’échelle du sujet, le décodage, la quantification et la manière dont le modèle traite les structures fines comptent aussi.
Pourquoi H3-Regenerate-2K va au-delà d’un simple agrandissement
MiniMax adopte une approche plus intéressante pour la sortie vidéo haute résolution. H3-Regenerate-2K réinjecte le résultat de plus basse résolution dans H3 avec le contexte multimodal d’origine.
Au lieu de demander à un système de super-résolution distinct de deviner les informations manquantes à partir des seuls pixels, la régénération peut réutiliser le prompt et les références pour reconstruire les détails fins.
MiniMax cite précisément les petits textes et les détails fins comme exemples où la régénération contextuelle peut retrouver des informations que la super-résolution classique devrait autrement déduire.
Pour les futurs flux d’image H3, cette idée pourrait compter davantage qu’un simple agrandissement.
Quel est le meilleur flux d’image H3 pour la production ?
Pour le design professionnel actuel, je considérerais d’abord H3 comme un moteur sémantique et de références, puis j’utiliserais sélectivement un modèle d’image natif pour la finition.
Étape 1 : utiliser H3 pour la structure créative
H3 convient bien pour résoudre :
- l’identité ;
- la composition ;
- la pose ;
- la caméra ;
- les relations entre références ;
- la structure de la scène ;
- les modifications complexes ;
- la continuité du storyboard.
Étape 2 : affiner uniquement les pixels faibles
Les flux examinés combinaient les sorties H3 avec des outils comme Flux.2 Klein 9B, Qwen Image Edit et SeedVR pour améliorer les visages, les tissus, les cheveux et les textures fines.
Le danger est l’excès de retouche. Un second modèle peut réparer une texture tout en modifiant accidentellement l’expression, l’éclairage, la pose ou l’identité.
Le meilleur objectif de production est donc une récupération sélective des détails préservant la sémantique, et non une régénération sans limites.
C’est aussi pourquoi un espace multimodèle peut être plus utile que la fidélité à un modèle unique. Virse cherche actuellement à conserver de nombreux modèles et ressources visuelles sur un même canevas, afin qu’une équipe puisse confier composition, retouche, finition et mouvement à différents modèles sans perdre le contexte créatif environnant.
Questions fréquentes
H3 est-il un modèle d’image ou de vidéo ?
H3 est un modèle de génération multimodal généraliste, mais ses checkpoints H3 actuellement publiés produisent surtout de la vidéo et de l’audio. La génération d’images fait néanmoins partie de ses capacités sous-jacentes, car MiniMax a inclus le T2I ainsi que la référence et la retouche I2I dans le préentraînement.
H3 peut-il générer une seule image sans créer une vidéo ordinaire ?
Oui. Les flux d’images fixes peuvent minimiser la génération temporelle avec une seule image ou un nombre minimal d’images, puis décoder le résultat pour un usage en image. Le flux exact varie : la génération d’images H3 ne doit donc pas être présentée comme une chaîne officielle universelle d’image unique.
Pourquoi les images H3 sont-elles floues, et le 4 MP résout-il le problème ?
Une résolution supérieure peut réduire certaines déformations faciales, mais le cas en 4 MP analysé n’a pas entièrement éliminé les problèmes de visages éloignés ni le manque de netteté des arrière-plans. La résolution, le comportement du VAE, la configuration des images, l’échelle du sujet, la quantification et le décodage influent tous sur la qualité finale.
H3 peut-il conserver la cohérence d’un personnage sans LoRA ?
Oui, les flux basés sur des références peuvent préserver l’identité d’un personnage sans entraîner immédiatement une LoRA. H3 prend officiellement en charge jusqu’à neuf images de référence, permettant à chacune d’apporter l’identité, les vêtements, les produits ou la direction visuelle. LoRA reste utile lorsqu’une très forte répétabilité est requise sur un grand ensemble de ressources.
H3 est-il meilleur que Flux ou GPT Image pour retoucher des images ?
Il n’existe pas de gagnant universel fiable. H3 est particulièrement intéressant pour la composition, les références, l’identité et le contrôle spatial, tandis que les modèles d’image natifs peuvent offrir de meilleures textures ou une meilleure finition dans certains flux. Pour une production exigeante, comparer H3 suivi d’un affinage sélectif est souvent plus utile que choisir un modèle unique pour toutes les tâches.
Conclusion
MiniMax H3 n’est pas simplement un modèle vidéo qui produit par hasard des images fixes utilisables. La génération d’images et la retouche I2I faisaient déjà partie de son entraînement multimodal, et les flux actuels montrent un réel potentiel pour la génération guidée par références, la cohérence des personnages, les retouches complexes, les storyboards, l’exploration graphique et la composition multiréférence. Ses principales limites restent la finition des images fixes, les visages éloignés, les textures fines et la typographie exacte ; les tests de génération en 4 MP montrent qu’une résolution supérieure améliore certains problèmes sans tous les résoudre. Pour les équipes de design, la meilleure stratégie actuelle consiste à confier à H3 la structure sémantique, les références et les modifications contrôlées, puis à transmettre uniquement les détails non résolus à un modèle d’image natif. L’évolution globale compte plus qu’un benchmark isolé : la génération d’images, la retouche, la compréhension des références et la génération vidéo deviennent de plus en plus des opérations liées au sein d’un même flux créatif multimodal.
Plus d’articles du blog Virse
Flux de travail

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 octobre 2026 by Yifan Zhao
Flux de travail

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 octobre 2026 by Yifan Zhao
Flux de travail

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 octobre 2026 by Yifan Zhao