
MiniMax H3 の画像生成と編集:動画モデルが画像モデルとしても使える理由
 Yifan Zhao読了 12 分 ·
MiniMax H3 は現在主に動画モデルとして知られていますが、T2I と I2I 編集がすでにマルチモーダル学習に含まれているため、静止画も生成・編集できます。MiniMax の H3 リリース文書には、T2I、T2V、汎用的な参照と編集、I2I の参照と編集、I2V の参照と編集が明記されています。そのため、H3 の画像生成は動画から偶然よいフレームを切り出すだけではありません。MiniMax H3 の使い方を理解すると、これらの機能が実際のワークフローでどう組み合わさるかが明確になります。
課題は、この基盤となる画像能力を制作に使える静止画へと仕上げることです。調査したH3 ワークフローとユーザーの質問では、構図、キャラクターの同一性、複数参照の制御、カメラの変更、複雑な編集で特に興味深い結果が見られました。一方で、遠景の顔、細かい質感、最終的なピクセル単位の仕上げは安定していませんでした。体系的なMiniMax H3 のプロンプトワークフローを使うと、これらの変数をより意図的に制御できます。真の可能性は単に画像を 1 枚作ることではなく、参照素材、修正、画像、動きを通じて創作意図を維持することにあります。
Virse は、このような複数モデルを使うワークフローを中心に設計されています。現在は 50 以上のモデルを 1 つのビジュアルキャンバスに集約し、モデルエコシステム内で Nano Banana 2、GPT Image 2、Seedance 2.0、MiniMax H3 などのツールを提供しています。デザイナーは別々のプロンプト画面間で参照素材や出力を移す代わりに、視覚的な文脈をまとめて保持し、方向性を比較し、同じAI デザインワークフロー内で画像モデルと動画モデルを切り替えられます。これを支えるのがマルチエージェントの創作ワークフローです。
MiniMax H3 は画像モデルか、動画モデルか?
H3 は、汎用的なマルチモーダル生成モデルであり、現在公開されている H3 チェックポイントは主に動画と音声の出力向けに設計されていると捉えるのが適切です。
モデルの能力と製品の出力の違いを理解すると、H3 の画像生成が一見矛盾して見える理由が分かります。
H3 は画像と動画の両方を生成するように学習済み
MiniMax は H3 を動画予測だけで学習させたわけではありません。公開された事前学習の範囲には、動画、音声、参照、クロスモーダルのタスクに加え、画像生成と I2I 編集も含まれています。
これは創作 AI の別のアーキテクチャを示唆しています。T2I、I2I、T2V、参照制御を完全に独立した問題として扱う代わりに、H3 はマルチモーダルな文脈と目的の出力の関係を学習します。
ただし、公開されている H3 のモデルカードでは、H3-Base-FL2VA と H3-Base-Ref2VA は現在、動画と音声を生成するものと説明されています。つまり、事前学習で得た能力は、公開済み H3 チェックポイントが提供する主な出力経路よりも広いということです。
レイヤー | H3 の対応内容 |
|---|---|
事前学習 | T2I、T2V、I2I 編集、マルチモーダル参照タスク |
公開 H3 チェックポイント | 主に動画と音声を出力 |
静止画ワークフロー | 単一フレームまたは最小限のフレームによる生成と編集 |
主な可能性 | H3 の画像能力をより使いやすい製品へ |
MiniMax H3 の単一画像生成はどう動くのか?
有用な H3 静止画ワークフローは、通常の動画を最終成果物とはしません。時間方向の生成処理を最小限に抑え、制御された静止画を効率よく生成または抽出できるようにします。
単一フレームの設定を目指すワークフローもあれば、最小限のフレーム群を生成し、最もよい静止画をデコードするものもあります。すべての H3 画像ワークフローがまったく同じ方法で動くと考えるより、この説明の方が技術的に正確です。
単一画像ワークフローの設計が重要な理由
実用的な H3 静止画パイプラインには通常、次の工程があります。
- テキスト、元画像、または複数の参照素材を用意する。
- 入力と望む結果の関係を定義する。
- 不要な時間方向の生成を最小限に抑える。
- 静止画として使えるよう結果をデコードする。
- 必要に応じ、未解決の質感や顔だけを改善する。
デザイナーにとって、H3 はコンセプトアート、キャラクターシート、絵コンテ、キャンペーン用カット、商品シーン、制御された画像編集に使える実用的なツールになります。こうした用途は、より広い制作工程の中でMiniMax H3 が最も適する場面を理解する手がかりにもなります。
H3 の Visual VAE が画質に関わる理由
公式文書では、H3-VisualVAE は16 倍の空間圧縮、4 倍の時間圧縮、24 の潜在チャネルを持つ、時間的に因果的な動画オートエンコーダーとされています。静止フレームを評価するうえで重要な背景です。
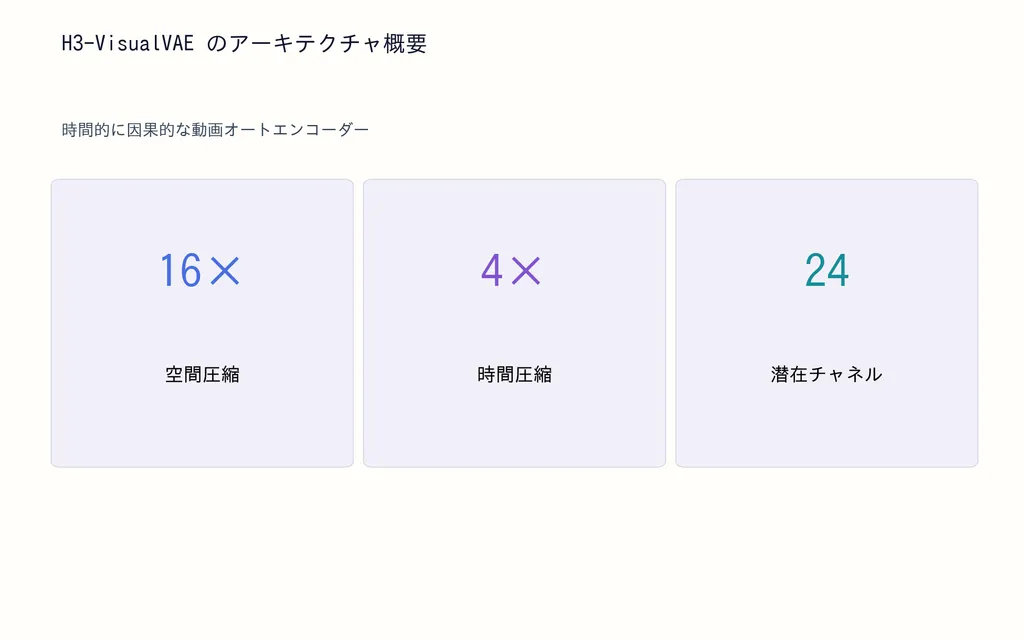
VAE だけですべての画質問題が起きるという意味ではありませんが、フレーム設定とデコード戦略が重要な理由を理解する助けになります。時間表現に最適化されたパイプラインが、あらゆる静止画の要件にも自動的に最適化されるわけではありません。特に髪、肌、布地、文字組み、小さな顔では注意が必要です。
MiniMax H3 の画像編集は実際のワークフローで何ができるのか?
H3 の画像編集が最も役立つのは、重要な属性を 1 つ変えながら、ほかの複数の属性を維持する必要があるときです。
調査では、服装や年齢の変更、体形調整、場所の置き換え、カメラの変更、ポーズ制御、スタイル化、深度情報に基づくポーズ編集、キャラクターシート、絵コンテのバリエーションを扱うワークフローを取り上げました。
事例:全体を保ちながら一部を変更
デザイナーが服装だけを変えたいファッションビジュアルを考えてみましょう。
編集を成功させるには、次を維持する必要があります。
- 人物の同一性。
- 表情。
- 体の位置。
- カメラアングル。
- 照明。
- 環境。
- 変更対象以外の物体。
これは見た目の似た代替画像を生成するより難しい作業です。モデルは、何を編集でき、何がすでに承認されているかを理解する必要があります。
一部を変更しつつ全体を保つこのパターンは、専門的なデザイン業務で H3 の画像編集を捉えるうえで特に有用です。
事例:1920 × 1088 の編集を約 8 秒で完了
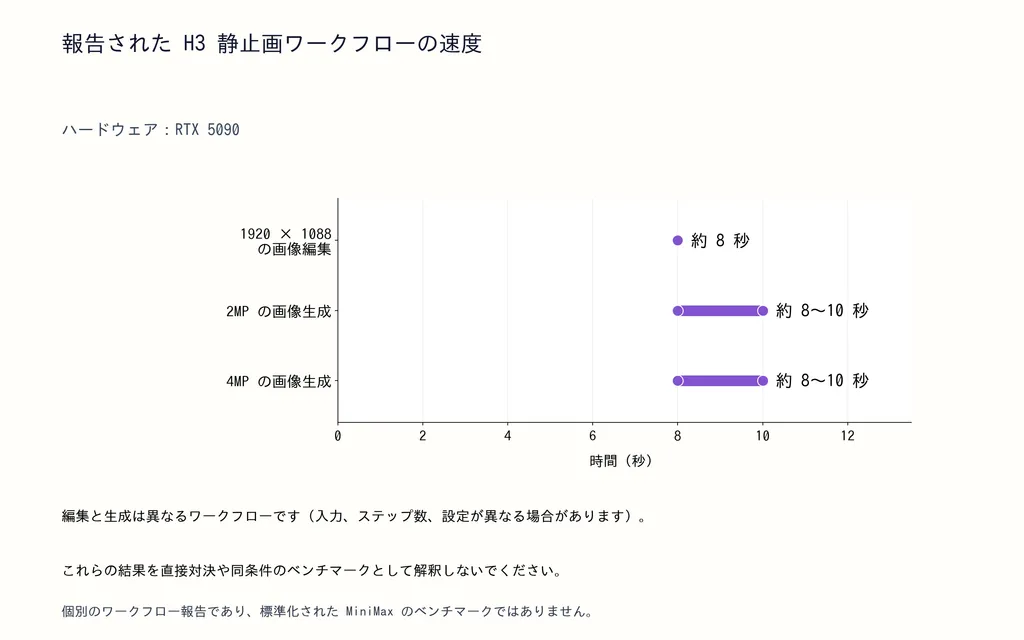
調査に含めたある RTX 5090 のワークフローでは、1920 × 1088 の単一画像編集の多くが約 8 秒で完了すると報告されていました。服装、年齢、体形、場所、カメラ、キャラクターシートのタスクが含まれます。
これは MiniMax の公式ベンチマークではありません。ハードウェア、精度、VAE、ワークフローの設定、タスクの複雑さはすべてレイテンシーに影響します。
この事例から分かるのは、H3 の画像編集が、反復的なビジュアル探索に十分な速さで動作し得るということです。デザイナーは最終レンダリングを 1 回待つよりも、制御された多数のバリエーションを比較する必要があるかもしれません。
H3 の複数参照編集とキャラクターの一貫性はどうか?
複数参照の制御は、画像やデザインのワークフローにおける H3 の特に重要な強みの 1 つです。
MiniMax の公式 Ref2VA 仕様は、最大 9 枚の画像参照に加え、最大 3 本の動画クリップと 3 件の音声クリップに対応しています。混合マルチモーダル参照入力の合計上限は 12 ファイルです。
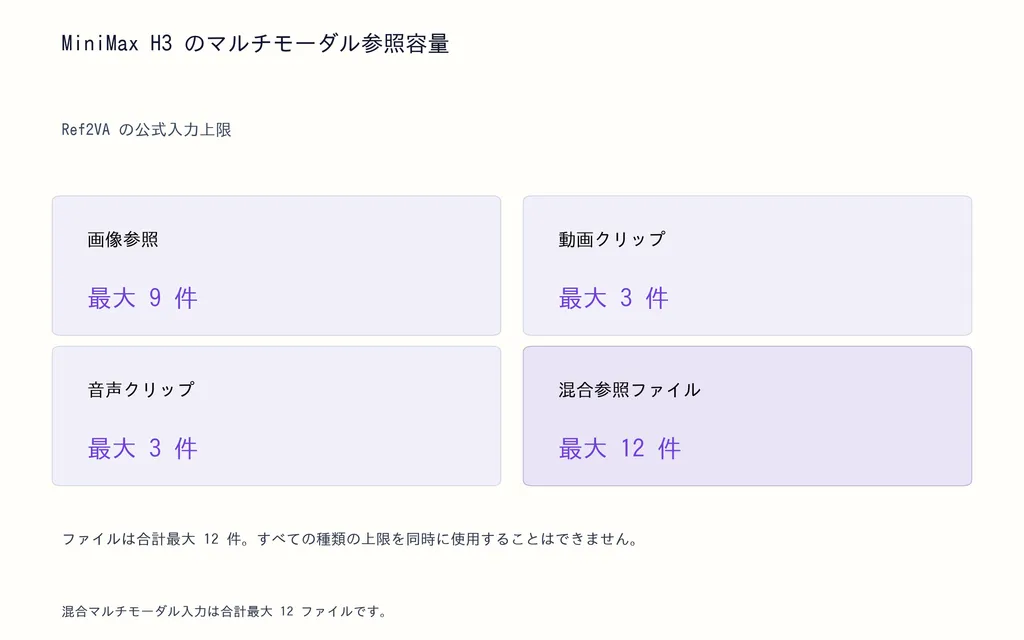
1 つの参照で人物の同一性を、別の参照でスタイルを制御
重要なのは画像を 9 枚アップロードすること自体ではなく、各参照に異なる創作上の役割を与えることです。
参照素材 | 創作上の役割 |
|---|---|
画像 1 | キャラクターの同一性 |
画像 2 | 服装 |
画像 3 | 商品 |
画像 4 | 照明 |
画像 5 | スタイルの方向性 |
プロンプトやコンテキスト層で、それらの素材をどう組み合わせるかを説明できます。明確なAI デザインのプロンプト構成は、複数の参照にそれぞれ異なる役割を持たせる場合に特に役立ちます。
キャラクターのワークフローでは、すぐに LoRA を学習させる以外の選択肢になります。絵コンテ、キャンペーン案の探索、キャラクターシート、小規模な制作では、参照による条件付けの方が速い場合があります。一方、はるかに大きなシリーズ全体で人物の同一性を高い再現性で保つ必要があるチームには、LoRA が引き続き役立ちます。
H3 の画像生成が最も得意なことは?
調査からは、H3 の画像能力の強みは、純粋なピクセル品質よりも意味の理解にあると考えられます。
人物の同一性、カメラ、空間関係、参照素材、照明、構図、明確な創作方針など、複数の制約を同時に満たす必要があるときに、特に興味深いモデルです。
構図、アートディレクション、空間理解
調査した比較ワークフローでは、H3 は次の点で目立つことが多くありました。
- 複雑な構図。
- 参照への忠実性。
- キャラクターの配置。
- カメラの解釈。
- 空間関係。
- アートディレクションへの準拠。
個別の比較では、GPT Image のワークフローより H3 の構図が好まれる場合がありました。一方、最終的な出力品質では Flux ベースの編集が好まれたテストもあります。
これらは標準化されたベンチマークではありません。実務上は、ピクセルを磨くことより依頼内容を理解する方が難しいときに H3 を試すという学びの方が役立ちます。
H3 は文字組みやグラフィックデザインにどう対応するか?
H3 の静止画ワークフローは、ポスター、雑誌風レイアウト、ダッシュボード、インフォグラフィックなどの構造化されたグラフィックでも試されています。
その価値は映画的なカットにとどまりません。優れた構図と文脈理解は、情報の階層、配置、ビジュアルの方向性を組み立てる助けになります。
文字組みは別の問題です。調査では文字の歪みも繰り返し見られ、特に小さい文字や正確な文言が必要な場合に問題になりました。そのため H3 は、最終的な文字組みを自動で承認する用途より、レイアウトの探索やビジュアルの方向性を検討する用途に向いています。制作用の文字は、編集可能なデザイン環境で確認または作り直すべきです。
H3 の画像がぼやけたり、遠景の顔が崩れたりする理由は?
調査で繰り返し見られた H3 静止画の制約は、ぼやけ、にじんだ質感、プラスチックのような肌、遠景の顔の弱さ、小さな顔の変形、背景の甘さ、文字の不安定さでした。
これらの問題は、制作における重要な区別を示しています。
構図が意味の上で正しくても、納品できる状態とは限りません。
事例:H3 の 2MP と 4MP 画像生成を比較
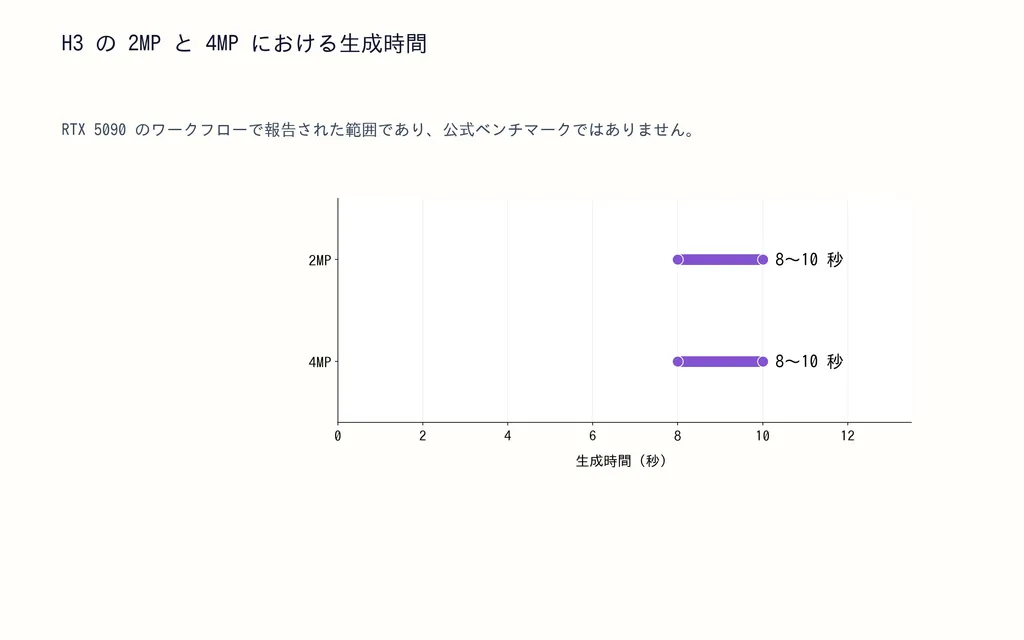
調査した長期運用の RTX 5090 ワークフローでは、H3 静止画を数千枚生成しており、その設定では2MP と 4MP の生成に約 8~10 秒かかると報告されていました。
解像度を 4MP に近づけると顔の変形の一部は軽減されましたが、遠景の顔や背景の甘さは完全には解消されませんでした。
この結果は、単にピクセル数を増やすだけでは不十分な理由を示す点で有用です。解像度は役立ちますが、VAE の挙動、被写体の大きさ、デコード、量子化、モデルによる細部構造の扱いも重要です。
H3-Regenerate-2K が通常のアップスケーリングにとどまらない理由
MiniMax は高解像度の動画出力に、より興味深い方法を採用しています。H3-Regenerate-2K は低解像度の結果を、元のマルチモーダルな文脈とともに H3 へ再入力します。
別の超解像システムにピクセルだけから不足情報を推測させる代わりに、再生成では細部を復元する際にプロンプトと参照素材を再利用できます。
MiniMax は特に、小さな文字と細部を例に挙げています。文脈に基づく再生成では、通常の超解像なら推測するしかない情報を復元できる場合があります。
今後の H3 画像ワークフローでは、単純なアップスケーリングより、この考え方の方が重要になるかもしれません。
制作向けの最適な H3 画像ワークフローは?
現在の専門的なデザイン業務では、まず H3 を意味と参照を扱うエンジンとして使い、その後に画像専用モデルを選択的に使って最終的な仕上げを行うことを勧めます。
段階 1:H3 で創作の構造を組み立てる
H3 は次の要素を整えるのに適しています。
- 人物の同一性。
- 構図。
- ポーズ。
- カメラ。
- 参照素材間の関係。
- シーンの構造。
- 複雑な変更。
- 絵コンテの連続性。
段階 2:弱いピクセル部分だけを改善する
調査したワークフローでは、H3 の出力を Flux.2 Klein 9B、Qwen Image Edit、SeedVR などのツールと組み合わせ、顔、布地、髪、細かい質感を改善していました。
危険なのは過剰な修正です。別のモデルが質感を直す一方で、表情、照明、ポーズ、人物の同一性を意図せず変えてしまうことがあります。
そのため、制作で目指すべきなのは、意味を保ちながら細部を選択的に復元することであり、制限なく再生成することではありません。
複数モデルを使えるワークスペースが、1 つのモデルへのこだわりより役立つ場合があるのもこのためです。Virse は現在、多くのモデルと視覚素材を同じキャンバス上に保持する方向を重視しています。チームは周囲の創作上の文脈を失わずに、構図、編集、仕上げ、動きをそれぞれ別のモデルに任せられます。
よくある質問
H3 は画像モデルか、動画モデルか?
H3 は汎用的なマルチモーダル生成モデルですが、現在公開されている H3 チェックポイントは主に動画と音声を出力します。MiniMax が事前学習に T2I と I2I の参照・編集を含めたため、画像生成も基盤となる能力の一部です。
H3 は通常の動画を作らずに 1 枚の画像を生成できるか?
はい。静止画ワークフローでは、単一フレームや最小限のフレームを使って時間方向の生成を抑え、結果を画像用にデコードできます。具体的な手順は異なるため、H3 の画像生成を、すべてに共通する公式の単一画像パイプラインとして説明すべきではありません。
H3 の画像がぼやける理由は?4MP で解決するか?
解像度を上げることで顔の変形の一部は軽減できますが、調査した 4MP の事例でも、遠景の顔や背景の甘さは完全には解消されませんでした。解像度、VAE の挙動、フレーム設定、被写体の大きさ、量子化、デコードはすべて最終品質に影響します。
H3 は LoRA なしでキャラクターの一貫性を保てるか?
はい。参照ベースのワークフローなら、すぐに LoRA を学習させなくてもキャラクターの同一性を保てます。H3 は公式に最大 9 枚の画像参照に対応し、別々の参照から人物の同一性、服装、商品、視覚的な方向性を与えられます。大量の素材全体で極めて高い再現性が必要な場合は、LoRA も引き続き有用です。
画像編集では H3 は Flux や GPT Image より優れているか?
信頼できる万能の勝者はいません。H3 は構図、参照、人物の同一性、空間制御で特に興味深いモデルです。一方、画像専用モデルの方が、ワークフローによっては質感や最終的な仕上げに優れる場合があります。厳しい制作要件では、すべてのタスクに 1 つのモデルを選ぶより、H3 の後に必要な部分だけ画像を改善する方法を比較する方が役立つことが多いでしょう。
結論
MiniMax H3 は、偶然使える静止フレームを出力する動画モデルというだけではありません。画像生成と I2I 編集はすでにマルチモーダル学習に含まれており、現在のワークフローは、参照に基づく画像生成、キャラクターの一貫性、複雑な編集、絵コンテ、グラフィックの探索、複数参照を使う構図に実用的な可能性を示しています。主な制約は依然として静止画の仕上げ、遠景の顔、細かい質感、正確な文字組みです。4MP 生成のテストでは、高解像度化で改善する問題もある一方、すべては解決できないことが分かります。デザインチームにとって現在の有力な戦略は、意味の構造、参照、制御された変更を H3 に任せ、未解決の細部だけを画像専用モデルに回すことです。個別のベンチマーク以上に重要なのは、より大きな変化です。画像生成、画像編集、参照理解、動画生成は、同じマルチモーダル創作ワークフローの中で、ますます相互につながる処理になっています。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao