
Pembuatan dan Pengeditan Gambar MiniMax H3: Mengapa Model Video Juga Dapat Berfungsi sebagai Model Gambar
 Yifan Zhao11 menit baca ·
MiniMax H3 dapat membuat dan mengedit gambar diam karena T2I dan pengeditan I2I sudah menjadi bagian dari pelatihan multimodalnya, meskipun saat ini H3 terutama dikenal sebagai model video. Dokumentasi peluncuran H3 dari MiniMax secara eksplisit mencakup T2I, T2V, referensi dan pengeditan umum, referensi dan pengeditan I2I, serta referensi dan pengeditan I2V. Karena itu, pembuatan gambar H3 bukan sekadar mengambil bingkai bagus secara kebetulan dari sebuah video. Memahami cara menggunakan MiniMax H3 membantu memperjelas bagaimana kemampuan ini diterapkan dalam alur kerja nyata.
Tantangannya adalah mengubah kemampuan gambar dasar itu menjadi gambar diam yang siap produksi. Dalam alur kerja H3 dan pertanyaan pengguna yang kami tinjau, model ini sangat menarik untuk komposisi, identitas karakter, kontrol multireferensi, perubahan kamera, dan pengeditan kompleks, sementara wajah di kejauhan, tekstur halus, dan penyempurnaan akhir tingkat piksel masih kurang andal. Alur kerja prompt MiniMax H3 yang terstruktur dapat membantu mengendalikan variabel tersebut secara lebih terarah. Peluang sesungguhnya bukan sekadar membuat satu gambar, melainkan mempertahankan maksud kreatif di seluruh referensi, revisi, gambar, dan gerakan.
Virse dibangun dengan berpusat pada alur kerja multimodel tersebut. Pengalaman produknya saat ini menyatukan lebih dari 50 model dalam satu kanvas visual, dengan alat seperti Nano Banana 2, GPT Image 2, Seedance 2.0, dan MiniMax H3 tersedia di ekosistem modelnya. Alih-alih memindahkan referensi dan hasil antarjendela prompt yang terpisah, desainer dapat menjaga konteks visual tetap bersama, membandingkan arah, dan beralih antara model gambar dan video dalam alur kerja desain AI yang sama, didukung oleh alur kerja kreatif multiagen.
Apakah MiniMax H3 Model Gambar atau Model Video?
H3 paling tepat dipahami sebagai model generasi multimodal serbaguna yang checkpoint H3-nya saat ini terutama dirancang untuk menghasilkan video dan audio.
Perbedaan antara kemampuan model dan keluaran produk ini menjelaskan mengapa pembuatan gambar H3 pada awalnya tampak bertentangan.
H3 Dilatih untuk Pembuatan Gambar dan Video
MiniMax tidak melatih H3 hanya untuk prediksi video. Cakupan prapelatihan yang dipublikasikan mencakup pembuatan gambar dan pengeditan I2I, selain tugas video, audio, referensi, dan lintas modalitas.
Ini menunjukkan arsitektur berbeda untuk AI kreatif: alih-alih memperlakukan T2I, I2I, T2V, dan kontrol referensi sebagai masalah yang sepenuhnya terpisah, H3 mempelajari hubungan antara konteks multimodal dan keluaran yang dituju.
Namun, kartu model H3 publik saat ini mendeskripsikan H3-Base-FL2VA dan H3-Base-Ref2VA sebagai penghasil video dan audio. Artinya, kemampuan hasil prapelatihan lebih luas daripada jalur keluaran utama yang disediakan checkpoint H3 yang dirilis.
Lapisan | Yang Didukung H3 |
|---|---|
Prapelatihan | T2I, T2V, pengeditan I2I, dan tugas referensi multimodal |
Checkpoint H3 Publik | Terutama keluaran video dan audio |
Alur Kerja Gambar Diam | Pembuatan dan pengeditan satu bingkai atau jumlah bingkai minimal |
Peluang Utama | Menghadirkan kemampuan gambar H3 dalam produk yang lebih baik |
Bagaimana Cara Kerja Pembuatan Gambar Tunggal MiniMax H3?
Alur kerja gambar diam H3 yang berguna tidak menjadikan video biasa sebagai produk akhir yang diinginkan. Alur ini meminimalkan proses generasi temporal agar dapat menghasilkan atau mengekstrak gambar diam yang terkendali secara efisien.
Sebagian alur kerja menargetkan pengaturan satu bingkai, sementara yang lain menghasilkan paket bingkai minimal lalu mendekode gambar diam terbaik. Ini lebih akurat secara teknis daripada menganggap semua alur kerja gambar H3 bekerja persis sama.
Mengapa Desain Alur Kerja Gambar Tunggal Penting
Alur gambar diam H3 yang praktis biasanya meliputi:
- Menyediakan teks, gambar sumber, atau beberapa referensi.
- Menentukan hubungan masukan tersebut dengan hasil yang diinginkan.
- Meminimalkan generasi temporal yang tidak diperlukan.
- Mendekode hasil untuk digunakan sebagai gambar diam.
- Menyempurnakan hanya tekstur atau wajah yang masih bermasalah jika diperlukan.
Bagi desainer, ini menjadikan H3 alat praktis untuk seni konsep, lembar karakter, storyboard, gambar kampanye, adegan produk, dan pengeditan gambar terkendali. Kegunaan ini juga menjelaskan di mana MiniMax H3 paling sesuai dalam proses kreatif yang lebih luas.
Mengapa VAE Visual H3 Penting bagi Kualitas Gambar
H3-VisualVAE secara resmi didokumentasikan sebagai autoencoder video kausal temporal dengan kompresi spasial 16×, kompresi temporal 4×, dan 24 kanal laten. Ini merupakan konteks penting saat mengevaluasi bingkai statis.
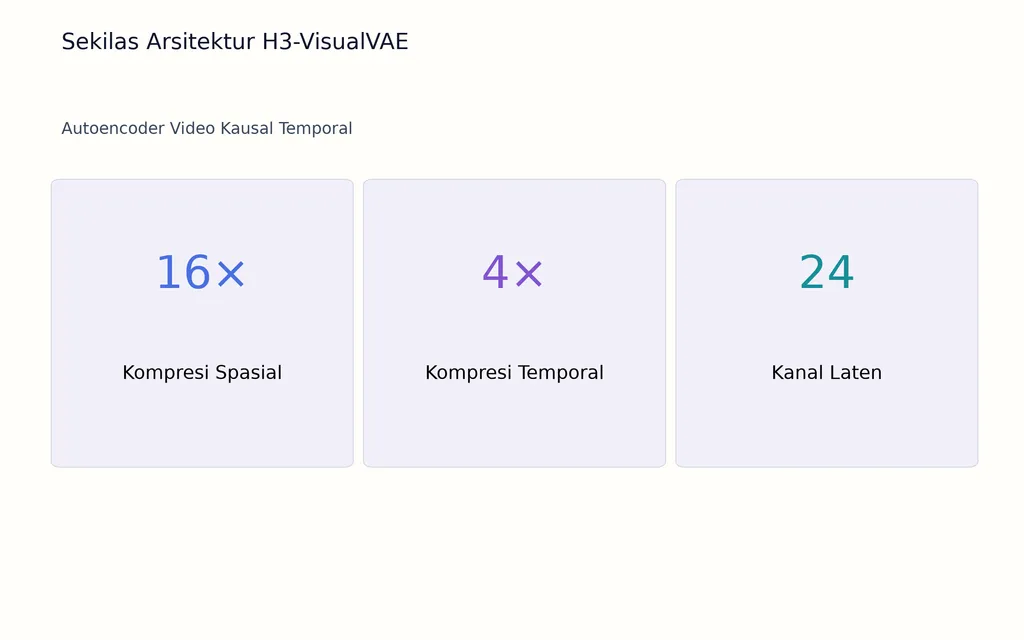
Ini tidak berarti VAE sendirian menyebabkan semua masalah kualitas, tetapi membantu menjelaskan pentingnya konfigurasi bingkai dan strategi dekode. Proses yang dioptimalkan untuk representasi temporal tidak otomatis optimal untuk semua kebutuhan gambar diam, terutama rambut, kulit, kain, tipografi, dan wajah kecil.
Apa yang Dapat Dilakukan Pengeditan Gambar MiniMax H3 dalam Alur Kerja Nyata?
Pengeditan gambar H3 paling berguna saat tugas memerlukan perubahan satu sifat penting sambil mempertahankan beberapa sifat lainnya.
Riset kami mencakup alur kerja perubahan pakaian, usia, penyesuaian tubuh, penggantian lokasi, perubahan kamera, kontrol pose, stilisasi, pengeditan pose dengan panduan kedalaman, lembar karakter, dan variasi storyboard.
Studi Kasus: Perubahan Lokal dengan Pelestarian Global
Bayangkan visual fesyen ketika desainer hanya ingin mengganti pakaian.
Pengeditan yang berhasil harus mempertahankan:
- identitas;
- ekspresi wajah;
- posisi tubuh;
- sudut kamera;
- pencahayaan;
- lingkungan;
- objek yang tidak terkait.
Ini lebih sulit daripada membuat gambar pengganti yang tampak serupa. Model harus memahami apa yang boleh diedit dan apa yang sudah disetujui.
Pola perubahan lokal dengan pelestarian global ini merupakan salah satu cara paling berguna untuk memahami pengeditan gambar H3 dalam pekerjaan desain profesional.
Studi Kasus: Pengeditan 1920 × 1088 dalam Sekitar Delapan Detik
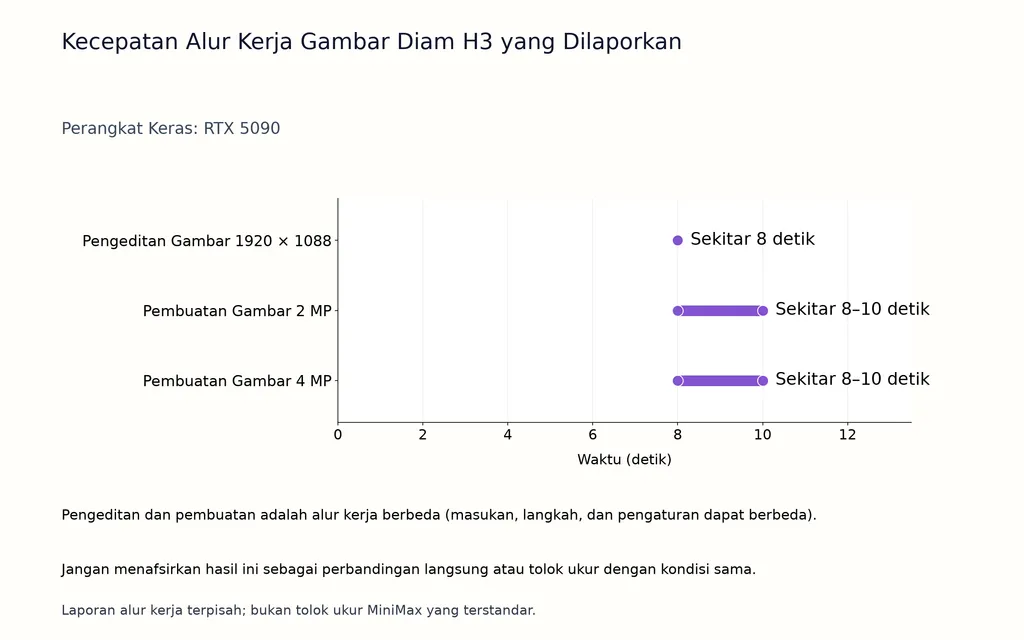
Salah satu alur kerja RTX 5090 dalam riset kami melaporkan sekitar delapan detik untuk banyak pengeditan gambar tunggal 1920 × 1088, termasuk tugas pakaian, usia, tubuh, lokasi, kamera, dan lembar karakter.
Ini bukan tolok ukur resmi MiniMax. Perangkat keras, presisi, VAE, konfigurasi alur kerja, dan kompleksitas tugas semuanya memengaruhi latensi.
Yang ditunjukkan kasus ini adalah bahwa pengeditan gambar H3 bisa cukup cepat untuk eksplorasi visual berulang, ketika desainer perlu membandingkan banyak variasi terkendali alih-alih menunggu satu render akhir.
Seberapa Baik Pengeditan Multireferensi dan Konsistensi Karakter H3?
Kontrol multireferensi adalah salah satu keunggulan terpenting H3 untuk alur kerja gambar dan desain.
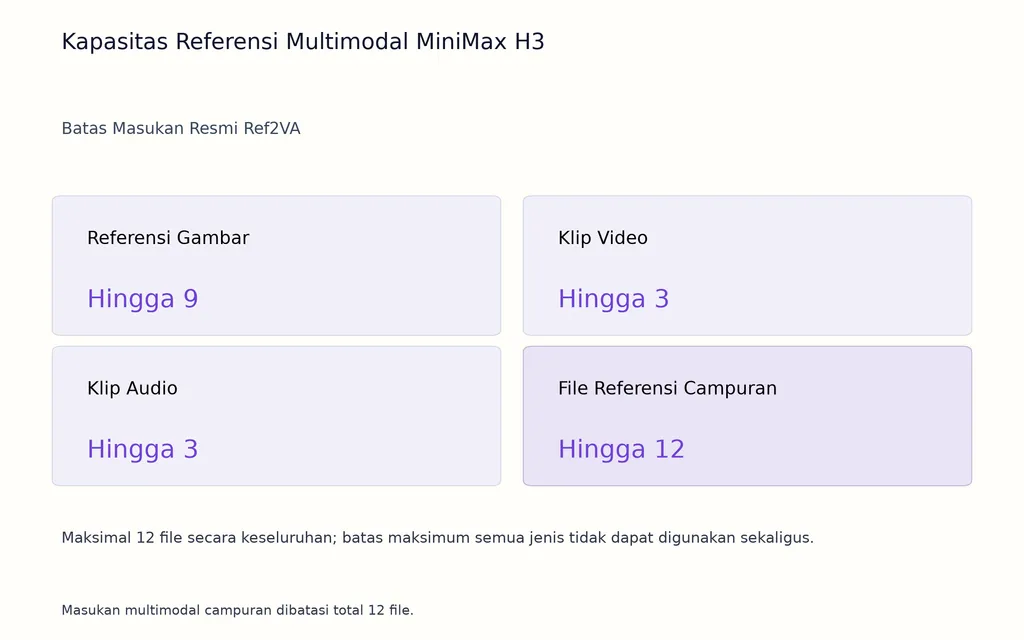
Spesifikasi resmi Ref2VA dari MiniMax mendukung hingga sembilan referensi gambar, bersama hingga tiga klip video dan tiga klip audio. Masukan referensi multimodal campuran dibatasi total 12 file.
Satu Referensi Dapat Mengontrol Identitas, yang Lain Mengontrol Gaya
Fitur pentingnya bukan sekadar mengunggah sembilan gambar, melainkan memberikan peran kreatif berbeda kepada tiap referensi.
Referensi | Peran Kreatif |
|---|---|
Gambar 1 | Identitas karakter |
Gambar 2 | Pakaian |
Gambar 3 | Produk |
Gambar 4 | Pencahayaan |
Gambar 5 | Arah gaya |
Prompt atau lapisan konteks kemudian dapat menjelaskan bagaimana aset ini harus berinteraksi. Struktur prompt desain AI yang jelas sangat berguna ketika beberapa referensi memerlukan tanggung jawab berbeda.
Untuk alur kerja karakter, ini menawarkan alternatif selain langsung melatih LoRA. Pengondisian berbasis referensi dapat lebih cepat untuk storyboard, eksplorasi kampanye, lembar karakter, dan produksi skala kecil, sementara LoRA tetap berguna ketika tim membutuhkan identitas yang sangat konsisten dan dapat diulang pada seri yang jauh lebih besar.
Di Mana Pembuatan Gambar H3 Paling Unggul?
Tinjauan kami menunjukkan bahwa kemampuan gambar terkuat H3 bersifat semantik, bukan semata-mata pada tingkat piksel.
Model ini sangat menarik ketika beberapa batasan harus bekerja bersama: identitas, kamera, hubungan spasial, referensi, pencahayaan, komposisi, dan arah kreatif yang jelas.
Komposisi, Arahan Artistik, dan Pemahaman Spasial
Dalam alur kerja perbandingan yang kami tinjau, H3 kerap menonjol dalam:
- komposisi kompleks;
- kesetiaan pada referensi;
- penempatan karakter;
- interpretasi kamera;
- hubungan spasial;
- kepatuhan pada arahan artistik.
Perbandingan individual terkadang lebih menyukai komposisi H3 daripada alur kerja GPT Image, sementara pengujian lain lebih menyukai pengeditan berbasis Flux untuk kualitas hasil akhir.
Ini bukan tolok ukur terstandar. Pelajaran praktisnya lebih berguna: uji H3 ketika memahami brief lebih sulit daripada memoles piksel.
Bagaimana H3 Menangani Tipografi dan Desain Grafis?
Alur kerja gambar diam H3 juga telah dieksplorasi untuk poster, tata letak bergaya majalah, dasbor, infografis, dan grafis terstruktur lainnya.
Ini memperluas nilainya melampaui bingkai sinematik. Komposisi dan pemahaman konteks yang kuat dapat membantu membangun hierarki, penempatan, dan arah visual.
Tipografi adalah persoalan berbeda. Tinjauan kami juga menemukan distorsi teks sebagai kegagalan berulang, terutama ketika hasil bergantung pada teks kecil atau kata-kata yang harus tepat. Karena itu, H3 lebih meyakinkan untuk eksplorasi tata letak dan arah visual daripada menyetujui tipografi akhir secara otomatis. Teks produksi tetap perlu diperiksa atau dibuat ulang dalam lingkungan desain yang dapat diedit.
Mengapa Gambar H3 Buram atau Lemah pada Wajah di Kejauhan?
Keterbatasan gambar diam H3 yang berulang dalam riset kami adalah keburaman, tekstur tercoreng, kulit seperti plastik, wajah jauh yang kurang baik, wajah kecil cacat, latar belakang kurang tajam, dan teks tidak konsisten.
Masalah ini mengungkap perbedaan penting dalam produksi:
Komposisi bisa benar secara semantik tanpa siap diserahkan.
Studi Kasus: Pembuatan Gambar H3 2 MP vs 4 MP
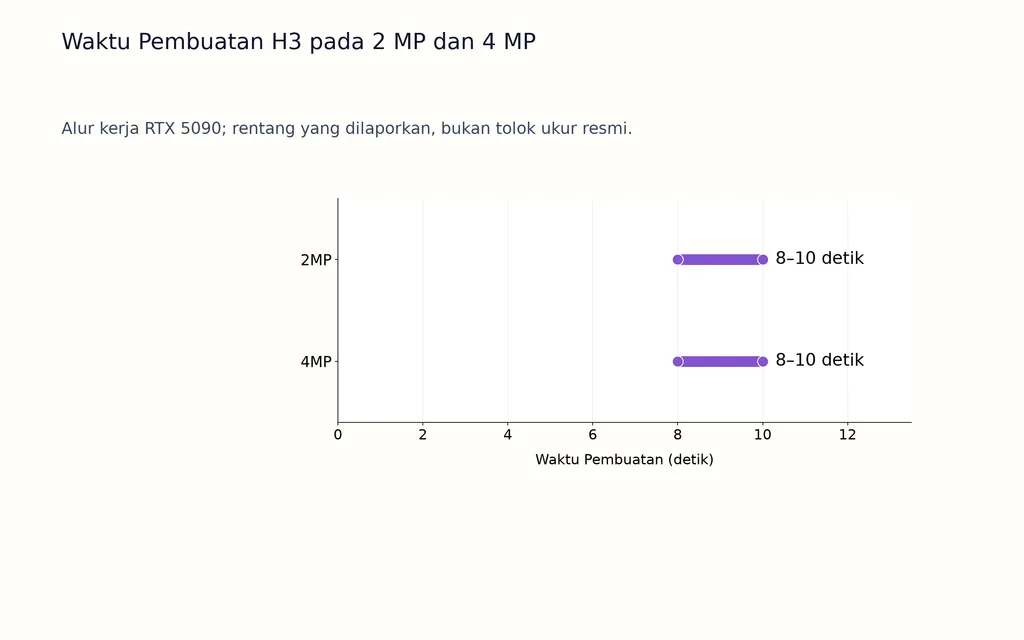
Alur kerja RTX 5090 yang telah lama dijalankan dalam riset kami sudah menghasilkan ribuan gambar diam H3 dan melaporkan sekitar 8–10 detik untuk pembuatan 2 MP dan 4 MP pada konfigurasinya.
Meningkatkan resolusi menuju 4 MP mengurangi sebagian deformasi wajah, tetapi masalah wajah jauh dan latar belakang kurang tajam belum sepenuhnya teratasi.
Hasil ini berharga karena menunjukkan mengapa sekadar meminta lebih banyak piksel tidak cukup. Resolusi membantu, tetapi perilaku VAE, skala subjek, dekode, kuantisasi, dan cara model menangani struktur halus juga penting.
Mengapa H3-Regenerate-2K Lebih dari Peningkatan Resolusi Biasa
MiniMax menggunakan pendekatan yang lebih menarik untuk keluaran video resolusi tinggi. H3-Regenerate-2K memasukkan hasil resolusi lebih rendah kembali ke H3 bersama konteks multimodal aslinya.
Alih-alih meminta sistem superresolusi terpisah menebak informasi yang hilang hanya dari piksel, regenerasi dapat menggunakan kembali prompt dan referensi saat merekonstruksi detail halus.
MiniMax secara khusus menyebut teks kecil dan detail halus sebagai contoh ketika regenerasi kontekstual dapat memulihkan informasi yang harus disimpulkan oleh superresolusi konvensional.
Bagi alur kerja gambar H3 di masa depan, gagasan ini mungkin lebih penting daripada sekadar peningkatan resolusi.
Apa Alur Kerja Gambar H3 Terbaik untuk Produksi?
Untuk pekerjaan desain profesional saat ini, saya akan memperlakukan H3 sebagai mesin semantik dan referensi terlebih dahulu, lalu memakai model khusus gambar secara selektif untuk penyempurnaan akhir.
Tahap 1: Gunakan H3 untuk Struktur Kreatif
H3 sangat sesuai untuk menangani:
- identitas;
- komposisi;
- pose;
- kamera;
- hubungan antar-referensi;
- struktur adegan;
- perubahan kompleks;
- kesinambungan storyboard.
Tahap 2: Sempurnakan Hanya Piksel yang Lemah
Alur kerja dalam riset kami menggabungkan hasil H3 dengan alat seperti Flux.2 Klein 9B, Qwen Image Edit, dan SeedVR untuk memperbaiki wajah, kain, rambut, dan tekstur halus.
Bahayanya adalah penyempurnaan berlebihan. Model kedua dapat memperbaiki tekstur sambil tanpa sengaja mengubah ekspresi, pencahayaan, pose, atau identitas.
Karena itu, sasaran produksi yang lebih baik adalah pemulihan detail secara selektif sambil mempertahankan semantik, bukan regenerasi tanpa batas.
Inilah alasan ruang kerja multimodel bisa lebih berguna daripada setia pada satu model. Arah produk Virse saat ini berfokus pada penyatuan banyak model dan aset visual di kanvas yang sama, sehingga tim dapat mengarahkan komposisi, pengeditan, penyempurnaan, dan gerakan ke model berbeda tanpa kehilangan konteks kreatif di sekitarnya.
Pertanyaan Umum
Apakah H3 model gambar atau model video?
H3 adalah model generasi multimodal serbaguna, tetapi checkpoint H3 yang saat ini dirilis terutama menghasilkan video dan audio. Pembuatan gambar tetap menjadi bagian dari kemampuan dasarnya karena MiniMax memasukkan T2I serta referensi dan pengeditan I2I selama prapelatihan.
Bisakah H3 membuat satu gambar tanpa membuat video biasa?
Ya. Alur kerja gambar diam dapat meminimalkan generasi temporal melalui pendekatan satu bingkai atau bingkai minimal, lalu mendekode hasilnya untuk penggunaan gambar. Alur kerja pastinya berbeda-beda, sehingga pembuatan gambar H3 tidak boleh digambarkan sebagai satu alur gambar tunggal resmi yang universal.
Mengapa gambar H3 buram, dan apakah 4 MP mengatasinya?
Resolusi lebih tinggi dapat mengurangi sebagian deformasi wajah, tetapi kasus 4 MP yang kami tinjau belum sepenuhnya menghilangkan masalah wajah jauh atau latar belakang kurang tajam. Resolusi, perilaku VAE, konfigurasi bingkai, skala subjek, kuantisasi, dan dekode semuanya memengaruhi kualitas akhir.
Bisakah H3 menjaga konsistensi karakter tanpa LoRA?
Ya, alur kerja berbasis referensi dapat mempertahankan identitas karakter tanpa langsung melatih LoRA. H3 secara resmi mendukung hingga sembilan referensi gambar, sehingga referensi berbeda dapat menyumbangkan identitas, pakaian, produk, atau arah visual. LoRA tetap berguna ketika dibutuhkan keterulangan yang sangat tinggi pada kumpulan aset besar.
Apakah H3 lebih baik daripada Flux atau GPT Image untuk pengeditan gambar?
Tidak ada pemenang universal yang dapat diandalkan. H3 sangat menarik untuk komposisi, referensi, identitas, dan kontrol spasial, sementara model khusus gambar mungkin menghasilkan tekstur atau penyempurnaan akhir yang lebih baik dalam sebagian alur kerja. Untuk produksi yang menuntut, H3 yang diikuti penyempurnaan gambar selektif sering menjadi perbandingan yang lebih berguna daripada memilih satu model untuk semua tugas.
Kesimpulan
MiniMax H3 bukan sekadar model video yang kebetulan menghasilkan bingkai diam yang bisa digunakan. Pembuatan gambar dan pengeditan I2I sudah menjadi bagian dari pelatihan multimodalnya, dan alur kerja saat ini menunjukkan potensi nyata untuk pembuatan gambar berbasis referensi, konsistensi karakter, pengeditan kompleks, storyboard, eksplorasi grafis, dan komposisi multireferensi. Keterbatasan utamanya tetap pada penyempurnaan gambar diam, wajah jauh, tekstur halus, dan tipografi yang tepat, sementara pengujian pembuatan 4 MP menunjukkan bahwa resolusi lebih tinggi memperbaiki sebagian masalah tanpa menyelesaikan semuanya. Bagi tim desain, strategi terkuat saat ini adalah membiarkan H3 menangani struktur semantik, referensi, dan perubahan terkendali, lalu hanya mengarahkan detail yang belum beres ke model khusus gambar. Pergeseran yang lebih besar lebih penting daripada satu tolok ukur: pembuatan gambar, pengeditan gambar, pemahaman referensi, dan pembuatan video semakin menjadi operasi yang saling terhubung dalam alur kerja kreatif multimodal yang sama.
Artikel lainnya dari Blog Virse
Alur kerja

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 Oktober 2026 by Yifan Zhao
Alur kerja

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 Oktober 2026 by Yifan Zhao
Alur kerja

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 Oktober 2026 by Yifan Zhao