
Geração e edição de imagens com MiniMax H3: por que um modelo de vídeo também pode funcionar como modelo de imagem
 Yifan Zhao13 min de leitura ·
MiniMax H3 pode gerar e editar imagens estáticas porque T2I e edição I2I já faziam parte de seu treinamento multimodal, embora atualmente o H3 seja conhecido principalmente como modelo de vídeo. A documentação de lançamento do H3 da MiniMax inclui explicitamente T2I, T2V, referência e edição generalizadas, referência e edição I2I e referência e edição I2V. Portanto, gerar imagens com o H3 vai além de extrair, por sorte, um bom quadro de um vídeo, e entender como usar o MiniMax H3 ajuda a esclarecer como essas capacidades se encaixam em fluxos reais.
O desafio é transformar essa capacidade subjacente em uma imagem estática pronta para produção. Nos fluxos do H3 e nas perguntas de usuários que analisamos, o modelo foi particularmente interessante para composição, identidade de personagens, controle de várias referências, mudanças de câmera e edições complexas, enquanto rostos distantes, texturas finas e acabamento final em nível de pixel permaneceram menos confiáveis. Um fluxo estruturado de prompts do MiniMax H3 pode ajudar a controlar essas variáveis de forma mais deliberada. A verdadeira oportunidade não é apenas criar uma imagem, mas preservar a intenção criativa entre referências, revisões, imagens e movimento.
Virse foi desenvolvido em torno desse fluxo multimodelo. A experiência atual do produto reúne mais de 50 modelos em uma única tela visual, com ferramentas como Nano Banana 2, GPT Image 2, Seedance 2.0 e MiniMax H3 disponíveis em seu ecossistema. Em vez de mover referências e resultados entre janelas de prompts desconectadas, designers podem manter o contexto visual reunido, comparar direções e alternar entre modelos de imagem e vídeo no mesmo fluxo de design com IA, apoiado por fluxos criativos multiagente.
O MiniMax H3 é um modelo de imagem ou de vídeo?
O H3 é melhor entendido como um modelo de geração multimodal de uso geral cujos checkpoints H3 atualmente lançados foram projetados principalmente para produzir vídeo e áudio.
Essa distinção entre a capacidade do modelo e a saída do produto explica por que a geração de imagens com o H3 parece contraditória inicialmente.
O H3 foi treinado para gerar imagens e vídeos
A MiniMax não treinou o H3 apenas para predição de vídeo. O escopo de pré-treinamento publicado inclui geração de imagens e edição I2I, além de tarefas de vídeo, áudio, referência e entre modalidades.
Isso sugere uma arquitetura diferente para a IA criativa: em vez de tratar T2I, I2I, T2V e controle de referências como problemas completamente separados, o H3 aprende as relações entre o contexto multimodal e a saída desejada.
No entanto, a ficha pública do H3 descreve atualmente H3-Base-FL2VA e H3-Base-Ref2VA como modelos que produzem vídeo e áudio. Isso significa que a capacidade adquirida no pré-treinamento é mais ampla que a principal via de saída disponibilizada pelos checkpoints H3 lançados.
Camada | O que o H3 oferece |
|---|---|
Pré-treinamento | T2I, T2V, edição I2I e tarefas de referência multimodal |
Checkpoints públicos do H3 | Principalmente saída de vídeo e áudio |
Fluxos de imagens estáticas | Geração e edição com um único quadro ou um número mínimo de quadros |
Principal oportunidade | Transformar melhor as capacidades de imagem do H3 em produtos |
Como funciona a geração de uma única imagem com MiniMax H3?
Os fluxos úteis de imagens estáticas com H3 não têm um vídeo normal como produto final desejado. Eles minimizam o processo de geração temporal para produzir ou extrair com eficiência uma imagem estática controlada.
Alguns fluxos usam uma configuração de quadro único; outros geram um pacote mínimo de quadros e decodificam a melhor imagem estática. Isso é tecnicamente mais preciso que presumir que todos os fluxos de imagem do H3 funcionam exatamente da mesma forma.
Por que o design do fluxo de imagem única importa
Um processo prático de imagens estáticas com H3 costuma envolver:
- Fornecer texto, uma imagem de origem ou várias referências.
- Definir como essas entradas se relacionam com o resultado desejado.
- Minimizar a geração temporal desnecessária.
- Decodificar o resultado para uso como imagem estática.
- Refinar apenas as texturas ou os rostos ainda problemáticos quando necessário.
Para designers, isso torna o H3 uma ferramenta prática para arte conceitual, fichas de personagens, storyboards, imagens de campanha, cenas de produtos e edição controlada de imagens. Esses usos também explicam onde o MiniMax H3 se encaixa melhor em um processo criativo mais amplo.
Por que o VAE visual do H3 importa para a qualidade da imagem
O H3-VisualVAE é documentado oficialmente como um autoencoder de vídeo temporalmente causal, com compressão espacial de 16×, compressão temporal de 4× e 24 canais latentes. Esse contexto é importante ao avaliar um quadro estático.
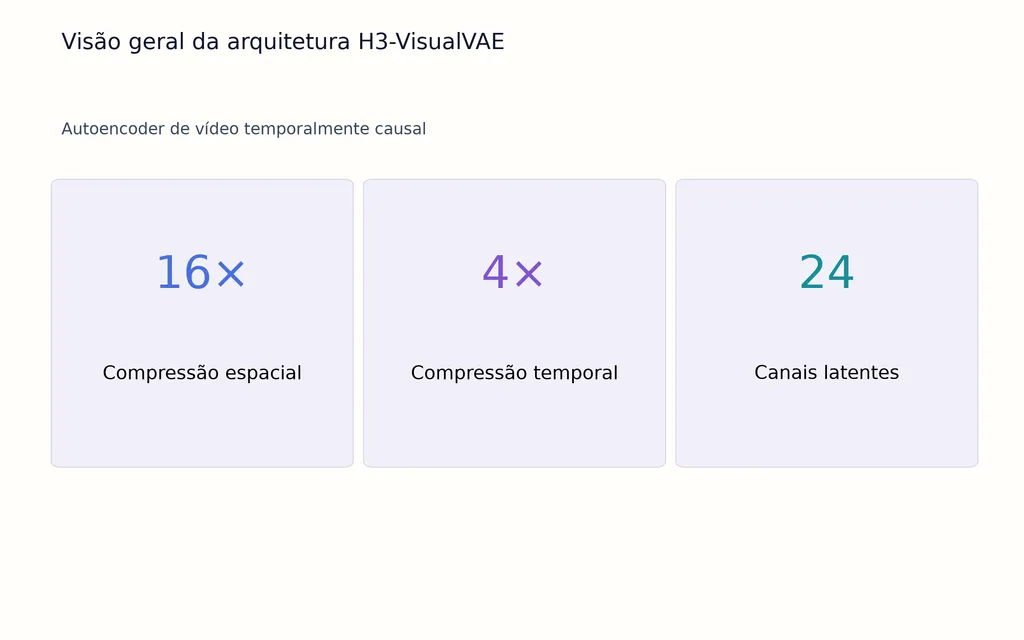
Isso não significa que o VAE, sozinho, cause todos os problemas de qualidade, mas ajuda a explicar a importância da configuração dos quadros e da estratégia de decodificação. Um processo otimizado para representação temporal não está automaticamente otimizado para todas as exigências de imagens estáticas, especialmente cabelo, pele, tecido, tipografia e rostos pequenos.
O que a edição de imagens com MiniMax H3 pode fazer em fluxos reais?
A edição de imagens com H3 é mais útil quando uma tarefa exige alterar uma propriedade significativa preservando várias outras.
Nossa pesquisa abrangeu fluxos de troca de roupas, mudanças de idade, ajustes corporais, substituição de locais, mudanças de câmera, controle de poses, estilização, edição de poses guiada por profundidade, fichas de personagens e variações de storyboards.
Estudo de caso: alteração local com preservação global
Considere uma imagem de moda em que o designer deseja trocar apenas a roupa.
Uma edição bem-sucedida deve preservar:
- a identidade;
- a expressão facial;
- a posição do corpo;
- o ângulo da câmera;
- a iluminação;
- o ambiente;
- os objetos não relacionados.
Isso é mais difícil que gerar uma imagem substituta visualmente semelhante. O modelo precisa entender o que pode ser editado e o que já foi aprovado.
Esse padrão de alteração local com preservação global é uma das formas mais úteis de entender a edição com H3 no design profissional.
Estudo de caso: edição em 1920 × 1088 em cerca de oito segundos
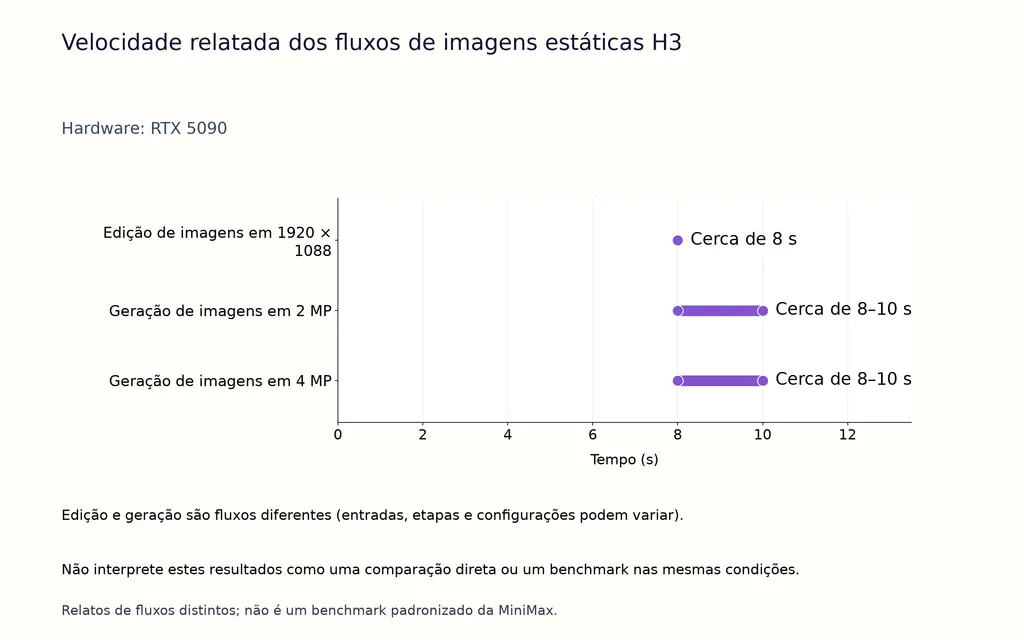
Um fluxo com RTX 5090 incluído em nossa pesquisa relatou cerca de oito segundos para muitas edições de imagem única em 1920 × 1088, incluindo tarefas de roupas, idade, corpo, local, câmera e fichas de personagens.
Este não é um benchmark oficial da MiniMax. Hardware, precisão, VAE, configuração do fluxo e complexidade da tarefa afetam a latência.
O caso mostra que a edição com H3 pode ser rápida o suficiente para exploração visual iterativa, em que um designer precisa comparar muitas variações controladas em vez de esperar um único render final.
Qual é o desempenho do H3 na edição com várias referências e na consistência de personagens?
O controle de várias referências é uma das principais vantagens do H3 para fluxos de imagem e design.
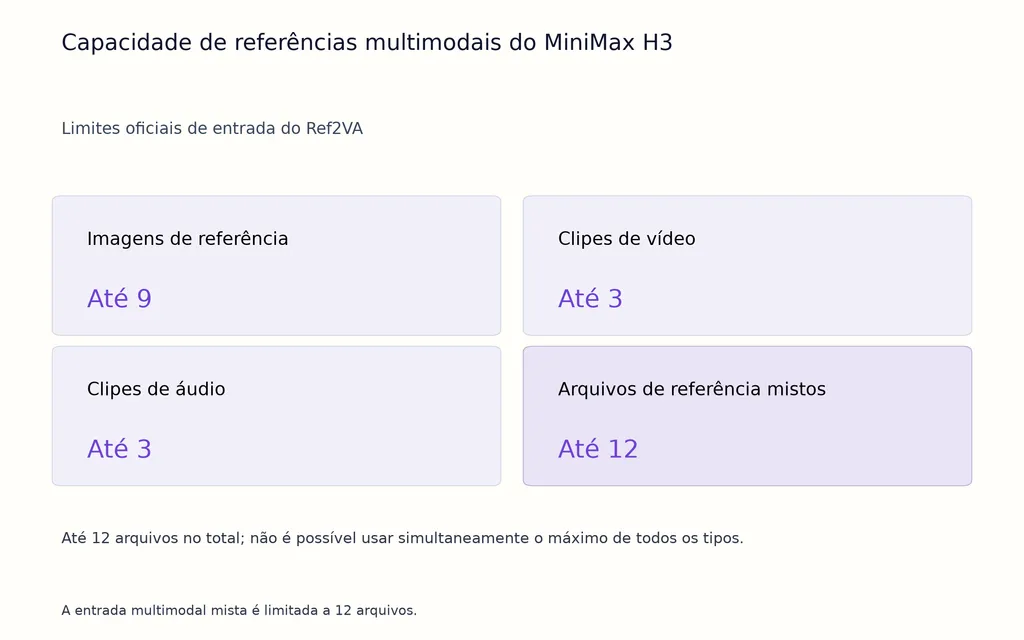
A especificação oficial Ref2VA da MiniMax oferece suporte a até nove imagens de referência, além de até três clipes de vídeo e três de áudio. A entrada mista de referências multimodais é limitada a 12 arquivos.
Uma referência pode controlar a identidade, e outra, o estilo
O importante não é simplesmente enviar nove imagens, mas atribuir diferentes papéis criativos às referências.
Referência | Papel criativo |
|---|---|
Imagem 1 | Identidade do personagem |
Imagem 2 | Roupa |
Imagem 3 | Produto |
Imagem 4 | Iluminação |
Imagem 5 | Direção de estilo |
Um prompt ou uma camada de contexto pode então descrever como esses recursos devem interagir. Uma estrutura clara de prompts de design com IA torna-se especialmente útil quando várias referências precisam de responsabilidades distintas.
Para fluxos de personagens, isso oferece uma alternativa ao treinamento imediato de uma LoRA. O condicionamento por referências pode ser mais rápido para storyboards, exploração de campanhas, fichas de personagens e pequenas produções, enquanto a LoRA continua útil quando uma equipe precisa reproduzir a identidade com muita consistência em uma série muito maior.
Em que a geração de imagens com H3 mais se destaca?
Nossa análise sugere que as maiores capacidades de imagem do H3 são semânticas, mais que puramente em nível de pixel.
O modelo torna-se particularmente interessante quando várias restrições precisam funcionar juntas: identidade, câmera, relações espaciais, referências, iluminação, composição e uma direção criativa explícita.
Composição, direção de arte e compreensão espacial
Nos fluxos comparativos que analisamos, o H3 frequentemente se destacou em:
- composição complexa;
- fidelidade às referências;
- posicionamento de personagens;
- interpretação da câmera;
- relações espaciais;
- adesão à direção de arte.
Algumas comparações individuais preferiram a composição do H3 à dos fluxos GPT Image, enquanto outros testes preferiram a edição baseada em Flux para a qualidade final.
Esses não são benchmarks padronizados. A lição prática é mais útil: teste o H3 quando entender o briefing for mais difícil que polir os pixels.
Como o H3 lida com tipografia e design gráfico?
Os fluxos de imagens estáticas do H3 também foram explorados para pôsteres, layouts de revista, painéis, infográficos e outras peças gráficas estruturadas.
Isso amplia seu valor para além de quadros cinematográficos. Uma boa composição e compreensão de contexto podem ajudar a estabelecer hierarquia, posicionamento e direção visual.
Tipografia é outra questão. Nossa análise também identificou distorção de texto como uma falha recorrente, principalmente quando o resultado depende de letras pequenas ou de texto exato. Portanto, o H3 é mais convincente para explorar layouts e direções visuais do que para aprovar automaticamente a tipografia final. O texto de produção ainda deve ser verificado ou reconstruído em um ambiente de design editável.
Por que as imagens do H3 ficam desfocadas ou falham em rostos distantes?
As limitações recorrentes das imagens estáticas do H3 em nossa pesquisa foram desfoque, texturas borradas, pele com aparência plástica, rostos distantes fracos, rostos pequenos deformados, fundos pouco nítidos e texto inconsistente.
Esses problemas revelam uma distinção importante na produção:
Uma composição pode estar semanticamente correta sem estar pronta para entrega.
Estudo de caso: geração de imagens H3 em 2 MP versus 4 MP
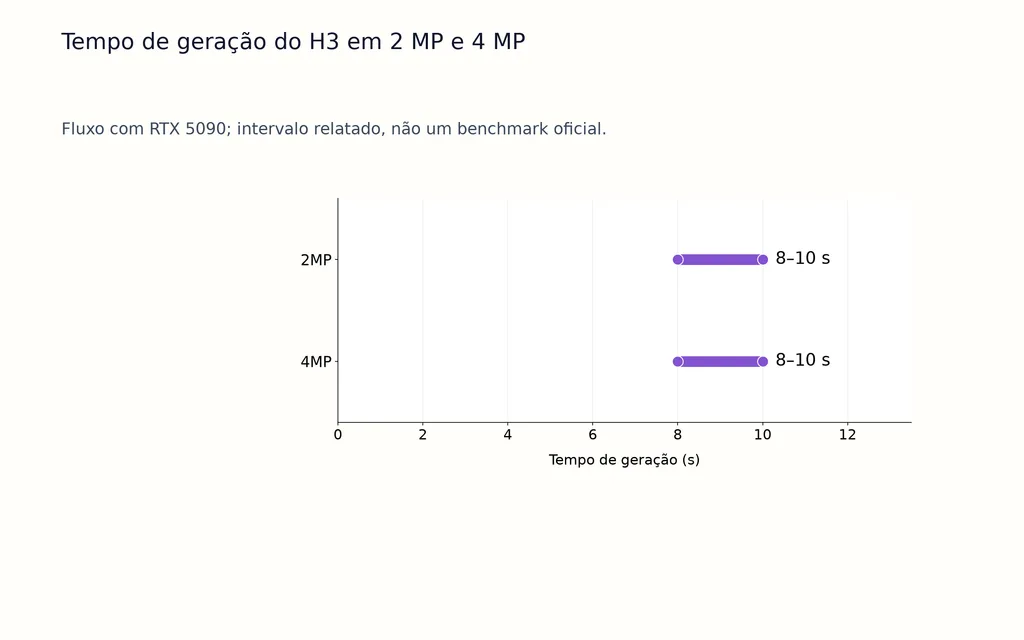
Um fluxo de longa duração com RTX 5090 em nossa pesquisa havia gerado milhares de imagens estáticas H3 e relatou cerca de 8–10 segundos para gerações em 2 MP e 4 MP com sua configuração.
Elevar a resolução para perto de 4 MP reduziu algumas deformações faciais, mas os problemas com rostos distantes e fundos pouco nítidos não foram totalmente resolvidos.
Esse resultado é valioso porque mostra por que simplesmente pedir mais pixels não basta. A resolução ajuda, mas o comportamento do VAE, a escala do assunto, a decodificação, a quantização e a forma como o modelo trata estruturas finas também importam.
Por que o H3-Regenerate-2K vai além da ampliação comum
A MiniMax adota uma abordagem mais interessante para a saída de vídeo em alta resolução. O H3-Regenerate-2K envia o resultado de menor resolução de volta ao H3 junto com o contexto multimodal original.
Em vez de pedir a um sistema separado de super-resolução que adivinhe informações ausentes apenas a partir dos pixels, a regeneração pode reutilizar o prompt e as referências ao reconstruir detalhes finos.
A MiniMax destaca especificamente textos pequenos e detalhes finos como exemplos em que a regeneração contextual pode recuperar informações que a super-resolução convencional teria de inferir.
Para futuros fluxos de imagem do H3, essa ideia pode importar mais que a simples ampliação.
Qual é o melhor fluxo de imagens com H3 para produção?
Para o design profissional de hoje, eu trataria o H3 como um motor semântico e de referências primeiro, usando depois um modelo nativo de imagem seletivamente para o acabamento final.
Etapa 1: usar o H3 para a estrutura criativa
O H3 é adequado para resolver:
- identidade;
- composição;
- pose;
- câmera;
- relações entre referências;
- estrutura da cena;
- alterações complexas;
- continuidade do storyboard.
Etapa 2: refinar apenas os pixels deficientes
Os fluxos em nossa pesquisa combinaram resultados do H3 com ferramentas como Flux.2 Klein 9B, Qwen Image Edit e SeedVR para melhorar rostos, tecidos, cabelos e texturas finas.
O perigo é o excesso de refinamento. Um segundo modelo pode corrigir a textura e, sem querer, alterar a expressão, a iluminação, a pose ou a identidade.
Portanto, o melhor objetivo de produção é a recuperação seletiva de detalhes com preservação semântica, e não a regeneração sem restrições.
É também por isso que um espaço multimodelo pode ser mais útil que a fidelidade a um único modelo. A direção atual do Virse se concentra em manter muitos modelos e recursos visuais na mesma tela, para que uma equipe possa encaminhar composição, edição, refinamento e movimento a modelos diferentes sem perder o contexto criativo ao redor.
Perguntas frequentes
O H3 é um modelo de imagem ou de vídeo?
O H3 é um modelo de geração multimodal de uso geral, mas seus checkpoints H3 atualmente lançados produzem principalmente vídeo e áudio. A geração de imagens continua sendo parte de sua capacidade subjacente porque a MiniMax incluiu T2I e referência e edição I2I no pré-treinamento.
O H3 pode gerar uma única imagem sem criar um vídeo normal?
Sim. Os fluxos de imagens estáticas podem minimizar a geração temporal com abordagens de quadro único ou de um número mínimo de quadros e decodificar o resultado para uso como imagem. O fluxo exato varia, portanto a geração de imagens com H3 não deve ser descrita como um único processo oficial universal de imagem única.
Por que as imagens H3 ficam desfocadas, e 4 MP resolve o problema?
Uma resolução maior pode reduzir algumas deformações faciais, mas o caso em 4 MP que analisamos não eliminou totalmente os problemas com rostos distantes nem com fundos pouco nítidos. Resolução, comportamento do VAE, configuração dos quadros, escala do assunto, quantização e decodificação influenciam a qualidade final.
O H3 pode manter um personagem consistente sem uma LoRA?
Sim, os fluxos baseados em referências podem preservar a identidade do personagem sem treinar uma LoRA imediatamente. O H3 oferece suporte oficial a até nove imagens de referência, permitindo que diferentes referências contribuam com identidade, roupa, produtos ou direção visual. A LoRA continua útil quando é necessária uma repetibilidade muito alta em um grande conjunto de recursos.
O H3 é melhor que Flux ou GPT Image para editar imagens?
Não há um vencedor universal confiável. O H3 é particularmente interessante para composição, referências, identidade e controle espacial, enquanto modelos nativos de imagem podem oferecer texturas ou acabamento final superiores em alguns fluxos. Para produções exigentes, usar H3 seguido de refinamento seletivo costuma ser uma comparação mais útil que escolher um único modelo para todas as tarefas.
Conclusão
O MiniMax H3 não é apenas um modelo de vídeo que, por acaso, produz quadros estáticos utilizáveis. A geração de imagens e a edição I2I já faziam parte de seu treinamento multimodal, e os fluxos atuais mostram potencial real para geração guiada por referências, consistência de personagens, edição complexa, storyboards, exploração gráfica e composição com várias referências. Suas principais limitações continuam sendo o acabamento de imagens estáticas, rostos distantes, texturas finas e tipografia exata, enquanto os testes de geração em 4 MP mostram que uma resolução maior melhora alguns problemas sem resolver todos. Para equipes de design, a estratégia atual mais forte é deixar o H3 cuidar da estrutura semântica, das referências e das alterações controladas, encaminhando apenas os detalhes não resolvidos a um modelo nativo de imagem. A mudança mais ampla importa mais que qualquer benchmark isolado: geração de imagens, edição de imagens, compreensão de referências e geração de vídeo estão se tornando operações cada vez mais conectadas dentro do mesmo fluxo criativo multimodal.
Mais do blogue da Virse
Fluxo de trabalho

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de outubro de 2026 by Yifan Zhao