
Generación y edición de imágenes con MiniMax H3: por qué un modelo de vídeo también puede funcionar como modelo de imagen
 Yifan Zhao13 min de lectura ·
MiniMax H3 puede generar y editar imágenes fijas porque T2I y la edición I2I ya formaban parte de su entrenamiento multimodal, aunque actualmente H3 se conoce principalmente como modelo de vídeo. La documentación de lanzamiento de H3 de MiniMax incluye explícitamente T2I, T2V, referencia y edición generalizadas, referencia y edición I2I, y referencia y edición I2V. Por tanto, la generación de imágenes con H3 va más allá de extraer por suerte un buen fotograma de un vídeo, y entender cómo usar MiniMax H3 ayuda a aclarar cómo encajan estas capacidades en flujos reales.
El reto es convertir esa capacidad de imagen subyacente en una imagen fija lista para producción. En los flujos de H3 y las preguntas de usuarios que revisamos, el modelo resultó especialmente interesante para composición, identidad de personajes, control multirreferencia, cambios de cámara y ediciones complejas, mientras que los rostros lejanos, las texturas finas y el acabado final a nivel de píxel seguían siendo menos fiables. Un flujo estructurado de prompts para MiniMax H3 puede ayudar a controlar esas variables de forma más deliberada. La verdadera oportunidad no es simplemente crear una imagen, sino preservar la intención creativa entre referencias, revisiones, imágenes y movimiento.
Virse se ha creado en torno a ese flujo multimodelo. Su experiencia actual reúne más de 50 modelos en un único lienzo visual, con herramientas como Nano Banana 2, GPT Image 2, Seedance 2.0 y MiniMax H3 disponibles en su ecosistema. En lugar de trasladar referencias y resultados entre ventanas de prompts desconectadas, los diseñadores pueden mantener unido el contexto visual, comparar enfoques y alternar entre modelos de imagen y vídeo dentro del mismo flujo de diseño con IA, con el apoyo de flujos creativos multiagente.
¿MiniMax H3 es un modelo de imagen o de vídeo?
La mejor forma de entender H3 es como un modelo de generación multimodal de propósito general cuyos checkpoints H3 publicados actualmente están diseñados principalmente para producir vídeo y audio.
Esa distinción entre la capacidad del modelo y la salida del producto explica por qué la generación de imágenes con H3 parece contradictoria al principio.
H3 se entrenó para generar tanto imágenes como vídeo
MiniMax no entrenó H3 únicamente para predecir vídeo. Su ámbito de preentrenamiento publicado incluye generación de imágenes y edición I2I, además de vídeo, audio, referencias y tareas intermodales.
Esto apunta a una arquitectura distinta para la IA creativa: en vez de tratar T2I, I2I, T2V y el control de referencias como problemas totalmente separados, H3 aprende las relaciones entre el contexto multimodal y la salida deseada.
Sin embargo, la ficha pública de H3 describe actualmente H3-Base-FL2VA y H3-Base-Ref2VA como modelos que producen vídeo y audio. Esto significa que la capacidad adquirida en el preentrenamiento es más amplia que la principal vía de salida expuesta por los checkpoints H3 publicados.
Capa | Qué admite H3 |
|---|---|
Preentrenamiento | T2I, T2V, edición I2I y tareas de referencia multimodal |
Checkpoints públicos de H3 | Principalmente salida de vídeo y audio |
Flujos de imágenes fijas | Generación y edición con un solo fotograma o un mínimo de fotogramas |
Principal oportunidad | Convertir mejor las capacidades de imagen de H3 en productos |
¿Cómo funciona la generación de una sola imagen con MiniMax H3?
Los flujos útiles de imágenes fijas con H3 no consideran un vídeo normal como producto final deseado. Reducen al mínimo el proceso de generación temporal para producir o extraer de forma eficiente una imagen fija controlada.
Algunos flujos buscan una configuración de un solo fotograma; otros generan un paquete mínimo de fotogramas y decodifican la mejor imagen fija. Esto es técnicamente más preciso que asumir que todos los flujos de imagen de H3 funcionan exactamente igual.
Por qué importa el diseño del flujo de imagen única
Un proceso práctico de imágenes fijas con H3 suele incluir:
- Proporcionar texto, una imagen de origen o varias referencias.
- Definir cómo se relacionan esas entradas con el resultado deseado.
- Minimizar la generación temporal innecesaria.
- Decodificar el resultado para usarlo como imagen fija.
- Refinar únicamente las texturas o los rostros que lo necesiten.
Para los diseñadores, esto convierte H3 en una herramienta práctica para arte conceptual, hojas de personajes, guiones gráficos, imágenes de campaña, escenas de producto y edición controlada. Estos usos también explican dónde encaja mejor MiniMax H3 en un proceso creativo más amplio.
Por qué el VAE visual de H3 importa para la calidad de imagen
H3-VisualVAE se documenta oficialmente como un autocodificador de vídeo temporalmente causal con compresión espacial de 16×, compresión temporal de 4× y 24 canales latentes. Este contexto es importante al evaluar un fotograma estático.
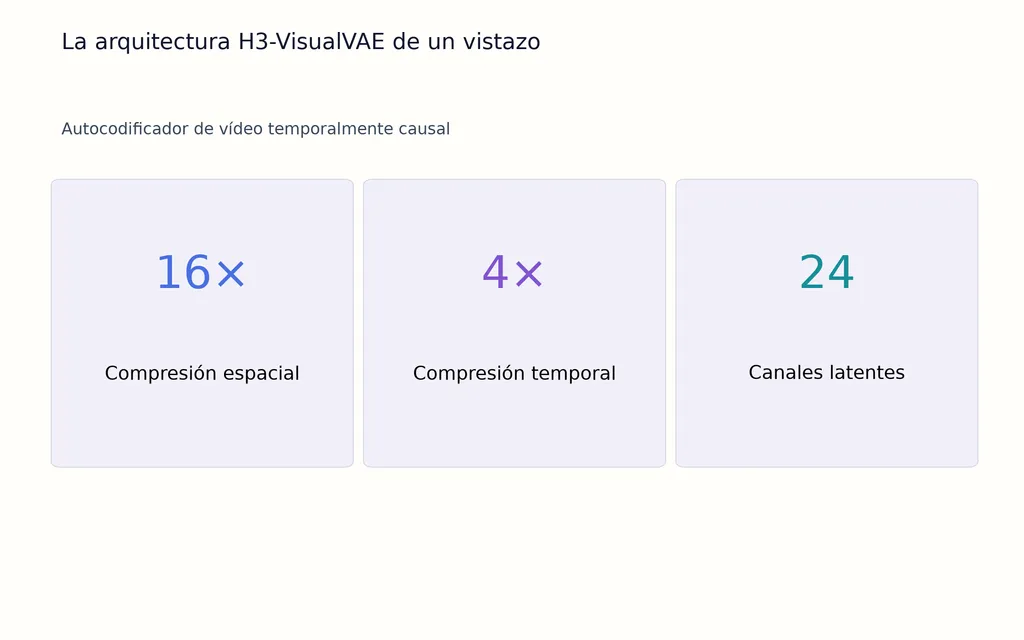
Esto no significa que el VAE sea por sí solo la causa de todos los problemas de calidad, pero ayuda a explicar por qué importan la configuración de fotogramas y la estrategia de decodificación. Un proceso optimizado para la representación temporal no está automáticamente optimizado para todas las exigencias de una imagen fija, especialmente cabello, piel, tejidos, tipografía y rostros pequeños.
¿Qué puede hacer la edición de imágenes con MiniMax H3 en flujos reales?
La edición de imágenes con H3 resulta más útil cuando una tarea exige cambiar una propiedad importante conservando varias otras.
Nuestra investigación abarcó flujos de cambios de ropa y edad, ajustes corporales, sustitución de ubicaciones, cambios de cámara, control de poses, estilización, edición de poses guiada por profundidad, hojas de personajes y variaciones de guiones gráficos.
Caso práctico: cambio local con conservación global
Pensemos en una imagen de moda en la que el diseñador solo quiere cambiar el atuendo.
Una edición acertada debe conservar:
- la identidad;
- la expresión facial;
- la posición del cuerpo;
- el ángulo de cámara;
- la iluminación;
- el entorno;
- los objetos ajenos al cambio.
Eso es más difícil que generar una imagen de reemplazo visualmente similar. El modelo debe entender qué se puede editar y qué ya se ha aprobado.
Este patrón de cambio local y conservación global es una de las formas más útiles de entender la edición con H3 para el diseño profesional.
Caso práctico: edición de 1920 × 1088 en unos ocho segundos
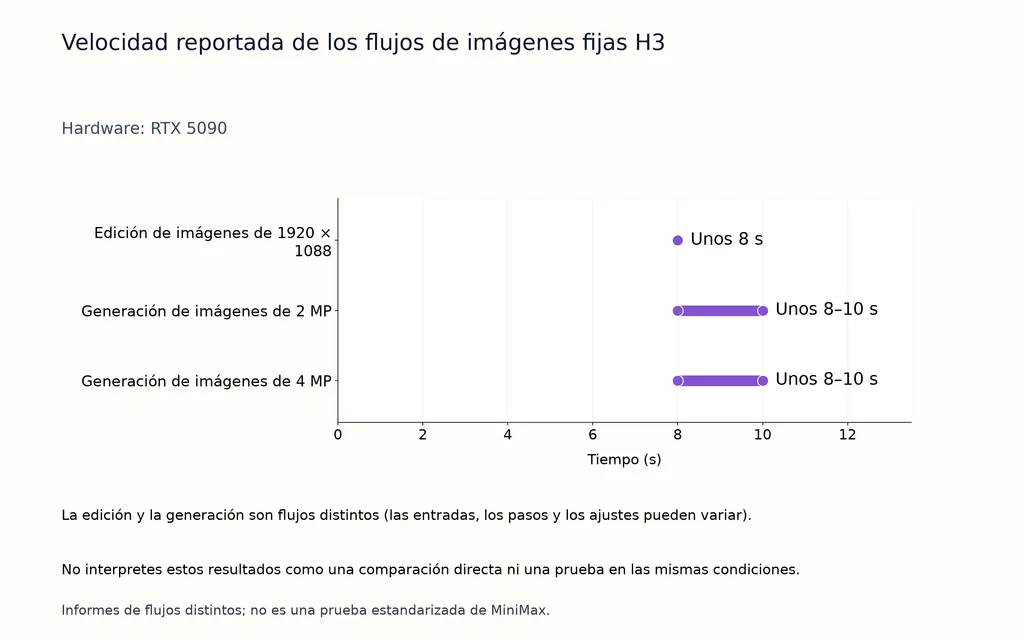
Un flujo con RTX 5090 incluido en nuestra investigación informó de aproximadamente ocho segundos para muchas ediciones de una sola imagen a 1920 × 1088, incluidas tareas de ropa, edad, cuerpo, ubicación, cámara y hojas de personajes.
No es una prueba oficial de MiniMax. El hardware, la precisión, el VAE, la configuración del flujo y la complejidad de la tarea influyen en la latencia.
Lo que sí demuestra este caso es que la edición con H3 puede ser lo bastante rápida para la exploración visual iterativa, cuando un diseñador necesita comparar muchas variaciones controladas en vez de esperar un único render final.
¿Qué tal funciona H3 en edición multirreferencia y coherencia de personajes?
El control multirreferencia es una de las principales ventajas de H3 para los flujos de imagen y diseño.
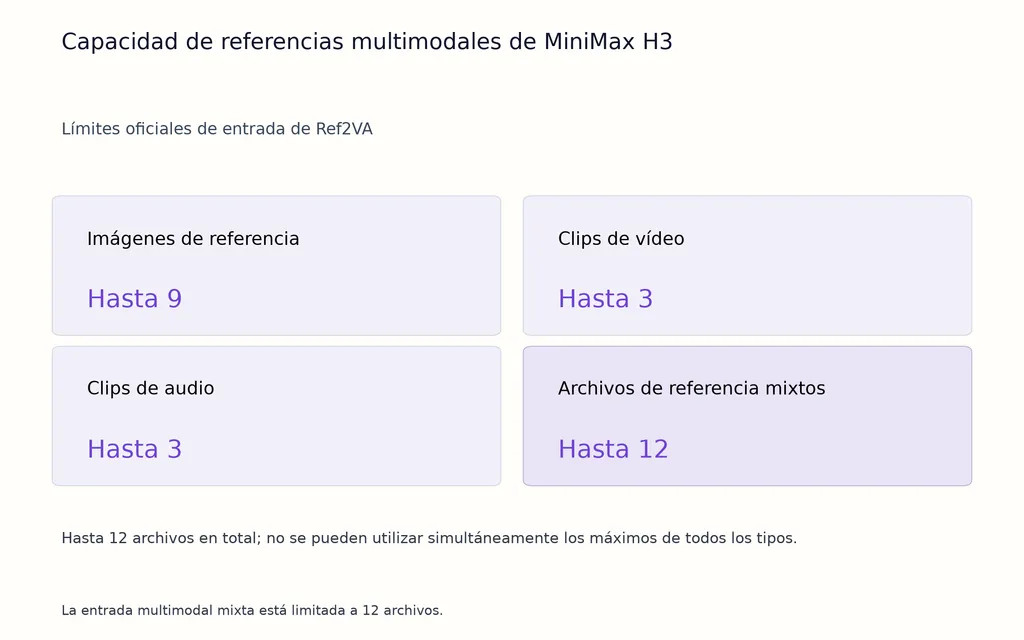
La especificación oficial Ref2VA de MiniMax admite hasta nueve imágenes de referencia, además de hasta tres clips de vídeo y tres de audio. La entrada mixta de referencias multimodales está limitada a 12 archivos.
Una referencia puede controlar la identidad y otra el estilo
Lo importante no es simplemente subir nueve imágenes, sino asignar distintas funciones creativas a las referencias.
Referencia | Función creativa |
|---|---|
Imagen 1 | Identidad del personaje |
Imagen 2 | Ropa |
Imagen 3 | Producto |
Imagen 4 | Iluminación |
Imagen 5 | Dirección de estilo |
Un prompt o una capa de contexto puede describir después cómo deben interactuar estos recursos. Una estructura clara de prompts de diseño con IA resulta especialmente útil cuando varias referencias necesitan responsabilidades distintas.
Para los flujos de personajes, esto ofrece una alternativa a entrenar una LoRA de inmediato. El condicionamiento por referencias puede ser más rápido para guiones gráficos, exploración de campañas, hojas de personajes y producciones cortas, mientras que LoRA sigue siendo útil cuando un equipo necesita una identidad altamente repetible en una serie mucho mayor.
¿Dónde destaca más la generación de imágenes con H3?
Nuestra revisión sugiere que las mayores fortalezas de H3 en imagen son semánticas, más que puramente a nivel de píxel.
El modelo resulta especialmente interesante cuando deben funcionar juntas varias restricciones: identidad, cámara, relaciones espaciales, referencias, iluminación, composición y una dirección creativa explícita.
Composición, dirección artística y comprensión espacial
En los flujos comparativos que revisamos, H3 destacó con frecuencia en:
- composición compleja;
- fidelidad a las referencias;
- posición de personajes;
- interpretación de la cámara;
- relaciones espaciales;
- seguimiento de la dirección artística.
Algunas comparaciones individuales preferían la composición de H3 a la de los flujos GPT Image, mientras que otras pruebas preferían la edición basada en Flux para la calidad final.
No son pruebas estandarizadas. La lección práctica es más útil: prueba H3 cuando entender el encargo sea más difícil que pulir los píxeles.
¿Cómo maneja H3 la tipografía y el diseño gráfico?
También se han explorado flujos de imágenes fijas con H3 para carteles, diseños de revista, paneles de control, infografías y otros gráficos estructurados.
Esto amplía su valor más allá de los fotogramas cinematográficos. Una buena composición y comprensión del contexto pueden ayudar a establecer jerarquía, ubicación y dirección visual.
La tipografía es otra cuestión. Nuestra revisión también detectó distorsión del texto como fallo recurrente, especialmente cuando el resultado depende de texto pequeño o exacto. Por eso H3 convence más para explorar diseños y direcciones visuales que para aprobar automáticamente la tipografía final. El texto de producción debe seguir revisándose o reconstruyéndose en un entorno de diseño editable.
¿Por qué las imágenes de H3 se ven borrosas o fallan en los rostros lejanos?
Las limitaciones recurrentes de las imágenes fijas H3 en nuestra investigación fueron desenfoque, texturas emborronadas, piel con aspecto plástico, rostros lejanos deficientes, caras pequeñas deformadas, fondos suaves y texto inconsistente.
Estos problemas revelan una distinción importante en producción:
Una composición puede ser semánticamente correcta sin estar lista para entregar.
Caso práctico: generación de imágenes H3 en 2 MP frente a 4 MP
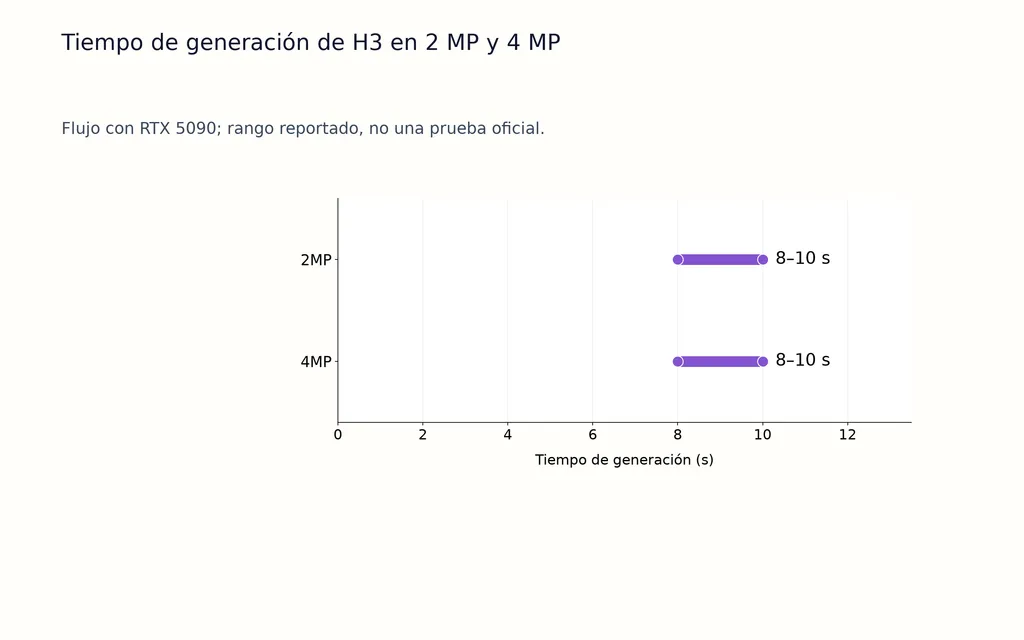
Un flujo de larga duración con RTX 5090 en nuestra investigación había generado miles de imágenes fijas H3 e informó de aproximadamente 8–10 segundos para generaciones de 2 MP y 4 MP con su configuración.
Aumentar la resolución hacia 4 MP redujo algunas deformaciones faciales, pero los rostros lejanos y la falta de nitidez del fondo no se resolvieron por completo.
Este resultado es valioso porque muestra por qué no basta con pedir más píxeles. La resolución ayuda, pero también importan el comportamiento del VAE, la escala del sujeto, la decodificación, la cuantización y cómo maneja el modelo las estructuras finas.
Por qué H3-Regenerate-2K es más que un reescalado normal
MiniMax adopta un enfoque más interesante para la salida de vídeo de alta resolución. H3-Regenerate-2K introduce el resultado de menor resolución de nuevo en H3 junto con el contexto multimodal original.
En lugar de pedir a un sistema de superresolución independiente que adivine la información faltante solo a partir de píxeles, la regeneración puede reutilizar el prompt y las referencias al reconstruir detalles finos.
MiniMax señala específicamente el texto pequeño y los detalles finos como ejemplos en los que la regeneración contextual puede recuperar información que la superresolución convencional tendría que inferir.
Para futuros flujos de imagen de H3, esta idea puede importar más que el simple reescalado.
¿Cuál es el mejor flujo de imágenes con H3 para producción?
Para el diseño profesional actual, trataría H3 como un motor semántico y de referencias primero, y después usaría un modelo de imagen nativo de forma selectiva para el acabado final.
Etapa 1: usar H3 para la estructura creativa
H3 es adecuado para resolver:
- identidad;
- composición;
- pose;
- cámara;
- relaciones entre referencias;
- estructura de la escena;
- cambios complejos;
- continuidad del guion gráfico.
Etapa 2: refinar solo los píxeles deficientes
Los flujos de nuestra investigación combinaron resultados de H3 con herramientas como Flux.2 Klein 9B, Qwen Image Edit y SeedVR para mejorar rostros, tejidos, cabello y texturas finas.
El riesgo es refinar en exceso. Un segundo modelo puede reparar la textura y, sin querer, cambiar la expresión, la iluminación, la pose o la identidad.
Por tanto, el mejor objetivo de producción es recuperar detalles de forma selectiva preservando la semántica, no regenerar sin restricciones.
Por eso un espacio multimodelo puede ser más útil que la fidelidad a un único modelo. La dirección actual de Virse se centra en mantener muchos modelos y recursos visuales en el mismo lienzo, para que un equipo pueda asignar composición, edición, refinamiento y movimiento a distintos modelos sin perder el contexto creativo que los rodea.
Preguntas frecuentes
¿H3 es un modelo de imagen o de vídeo?
H3 es un modelo de generación multimodal de propósito general, pero sus checkpoints H3 publicados actualmente producen principalmente vídeo y audio. La generación de imágenes sigue siendo parte de su capacidad subyacente porque MiniMax incluyó T2I y referencia y edición I2I durante el preentrenamiento.
¿Puede H3 generar una sola imagen sin crear un vídeo normal?
Sí. Los flujos de imágenes fijas pueden minimizar la generación temporal mediante enfoques de un solo fotograma o de un mínimo de fotogramas, y decodificar el resultado para usarlo como imagen. El flujo exacto varía, por lo que no debe describirse la generación de imágenes con H3 como un único proceso oficial universal de imagen única.
¿Por qué las imágenes H3 salen borrosas y lo soluciona 4 MP?
Una mayor resolución puede reducir algunas deformaciones faciales, pero el caso de 4 MP que revisamos no eliminó del todo los problemas de rostros lejanos ni la falta de nitidez del fondo. La resolución, el comportamiento del VAE, la configuración de fotogramas, la escala del sujeto, la cuantización y la decodificación influyen en la calidad final.
¿Puede H3 mantener un personaje coherente sin una LoRA?
Sí, los flujos basados en referencias pueden conservar la identidad del personaje sin entrenar una LoRA de inmediato. H3 admite oficialmente hasta nueve imágenes de referencia, lo que permite que distintas referencias aporten identidad, ropa, productos o dirección visual. LoRA sigue siendo útil cuando se requiere una repetibilidad muy alta en un conjunto grande de recursos.
¿H3 es mejor que Flux o GPT Image para editar imágenes?
No hay un ganador universal fiable. H3 resulta especialmente interesante para composición, referencias, identidad y control espacial, mientras que los modelos de imagen nativos pueden ofrecer mejores texturas o acabado final en algunos flujos. Para una producción exigente, H3 seguido de un refinamiento selectivo suele ser una comparación más útil que elegir un solo modelo para todas las tareas.
Conclusión
MiniMax H3 no es simplemente un modelo de vídeo que por casualidad produce fotogramas fijos utilizables. La generación de imágenes y la edición I2I ya formaban parte de su entrenamiento multimodal, y los flujos actuales muestran un potencial real para generación guiada por referencias, coherencia de personajes, edición compleja, guiones gráficos, exploración gráfica y composición multirreferencia. Sus principales límites siguen siendo el acabado de imágenes fijas, los rostros lejanos, las texturas finas y la tipografía exacta; las pruebas de generación en 4 MP muestran que una mayor resolución mejora algunos problemas sin resolverlos todos. Para los equipos de diseño, la estrategia más sólida actualmente es dejar que H3 gestione la estructura semántica, las referencias y los cambios controlados, y enviar solo los detalles pendientes a un modelo de imagen nativo. El cambio general importa más que cualquier prueba aislada: la generación de imágenes, la edición, la comprensión de referencias y la generación de vídeo se están convirtiendo cada vez más en operaciones conectadas dentro del mismo flujo creativo multimodal.
Más del blog de Virse
Flujo de trabajo

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de octubre de 2026 by Yifan Zhao