
MiniMax H3ワークフロー:メモリ不足、音声の乱れ、遅いレンダリングを解決
Vincent読了 11 分 ·
最適なMiniMax H3のComfyUIワークフローでは、T2V、I2V、開始・終了フレーム生成にFL2VAを使い、参照で同一性、動き、カメラ、声を制御する必要がある場合はRef2VAに切り替え、高速プレビューと最終レンダリングを分けます。信頼できるH3制作を支えるのは、モデルの振り分け、参照の構造、RAM/VRAM管理、ネイティブ音声の品質であり、1つの「完璧な」グラフではありません。
プロジェクトの規模が大きくなると難しさが現れます。複数の画像、動きの参照、音声、プロンプト、プレビュー、最終レンダリングによって、ワークフローはすぐに分断されます。同一性の維持、生成結果の比較、メモリ制御、連続性の確保が難しくなります。私たちが行ったH3ワークフロー事例の検討では、音声を損なわずに反復コストを減らすことが、制作上の最も重要なトレードオフの1つと分かりました。
Virseは、AIエージェントを無限キャンバスに取り入れ、こうしたワークフロー全体の不足を補います。デザイナーは、アセットの整理、制作の文脈の接続、複数エージェントの並行実行に加え、共有するブランドの好みやプロジェクト知識に基づいて作業できます。Virseはワンクリック生成でデザイナーを置き換えるのではなく、プロの制作チームによるAI支援制作をより構造的で、再現可能で、拡張しやすくします。MiniMax H3、Seedance 2.5、Seedance 2.0がVirseで利用でき、同じ制作ワークフロー内で複数の主要動画モデルを試して比較できます。
最適なMiniMax H3 ComfyUIワークフローとは?
実制作に使えるMiniMax H3ワークフローでは 探索と最終レンダリングを分けるべきです。構図、動き、同一性、カメラの方向性が適切か分からないうちに、すべてのシードをフル解像度でレンダリングするとGPU時間を無駄にします。本ガイドで検討した調査は、これらが公式の主要ワークフロー経路であることを確認しています。
プレビューから完成へ進むH3ワークフローを使う
実用的な手順は次のとおりです。
- ショットを定義する — 時間、アスペクト比、被写体、カメラ、必須の視覚的制約。
- FL2VAかRef2VAを選ぶ際は、必要な制御の種類を基準にします。
- 各参照に役割を割り当てるのは、生成を始める前です。
- 低解像度のプレビューを複数生成することで、構図と動きを比較します。
- 最適なシードと方向性を選ぶ。
- 最終品質の設定に戻すのは、承認されたショットです。
- 承認された結果だけをアップスケールまたは再生成する。
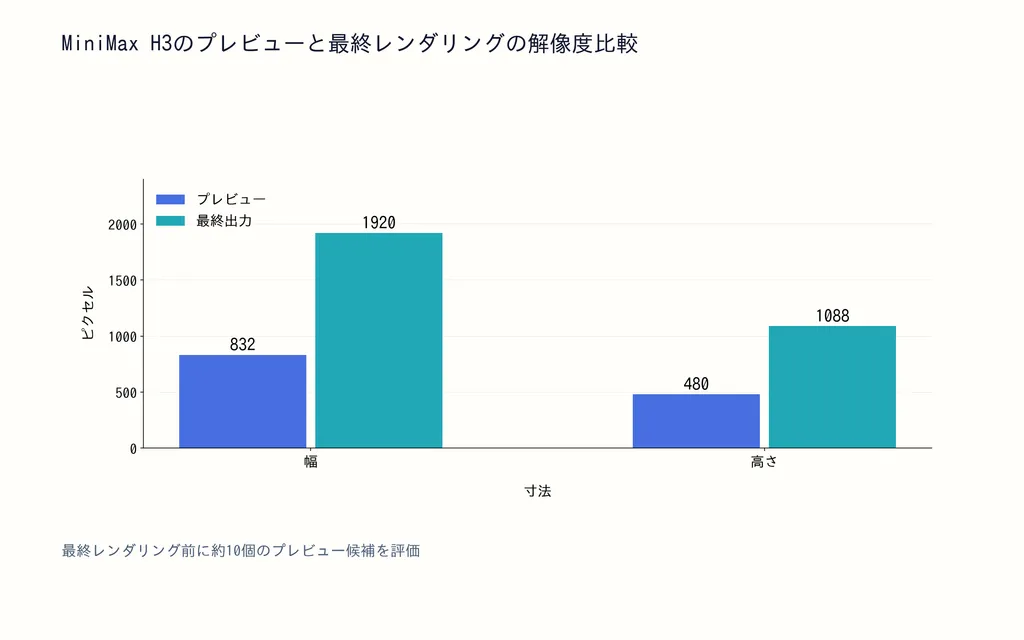
ある記録されたワークフローでは、約832 × 480でプレビューし、1920 × 1088で最終レンダリングすることで、まず約10個の候補を素早く評価しました。別の事例では、サンプリングを20ステップから10ステップに減らすと、見た目の変化は比較的小さかったものの、ネイティブ音声は明らかに悪化しました。
実践上の教訓は、ステップ数を大幅に減らす前にプレビュー解像度を下げることです。特に会話や音の同期が重要な場合に有効です。
ComfyUIでMiniMax H3を設定する方法
ComfyUIの公式H3ワークフローはT2V、I2V、R2Vを中心に構成され、FL2VAとRef2VAが異なる生成ニーズに対応します。本ガイドで検討した調査は、これらが公式の主要ワークフロー経路であることを確認しています。
どのH3ワークフローから始めるべきか?
ショットの要件を満たす最も単純な経路から始めます。
- T2V:FL2VA
- 単一画像のI2V:FL2VA
- 開始+終了フレーム:FL2VA
- 同一性の参照:Ref2VA
- 動きやカメラの参照:Ref2VA
- 音声や声の参照:Ref2VA
- 画像+動画+音声の複合制御:Ref2VA
ハイブリッドグラフで可能だからという理由だけで、大きなモデル分岐を両方読み込むのは避けましょう。モデルを単純に保つとメモリ負荷が減り、障害の診断もしやすくなります。
MiniMax H3のFL2VAとRef2VA:どちらのワークフローを使うべきか?
FL2VAは効率的な標準の選択肢、Ref2VAはマルチモーダル制御のワークフローです。
ニーズ | FL2VA | Ref2VA |
T2V | 最適な選択 | 通常は不要 |
I2V | 最適な選択 | 追加の参照がある場合のみ使用 |
開始/終了フレーム | 対応 | 主な用途ではない |
同一性の参照 | 限定的 | より適している |
動き/カメラの参照 | 非対応 | 対応 |
音声の参照 | 非対応 | 対応 |
公式のモデル構造では、T2V、I2V、フレーム条件付き生成のFL2VAと、画像・動画・音声参照による豊かな制御のRef2VAを区別しています。
すべてのH3生成にRef2VAを使わない理由は?
参照を増やしても、制御力が自動的に高まるわけではありません。画像、動画、音声の入力ごとに、H3が解釈する関係が増えます。
この点をデザインワークフローの観点から見ると、制作意図を正確に伝える最小限の参照セットを使うべきです。これにより曖昧さ、メモリコスト、プロンプトの複雑さを減らせます。
参照制御を改善するMiniMax H3 Ref2Vプロンプトの書き方
最も重要なH3のプロンプト作成ルールは、各参照に1つの明確な役割を与えることです。
同一性、動き、カメラ、声、音を分ける
構造化したRef2V指示では、次を明確にします。
- 画像1:人物や製品の同一性
- 画像2:照明、素材、視覚スタイル
- 動画1:身体の動きのみ
- 動画2:カメラの軌道のみ
- 音声1:声の特徴やタイミング
- サウンドスケープ:環境音
- 音楽:会話や劇中の音とは分けて記述
これはプロンプトに形容詞を増やすより信頼できる方法です。参照管理は従来のプロンプト作成より、アートディレクションに近い作業です。
複雑なRef2VAプロジェクトにはプロンプトコンパイラを使う
本ガイドで検討した実験的なワークフローでは、マルチモーダルLLMでアセットを分類し、時間、アスペクト比、人物、カメラ、音の決定事項を集め、その関係をH3で使えるプロンプトにまとめました。
複数人物や複数参照のプロジェクトでは、制作指示と生成の間に欠けていた重要な層、構造化された文脈管理が生まれます。
音声を損なわずComfyUIのMiniMax H3を高速化する方法
実用的で最も速いH3ワークフローは、必ずしもサンプリングステップが最少のものではありません。プレビューには、重要な特性を判断できるだけの品質が必要です。
H3のステップ数より先に解像度を下げる
記録された20から10ステップへの削減事例は特に参考になります。テストした人には見た目の劣化は比較的限定的に見えましたが、音声ははるかに明確に劣化しました。
構図、動きの方向、カメラを評価する場合、プレビューでは解像度を下げる方が通常は安全です。会話、タイミング、顔の細部、最終的な同期には、予定するレンダリングに近い設定を使いましょう。
SageAttentionとキャッシュ最適化を個別に試す
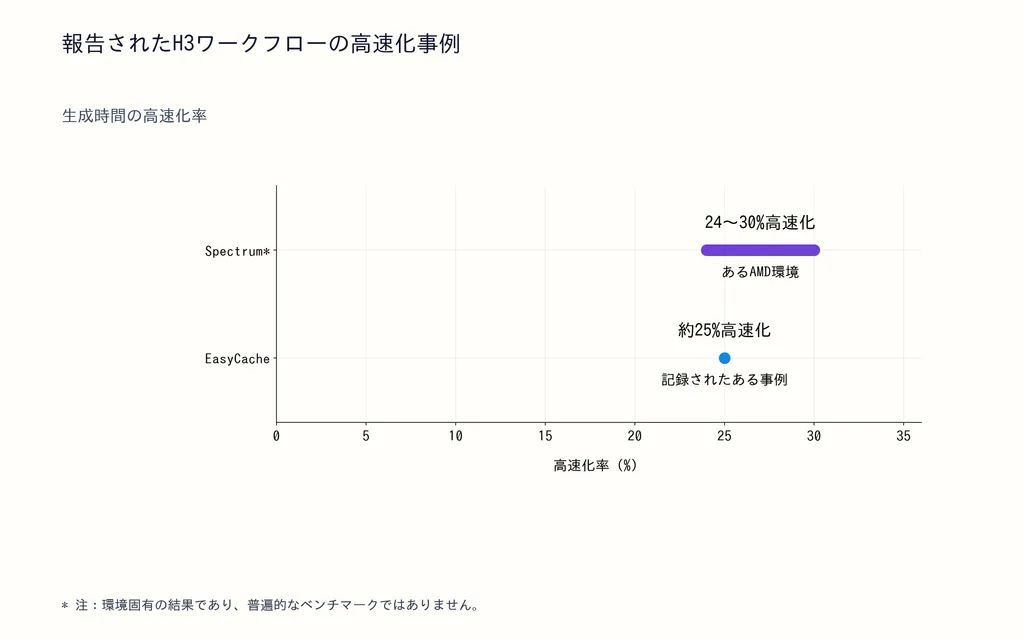
SageAttentionはH3の公式最適化の議論に含まれていますが、コミュニティの環境では実際の改善幅に差があります。SpectrumではあるAMD環境で約24~30%の高速化、EasyCacheのある事例では約25%が報告されています。ただし、これらは環境固有の観察であり、普遍的なベンチマークではありません。
EasyCacheについては、会話や一貫性が弱まったという報告もあります。SageAttention、キャッシュ、サンプラー、サンプリングステップ数を同時に変更しないでください。品質が変わった理由を理解するためです。
MiniMax H3のVRAM・RAM要件:必要なハードウェアは?
H3のメモリ計画はVRAMだけを基準にはできません。大きなモデルコンポーネントはGPUとシステムメモリの間を移動するため、RAMやモデルのライフサイクル管理が実際のボトルネックになることがあります。
十分なVRAMがあってもH3がメモリ不足になる理由
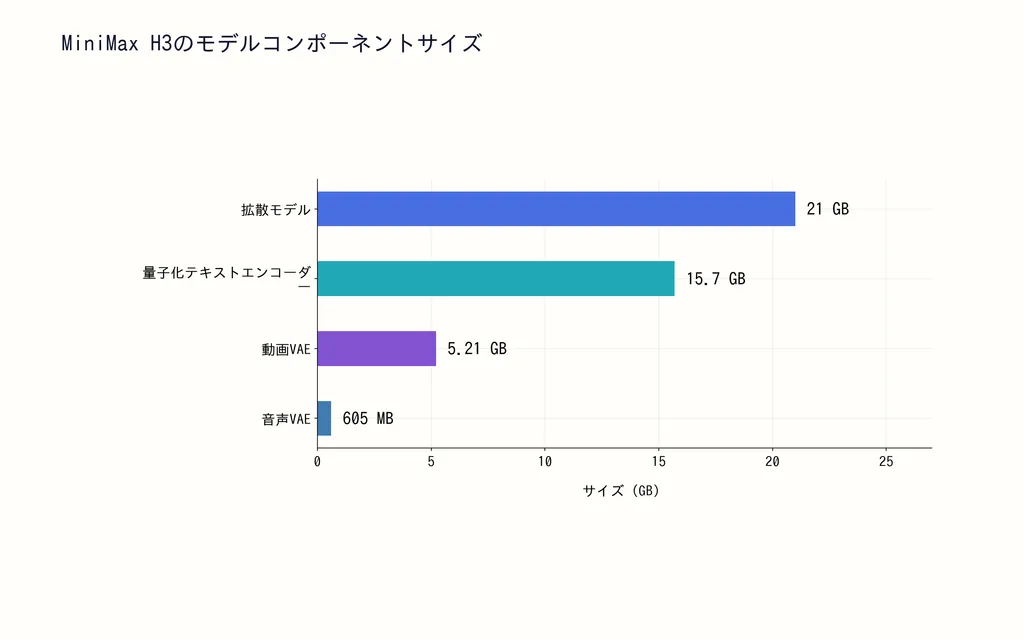
調査資料には、パッケージの概算サイズとして拡散モデル21 GB、ある量子化テキストエンコーダー15.7 GB、動画VAE 5.21 GB、音声VAE 605 MBが記録されています。
そのため、アンロードやオフロードは任意の整理作業ではなく、ワークフローの一部になります。
12 GB・16 GBのH3事例から分かること
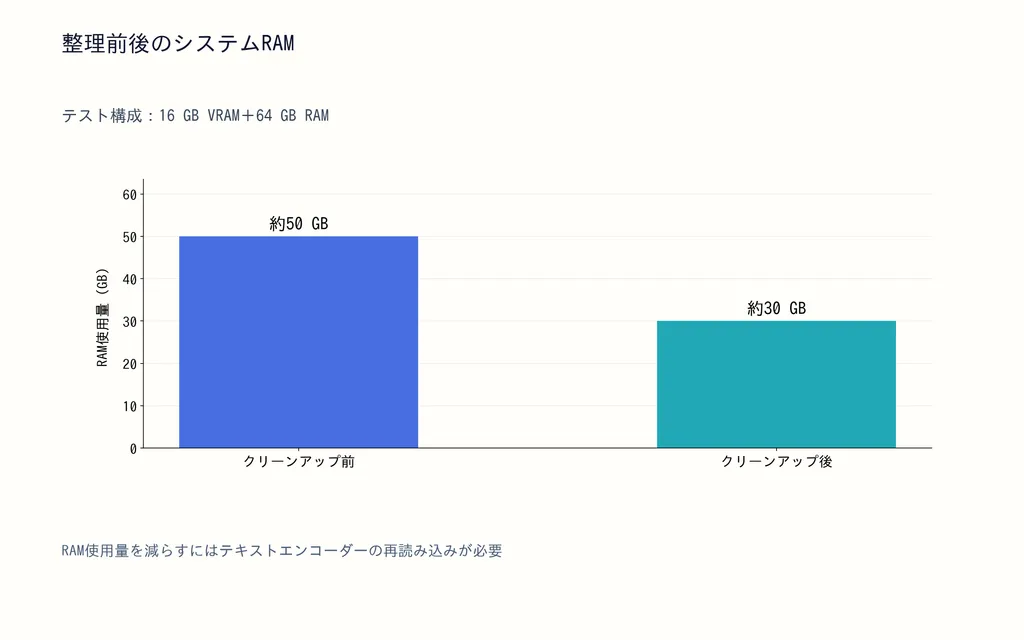
記録されたある16 GB VRAM+64 GB RAM構成では、整理前にシステムRAM使用量が約50 GBに達し、整理後は約30 GBに下がりましたが、テキストエンコーダーの再読み込みが必要になりました。
別のRTX 3060 12 GB+64 GB RAMのRef2V事例では、約0.35 MPの5秒動画を生成する際に、システムRAMをほぼ使い切りました。
これらは普遍的なベンチマークではありませんが、「H3が動く」と「H3で快適に反復できる」が違う理由を示しています。
MiniMax H3の音声の乱れと顔の一貫性の問題を解決する方法
H3のネイティブな音声・動画生成は大きな利点ですが、音声と同一性には個別の品質チェックが必要です。
H3の音声の乱れを調べる方法
繰り返し出るワークフローの疑問を調べても、音声の乱れについて検証済みの単一原因は見つかりませんでした。考えられる要因には、会話のタイミングの曖昧さ、不要な音楽指示、強いキャッシュ最適化、極端に少ないサンプリングステップがあります。
最も安全な診断手順は、基本ワークフローに戻り、誰がいつ話すかを定義し、音楽と環境音を分け、通常のサンプリング設定を復元した後、性能最適化を1つずつ再有効化することです。
参照解像度を上げても同一性を保証できない理由
詳細な同一性の事例では、Ref2VA、1344 × 768の出力、追加の高解像度顔参照、最大の参照詳細設定、最大20ステップを使っても、引いたショットや動きのあるショットで顔のぼやけや歪みが確認されました。
参照の詳細を増やすとH3により多くの同一性情報を与えられますが、顔の一貫性を必ず解決する方法として示すべきではありません。
15秒を超えるMiniMax H3動画の作成方法
H3の公式単一クリップワークフローの上限は15秒です。そのため長尺制作は、単に時間を伸ばすより、連続性の問題として扱う方が適切です。
動きと音声の文脈を連結する
有望な方法は次のとおりです。
クリップA → 動きと音声の状態を保持 → クリップB → 文脈を継続 → クリップC
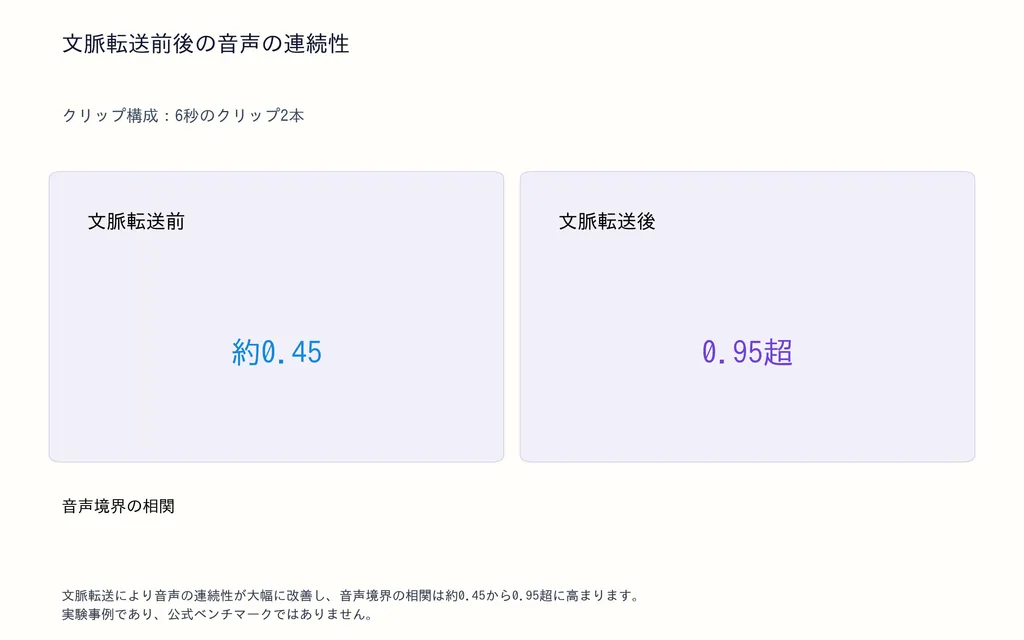
ある実験事例では、6秒のクリップ2本をクロスフェードなしで接続し、文脈転送後に音声境界の相関が約0.45から0.95超へ改善したと報告しています。
公式ベンチマークではありませんが、有用な制作原則を裏付けます。各生成で連続性をゼロから作り直させず、クリップ間で状態を保持しましょう。
MiniMax H3の1080pと2K:アップスケールかRegenerate-2Kか?
ローカル制作では、H3 Baseの生成と完全なH3 2Kパイプラインを区別しましょう。
H3 Baseは短辺768ピクセルの生成段階を中心にしており、MiniMaxの完全なアーキテクチャには、独立したH3-Regenerate-2K段階が含まれます。高解像度の細部を再構築する際に元の文脈を再利用します。ローカルのオープンなワークフローでは主にH3 Baseを利用できるため、従来型アップスケールは実用的な納品方法です。
アップスケーラーを使う場面
次の場合は従来型の動画アップスケールを選びます。
- 生成済みのフレームがすでに良好な場合。
- 予測可能な拡大が必要な場合。
- 納品速度が重要な場合。
- 追加の生成処理を望まない場合。
記録されたRTX 3090のある事例では、約14秒・1 MPのクリップを約40分で生成した後、RTXベースの超解像処理を適用しました。
Regenerate-2Kがより適している場面
文脈を考慮した再生成を選ぶのは、元のマルチモーダルな意図から細かな視覚情報を再構築することが、決定的な保持より重要な場合です。通常のピクセル拡大と混同すべきではなく、現時点の調査には、常に優れていると証明する管理されたローカルベンチマークはありません。
よくある質問
H3は12 GBのVRAMで動きますか?
はい。一部の12 GB構成では、量子化とオフロードによりH3を実行できます。ただしRAMが制約になることがあります。記録されたRTX 3060 12 GB・64 GB RAMのシステムでは、短いRef2V生成中にRAM使用量が上限近くになりました。ハードウェア、量子化、解像度、ノード構成によって結果は大きく変わります。
FL2VAとRef2VA:どちらを使うべきですか?
使い分けとして、T2V、I2V、開始・終了フレーム生成にはFL2VAを使います。一方、画像、動画、音声で同一性、動き、カメラ、スタイル、声を制御する場合はRef2VAを使います。マルチモーダル参照制御が不要なショットでは、FL2VAの方が通常は単純でメモリ効率も良好です。
H3の音声が意味不明になるのはなぜですか?
現時点で、検証済みの単一原因はありません。本ガイドの検討対象となったワークフロー事例では、少ないサンプリングステップ、曖昧な会話指示、不要な音楽、強いキャッシュ最適化が、いずれも音声の失敗と共に見られました。標準ワークフローから始め、音声指示を単純化し、最適化の変更を1つずつ戻してください。
Regenerate-2Kとアップスケーラー:どちらが優れていますか?
完成度の高いクリップには、より速く決定的に拡大できるアップスケーラーを使います。一方、文脈に沿った細部の再構築を優先する場合はRegenerate-2Kを使います。両者は別の問題を解決します。一方は既存の結果を拡大し、もう一方はMiniMaxのより広範な文脈対応再生成アーキテクチャの一部です。
結論
最も信頼できるMiniMax H3 ComfyUIワークフローは、単一のグラフではなく制作システムです。単純な作業はFL2VAへ振り分け、マルチモーダル制御が必要な場合だけRef2VAを使い、生成前に参照の役割を定義し、最終レンダリングの計算資源を使う前に低解像度でプレビューします。RAMとVRAMを併せて管理し、強い高速化を加える前にネイティブ音声を検証し、クリップ延長時には文脈を保持し、納品目標に応じてアップスケールか文脈対応2K再生成を選びます。こうすれば、デザイナーはより再現可能な形で、H3の実験から管理されたAI動画制作へ進めます。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao