什么是 MiniMax H3 Max?解读 Fal 更快的 H3
Vincent8 分钟阅读 ·
MiniMax H3 Max是 fal 基于开放权重的 MiniMax H3 视频模型进行后训练和推理优化的版本。fal 报告称,它能在不到三秒内生成五秒视频,吞吐量约为 MiniMax 官方 H3 端点的35 倍。关键在于,这是包含后训练和定制推理栈的整套系统结果,并不证明 H3 Max 检查点在所有 GPU 上都会快 35 倍。
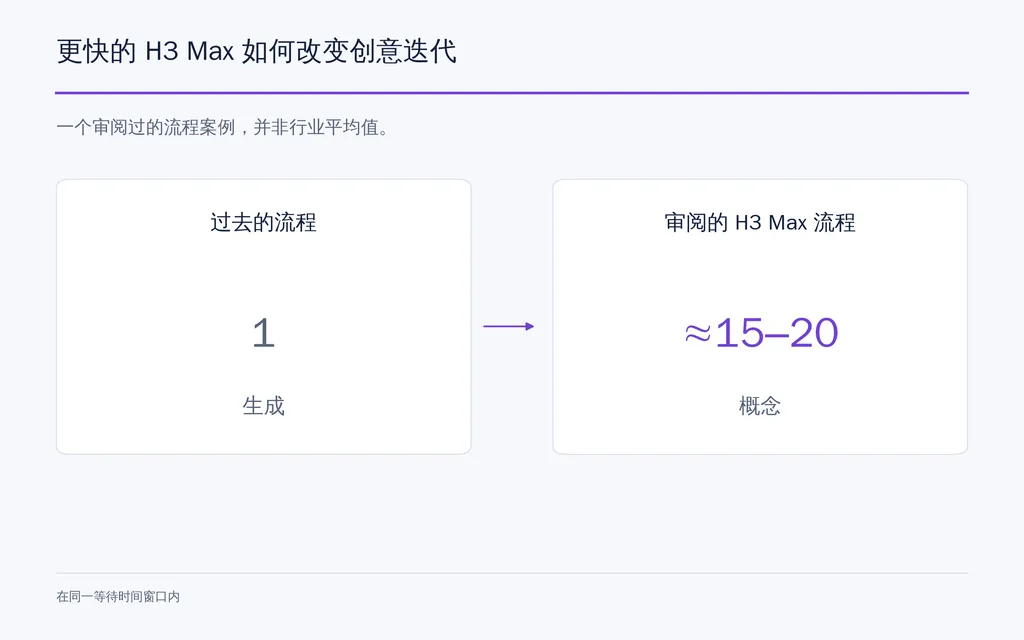
更大的变化在于工作流程。在一个审阅过的案例中,更快的生成速度把过去等待一次渲染的时间窗口,变成了约15–20 个概念变体。瓶颈从等待转向比较创意、保持一致性,以及选择值得最终渲染的概念。
这正是Virse发挥作用的地方。Virse 将 AI Agent 与无限画布结合,让设计师组织参考、连接素材、并行运行多个 Agent,并基于共享项目上下文和长期记忆协作。Virse帮助团队把快速生成转化为探索、比较和完善最强创意方向的结构化流程,而不是让 H3 Max 的速度只带来几十个互不相连的结果。 MiniMax H3、Seedance 2.5和Seedance 2.0现已上线 Virse,因此团队可以在同一创意工作流程中探索并比较多个领先的视频模型。
H3 Max 是什么,由谁开发?
H3 Max 以 MiniMax H3 为基础,但更准确的说法是fal 的 H3 衍生版本,而不是 MiniMax 另行发布的基础模型。
fal 如何改造 MiniMax H3
Fal 表示,它从开放权重的 H3 模型出发,使用新数据进一步后训练,重点改善提示词遵循度和视觉质量。模型开发与 fal 的推理优化工作同步进行,而不是先把检查点完成,再事后优化。
因此,最清晰的定义是:
H3 Max = 后训练后的 MiniMax H3 + fal 优化的推理系统。
H3 Max 只是一个 Turbo LoRA 吗?
现有证据不支持这种描述。
更广泛的 H3 生态已在使用减少步数、替代注意力实现、精度调整和 Turbo 类方法等加速手段。H3 Max 的范围更广,因为 fal 将模型层面的训练与运行时及服务部署优化结合起来。
H3 Max 为什么这么快?
理解 H3 Max 速度的最佳方式是模型与系统协同优化,而非某一个加速技巧。
后训练与推理协同开发
fal 表示,模型研究与推理工程在整个开发期间保持联动。目标不仅是最低延迟,还要在保留后训练带来的质量提升的同时,提高吞吐量。
这种区别很重要,因为通过降低精度或减少采样工作量来加速视频模型,也可能损害输出质量。fal 称,只有持续满足其内部偏好评估的优化才会被保留。
基础设施为何重要
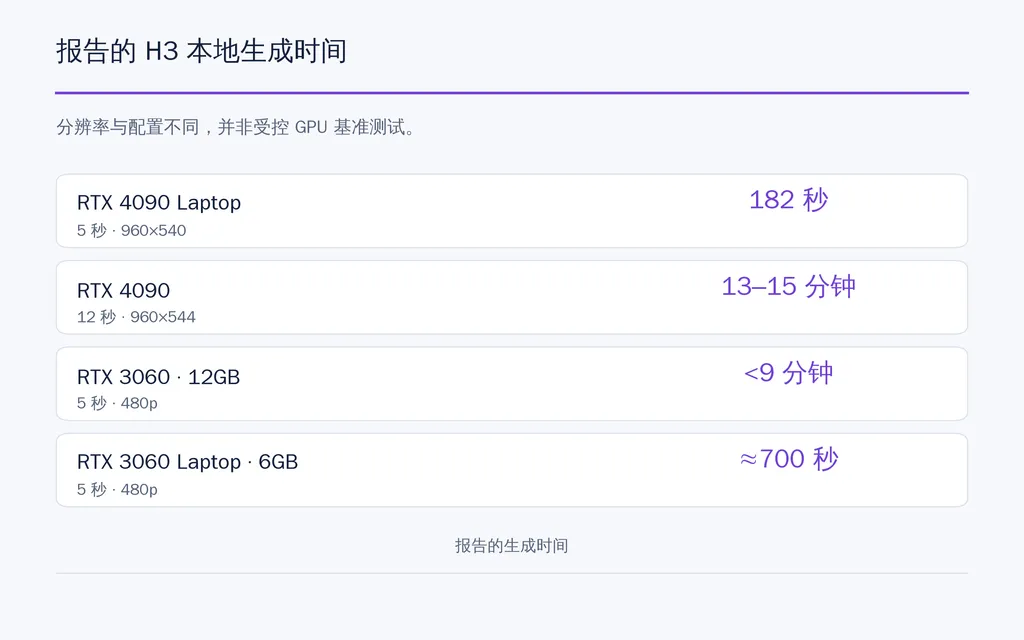
本地H3 结果显示,系统配置对性能的影响很大。
我们的审阅发现以下例子:
- 182 秒生成 5 秒的 960×540 视频,使用 4090 Laptop
- 13–15 分钟生成 12 秒的 960×544 视频,使用 RTX 4090
- 不到 9 分钟生成 5 秒的 480p 视频,使用 12GB RTX 3060
- 约 700 秒生成 5 秒的 480p 视频,使用 6GB 3060 Laptop
这些测试使用了不同的H3 工作流程,不应被视为受控 GPU 基准测试。其价值在于说明,端点速度与检查点速度不是可以互换的概念。
H3 Max“快 35 倍”究竟意味着什么?
fal 报告称,吞吐量约为MiniMax 官方 H3 端点的 35 倍,同时约三秒生成五秒视频。
35 倍不等于在 RTX 4090 上快 35 倍
吞吐量衡量系统在一段时间内能处理多少工作量,并不等同于每个独立请求实际经历的延迟。
更重要的是,这项比较包含后训练模型与 fal 的推理栈。现有证据并未展示 H3 和 H3 Max 在同一张 4090 上并排运行,且 H3 Max 对所有任务都快 35 倍。
对本地用户而言,正确理解是:fal 展示了一套大幅加速的 H3 制作系统,而非通用的消费级 GPU 35 倍加速。
H3 Max 真的快于实时吗?
在部分测试条件下是,但并非所有报告过的流程都始终如此。
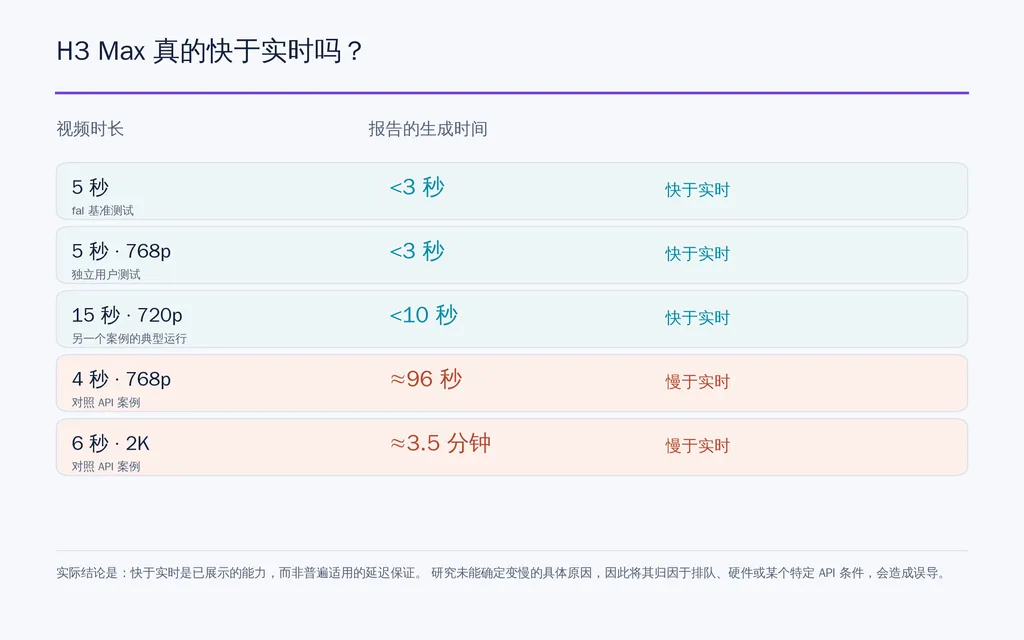
不到三秒生成五秒视频
fal 的核心基准结果是不到三秒生成五秒视频。我们研究中的另一个用户测试,对五秒 768p 片段报告了类似结果。
另一个案例在典型运行中,用不到 10 秒生成 15 秒的 720p 视频。这是一个有意义的门槛,因为生成完成得比观众看完结果还快。
为何有些 H3 Max 生成慢得多
我们的审阅还发现了一个形成对照的 API 案例:
输出 | 报告的生成时间 |
4 秒 768p 视频 | 约 96 秒 |
6 秒 2K 视频 | 约 3.5 分钟 |
研究未能确定变慢的具体原因,因此将其归因于排队、硬件或某个特定 API 条件,会造成误导。
实际结论是:快于实时是已展示的能力,而非普遍适用的延迟保证。
H3 Max 有哪些规格与能力?
Fal 目前通过文生视频和图生视频工作流程提供 H3 Max。其 API 文档列出480p 和 768p 原生生成选项,默认 768p,并支持文生视频的宽高比控制。图生视频路径可使用起始图像,并可选用结束图像实现首尾帧生成。
Fal 还表示,H3 Max 在后训练后保留了 H3 的统一多模态上下文,以及原生同步音视频能力。
对创意团队而言,H3 Max 不仅适合基于提示词的生成,也适用于图像动画化、分镜开发、镜头探索和可控的视觉序列。
H3 Max 如何改善 AI 视频工作流程?
H3 Max 最有用的指标可能是每分钟迭代次数,而不是每段片段的生成秒数。
从一次渲染到 15–20 个概念变体
我们研究中的一个工作流程报告称,其速度足以在过去等待一次生成的时间窗口内,探索约 15–20 个概念。
这让团队能在投入最终渲染前,测试镜头方向、动作、构图、灯光、节奏,以及对同一简报的不同诠释。
从设计角度看,这更像草绘,而非传统渲染。
最佳 H3 Max 草稿到成片工作流程
一个实用工作流程如下:
- 生成多个H3 Max 草稿
- 比较镜头、动作、时序与构图
- 快速淘汰薄弱方向
- 选出最强概念
- 只有在最终镜头需要额外质量时,才使用成本更高或速度更慢的模型
在我们审阅的制作模式中,有时会先用更快的模型确定创意方向,再将Seedance 和 Kling用于选定的关键镜头。
H3 Max 质量:速度会降低视频质量吗?
关于质量的证据,不如速度方面一致。
H3 Max 表现好的方面
fal 报告称,在其自身的人类偏好评估中,H3 Max 在整体质量、提示词理解和美学方面排名靠前。
在研究中的各个案例里,H3 Max 也展现了对动态场景、多次切镜指令、提示词遵循、音频和快速视觉探索的价值。
质量仍可能波动的方面
我们的审阅也发现,一些输出在人体结构、自然的人体动作,以及机械感行为方面存在问题。
这提示了一个实用区别:当快速视觉决策很重要时,H3 Max 尤其有吸引力;但对人体结构要求严格或表达高度细腻的关键镜头,在最终制作前比较模型仍可能有益。
H3 Max 与 H3:应该选哪个?
因素 | H3 | H3 Max |
模型 | 原始 H3 | fal 后训练的 H3 |
主要优势 | 开放模型的控制权 | 快速的托管迭代 |
本地工作流程 | 强 | 未核实可下载检查点 |
速度 | 本地通常需数分钟 | fal 优化测试中达到秒级 |
最佳用途 | 本地研究与定制 | 预可视化与快速探索 |
选择 H3,如果最看重本地控制、自定义优化或模型实验。
选择 H3 Max,如果主要瓶颈是等待生成,而且你希望采用针对迭代优化的托管工作流程。
H3 Max 与 FastH3:托管速度还是开放控制?
FastH3 从更开放的部署方向解决类似问题。
其开发团队报告称,单张 GPU 约 13 秒生成 15 秒的 768p 视频,并声称实现了14 倍加速。另一个报告过的 FastH3 配置得出了不同耗时,因此这些数字不应合并成一个通用基准。
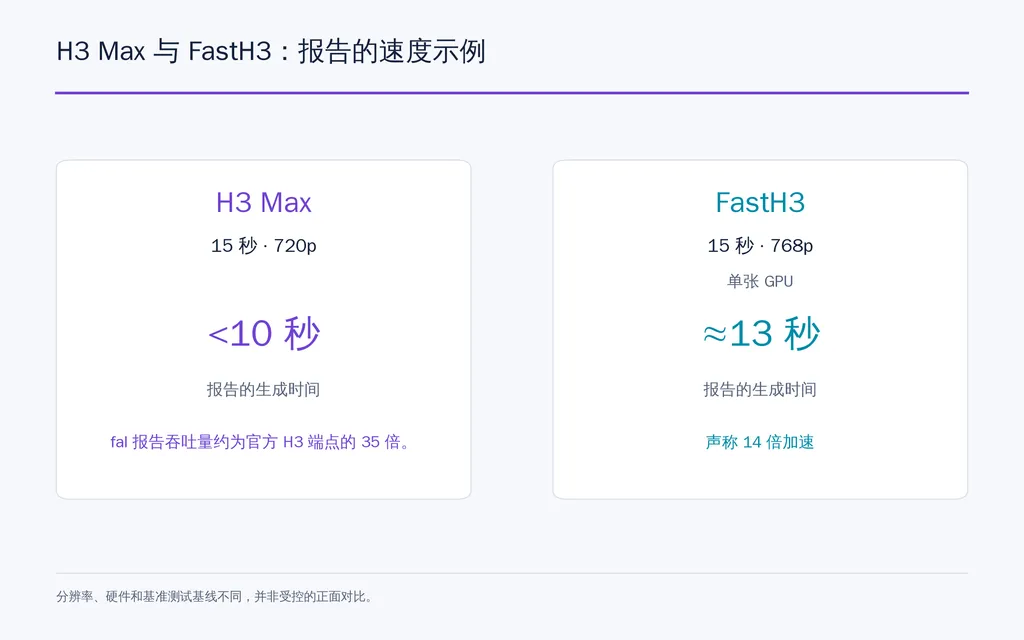
更好的比较方式是看策略:
H3 Max 优化托管体验。FastH3 强调加速与开放掌控。
优先考虑即时创意吞吐量的团队可能更倾向 H3 Max。优先考虑本地部署、隐私或推理栈控制权的开发者,可能更倾向 FastH3 等开放路线。
H3 Max 能在 RTX 4090 上本地运行吗?
截至发布时,fal 的H3 Max 托管文生视频与图生视频端点可以核实,但我们的审阅没有核实到 fal 官方可下载的 H3 Max 检查点。
即使可下载权重日后开放,也不应期待 4090 自动复现 fal 的托管基准结果。
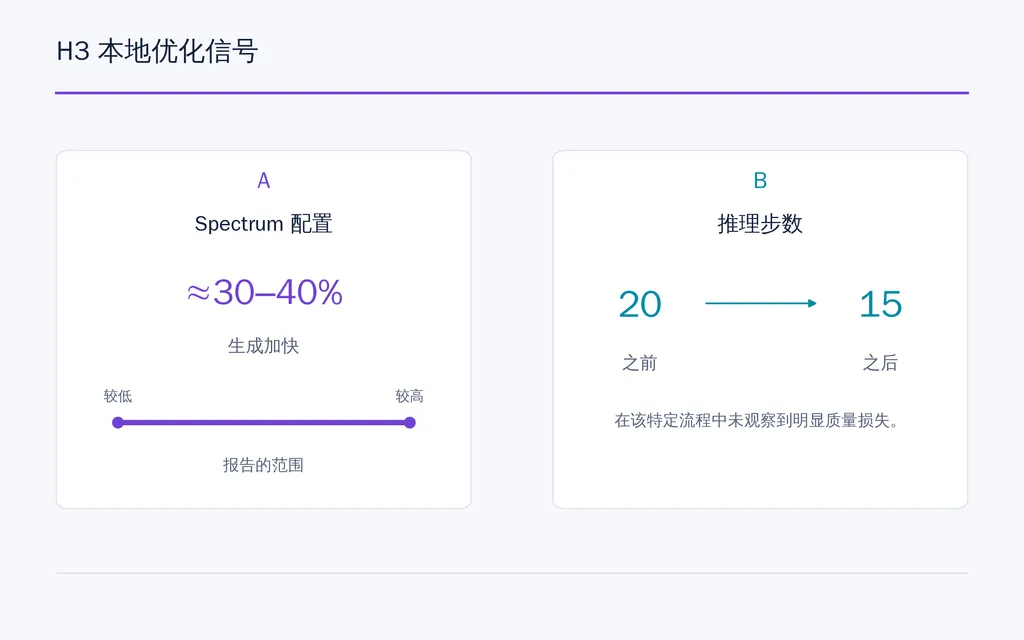
H3 本地速度会随显存、系统内存、精度、卸载、注意力后端、分辨率和步数而大幅变化。研究中有一种 Spectrum 配置报告生成加快约 30–40%;另一个流程将推理从 20 步降至 15 步,在那次特定测试中未见明显质量损失。
H3 Max 能实现实时 AI 视频吗?
H3 Max 让实时生成视频更有可能,但仅有峰值速度还不够。
连续生成流还需要可预测的延迟、一致的角色、稳定的环境、时间连贯性,以及持续的吞吐量。
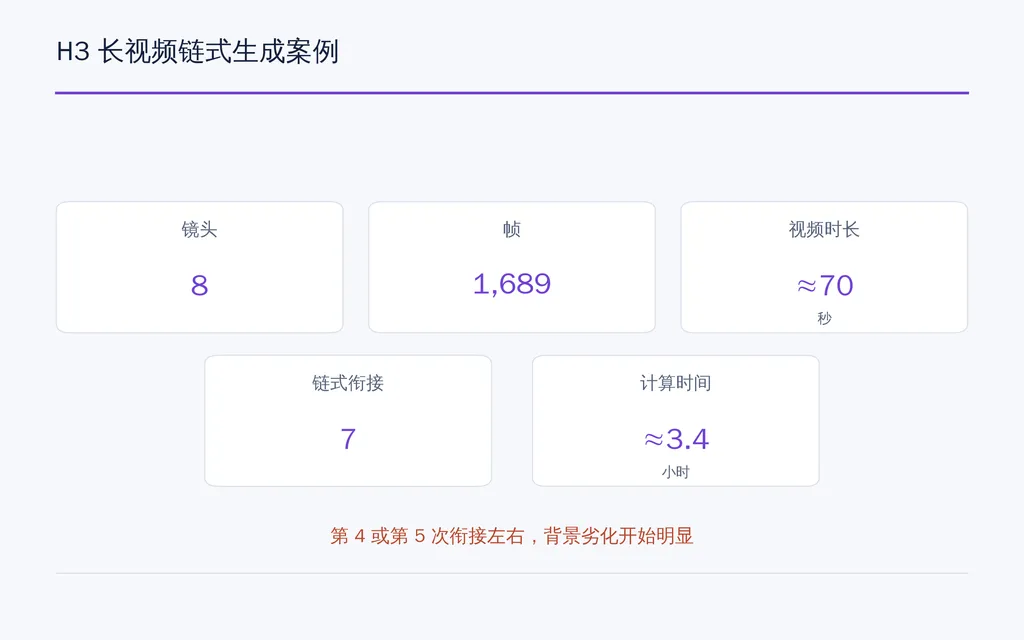
我们对更长的H3 工作流程进行研究时发现,一个链式实验生成了8 个镜头、1,689 帧、约 70 秒视频,进行了七次链式衔接,总耗时约 3.4 小时。背景劣化在第四或第五次衔接左右变得更明显。
这揭示了下一个瓶颈:生成变快之后,连贯性变得更加重要。
谁应该使用 H3 Max?
当创意迭代成为瓶颈时,H3 Max 最有用。
设计师可以探索视觉方向,导演可以测试镜头运动,广告团队可以制作多个概念,而分镜或预可视化流程可以在昂贵的最终生成前淘汰薄弱创意。
对于要求完全本地部署、高度可预测的实时延迟、深度检查点定制,或无需额外比较就必须保证人体结构准确的团队,它的适用性还不够明确。
因此,最强的用例并不是让 H3 Max 替代所有视频模型,而是在最终创意决策之前使用它,因为此时速度能带来最大的流程优势。
常见问题
H3 Max 是什么?
H3 Max 是 fal 后训练的 H3 变体与优化推理系统的组合。fal 报告称,它不到三秒就能生成五秒视频,吞吐量约为官方 H3 端点的 35 倍。这项速度说法适用于优化后的托管系统,并不证明仅检查点本身就能带来 35 倍加速。
H3 Max 真的快 35 倍吗?
fal 报告称,相比官方 H3 端点,吞吐量约为其 35 倍。我们的审阅也发现了快于实时的结果,但更慢的案例同样存在。因此,应将该数字理解为系统级吞吐量比较,而不是保证每个 H3 Max 请求或本地 GPU 配置都快 35 倍。
H3 Max 能在 4090 上运行吗?
我们目前的研究没有经过核实的 H3 Max 4090 基准测试。fal 最快的数字依赖其优化推理环境,因此仅本地权重不会自动复现这些结果。基础 H3 在 4090 级系统上的性能,会随分辨率、内存、卸载和软件配置显著变化。
H3 Max 与 FastH3:哪个更好?
如果优先考虑快速托管迭代,就使用 H3 Max。如果重视开放权重与本地控制,FastH3 更相关。FastH3 开发者报告,在一次测试中约 13 秒生成了 15 秒的 768p 片段,但硬件和基准条件不同,因此直接比较速度需要谨慎。
结论
H3 Max 的意义在于,它让 AI 视频从缓慢的批量渲染走向交互式创意迭代。不到三秒生成五秒视频的结果,以及约 35 倍吞吐量的说法,在技术上很突出;但更大的变化是流程:当团队能在选定方向前探索许多视觉方案时,生成式视频就成为创意决策工具,而不仅是最终渲染工具。H3 Max 在概念开发、预可视化、镜头测试、场面调度和快速草稿方面已很有吸引力,但本地性能、延迟一致性、对人体结构敏感的最终镜头,以及长视频连贯性仍需仔细评估。它目前最强的角色,是作为高速创意迭代层,帮助团队更快做出更好的最终决策。