
O que é MiniMax H3 Max? Entenda o H3 mais rápido da Fal
Vincent12 min de leitura ·
MiniMax H3 Max é a versão da fal do modelo de vídeo MiniMax H3 de pesos abertos, com pós-treinamento e inferência otimizada. A fal informa que ele pode gerar um vídeo de cinco segundos em menos de três segundos e oferecer aproximadamente 35× a vazão do endpoint H3 oficial da MiniMax. Trata-se de um resultado do sistema completo, com pós-treinamento e uma infraestrutura de inferência personalizada, não de uma prova de que um checkpoint H3 Max rodará 35× mais rápido em qualquer GPU.
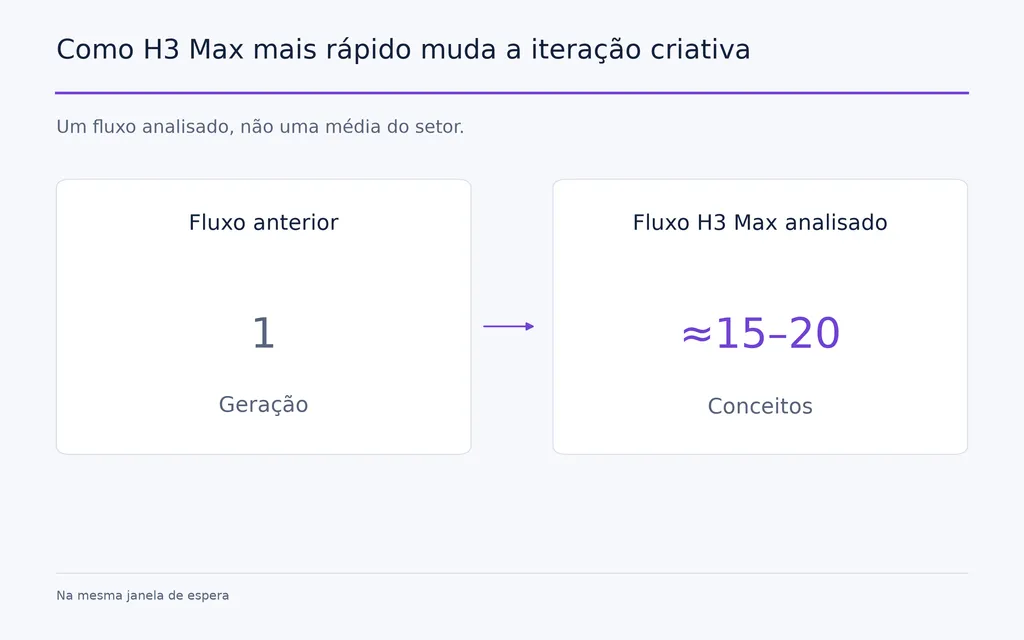
A mudança maior está no fluxo de trabalho. Em um caso analisado, a geração mais rápida transformou a antiga espera de uma renderização em aproximadamente 15–20 variações de conceitos. O gargalo deixa de ser a espera e passa a ser comparar ideias, manter a consistência e escolher qual conceito merece uma renderização final.
É aqui que Virse se torna útil. Virse combina agentes de IA com uma tela infinita, permitindo organizar referências, conectar recursos, executar vários agentes em paralelo e trabalhar com contexto compartilhado do projeto e memória de longo prazo. Em vez de transformar a velocidade do H3 Max em dezenas de resultados desconectados, Virse ajuda as equipes a transformar a geração rápida em um fluxo estruturado para explorar, comparar e refinar a direção criativa mais forte. MiniMax H3, Seedance 2.5 e Seedance 2.0 já estão disponíveis no Virse, permitindo explorar e comparar vários modelos de vídeo de ponta no mesmo fluxo criativo.
O que é H3 Max e quem o criou?
H3 Max parte do MiniMax H3, mas é mais preciso descrevê-lo como um derivado do H3 criado pela fal do que como um modelo fundacional independente lançado pela MiniMax.
Como a fal modificou o MiniMax H3
A Fal afirma que começou com o H3 de pesos abertos e realizou pós-treinamento adicional com novos dados, focando em aderência às instruções e qualidade visual. O modelo foi desenvolvido junto com a otimização de inferência da fal, em vez de ser tratado como um checkpoint concluído que seria otimizado depois.
A definição mais clara é, portanto:
H3 Max = MiniMax H3 com pós-treinamento + sistema de inferência otimizado da fal.
H3 Max é apenas um Turbo LoRA?
As evidências disponíveis não sustentam essa descrição.
O ecossistema mais amplo do H3 já usa aceleradores como redução de etapas, implementações alternativas de atenção, mudanças de precisão e métodos do tipo Turbo. H3 Max é mais abrangente porque a fal combina treinamento no nível do modelo com otimização da execução e do serviço.
Por que H3 Max é tão rápido?
A velocidade do H3 Max é melhor entendida como otimização conjunta do modelo e do sistema, não como um único truque de aceleração.
Pós-treinamento e inferência foram desenvolvidos juntos
A fal afirma que pesquisa do modelo e engenharia de inferência estiveram conectadas durante todo o desenvolvimento. A meta não era apenas minimizar a latência, mas aumentar a vazão preservando os ganhos de qualidade do pós-treinamento.
Essa distinção importa porque acelerar um modelo de vídeo reduzindo precisão ou trabalho de amostragem também pode diminuir a qualidade. A fal afirma que só manteve otimizações que continuavam satisfazendo suas avaliações internas de preferência.
Por que a infraestrutura importa
Os resultados locais do H3 mostram como a configuração do sistema afeta fortemente o desempenho.
Nossa análise encontrou exemplos como:
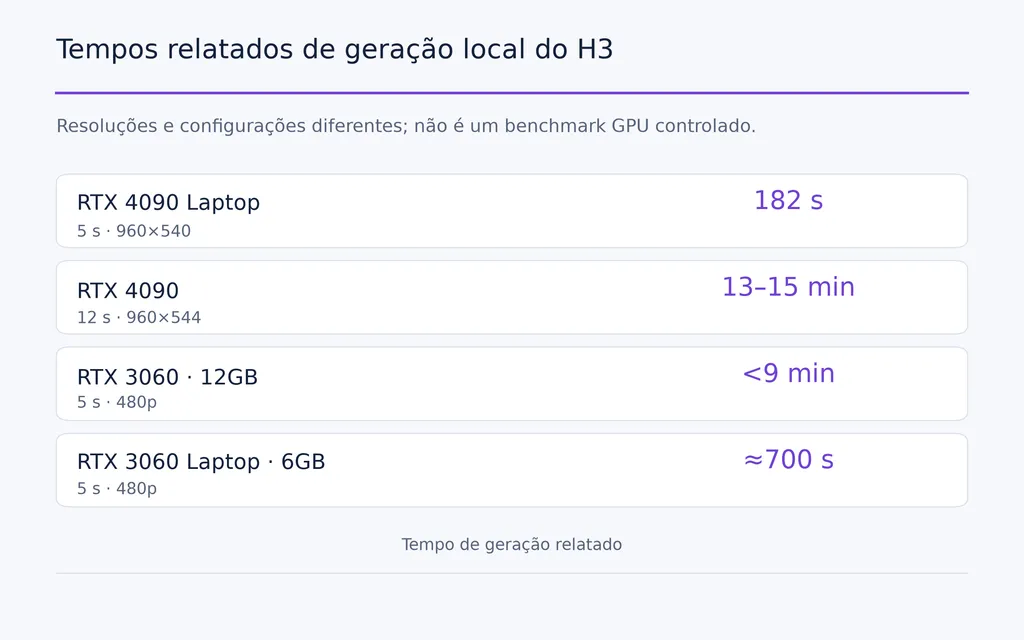
- 5 segundos em 960×540 em 182 segundos em uma 4090 Laptop
- 12 segundos em 960×544 em 13–15 minutos em uma RTX 4090
- 5 segundos em 480p em menos de 9 minutos em uma RTX 3060 de 12 GB
- 5 segundos em 480p em cerca de 700 segundos em uma 3060 Laptop de 6 GB
Esses testes usaram diferentes fluxos do H3 e não devem ser tratados como um benchmark controlado de GPU. Seu valor é mostrar por que velocidade do endpoint e velocidade do checkpoint não são conceitos intercambiáveis.
O que significa realmente H3 Max ser “35× mais rápido”?
A fal informa aproximadamente 35× a vazão do endpoint oficial do MiniMax H3, gerando um vídeo de cinco segundos em aproximadamente três segundos.
35× não significa 35× mais rápido em uma RTX 4090
Vazão mede quanto trabalho um sistema consegue processar ao longo do tempo. Não é a mesma coisa que a latência sentida por cada solicitação individual.
Mais importante, a comparação inclui o modelo com pós-treinamento e a infraestrutura de inferência da fal. As evidências atuais não mostram H3 e H3 Max lado a lado na mesma 4090, com H3 Max concluindo todas as tarefas 35× mais rápido.
Para usuários locais, a conclusão correta é: a fal demonstrou um sistema de produção baseado em H3 muito mais rápido, não uma aceleração universal de 35× em GPUs de consumo.
H3 Max é realmente mais rápido que o tempo real?
Sim em algumas condições testadas, mas não de forma consistente em todos os fluxos relatados.
Cinco segundos em menos de três segundos
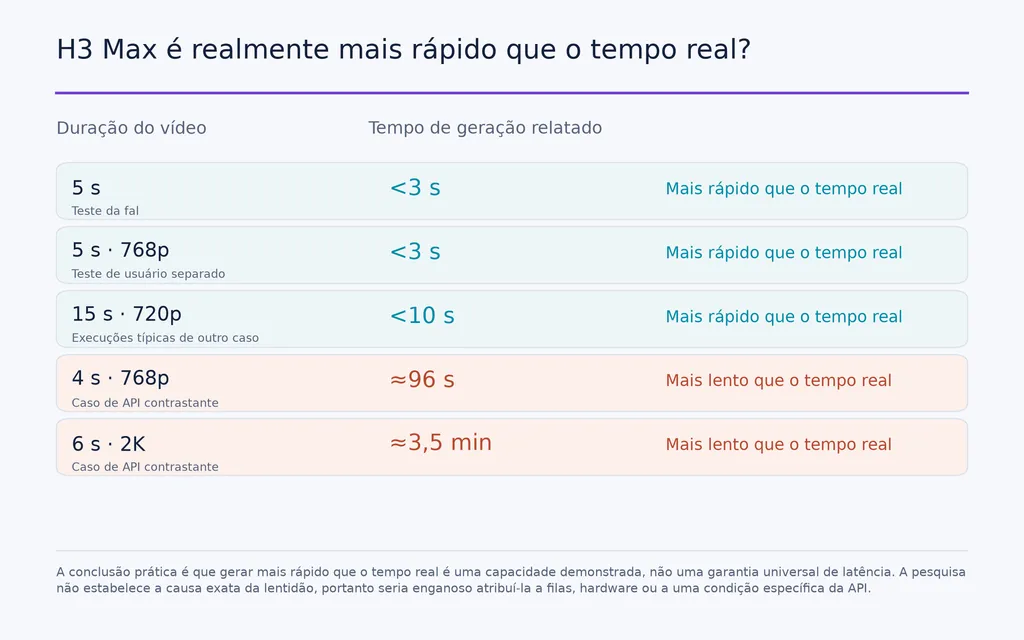
O principal benchmark da fal é um vídeo de cinco segundos gerado em menos de três segundos. Um teste separado de usuário em nossa pesquisa relatou resultado semelhante para um clipe de cinco segundos em 768p.
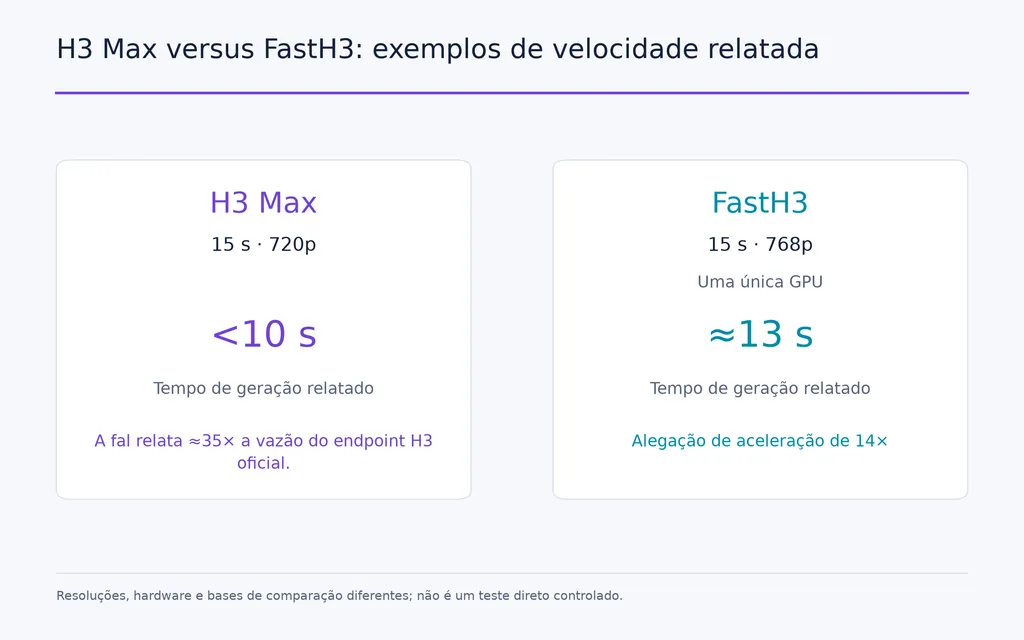
Outro caso gerou 15 segundos de vídeo em 720p em menos de 10 segundos nas execuções típicas. É um limite relevante porque a geração termina antes de o espectador terminar de assistir ao resultado.
Por que algumas gerações do H3 Max foram muito mais lentas
Nossa análise também encontrou um caso de API contrastante:
Saída | Tempo de geração relatado |
Vídeo de 4 segundos em 768p | Cerca de 96 segundos |
Vídeo de 6 segundos em 2K | Cerca de 3,5 minutos |
A pesquisa não estabelece a causa exata da lentidão, portanto seria enganoso atribuí-la a filas, hardware ou a uma condição específica da API.
A conclusão prática é que gerar mais rápido que o tempo real é uma capacidade demonstrada, não uma garantia universal de latência.
Quais são as especificações e capacidades do H3 Max?
A Fal oferece atualmente o H3 Max por fluxos de texto para vídeo e imagem para vídeo. A documentação da API lista opções de geração nativa em 480p e 768p, com 768p como padrão, e oferece controle de proporção no texto para vídeo. A rota de imagem para vídeo pode usar uma imagem inicial e, opcionalmente, uma final para geração do primeiro ao último quadro.
A Fal também afirma que, após o pós-treinamento, o H3 Max preserva o contexto multimodal unificado e as capacidades de áudio e vídeo sincronizados nativamente do H3.
Para equipes criativas, isso torna o H3 Max relevante não só para gerar a partir de instruções, mas também para animação de imagens, desenvolvimento de storyboards, exploração de planos e sequências visuais controladas.
Como H3 Max melhora os fluxos de vídeo com IA?
A métrica mais útil do H3 Max pode ser iterações por minuto, não segundos por clipe.
De uma renderização a 15–20 variações de conceitos
Um fluxo de nossa pesquisa relatou velocidade suficiente para explorar aproximadamente 15–20 conceitos durante a antiga janela de espera de uma única geração.
Isso permite testar direção de câmera, ação, composição, iluminação, ritmo e interpretações alternativas do mesmo briefing antes de se comprometer com a renderização final.
Do ponto de vista do design, isso se aproxima mais de esboçar do que de renderizar tradicionalmente.
O melhor fluxo do H3 Max do rascunho ao resultado final
Um fluxo prático é:
- Gerar vários rascunhos no H3 Max
- Comparar câmera, movimento, tempo e composição
- Descartar rapidamente direções fracas
- Selecionar o conceito mais forte
- Usar um modelo mais caro ou lento somente quando for necessária mais qualidade no plano final
Nos padrões de produção analisados, Seedance e Kling às vezes eram usados em planos de destaque selecionados depois que a direção criativa já estava estabelecida com um modelo mais rápido.
Qualidade do H3 Max: a velocidade reduz a qualidade do vídeo?
As evidências sobre qualidade são menos consistentes do que as de velocidade.
Onde H3 Max se sai bem
A fal relata que H3 Max ficou bem classificado em suas próprias avaliações de preferência humana em qualidade geral, compreensão das instruções e estética.
Nos casos de nossa pesquisa, H3 Max também mostrou valor para cenas dinâmicas, instruções com vários cortes, aderência às instruções, áudio e exploração visual rápida.
Onde a qualidade ainda pode variar
Nossa análise também encontrou preocupações com anatomia, movimento humano natural e comportamentos de aparência robótica em algumas saídas.
Isso sugere uma distinção prática: H3 Max é especialmente atraente quando decisões visuais rápidas importam, mas planos de destaque que exigem precisão anatômica ou grande sutileza ainda podem se beneficiar da comparação de modelos antes da produção final.
H3 Max versus H3: qual usar?
Fator | H3 | H3 Max |
Modelo | H3 original | H3 com pós-treinamento da fal |
Principal vantagem | Controle de modelo aberto | Iteração rápida hospedada |
Fluxo local | Forte | Checkpoint para download não verificado |
Velocidade | Frequentemente minutos em execução local | Segundos em testes otimizados da fal |
Melhor uso | Pesquisa local e personalização | Pré-visualização e exploração rápida |
Escolha H3 quando controle local, otimização personalizada ou experimentação do modelo forem o mais importante.
Escolha H3 Max quando o principal gargalo for esperar as gerações e você quiser um fluxo hospedado otimizado para iteração.
H3 Max versus FastH3: velocidade hospedada ou controle aberto?
FastH3 trata um problema parecido por uma abordagem de implantação mais aberta.
Sua equipe de desenvolvimento relatou 15 segundos de vídeo em 768p em cerca de 13 segundos em uma única GPU, junto com uma alegação de aceleração de 14×. Outra configuração relatada do FastH3 produziu tempos diferentes, portanto esses números não devem ser fundidos em um único benchmark universal.
A comparação melhor é estratégica:
H3 Max otimiza a experiência hospedada. FastH3 enfatiza o controle aberto com aceleração.
Equipes que priorizam vazão criativa imediata podem preferir H3 Max. Desenvolvedores que priorizam implantação local, privacidade ou controle da infraestrutura de inferência podem preferir uma alternativa aberta como FastH3.
H3 Max pode rodar localmente em uma RTX 4090?
Na publicação, os endpoints hospedados de texto para vídeo e imagem para vídeo do H3 Max da fal são verificáveis, mas nossa análise não verificou um checkpoint oficial do H3 Max disponibilizado pela fal para download.
Mesmo que pesos para download sejam disponibilizados, não se deve esperar que uma 4090 reproduza automaticamente o benchmark hospedado da fal.
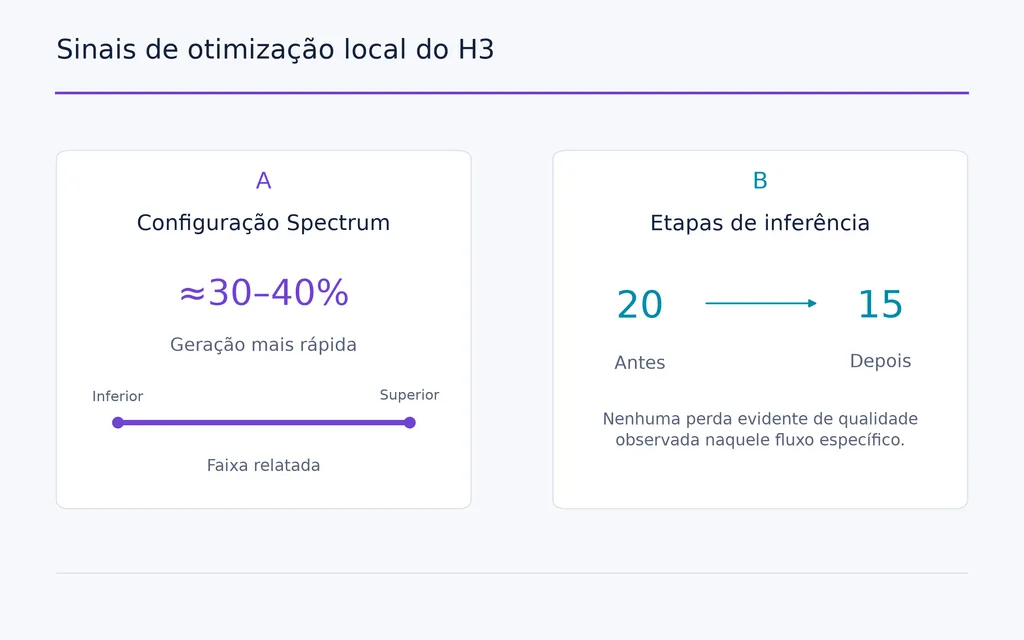
A velocidade local do H3 pode variar bastante com VRAM, RAM do sistema, precisão, descarregamento, backend de atenção, resolução e número de etapas. Em nossa pesquisa, uma configuração Spectrum relatou geração cerca de 30–40% mais rápida, enquanto outro fluxo reduziu a inferência de 20 para 15 etapas sem perda evidente de qualidade naquele teste específico.
H3 Max pode viabilizar vídeo de IA em tempo real?
H3 Max torna o vídeo generativo em tempo real mais plausível, mas a velocidade de pico sozinha não basta.
Um fluxo generativo contínuo também precisa de latência previsível, personagens consistentes, ambientes estáveis, coerência temporal e vazão sustentada.
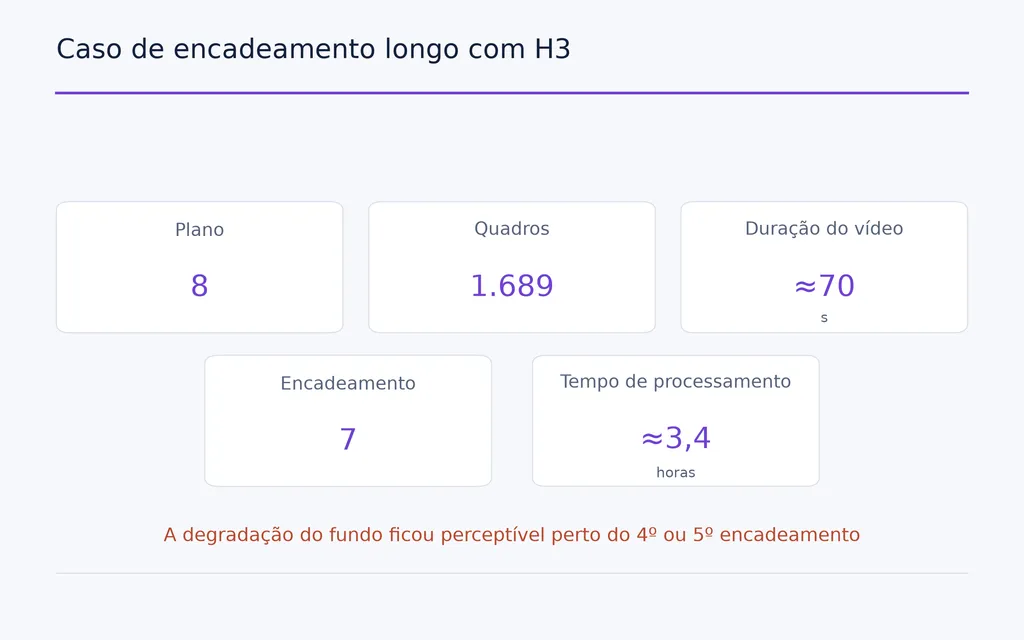
Nossa pesquisa sobre fluxos do H3 mais longos encontrou um experimento encadeado que produziu 8 planos, 1.689 quadros, cerca de 70 segundos de vídeo e sete etapas de encadeamento em aproximadamente 3,4 horas. A degradação do fundo ficou mais visível por volta do quarto ou quinto encadeamento.
Isso revela o próximo gargalo: quando a geração fica rápida, a continuidade se torna mais importante.
Quem deve usar H3 Max?
H3 Max é mais útil quando a iteração criativa é o gargalo.
Designers podem explorar direções visuais, diretores testar movimentos de câmera, equipes de publicidade produzir vários conceitos, e fluxos de storyboard ou pré-visualização descartar ideias fracas antes da geração final cara.
Sua adequação é menos clara para equipes que exigem implantação totalmente local, latência em tempo real altamente previsível, personalização profunda do checkpoint ou resultados anatomicamente exigentes sem comparação adicional.
O melhor uso, portanto, não é substituir todos os modelos de vídeo por H3 Max, mas usá-lo antes da decisão criativa final, quando a velocidade gera a maior vantagem de fluxo.
Perguntas frequentes
O que é H3 Max?
H3 Max é a variante H3 com pós-treinamento da fal combinada com um sistema de inferência otimizado. A fal relata um vídeo de cinco segundos em menos de três segundos e aproximadamente 35× a vazão do endpoint oficial H3. A alegação de velocidade se aplica ao sistema hospedado otimizado, não comprova aceleração de 35× apenas do checkpoint.
H3 Max é realmente 35× mais rápido?
A fal relata aproximadamente 35× a vazão do endpoint oficial H3. Nossa análise também encontrou resultados mais rápidos que o tempo real, mas há casos mais lentos. O número deve ser entendido como comparação de vazão do sistema, não como garantia de que toda solicitação H3 Max ou configuração local de GPU rodará 35× mais rápido.
H3 Max roda em uma 4090?
Não há um benchmark verificado de H3 Max na 4090 em nossa pesquisa atual. Os melhores números da fal dependem de seu ambiente de inferência otimizado, portanto pesos locais sozinhos não reproduziriam esses resultados automaticamente. O desempenho do H3 base em sistemas da classe 4090 varia bastante conforme resolução, memória, descarregamento e configuração de software.
H3 Max versus FastH3: qual é melhor?
Use H3 Max quando a prioridade for iterar rapidamente em um serviço hospedado. FastH3 é mais relevante quando importam pesos abertos e controle local. Os desenvolvedores do FastH3 relataram cerca de 13 segundos para um clipe de 15 segundos em 768p em um teste, mas hardware e condições diferem, exigindo cautela nas comparações diretas de velocidade.
Conclusão
H3 Max importa porque leva o vídeo de IA da renderização lenta em lote à iteração criativa interativa. O resultado de cinco segundos em menos de três e a alegação de aproximadamente 35× de vazão impressionam tecnicamente, mas a mudança maior está no fluxo: quando equipes exploram muitas direções visuais antes de escolher uma, o vídeo generativo vira ferramenta de decisão criativa, não apenas de renderização final. H3 Max já é atraente para desenvolver conceitos, pré-visualizar, testar câmera, planejar a movimentação em cena e criar rascunhos rápidos, enquanto desempenho local, consistência da latência, planos finais sensíveis à anatomia e continuidade de formato longo ainda exigem avaliação cuidadosa. Seu papel mais forte hoje é o de uma camada de iteração criativa em alta velocidade que ajuda as equipes a chegar mais rápido a decisões finais melhores.
Mais do blogue da Virse
Produto
GPT Image 2.5 Resolution Explained: Can It Generate True 4K Images?
9 de outubro de 2026 by Yifan Zhao
Produto
GPT Image 2.5 Quality Settings Explained: Low vs Medium vs High vs XHigh vs Max
9 de outubro de 2026 by Yifan Zhao
Produto
What Is Product Design in 2026? What Product Designers Actually Do
21 de setembro de 2026 by Vincent