
¿Qué es MiniMax H3 Max? Así funciona el H3 más rápido de Fal
Vincent12 min de lectura ·
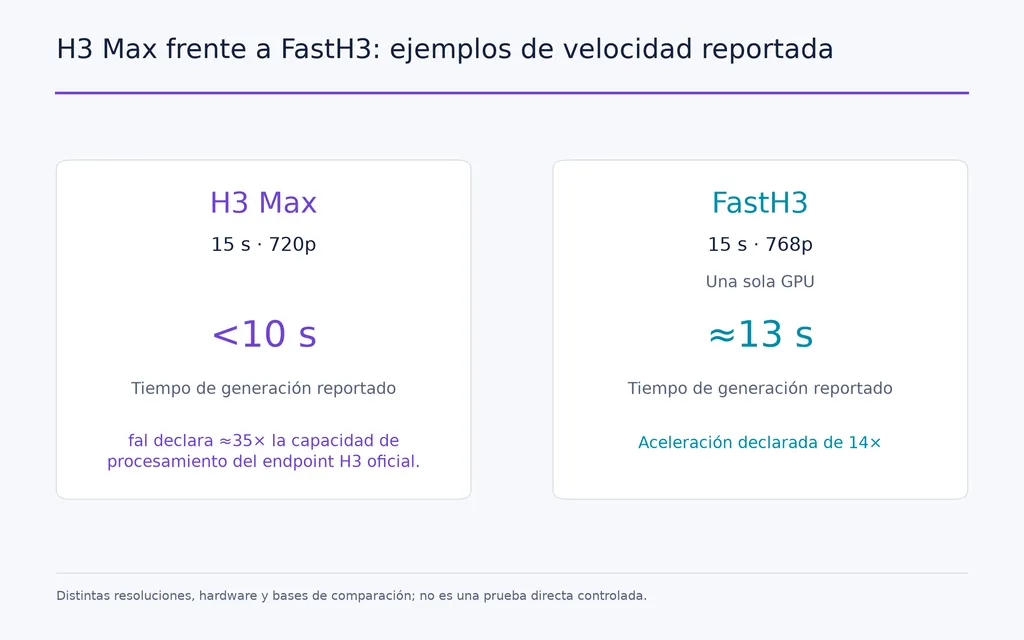
MiniMax H3 Max es la versión de fal del modelo de vídeo MiniMax H3 de pesos abiertos, con posentrenamiento e inferencia optimizada. fal afirma que puede generar un vídeo de cinco segundos en menos de tres segundos y ofrecer aproximadamente 35× la capacidad de procesamiento del endpoint oficial H3 de MiniMax. Es un resultado del sistema completo, que incluye posentrenamiento y una infraestructura de inferencia personalizada, no una prueba de que un punto de control H3 Max funcione 35× más rápido en cualquier GPU.
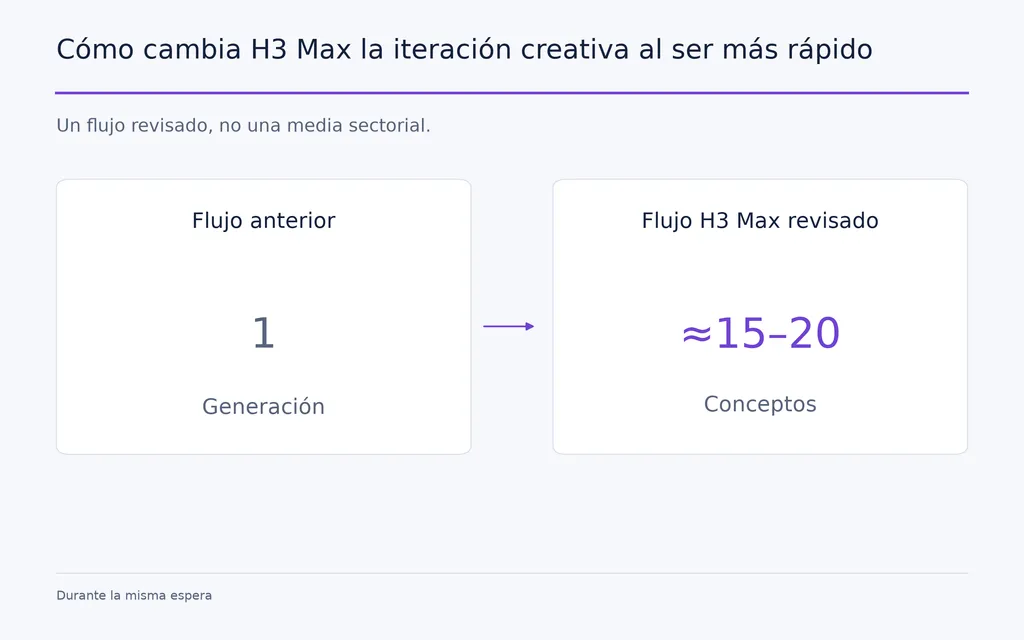
El mayor cambio está en el flujo de trabajo. En un caso revisado, la generación más rápida convirtió la antigua espera de un renderizado en aproximadamente 15–20 variaciones de conceptos. El cuello de botella pasa de esperar a comparar ideas, mantener la consistencia y elegir qué concepto merece un renderizado final.
Aquí es donde Virse resulta útil. Virse combina agentes de IA con un lienzo infinito para organizar referencias, conectar recursos, ejecutar varios agentes en paralelo y trabajar con contexto compartido del proyecto y memoria a largo plazo. En lugar de convertir la velocidad de H3 Max en decenas de resultados desconectados, Virse ayuda a convertir la generación rápida en un flujo estructurado para explorar, comparar y refinar la dirección creativa más sólida. MiniMax H3, Seedance 2.5 y Seedance 2.0 ya están disponibles en Virse, por lo que los equipos pueden explorar y comparar varios modelos de vídeo líderes en el mismo flujo creativo.
¿Qué es H3 Max y quién lo creó?
H3 Max parte de MiniMax H3, pero resulta más preciso describirlo como un derivado de H3 creado por fal que como un modelo fundacional independiente publicado por MiniMax.
Cómo modificó fal MiniMax H3
Fal dice que partió del modelo H3 de pesos abiertos y realizó posentrenamiento adicional con nuevos datos, centrado en seguir las instrucciones y mejorar la calidad visual. El modelo se desarrolló junto con la optimización de inferencia de fal, en vez de tratarlo como un punto de control terminado que se optimizaría después.
La definición más clara es, por tanto:
H3 Max = MiniMax H3 con posentrenamiento + sistema de inferencia optimizado de fal.
¿Es H3 Max simplemente un Turbo LoRA?
La evidencia disponible no respalda esa descripción.
El ecosistema de H3 ya usa aceleradores como menos pasos, implementaciones alternativas de atención, cambios de precisión y métodos de tipo Turbo. H3 Max abarca más porque fal combina entrenamiento del modelo con optimización de ejecución y servicio.
¿Por qué es H3 Max tan rápido?
La velocidad de H3 Max se entiende mejor como optimización conjunta del modelo y el sistema, no como un único truco de aceleración.
El posentrenamiento y la inferencia se desarrollaron juntos
fal afirma que la investigación del modelo y la ingeniería de inferencia estuvieron conectadas durante todo el desarrollo. El objetivo no era solo minimizar la latencia, sino aumentar la capacidad de procesamiento manteniendo las mejoras de calidad del posentrenamiento.
Esta distinción importa porque acelerar un modelo de vídeo reduciendo precisión o trabajo de muestreo también puede bajar la calidad. fal afirma que solo conservó optimizaciones que seguían superando sus evaluaciones internas de preferencias.
Por qué importa la infraestructura
Los resultados locales de H3 muestran cuánto influye la configuración del sistema en el rendimiento.
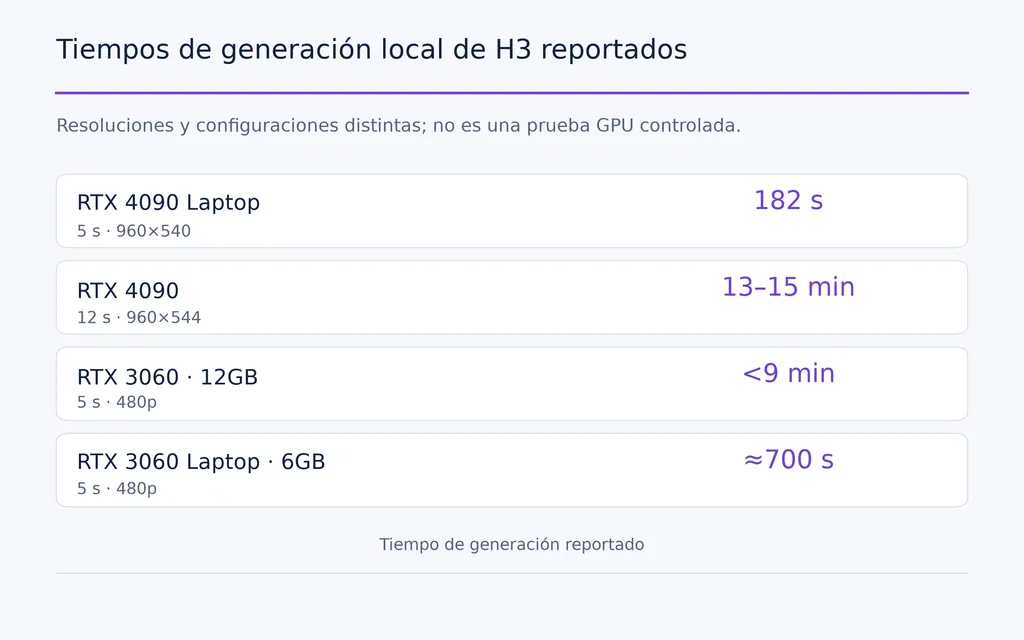
Nuestra revisión encontró ejemplos como:
- 5 segundos a 960×540 en 182 segundos en una 4090 Laptop
- 12 segundos a 960×544 en 13–15 minutos en una RTX 4090
- 5 segundos a 480p en menos de 9 minutos en una RTX 3060 de 12 GB
- 5 segundos a 480p en unos 700 segundos en una 3060 Laptop de 6 GB
Estas pruebas usaron diferentes flujos de H3 y no deben tratarse como una comparación controlada de GPU. Su valor está en mostrar por qué la velocidad del endpoint y la del punto de control no son conceptos intercambiables.
¿Qué significa realmente que H3 Max sea «35× más rápido»?
fal declara aproximadamente 35× la capacidad de procesamiento del endpoint oficial de MiniMax H3, generando un vídeo de cinco segundos en unos tres segundos.
35× no significa 35× más rápido en una RTX 4090
La capacidad de procesamiento mide cuánto trabajo puede procesar un sistema a lo largo del tiempo. No equivale a la latencia que experimentará cada petición individual.
La comparación incluye, sobre todo, el modelo con posentrenamiento y la infraestructura de inferencia de fal. La evidencia actual no muestra H3 y H3 Max ejecutándose en paralelo en la misma 4090 con H3 Max terminando cada tarea 35× más rápido.
Para usuarios locales, la conclusión correcta es: fal ha demostrado un sistema de producción basado en H3 mucho más rápido, no una aceleración universal de 35× en GPU de consumo.
¿Es H3 Max realmente más rápido que el tiempo real?
Sí en algunas condiciones probadas, pero no de forma constante en todos los flujos reportados.
Cinco segundos en menos de tres segundos
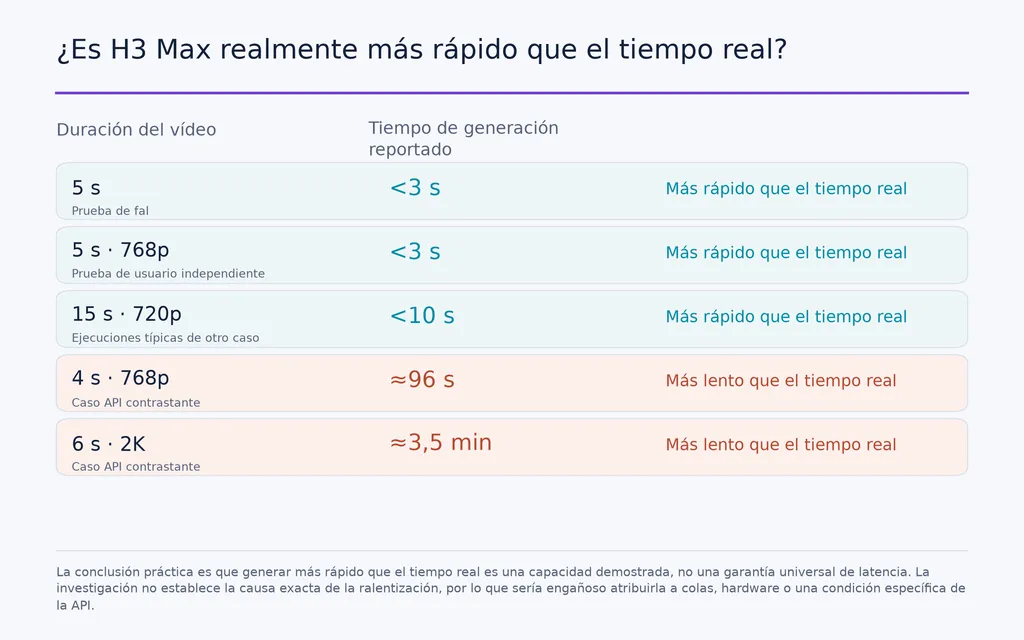
La prueba principal de fal es un vídeo de cinco segundos generado en menos de tres segundos. Otra prueba de usuario de nuestra investigación reportó un resultado parecido para un clip de cinco segundos a 768p.
Otro caso generó 15 segundos de vídeo a 720p en menos de 10 segundos en ejecuciones típicas. Es un umbral relevante porque la generación termina antes de que el espectador acabe de ver el resultado.
Por qué algunas generaciones de H3 Max fueron mucho más lentas
También encontramos un caso de API que contrasta con los anteriores:
Resultado | Tiempo de generación reportado |
Vídeo de 4 segundos a 768p | Unos 96 segundos |
Vídeo de 6 segundos a 2K | Unos 3,5 minutos |
La investigación no establece la causa exacta de la ralentización, por lo que sería engañoso atribuirla a colas, hardware o una condición específica de la API.
La conclusión práctica es que generar más rápido que el tiempo real es una capacidad demostrada, no una garantía universal de latencia.
¿Cuáles son las especificaciones y capacidades de H3 Max?
Fal ofrece actualmente H3 Max mediante flujos de texto a vídeo e imagen a vídeo. Su documentación de API enumera opciones de generación nativa a 480p y 768p, con 768p como valor predeterminado, y permite controlar la relación de aspecto en texto a vídeo. La ruta de imagen a vídeo puede usar una imagen inicial y, opcionalmente, una final para generación entre el primer y el último fotograma.
Fal también afirma que H3 Max conserva tras el posentrenamiento el contexto multimodal unificado de H3 y sus capacidades de audio y vídeo sincronizados de forma nativa.
Para los equipos creativos, esto hace que H3 Max sirva no solo para generar con instrucciones, sino también para animar imágenes, desarrollar guiones gráficos, explorar planos y crear secuencias visuales controladas.
¿Cómo mejora H3 Max los flujos de vídeo con IA?
La métrica más útil de H3 Max puede ser las iteraciones por minuto, no los segundos por clip.
De un renderizado a 15–20 variaciones de conceptos
Un flujo de nuestra investigación reportó velocidad suficiente para explorar aproximadamente 15–20 conceptos durante la antigua espera de una sola generación.
Así los equipos pueden probar dirección de cámara, acción, composición, iluminación, ritmo e interpretaciones alternativas del mismo brief antes de comprometerse con el renderizado final.
Desde la perspectiva del diseño, se parece más a dibujar bocetos que al renderizado tradicional.
El mejor flujo de H3 Max del borrador al resultado final
Un flujo práctico consiste en:
- Generar varios borradores con H3 Max
- Comparar cámara, movimiento, tiempos y composición
- Descartar rápidamente las direcciones débiles
- Seleccionar el concepto más sólido
- Usar un modelo más caro o lento solo cuando se necesite más calidad en el plano final
En los patrones de producción revisados, Seedance y Kling se usaban a veces para determinados planos protagonistas una vez definida la dirección creativa con un modelo más rápido.
Calidad de H3 Max: ¿reduce la velocidad la calidad del vídeo?
La evidencia sobre calidad es menos uniforme que la relativa a velocidad.
Dónde funciona bien H3 Max
fal afirma que H3 Max obtuvo posiciones destacadas en sus propias evaluaciones de preferencias humanas en calidad general, comprensión de instrucciones y estética.
En los casos de nuestra investigación, H3 Max también mostró utilidad para escenas dinámicas, instrucciones con varios cortes, seguimiento de instrucciones, audio y exploración visual rápida.
Dónde puede seguir variando la calidad
También encontramos dudas sobre anatomía, movimiento humano natural y comportamientos de aspecto robótico en algunos resultados.
Esto sugiere una distinción práctica: H3 Max resulta especialmente atractivo cuando importa decidir visualmente con rapidez, pero los planos protagonistas que exigen precisión anatómica o gran sutileza pueden beneficiarse de comparar modelos antes de la producción final.
H3 Max frente a H3: ¿cuál debes usar?
Factor | H3 | H3 Max |
Modelo | H3 original | H3 con posentrenamiento de fal |
Fortaleza principal | Control de un modelo abierto | Iteración alojada rápida |
Flujo local | Sólido | Punto de control descargable no verificado |
Velocidad | A menudo minutos en local | Segundos en pruebas optimizadas de fal |
Mejor uso | Investigación local y personalización | Previsualización y exploración rápida |
Elige H3 cuando lo más importante sea el control local, la optimización personalizada o experimentar con el modelo.
Elige H3 Max cuando el principal cuello de botella sea esperar las generaciones y quieras un flujo alojado optimizado para iterar.
H3 Max frente a FastH3: ¿velocidad alojada o control abierto?
FastH3 aborda un problema parecido desde un enfoque de despliegue más abierto.
Su equipo de desarrollo reportó 15 segundos de vídeo a 768p en unos 13 segundos en una sola GPU, junto con una aceleración declarada de 14×. Otra configuración de FastH3 reportó tiempos distintos, así que no deben mezclarse estos números en una única referencia universal.
La mejor comparación es estratégica:
H3 Max optimiza la experiencia alojada. FastH3 destaca el control abierto con aceleración.
Los equipos que priorizan capacidad creativa inmediata pueden preferir H3 Max. Los desarrolladores que priorizan despliegue local, privacidad o control de la infraestructura de inferencia pueden preferir una vía abierta como FastH3.
¿Puede ejecutarse H3 Max localmente en una RTX 4090?
En el momento de publicación, los endpoints alojados de H3 Max de texto a vídeo e imagen a vídeo de fal son verificables, pero nuestra revisión no verificó un punto de control H3 Max oficial descargable de fal.
Aunque se publiquen pesos descargables, no debe esperarse que una 4090 reproduzca automáticamente el rendimiento alojado de fal.
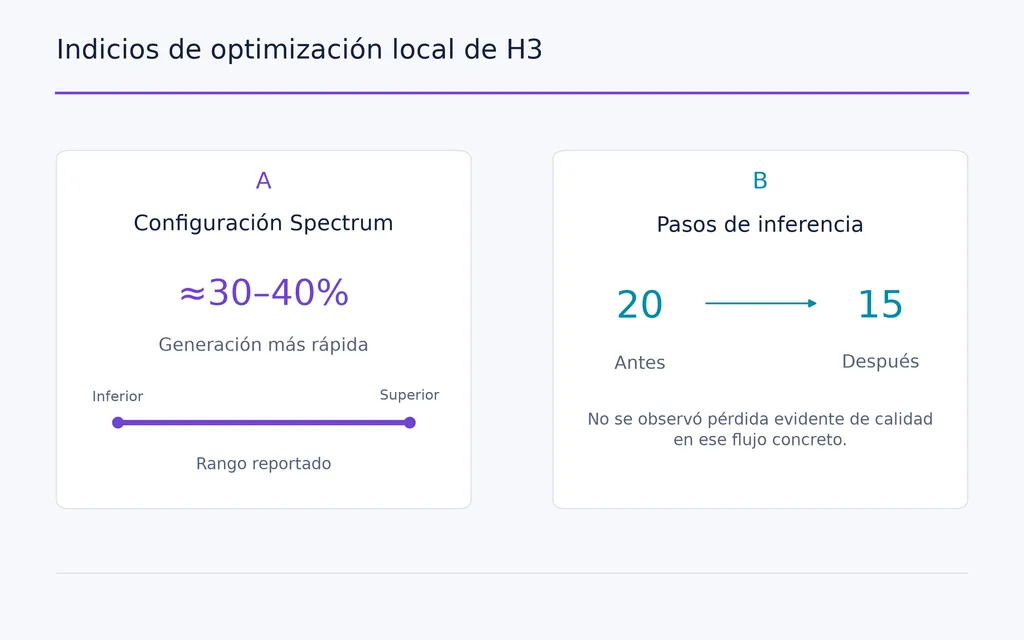
La velocidad local de H3 puede variar mucho con la VRAM, RAM del sistema, precisión, descarga de memoria, backend de atención, resolución y número de pasos. En nuestra investigación, una configuración Spectrum reportó una generación aproximadamente un 30–40% más rápida, mientras otro flujo redujo la inferencia de 20 a 15 pasos sin una pérdida evidente de calidad en esa prueba concreta.
¿Puede H3 Max permitir vídeo con IA en tiempo real?
H3 Max hace más plausible el vídeo generativo en tiempo real, pero la velocidad máxima por sí sola no basta.
Un flujo generativo continuo también necesita latencia predecible, personajes consistentes, entornos estables, coherencia temporal y capacidad de procesamiento sostenida.
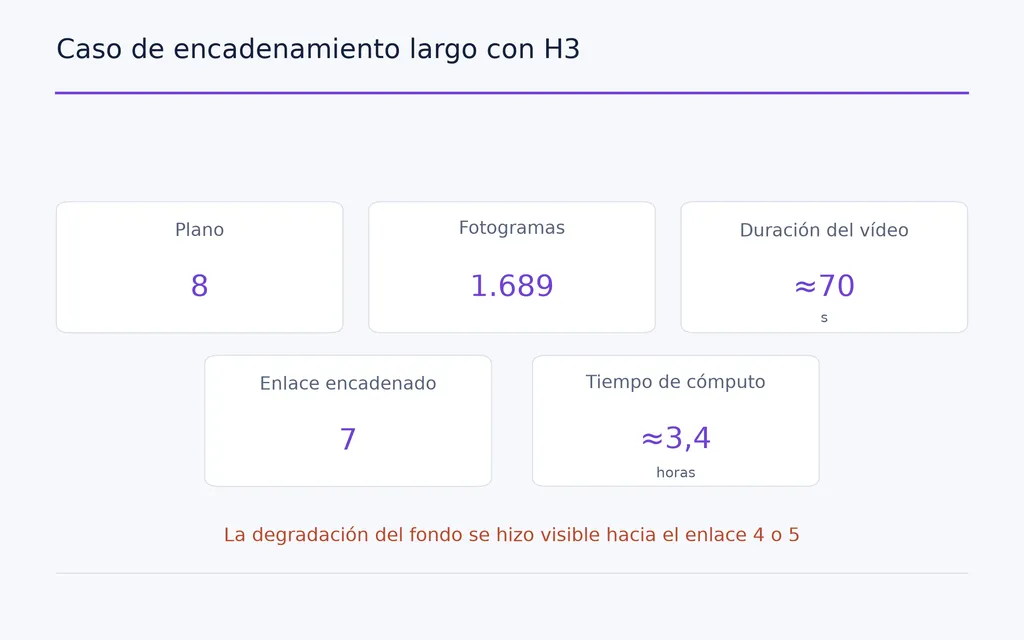
Nuestra investigación de flujos de H3 más largos encontró un experimento encadenado que produjo 8 planos, 1.689 fotogramas, unos 70 segundos de vídeo y siete enlaces en unas 3,4 horas. La degradación del fondo se volvió más visible hacia el cuarto o quinto enlace.
Esto revela el siguiente cuello de botella: cuando la generación se acelera, la continuidad cobra más importancia.
¿Quién debería usar H3 Max?
H3 Max resulta más útil cuando la iteración creativa es el cuello de botella.
Los diseñadores pueden explorar direcciones visuales, los directores probar movimientos de cámara, los equipos publicitarios producir varios conceptos y los flujos de guion gráfico o previsualización descartar ideas débiles antes de una generación final cara.
Es menos claro que encaje en equipos que necesitan despliegue totalmente local, latencia en tiempo real muy predecible, personalización profunda del punto de control o resultados anatómicamente exigentes sin comparaciones adicionales.
Por tanto, su mejor uso no es sustituir todos los modelos de vídeo por H3 Max, sino emplearlo antes de la decisión creativa final, donde la velocidad aporta la mayor ventaja al flujo.
Preguntas frecuentes
¿Qué es H3 Max?
H3 Max es la variante H3 con posentrenamiento de fal combinada con un sistema de inferencia optimizado. fal reporta un vídeo de cinco segundos en menos de tres segundos y unas 35× la capacidad de procesamiento del endpoint oficial H3. La afirmación se aplica al sistema alojado optimizado, no demuestra una aceleración de 35× solo del punto de control.
¿Es H3 Max realmente 35× más rápido?
fal reporta unas 35× la capacidad de procesamiento del endpoint oficial H3. Nuestra revisión también encontró resultados más rápidos que el tiempo real, pero existen casos más lentos. Debe entenderse como una comparación de capacidad del sistema, no como garantía de que toda petición H3 Max o configuración GPU local funcione 35× más rápido.
¿Puede H3 Max funcionar en una 4090?
En nuestra investigación actual no hay una prueba verificada de H3 Max en 4090. Los mejores números de fal dependen de su entorno de inferencia optimizado, por lo que los pesos locales por sí solos no reproducirían automáticamente esos resultados. El rendimiento del H3 base en sistemas de clase 4090 varía mucho según resolución, memoria, descarga y configuración del software.
H3 Max frente a FastH3: ¿cuál es mejor?
Usa H3 Max cuando la prioridad sea iterar rápidamente en un servicio alojado. FastH3 es más relevante cuando importan los pesos abiertos y el control local. Sus desarrolladores reportaron unos 13 segundos para un clip de 15 segundos a 768p en una prueba, pero el hardware y las condiciones difieren, de modo que las comparaciones directas de velocidad exigen cautela.
Conclusión
H3 Max importa porque desplaza el vídeo con IA del renderizado lento por lotes hacia la iteración creativa interactiva. El resultado de cinco segundos en menos de tres y la afirmación de unas 35× de capacidad son técnicamente impresionantes, pero el cambio mayor es el flujo: cuando se exploran muchas direcciones visuales antes de elegir una, el vídeo generativo pasa a ser una herramienta de decisión creativa, no solo de renderizado final. H3 Max ya resulta atractivo para desarrollar conceptos, previsualizar, probar cámaras, planificar la puesta en escena y crear borradores rápidos, mientras el rendimiento local, la regularidad de la latencia, los planos finales sensibles a la anatomía y la continuidad de larga duración aún requieren una evaluación cuidadosa. Su papel más sólido hoy es el de una capa de iteración creativa de alta velocidad que ayuda a tomar mejores decisiones finales con mayor rapidez.
Más del blog de Virse
Producto
GPT Image 2.5 Resolution Explained: Can It Generate True 4K Images?
9 de octubre de 2026 by Yifan Zhao
Producto
GPT Image 2.5 Quality Settings Explained: Low vs Medium vs High vs XHigh vs Max
9 de octubre de 2026 by Yifan Zhao
Producto
What Is Product Design in 2026? What Product Designers Actually Do
21 de septiembre de 2026 by Vincent