MiniMax H3 Max 评测:实测速度、质量、价格与 AI 视频工作流
 Yifan Zhao8 分钟阅读 ·
MiniMax H3 Max最大的价值在于充当高速 AI 视频迭代模型,而不仅是更快的最终渲染器。研究发现,一个工作流不到三秒就生成了五秒 768p 视频,另一个端到端案例却花了约 96 秒生成四秒 768p 片段。真正的机会是,在确定最终镜头前测试更多动作、构图和视觉方向。
这种速度差异也是主要生产风险。API 排队、基础设施、编码和生成设置,可能把接近实时的基准表现变成慢得多的生产工作流。对创意团队而言,有意义的指标不是峰值推理速度,而是可重复的端到端延迟,以及每个工作时段能探索多少 有用的创意 。这使迭代策略与模型本身的速度同样重要。
Virse让这类实验更容易融入专业设计工作。它结合无限画布、共享项目上下文、多智能体协作与团队长期知识,而不是把流程压缩成单个提示词框。MiniMax H3、Seedance 2.0和Seedance 2.5已在其模型页上线。付费套餐包含无限使用 40 多款模型,包括 Nano Banana 2 与 GPT Image 2,以及无限席位;新用户可获得注册额度,最多用于生成 10 张 Nano Banana 2 图片或一条 Seedance 2.0 视频。
MiniMax H3 Max 是什么,最适合做什么?
MiniMax H3 Max 是fal Research 在 MiniMax H3 上进行后训练,并与 fal 推理技术栈联合优化以提高吞吐量的变体。更完整的H3 Max 介绍有助于区分它与基础 H3 工作流。fal 表示,其后训练重点是改善提示词遵循度和视觉质量,同时保留 H3 基础模型的多模态能力。
它最突出的用途是快速创意探索:生成足够多的备选方案,先比较摄像机运动、主体动作、时序、构图和视觉方向,再投入更高成本进行最终制作。因此,它尤其适合分镜转视频工作流。
H3 Max 功能 | 当前能力 |
|---|---|
模型来源 | 由 fal Research 基于 MiniMax H3 后训练 |
生成方式 | 文生视频、图生视频、参考生视频 |
分辨率 | 480p 和 768p |
音频 | 原生同步音频 |
时长 | 支持的工作流最长 15 秒 |
核心优势 | 高吞吐量迭代与提示词遵循 |
为何 H3 Max 更适合迭代,而非一次性生成
在专业创意工作中,团队通常要看到备选方案后才知道最佳镜头。他们需要测试不同的摄像机路径、姿势、节奏、产品位置和动作结构。
研究中的一个案例不到三秒就生成了五秒 768p 片段,因而能在较慢工作流的等待期间探索约15–20 个概念变体。
这让有用的生产力指标从每次渲染的秒数变成每小时探索的有效概念数。
H3 Max 在真实速度测试中有多快?
在优化条件下,H3 Max 可以快于实时。fal 报告,不到三秒就能生成五秒视频;在其评测中,吞吐量约为MiniMax H3 官方端点的 35 倍。
不过,我们更广泛的工作流研究发现,端到端延迟远没有这么一致。
场景 | 输出 | 实测或报告耗时 |
|---|---|---|
优化后的 H3 Max 案例 | 5 秒,768p | 不到 3 秒 |
较慢的端到端案例 | 4 秒,768p | 约 96 秒 |
fal 基准测试 | 5 秒 | 不到 3 秒 |
FastH3 参考数据 | 去噪步数从 50 降至 4 | 约 14 倍加速 |
为何 H3 Max API 延迟可能不同于基准速度
创作者经历的不只是推理。请求可能先经过排队、GPU 分配、生成、编码和交付,视频才可使用。
因此,我建议反复测试实际生产请求,而非依赖某一次最快结果。应测量:
- 生成时间中位数
- 最慢生成时间
- 目标分辨率下的性能
- 并发请求表现
- 每个可用输出的成本
当 AI 视频成为日常工作的一部分,可靠性比一次破纪录运行更重要。因此,可重复的H3 Max 生产工作流应同时评估速度和输出可用性。
H3 Max 如何改变 AI 视频创作工作流
研究中最重要的 H3 Max 用途是高频概念探索,再有选择地进行最终渲染。
案例:先探索 15–20 个概念,再确定最终镜头
一个实用工作流先用 H3 Max 探索约 15–20 个变体,再选择喜欢的构图和动作方向。如有需要,再用较慢、侧重质量的模型制作最终主镜头。
制作阶段 | 主要目标 | 优先事项 |
|---|---|---|
概念生成 | 探索方向 | 吞吐量 |
动作测试 | 比较动作 | 低延迟 |
构图测试 | 比较画面构图 | 变体数量 |
筛选 | 降低不确定性 | 快速比较 |
最终渲染 | 尽量完善质感 | 细节与一致性 |
剪辑 | 完成交付 | 制作控制 |
这比期待一个生成器在每个阶段都最优,更符合专业 AI 视频制作。
从产品设计角度看,速度降低了早期试错成本。团队可以先排除薄弱方向,再投入时间做高分辨率渲染、声音精修、合成或剪辑。
H3 Max 会为速度牺牲视频质量吗?
目前独立、标准化证据不足,无法断言 H3 Max 消除了速度与质量的取舍,也无法断言它总会损失质量。
fal 自己的偏好评估中,H3 Max 在总体偏好、提示词理解和美学方面排名较高,但制作团队仍应在相同提示词和动作条件下比较,再决定最终渲染方案。
H3 Base 低步数测试揭示的速度与瑕疵问题
研究中的一个 H3 Base 案例说明了激进加速的风险。
在 RTX 3060 12GB 工作流中,约4–8 步会产生静态噪点、动作拖影和块状瑕疵。将步数提升至10–20 步左右,生成时间大约翻倍,但可见的动作瑕疵减少。
这不是 H3 Max 的基准测试。它的价值在于指出更快的视频模型应评估什么:时间稳定性、细节保留、动作质量、主体一致性和音画协调性,而不只是速度。对于反复出现的主体,MiniMax H3 角色一致性应与纯生成速度分开测试。
H3 Max、H3 与 FastH3:分别适合什么工作流?
这三种方向解决不同问题。
H3 Base 的消费级 GPU 本地制作证据更充分
我们的研究包括多个实用 H3 Base 工作流:
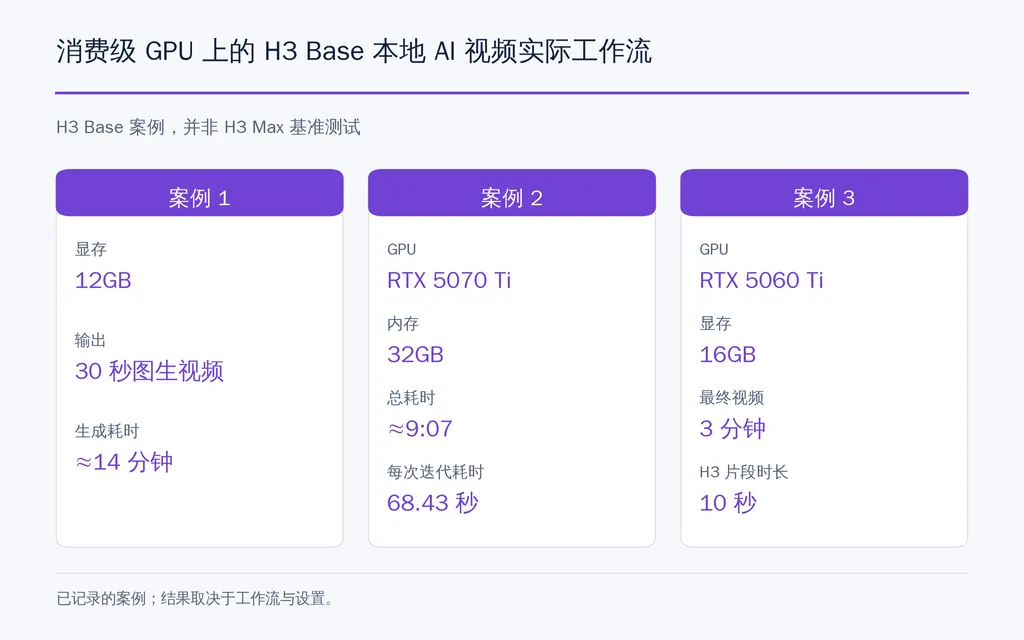
- 12GB 显存:约 14 分钟生成 30 秒图生视频
- RTX 5070 Ti,32GB RAM:总计约 9:07,记录的每次迭代耗时为 68.43 秒
- RTX 5060 Ti 16GB:由多段 10 秒 H3 片段组装成三分钟 AI 视频成片
H3 Base 还是开放权重模型,而 fal 目前将其作为 2K 多模态选项介绍。
FastH3 展示极致加速的潜力
数据集中的 FastH3 研究将去噪从约50 步降至 4 步,据报告实现约14 倍提速。连续生成实验也说明了加速 H3 工作流为何适用于 AI 直播和无限视频系统探索。
模型方向 | 当前最突出的价值 |
|---|---|
H3 Max | 快速高吞吐量迭代 |
H3 Base | 本地控制与经过验证的消费级 GPU 工作流 |
FastH3 | 实验性加速与连续生成 |
没有有意义的通用赢家,因为取舍涉及速度、分辨率、本地控制、质量和基础设施。
H3 Max 能在 ComfyUI 中本地运行吗?
本地 H3 Max 仍是最重要的未解工作流问题之一。用户问题中反复出现对 H3 Max 权重、ComfyUI 集成、显存要求,以及本地硬件能否复现云端速度的关注。
目前研究尚无足够经过验证的证据,无法给出明确的最低显存要求或标准本地 H3 Max 安装流程。
为何设计师关心本地 H3 Max
本地部署影响的不只是 API 费用,还可能改善:
- 隐私
- 可复现性
- 自定义节点工作流
- LoRA 实验
- 批处理
- 流程自动化
- 与现有创作系统集成
H3 Base 的消费级 GPU 案例说明了这种需求为何存在。创作者已经知道本地 H3 能承担严肃制作;尚待回答的是,未来能否兼得 H3 Max 级速度与相近的控制能力。
H3 Max 能驱动实时 AI 视频吗?
H3 Max 让实时 AI 视频更有可能,但仅有快速推理不足以构成可靠的实时系统。
研究中的一个端到端工作流约需96 秒才能生成四秒 768p 视频。在这种延迟下,简单的先生成再推流架构无法持续运行。
实用的 AI 电视或直播系统还需要场景连续性、角色一致性、缓冲、故障恢复、稳定延迟和可预测成本。
FastH3 的连续生成实验提示了这一领域的未来方向。更大的转变是从孤立的视频片段走向交互式、持续生成的媒体,但 H3 Max 要胜任该场景,仍需达到生产级的延迟一致性。
H3 Max 要多少钱?
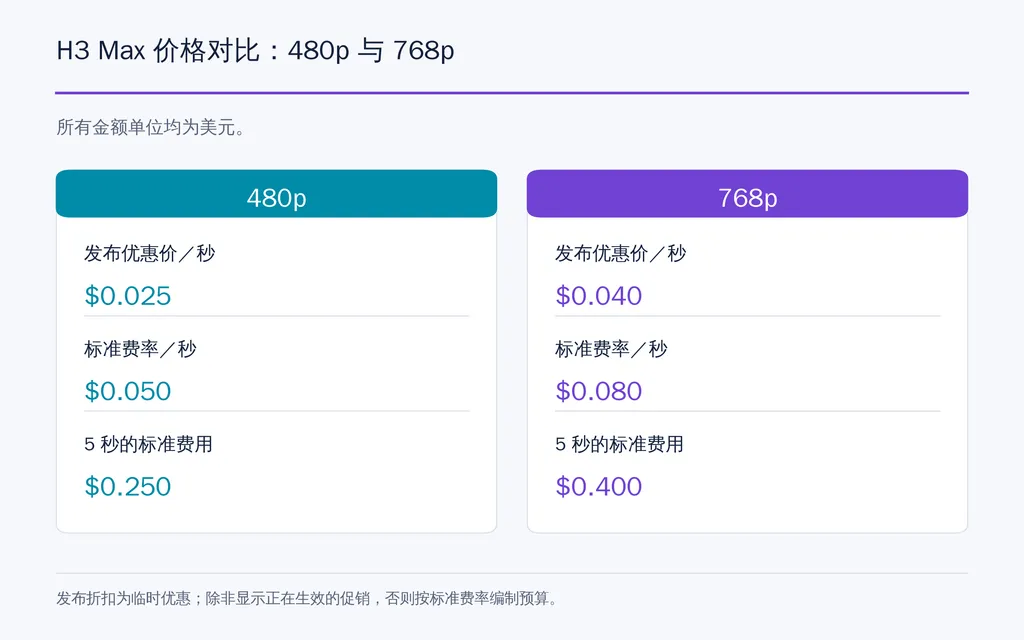
fal 目前列出了 480p 和 768p 的促销及标准每秒费率。端点说明首发优惠是临时的,因此生产预算应采用标准费率,除非当前端点显示有生效的促销。
分辨率 | 首发费率 | 标准费率 | 5 秒标准费用 |
|---|---|---|---|
480p | $0.025/秒 | $0.05/秒 | $0.25 |
768p | $0.04/秒 | $0.08/秒 | $0.40 |
按 768p 标准费率,20 个五秒概念片段约需 $8,100 次五秒生成则约需 $40。
对专业团队,更好的指标是每个获批概念的成本,而非每秒生成费用。当更多变体能显著改善创意筛选时,快速模型才具有经济价值。
谁适合使用 H3 Max?
H3 Max 当前最适合那些因等待生成而限制了创意探索的团队。
它尤其适用于广告概念、分镜开发、预演、社交视频测试、动作探索、大量变体和 AI 视频原型。
如果团队更关注已确认的本地部署、固定的消费级 GPU 性能或最高的最终镜头保真度,应分别评估这些要求。
最佳决策问题不是“H3 Max 是最好的视频模型吗?”,而是“更快迭代能否让团队在投入制作前有效测试更多想法?”
结论
MiniMax H3 Max的重要性在于,它可能让 AI 视频从等待单次输出转向快速探索大得多的创意空间。它的主要价值是高吞吐量迭代,而实际制作效用仍取决于可重复延迟、视觉质量、可预测价格和部署灵活性。H3 Base已证明消费级 GPU 本地工作流可行,FastH3 展示加速生成如何支持连续视频实验,H3 Max 则进一步推进速度端的发展。对设计师和创意团队,真正的机会不只是更快得到一个视频,而是在选定最终镜头前测试更多可能性,从而做出更有依据的创意决策。
常见问题
H3 Max 真的能实时生成吗?
在优化条件下,它可以快于实时,但不保证端到端实时性能。研究既包含不到三秒生成五秒片段的案例,也包含慢得多的 768p API 工作流。团队应反复测试实际请求,而非依赖峰值推理速度。
H3 Max 能在 ComfyUI 本地运行吗,需要多少显存?
目前研究没有足够经过验证的证据,无法给出 H3 Max 明确的最低显存要求或标准 ComfyUI 安装流程。H3 Base 已有在 12GB、16GB 级消费显卡上的成熟本地工作流,但这些结果不能视为 H3 Max 规格。
H3 Max、H3 与 FastH3:该选哪一个?
选择H3 Max 进行快速迭代并追求高吞吐量;重视本地控制与成熟消费级 GPU 工作流时选 H3 Base;探索激进加速或连续生成实验时选 FastH3。最佳选择取决于速度、分辨率、控制、硬件和最终质量要求。
H3 Max 要多少钱?
fal 按生成视频秒数列出 H3 Max 的价格。预算所用标准费率为480p 每秒 $0.05、768p 每秒 $0.08,有时另有临时促销。按 768p 标准费率,五秒生成约为 $0.40,因此团队应依据预计变体数量计算探索总成本。