
Análise do MiniMax H3 Max: testes reais de velocidade, qualidade, preços e fluxos de vídeo com IA
 Yifan Zhao12 min de leitura ·
MiniMax H3 Max tem mais valor como modelo de iteração de vídeo com IA em alta velocidade, e não apenas como um renderizador final mais rápido. Nossa pesquisa encontrou uma geração de cinco segundos em 768p concluída em menos de três segundos em um fluxo, enquanto outro caso levou cerca de 96 segundos de ponta a ponta para um clipe de quatro segundos em 768p. A verdadeira oportunidade é testar mais movimentos, composições e direções visuais antes de definir a tomada final.
Essa diferença de velocidade também é o principal risco de produção. Filas da API, infraestrutura, codificação e configurações de geração podem transformar um benchmark próximo do tempo real em um fluxo de produção muito mais lento. Para equipes criativas, a métrica relevante não é a velocidade máxima de inferência, mas a latência de ponta a ponta repetível e quantas ideias úteis podem ser exploradas por sessão de trabalho. Isso torna a estratégia de iteração tão importante quanto a velocidade bruta do modelo.
Virse facilita a integração dessa experimentação ao trabalho de design profissional. Combina uma tela infinita, contexto compartilhado do projeto, colaboração entre vários agentes e conhecimento de longo prazo da equipe, em vez de reduzir o processo a uma única caixa de prompt. MiniMax H3, Seedance 2.0 e Seedance 2.5 já estão disponíveis em sua página de modelos. Os planos pagos incluem uso ilimitado de mais de 40 modelos, incluindo Nano Banana 2 e GPT Image 2, além de assentos ilimitados, enquanto novos usuários recebem créditos de cadastro que podem cobrir até 10 imagens Nano Banana 2 ou um vídeo Seedance 2.0.
O que é MiniMax H3 Max e para que ele é mais indicado?
MiniMax H3 Max é uma variante do MiniMax H3 com pós-treinamento desenvolvido pela fal Research e otimização conjunta com a infraestrutura de inferência da fal para aumentar a capacidade de processamento. Uma explicação mais ampla do H3 Max ajuda a diferenciá-lo do fluxo do H3 básico. Segundo a fal, o pós-treinamento busca melhorar a aderência aos prompts e a qualidade visual, preservando as capacidades multimodais do modelo H3 básico.
Seu uso mais forte é a exploração criativa rápida: gerar alternativas suficientes para comparar movimento de câmera e do sujeito, ritmo temporal, enquadramento e direção visual antes de investir em uma produção final mais cara. Isso o torna especialmente relevante para fluxos de storyboard para vídeo.
Recurso do H3 Max | Capacidade atual |
|---|---|
Origem do modelo | Pós-treinado a partir do MiniMax H3 pela fal Research |
Geração | Texto para vídeo, imagem para vídeo e referência para vídeo |
Resolução | 480p e 768p |
Áudio | Áudio sincronizado nativo |
Duração | Até 15 segundos nos fluxos compatíveis |
Principal vantagem | Iteração com alta capacidade e aderência aos prompts |
Por que H3 Max vale mais para iteração do que para uma geração isolada
No trabalho criativo profissional, as equipes raramente sabem qual é a melhor tomada antes de ver alternativas. Precisam testar diferentes trajetórias de câmera, poses, ritmos, posicionamentos de produto e estruturas de movimento.
Um caso de nossa pesquisa gerou um clipe de cinco segundos em 768p em menos de três segundos e permitiu explorar aproximadamente 15–20 variações de conceito durante o tempo de espera de um fluxo mais lento.
Isso muda a métrica útil de produtividade de segundos por renderização para conceitos úteis explorados por hora.
Qual é a velocidade do H3 Max em testes reais?
H3 Max pode operar mais rápido que o tempo real em condições otimizadas. A fal relata um vídeo de cinco segundos gerado em menos de três segundos, cerca de 35 vezes a capacidade de processamento do endpoint oficial do MiniMax H3 em sua avaliação.
Nossa pesquisa mais ampla sobre fluxos, porém, encontrou uma latência de ponta a ponta muito menos consistente.
Cenário | Resultado | Tempo observado ou informado |
|---|---|---|
Caso otimizado de H3 Max | 5 s, 768p | Menos de 3 segundos |
Caso mais lento de ponta a ponta | 4 s, 768p | Cerca de 96 segundos |
Benchmark da fal | 5 s | Menos de 3 segundos |
Referência FastH3 | De 50 para 4 etapas de remoção de ruído | Aceleração de cerca de 14 vezes |
Por que a latência da API do H3 Max pode diferir da velocidade do benchmark
Um criador vivencia mais do que a inferência. Uma solicitação pode passar por fila, alocação de GPU, geração, codificação e entrega antes de o vídeo ficar utilizável.
Por isso, recomendo testar solicitações de produção repetidas em vez de confiar em um único resultado mais rápido. Meça:
- tempo mediano de geração
- tempo de geração mais lento
- desempenho na resolução desejada
- comportamento de solicitações simultâneas
- custo por resultado utilizável
A confiabilidade importa mais do que uma execução recordista quando o vídeo com IA integra o trabalho diário. Portanto, um fluxo de produção com H3 Max repetível deve ser avaliado tanto pela velocidade quanto pela utilidade dos resultados.
Como H3 Max muda o fluxo criativo de vídeo com IA
O principal uso de H3 Max em nossa pesquisa é a exploração frequente de conceitos seguida de renderização final seletiva.
Estudo de caso: 15–20 conceitos antes de uma tomada final
Um fluxo prático usou H3 Max para explorar aproximadamente 15–20 variações antes de escolher a composição e a direção de movimento preferidas. Depois, um modelo mais lento e focado em qualidade poderia ser usado para a tomada principal final, se necessário.
Etapa de produção | Objetivo principal | Prioridade |
|---|---|---|
Geração de conceitos | Explorar direções | Capacidade de processamento |
Testes de movimento | Comparar movimentos | Baixa latência |
Testes de composição | Comparar enquadramentos | Quantidade de variações |
Seleção | Reduzir a incerteza | Comparação rápida |
Renderização final | Maximizar o acabamento | Detalhe e consistência |
Edição | Concluir a entrega | Controle de produção |
Essa abordagem é melhor para o vídeo profissional com IA do que esperar que um único gerador seja ideal em todas as etapas.
Na perspectiva do design de produto, a velocidade reduz o custo de errar no início. As equipes podem rejeitar direções fracas antes de gastar tempo com renderização em alta resolução, refinamento de som, composição ou edição.
H3 Max sacrifica a qualidade do vídeo pela velocidade?
Não há evidências independentes e padronizadas suficientes para afirmar que H3 Max elimina o compromisso entre velocidade e qualidade ou perde qualidade de forma consistente.
A própria avaliação de preferência da fal classificou H3 Max bem em preferência geral, compreensão de prompts e estética, mas as equipes de produção ainda devem comparar prompts e condições de movimento idênticos antes de decidir a renderização final.
O que os testes de H3 Base com poucas etapas revelam sobre velocidade e artefatos
Um caso útil de H3 Base em nossa pesquisa ilustra o risco da aceleração agressiva.
Em um fluxo com RTX 3060 de 12 GB, aproximadamente 4–8 etapas produziram problemas como ruído estático, rastros de movimento e blocos visíveis. Aumentar o fluxo para cerca de 10–20 etapas aproximadamente dobrou o tempo de geração, mas reduziu os artefatos visíveis de movimento.
Este não é um benchmark de H3 Max. É útil porque identifica o que deve ser avaliado em modelos de vídeo mais rápidos: estabilidade temporal, retenção de detalhes, qualidade do movimento, consistência do sujeito e coerência entre áudio e vídeo, além da velocidade. Para sujeitos recorrentes, a consistência de personagens do MiniMax H3 deve ser testada separadamente da velocidade pura de geração.
H3 Max vs H3 vs FastH3: qual combina com cada fluxo?
As três abordagens resolvem problemas diferentes.
H3 Base tem evidências mais fortes para produção local em GPUs de consumo
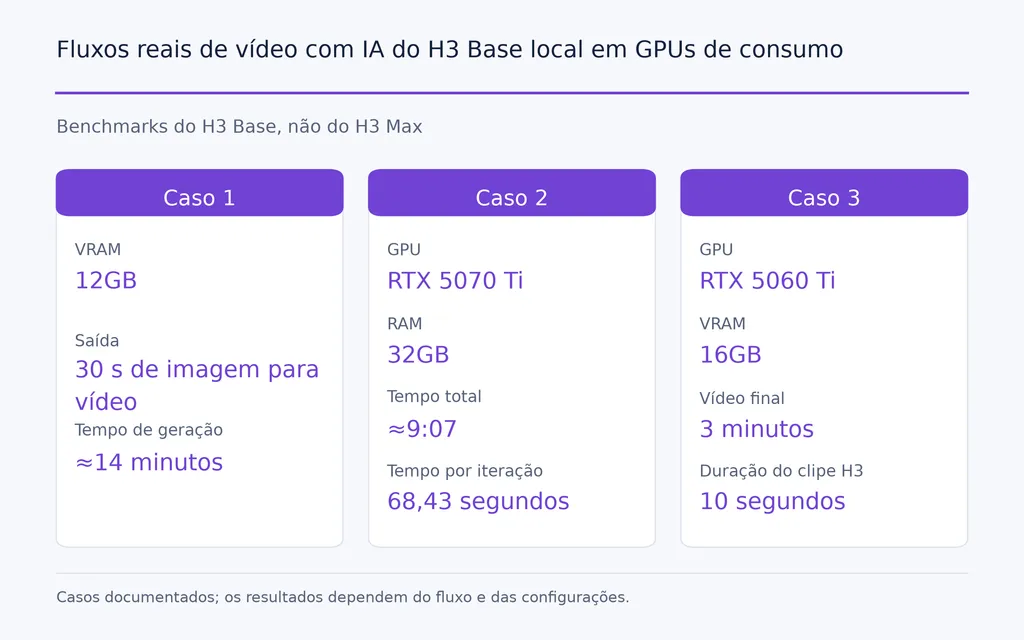
Nossa pesquisa inclui vários fluxos práticos de H3 Base:
- 12 GB de VRAM: geração de imagem para vídeo de 30 segundos em cerca de 14 minutos
- RTX 5070 Ti com 32 GB de RAM: cerca de 9:07 no total, com registro de 68,43 segundos por iteração
- RTX 5060 Ti de 16 GB: vídeo final com IA de três minutos montado a partir de vários clipes H3 de 10 segundos
H3 Base também é um modelo de pesos abertos, enquanto a fal atualmente o apresenta como uma opção multimodal 2K.
FastH3 mostra o potencial de aceleração extrema
A pesquisa de FastH3 em nosso conjunto de dados reduziu a remoção de ruído de aproximadamente 50 etapas para 4, com uma aceleração relatada de cerca de 14 vezes. Os experimentos de geração contínua também mostram por que fluxos H3 acelerados são interessantes para transmissões de IA ao vivo e sistemas de vídeo infinito.
Orientação do modelo | Maior valor atual |
|---|---|
H3 Max | Iteração rápida com alta capacidade |
H3 Base | Controle local e fluxos comprovados em GPUs de consumo |
FastH3 | Aceleração experimental e geração contínua |
Não existe um vencedor universal útil, porque os compromissos envolvem velocidade, resolução, controle local, qualidade e infraestrutura.
H3 Max pode rodar localmente no ComfyUI?
H3 Max local continua sendo uma das questões de fluxo de trabalho mais importantes sem resposta. Nossa revisão das dúvidas dos usuários identificou repetidamente interesse nos pesos do H3 Max, na integração com ComfyUI, nos requisitos de VRAM e na possibilidade de o hardware local reproduzir a velocidade da nuvem.
A pesquisa atual não oferece evidências verificadas suficientes para publicar um requisito mínimo definitivo de VRAM ou um procedimento padrão de instalação local do H3 Max.
Por que H3 Max local importa para designers
A implantação local afetaria mais do que o custo da API. Poderia melhorar:
- privacidade
- repetibilidade
- fluxos com nós personalizados
- experimentação com LoRA
- processamento em lotes
- automação de pipelines
- integração com sistemas criativos existentes
Os casos de H3 Base em GPUs de consumo mostram por que essa demanda existe. Os criadores já sabem que H3 local pode sustentar produção séria; a questão em aberto é se a velocidade do H3 Max poderá chegar acompanhada de controle comparável.
H3 Max pode viabilizar vídeo com IA em tempo real?
H3 Max torna o vídeo com IA em tempo real mais plausível, mas inferência rápida sozinha não cria um sistema confiável em tempo real.
Um fluxo de ponta a ponta em nossa pesquisa exigiu cerca de 96 segundos para gerar quatro segundos de vídeo em 768p. Com essa latência, uma arquitetura simples de gerar e depois transmitir não consegue operar continuamente.
Um sistema prático de TV com IA ou transmissão ao vivo também precisa de continuidade de cenas, consistência de personagens, buffer, recuperação de falhas, latência estável e custos previsíveis.
Os experimentos de geração contínua do FastH3 sugerem para onde essa categoria pode ir. A mudança mais ampla é de clipes isolados para mídias interativas geradas continuamente, mas H3 Max ainda precisa de consistência de latência em nível de produção para esse uso.
Quanto custa H3 Max?
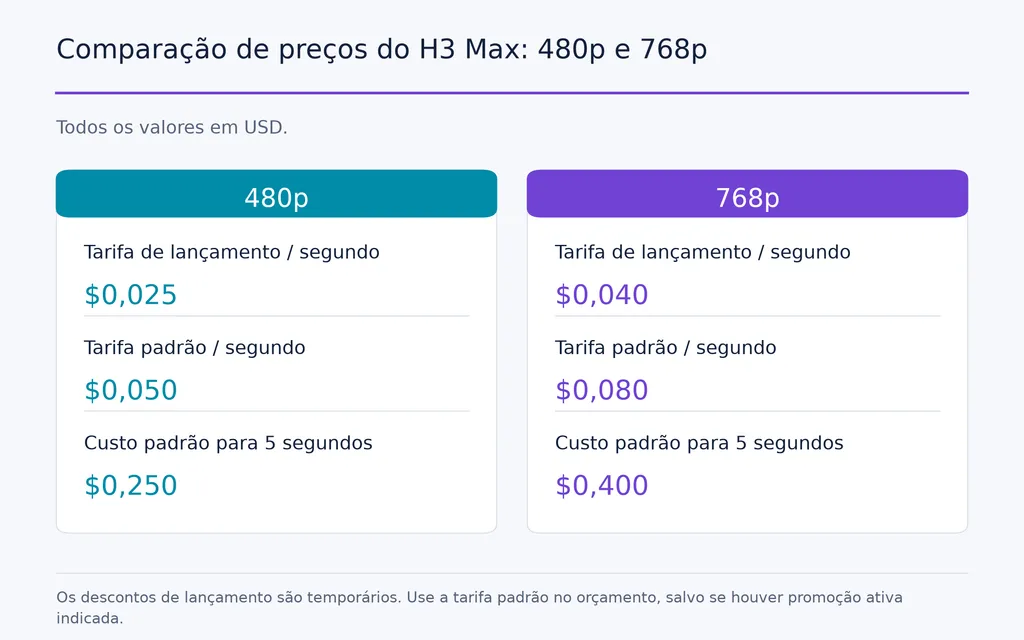
A fal atualmente lista tarifas promocionais e padrão por segundo para 480p e 768p. Seu endpoint informa que o desconto de lançamento é temporário; portanto, o orçamento de produção deve usar a tarifa padrão, a menos que o endpoint atual mostre uma promoção ativa.
Resolução | Tarifa de lançamento | Tarifa padrão | Custo padrão para 5 s |
|---|---|---|---|
480p | US$ 0,025/s | US$ 0,05/s | US$ 0,25 |
768p | US$ 0,04/s | US$ 0,08/s | US$ 0,40 |
Na tarifa padrão de 768p, 20 conceitos de cinco segundos custariam cerca de US$ 8, enquanto 100 gerações de cinco segundos custariam cerca de US$ 40.
Para equipes profissionais, a melhor métrica é o custo por conceito aprovado, e não por segundo gerado. Um modelo rápido se torna economicamente valioso quando variações adicionais melhoram significativamente a seleção criativa.
Quem deve usar H3 Max?
H3 Max atualmente faz mais sentido para equipes nas quais a espera pelas gerações limita a exploração criativa.
Ele se encaixa especialmente bem em conceitos publicitários, desenvolvimento de storyboards, pré-visualização, testes de vídeos para redes sociais, exploração de movimento, variações em alto volume e prototipagem de vídeo com IA.
Equipes focadas principalmente em implantação local confirmada, desempenho fixo em GPUs de consumo ou fidelidade máxima da tomada final devem avaliar esses requisitos separadamente.
A melhor pergunta para decidir não é “H3 Max é o melhor modelo de vídeo?”, mas “Iterações mais rápidas permitiriam à minha equipe testar significativamente mais ideias antes de se comprometer com a produção?”.
Conclusão
MiniMax H3 Max importa porque pode transformar o vídeo com IA, passando da espera por resultados individuais para a exploração rápida de um espaço criativo muito maior. Seu maior valor está na iteração com alta capacidade, enquanto sua utilidade em produção ainda depende de latência repetível, qualidade visual, preços previsíveis e flexibilidade de implantação. H3 Base já demonstra fluxos locais viáveis em GPUs de consumo, FastH3 mostra como a geração acelerada pode sustentar experimentos de vídeo contínuo e H3 Max avança ainda mais a velocidade nessa evolução. Para designers e equipes criativas, a verdadeira oportunidade não é apenas obter um vídeo mais rápido, mas tomar decisões criativas mais bem informadas porque muito mais possibilidades podem ser testadas antes de escolher a tomada final.
Perguntas frequentes
H3 Max realmente funciona em tempo real?
Ele pode ser mais rápido que o tempo real em condições otimizadas, mas isso não garante desempenho de ponta a ponta em tempo real. Nossa pesquisa inclui tanto geração em menos de três segundos para um clipe de cinco segundos quanto um fluxo de API em 768p muito mais lento. As equipes devem medir solicitações reais repetidas em vez de confiar na velocidade máxima de inferência.
H3 Max pode rodar localmente no ComfyUI, e de quanta VRAM precisa?
A pesquisa atual não fornece evidências verificadas suficientes para definir um requisito mínimo definitivo de VRAM para H3 Max ou um procedimento padrão de instalação no ComfyUI. H3 Base tem fluxos locais comprovados em GPUs de consumo das classes de 12 GB e 16 GB, mas esses resultados não devem ser tratados como especificações de H3 Max.
H3 Max vs H3 vs FastH3: qual devo usar?
Use H3 Max para iteração rápida e capacidade de processamento, H3 Base quando o controle local e fluxos estabelecidos em GPUs de consumo forem importantes, e FastH3 ao explorar aceleração agressiva ou experimentos de geração contínua. A melhor escolha depende de requisitos de velocidade, resolução, controle, hardware e qualidade final.
Quanto custa H3 Max?
A fal lista H3 Max por segundo de vídeo gerado. As tarifas padrão indicadas para orçamento são US$ 0,05/s em 480p e US$ 0,08/s em 768p, com promoções temporárias disponíveis em alguns momentos. Na tarifa padrão de 768p, uma geração de cinco segundos custa cerca de US$ 0,40, portanto as equipes devem calcular o custo total de exploração pelo número de variações que esperam gerar.
Mais do blogue da Virse
Produto
GPT Image 2.5 Resolution Explained: Can It Generate True 4K Images?
9 de outubro de 2026 by Yifan Zhao
Produto
GPT Image 2.5 Quality Settings Explained: Low vs Medium vs High vs XHigh vs Max
9 de outubro de 2026 by Yifan Zhao
Produto
What Is Product Design in 2026? What Product Designers Actually Do
21 de setembro de 2026 by Vincent