
Avis sur MiniMax H3 Max : tests de vitesse réels, qualité, tarifs et workflows vidéo IA
 Yifan Zhao12 min de lecture ·
MiniMax H3 Max est surtout utile comme modèle d’itération vidéo IA à grande vitesse, plutôt que comme simple moteur de rendu final plus rapide. Notre recherche a relevé une génération de cinq secondes en 768p terminée en moins de trois secondes dans un workflow, tandis qu’un autre cas a nécessité environ 96 secondes de bout en bout pour un clip de quatre secondes en 768p. Le véritable intérêt est de pouvoir tester davantage de mouvements, de compositions et de directions visuelles avant de s’engager sur un plan final.
Cet écart de vitesse représente aussi le principal risque en production. Les files d’attente API, l’infrastructure, l’encodage et les paramètres de génération peuvent transformer un benchmark proche du temps réel en un workflow de production beaucoup plus lent. Pour les équipes créatives, la mesure pertinente n’est pas la vitesse d’inférence maximale, mais une latence de bout en bout reproductible et le nombre d’ idées utiles pouvant être explorées par session de travail. La stratégie d’itération devient ainsi aussi importante que la vitesse brute du modèle.
Virse facilite l’intégration de cette expérimentation au travail de design professionnel. Il associe un canevas infini, un contexte de projet partagé, une collaboration entre plusieurs agents et les connaissances durables de l’équipe, au lieu de réduire le processus à un simple champ de prompt. MiniMax H3, Seedance 2.0 et Seedance 2.5 sont déjà disponibles sur sa page de modèles. Les offres payantes comprennent l’utilisation illimitée de plus de 40 modèles, dont Nano Banana 2 et GPT Image 2, ainsi qu’un nombre illimité de places, tandis que les nouveaux utilisateurs reçoivent des crédits d’inscription permettant de créer jusqu’à 10 images Nano Banana 2 ou une vidéo Seedance 2.0.
Qu’est-ce que MiniMax H3 Max et à quels usages convient-il le mieux ?
MiniMax H3 Max est une variante de MiniMax H3 ayant subi un post-entraînement par fal Research et co-optimisée avec la pile d’inférence de fal pour augmenter le débit. Une présentation détaillée de H3 Max permet de mieux le distinguer du workflow H3 de base. Selon fal, son post-entraînement vise à améliorer le respect des prompts et la qualité visuelle tout en conservant les capacités multimodales du modèle H3 de base.
Son meilleur usage est l’exploration créative rapide : générer suffisamment de variantes pour comparer les mouvements de caméra et du sujet, le timing, le cadrage et la direction visuelle avant d’investir dans une production finale plus coûteuse. Cela le rend particulièrement pertinent pour les workflows du storyboard à la vidéo.
Fonctionnalité de H3 Max | Capacité actuelle |
|---|---|
Origine du modèle | Post-entraîné à partir de MiniMax H3 par fal Research |
Génération | Texte vers vidéo, image vers vidéo et référence vers vidéo |
Résolution | 480p et 768p |
Audio | Audio synchronisé natif |
Durée | Jusqu’à 15 secondes dans les workflows compatibles |
Atout principal | Itération à haut débit et respect des prompts |
Pourquoi H3 Max est plus utile pour itérer que pour une génération ponctuelle
Dans le travail créatif professionnel, les équipes connaissent rarement le meilleur plan avant d’avoir vu plusieurs options. Elles doivent tester différentes trajectoires de caméra, poses, rythmes, dispositions de produits et structures de mouvement.
Dans un cas étudié, un clip de cinq secondes en 768p a été généré en moins de trois secondes, permettant d’explorer environ 15 à 20 variantes de concept pendant le temps d’attente d’un workflow plus lent.
La mesure de productivité pertinente passe ainsi des secondes par rendu au nombre de concepts utiles explorés par heure.
Quelle est la vitesse de H3 Max dans les tests en conditions réelles ?
H3 Max peut aller plus vite que le temps réel dans des conditions optimisées. fal annonce une vidéo de cinq secondes générée en moins de trois secondes, soit environ 35 fois le débit du point de terminaison officiel de MiniMax H3 dans son évaluation.
Notre recherche plus large sur les workflows a toutefois révélé une latence de bout en bout beaucoup moins constante.
Scénario | Sortie | Temps observé ou annoncé |
|---|---|---|
Cas H3 Max optimisé | 5 s, 768p | Moins de 3 secondes |
Cas plus lent de bout en bout | 4 s, 768p | Environ 96 secondes |
Benchmark de fal | 5 s | Moins de 3 secondes |
Référence FastH3 | De 50 à 4 étapes de débruitage | Accélération d’environ 14 fois |
Pourquoi la latence API de H3 Max peut différer de la vitesse des benchmarks
Le créateur subit davantage que le seul temps d’inférence. Une requête peut passer par la mise en file d’attente, l’allocation du GPU, la génération, l’encodage et la livraison avant que la vidéo soit exploitable.
C’est pourquoi je recommande de tester plusieurs requêtes de production plutôt que de se fier à un unique résultat record. Mesurez :
- le temps de génération médian
- le temps de génération le plus long
- les performances à la résolution visée
- le comportement des requêtes simultanées
- le coût par résultat exploitable
La fiabilité compte davantage qu’un record lorsque la vidéo IA fait partie du travail quotidien. Un workflow de production H3 Max reproductible doit donc être évalué sur sa vitesse et sur l’exploitabilité de ses résultats.
Comment H3 Max transforme le workflow créatif de la vidéo IA
Le principal usage de H3 Max dans notre recherche est l’exploration fréquente de concepts, suivie d’un rendu final sélectif.
Étude de cas : 15 à 20 concepts avant un plan final
Un workflow pratique utilisait H3 Max pour explorer environ 15 à 20 variantes avant de choisir une composition et une direction de mouvement. Un modèle plus lent, privilégiant la qualité, pouvait ensuite produire le plan phare final si nécessaire.
Étape de production | Objectif principal | Priorité |
|---|---|---|
Génération de concepts | Explorer des directions | Débit |
Tests de mouvement | Comparer les mouvements | Faible latence |
Tests de composition | Comparer les cadrages | Nombre de variantes |
Sélection | Réduire l’incertitude | Comparaison rapide |
Rendu final | Peaufiner au maximum | Détail et cohérence |
Montage | Finaliser la livraison | Maîtrise de la production |
Cette approche convient mieux à la vidéo IA professionnelle que d’attendre d’un seul générateur qu’il soit optimal à chaque étape.
Du point de vue du design produit, la vitesse réduit le coût des erreurs commises tôt. Les équipes peuvent écarter les mauvaises pistes avant de consacrer du temps au rendu haute résolution, au travail sonore, au compositing ou au montage.
H3 Max sacrifie-t-il la qualité vidéo à la vitesse ?
Les données indépendantes et standardisées sont insuffisantes pour affirmer que H3 Max élimine le compromis vitesse-qualité ou qu’il entraîne systématiquement une perte de qualité.
L’évaluation des préférences menée par fal classe H3 Max favorablement en préférence globale, compréhension des prompts et esthétique, mais les équipes de production doivent toujours comparer des prompts et des conditions de mouvement identiques avant de choisir un outil de rendu final.
Ce que les tests de H3 Base avec peu d’étapes révèlent sur la vitesse et les artefacts
Un cas utile de H3 Base dans notre recherche illustre les risques d’une accélération poussée.
Dans un workflow sur RTX 3060 12 Go, environ 4 à 8 étapes provoquaient du bruit statique, des traînées de mouvement et des effets de blocs. Passer à environ 10 à 20 étapes doublait approximativement le temps de génération, mais réduisait les artefacts de mouvement visibles.
Il ne s’agit pas d’un benchmark H3 Max. Ce cas est utile, car il indique les critères d’évaluation des modèles vidéo plus rapides : stabilité temporelle, préservation des détails, qualité du mouvement, cohérence du sujet et cohérence audiovisuelle, au-delà de la seule vitesse. Pour les sujets récurrents, la cohérence des personnages de MiniMax H3 doit être testée indépendamment de la vitesse de génération pure.
H3 Max, H3 ou FastH3 : lequel convient à quel workflow ?
Ces trois approches répondent à des problèmes différents.
H3 Base dispose de preuves plus solides pour la production locale sur GPU grand public
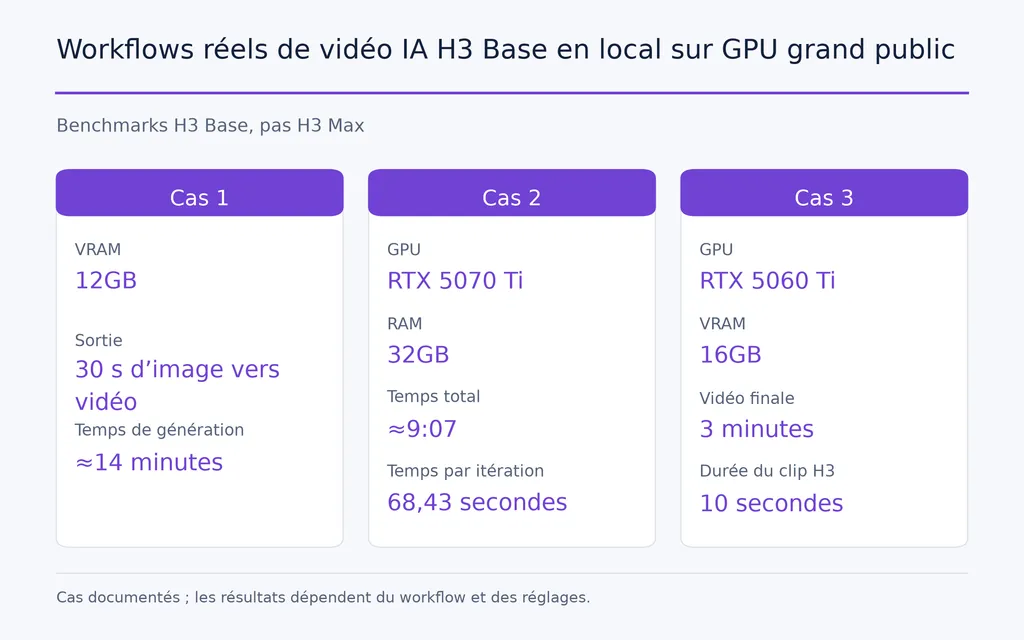
Notre recherche comprend plusieurs workflows pratiques avec H3 Base :
- 12 Go de VRAM : une génération image vers vidéo de 30 secondes en environ 14 minutes
- RTX 5070 Ti avec 32 Go de RAM : environ 9:07 au total, avec 68,43 secondes par itération enregistrées
- RTX 5060 Ti 16 Go : une vidéo IA finale de trois minutes assemblée à partir de plusieurs clips H3 de 10 secondes
H3 Base est également un modèle à poids ouverts, et fal le présente actuellement comme une option multimodale 2K.
FastH3 montre le potentiel d’une accélération extrême
Les travaux sur FastH3 présents dans notre jeu de données réduisent le débruitage d’environ 50 à 4 étapes, avec une accélération annoncée d’environ 14 fois. Les expériences de génération continue montrent aussi l’intérêt des workflows H3 accélérés pour les diffusions IA en direct et les systèmes de vidéo infinie.
Orientation du modèle | Principal intérêt actuel |
|---|---|
H3 Max | Itération rapide à haut débit |
H3 Base | Contrôle local et workflows éprouvés sur GPU grand public |
FastH3 | Accélération expérimentale et génération continue |
Il n’existe pas de vainqueur universel pertinent, car les compromis portent sur la vitesse, la résolution, le contrôle local, la qualité et l’infrastructure.
H3 Max peut-il fonctionner en local dans ComfyUI ?
L’utilisation locale de H3 Max reste l’une des grandes questions de workflow sans réponse. Notre analyse des questions des utilisateurs a régulièrement révélé un intérêt pour les poids de H3 Max, son intégration à ComfyUI, les besoins en VRAM et la possibilité de reproduire la vitesse du cloud sur du matériel local.
Les recherches actuelles n’apportent pas assez de preuves vérifiées pour publier une exigence minimale définitive de VRAM ou une procédure standard d’installation locale de H3 Max.
Pourquoi H3 Max en local compte pour les designers
Un déploiement local aurait des effets au-delà du coût de l’API. Il pourrait améliorer :
- la confidentialité
- la reproductibilité
- les workflows à nœuds personnalisés
- l’expérimentation avec des LoRA
- le traitement par lots
- l’automatisation des pipelines
- l’intégration aux systèmes créatifs existants
Les cas H3 Base sur GPU grand public expliquent cette demande. Les créateurs savent déjà que H3 en local permet une production sérieuse ; la question est de savoir si une vitesse comparable à H3 Max pourra un jour s’accompagner d’un contrôle similaire.
H3 Max peut-il alimenter la vidéo IA en temps réel ?
H3 Max rend la vidéo IA en temps réel plus plausible, mais une inférence rapide ne suffit pas à créer un système temps réel fiable.
Un workflow de bout en bout étudié nécessitait environ 96 secondes pour générer quatre secondes de vidéo en 768p. À cette latence, une architecture simple de génération suivie de diffusion ne peut pas fonctionner en continu.
Un système pratique de télévision IA ou de diffusion en direct a également besoin de continuité entre les scènes, de cohérence des personnages, de mise en mémoire tampon, de récupération après échec, d’une latence stable et de coûts prévisibles.
Les expériences de génération continue de FastH3 laissent entrevoir l’avenir de cette catégorie. L’évolution générale va des clips isolés vers des médias interactifs générés en continu, mais H3 Max a encore besoin d’une latence stable au niveau de la production pour cet usage.
Combien coûte H3 Max ?
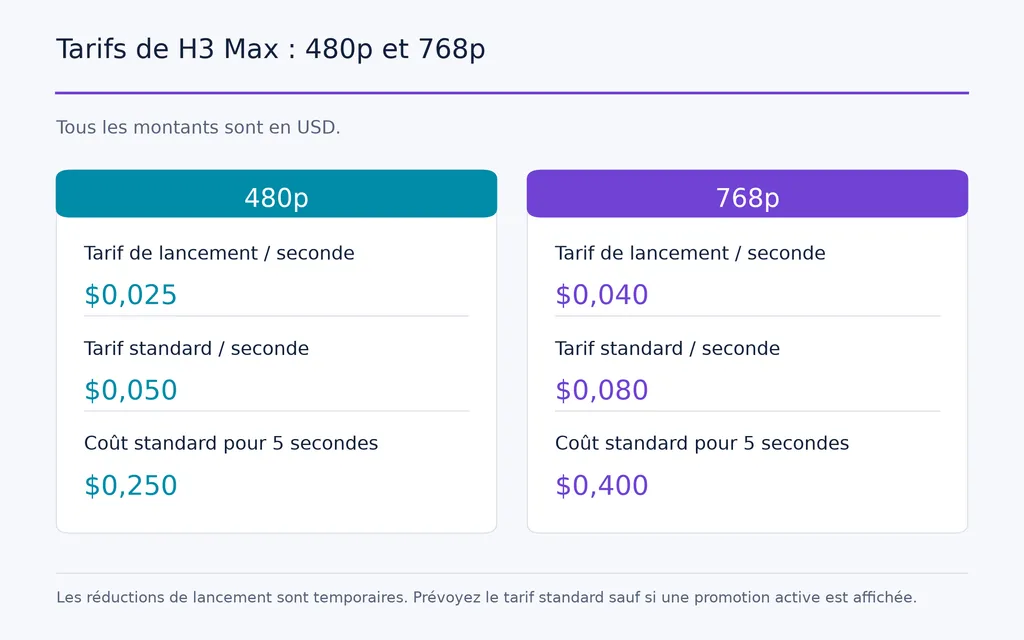
fal affiche actuellement des tarifs promotionnels et standard à la seconde pour le 480p et le 768p. Son point de terminaison précise que la réduction de lancement est temporaire ; les budgets de production doivent donc utiliser le tarif standard, sauf si le point de terminaison affiche actuellement une promotion active.
Résolution | Tarif de lancement | Tarif standard | Coût standard pour 5 s |
|---|---|---|---|
480p | 0,025 $/s | 0,05 $/s | 0,25 $ |
768p | 0,04 $/s | 0,08 $/s | 0,40 $ |
Au tarif standard en 768p, 20 concepts de cinq secondes coûteraient environ 8 $, et 100 générations de cinq secondes environ 40 $.
Pour les équipes professionnelles, la meilleure mesure est le coût par concept approuvé, et non par seconde générée. Un modèle rapide devient économiquement intéressant lorsque les variantes supplémentaires améliorent réellement la sélection créative.
À qui s’adresse H3 Max ?
H3 Max est actuellement le plus convaincant pour les équipes chez qui l’attente des générations limite l’exploration créative.
Il convient particulièrement aux concepts publicitaires, au développement de storyboards, à la prévisualisation, aux tests de vidéos sociales, à l’exploration des mouvements, aux variantes en grand nombre et au prototypage vidéo IA.
Les équipes qui privilégient un déploiement local confirmé, des performances fixes sur GPU grand public ou une fidélité maximale du plan final doivent évaluer ces exigences séparément.
La bonne question n’est pas « H3 Max est-il le meilleur modèle vidéo ? », mais « Des itérations plus rapides permettraient-elles à mon équipe de tester sensiblement plus d’idées avant de lancer la production ? »
Conclusion
MiniMax H3 Max compte parce qu’il peut faire passer la vidéo IA de l’attente de résultats individuels à l’exploration rapide d’un espace créatif bien plus vaste. Son principal atout est l’itération à haut débit, tandis que son utilité en production dépend encore d’une latence reproductible, de la qualité visuelle, de tarifs prévisibles et de la souplesse du déploiement. H3 Base démontre déjà la viabilité des workflows locaux sur GPU grand public ; FastH3 montre comment la génération accélérée peut soutenir les expériences de vidéo continue ; H3 Max pousse encore plus loin la vitesse dans cette évolution. Pour les designers et les équipes créatives, le véritable intérêt n’est pas seulement d’obtenir une vidéo plus vite, mais de prendre des décisions créatives plus éclairées grâce à un nombre bien plus important de possibilités testées avant de choisir le plan final.
FAQ
H3 Max fonctionne-t-il vraiment en temps réel ?
Il peut dépasser le temps réel dans des conditions optimisées, mais cela ne garantit pas des performances de bout en bout en temps réel. Notre recherche comprend à la fois une génération de moins de trois secondes pour un clip de cinq secondes et un workflow API 768p beaucoup plus lent. Les équipes doivent mesurer plusieurs requêtes réelles plutôt que se fier à la vitesse d’inférence maximale.
H3 Max peut-il fonctionner en local dans ComfyUI, et combien de VRAM lui faut-il ?
Les recherches actuelles n’apportent pas assez de preuves vérifiées pour fixer un minimum définitif de VRAM ou une procédure standard d’installation de H3 Max dans ComfyUI. H3 Base dispose de workflows locaux éprouvés sur des GPU grand public de classe 12 Go et 16 Go, mais ces résultats ne doivent pas être considérés comme des spécifications de H3 Max.
H3 Max, H3 ou FastH3 : lequel utiliser ?
Utilisez H3 Max pour l’itération rapide et le débit, H3 Base lorsque le contrôle local et des workflows éprouvés sur GPU grand public comptent, et FastH3 pour explorer une accélération poussée ou des expériences de génération continue. Le meilleur choix dépend des exigences de vitesse, de résolution, de contrôle, de matériel et de qualité finale.
Combien coûte H3 Max ?
fal facture H3 Max à la seconde de vidéo générée. Les tarifs standard affichés pour établir un budget sont de 0,05 $/s en 480p et 0,08 $/s en 768p, avec parfois des promotions temporaires. Au tarif standard en 768p, une génération de cinq secondes coûte environ 0,40 $ ; les équipes doivent donc calculer le coût total de l’exploration selon le nombre de variantes qu’elles prévoient de générer.
Plus d’articles du blog Virse
Produit
GPT Image 2.5 Resolution Explained: Can It Generate True 4K Images?
9 octobre 2026 by Yifan Zhao
Produit
GPT Image 2.5 Quality Settings Explained: Low vs Medium vs High vs XHigh vs Max
9 octobre 2026 by Yifan Zhao
Produit
What Is Product Design in 2026? What Product Designers Actually Do
21 septembre 2026 by Vincent