
Inpainting de audio en MiniMax H3: cómo editar vídeo y audio sin regenerar todo el clip
 Yifan Zhao13 min de lectura ·
MiniMax H3 ya puede usarse para hacer inpainting tanto de vídeo como de audio, permitiendo regenerar una región visual, un intervalo de fotogramas o un segmento sonoro seleccionado sin reconstruir todo el clip. En los flujos de H3 prácticos, vídeo y audio pueden controlarse por separado para reparar un detalle visual, conservar una pista sonora aprobada o regenerar el audio dejando intacta la imagen.
Esto resuelve un problema importante de la edición de vídeo con IA: un plano puede estar casi terminado, pero una pequeña corrección puede obligar a regenerarlo por completo y cambiar el movimiento, el ritmo, la interpretación del personaje o el sonido. El inpainting de H3 cambia el enfoque: en vez de generar otra toma parecida, se protege lo que funciona, se mantiene la consistencia del personaje y se regenera selectivamente lo que falla mediante un flujo de producción más controlado.
Para los equipos que exploran H3 junto con otros modelos creativos destacados, Virse reúne MiniMax H3, Seedance 2.0, Seedance 2.5, Nano Banana 2, GPT Image 2 y más de 40 modelos en un único espacio creativo. Los planes de pago incluyen uso ilimitado de modelos como Nano Banana 2 y GPT Image 2, con puestos ilimitados. Los nuevos usuarios reciben créditos gratuitos suficientes para unas 10 generaciones de imágenes Nano Banana 2 o una generación de vídeo Seedance 2.0.
¿Qué es el inpainting de audio de MiniMax H3 y por qué importa para editar vídeo?
El inpainting de audio de MiniMax H3 consiste en regenerar solo una sección sonora seleccionada y conservar el resto del audio y del vídeo. El inpainting de vídeo aplica el mismo principio a píxeles, objetos o intervalos de fotogramas concretos. Este enfoque selectivo amplía el flujo de edición de MiniMax H3 general.
MiniMax H3 es un modelo de vídeo omnimodal que comprende texto, imágenes, vídeo y audio y genera vídeo con sonido estéreo nativo. MiniMax especifica salidas de hasta 15 segundos y resolución de hasta 2K. Esta arquitectura multimodal hace especialmente útil la edición audiovisual selectiva.
Conviene aclarar que el inpainting de audio y vídeo de H3 es actualmente un flujo de inferencia basado en la representación latente audiovisual y las capacidades de enmascarado de H3, no un checkpoint independiente de H3 Inpainting. El índice de integraciones de MiniMax describe LanPaint como un flujo de inpainting de vídeo y audio para H3 que no requiere entrenamiento.
Modo de edición H3 | Qué cambia | Qué se protege | Mejor uso |
|---|---|---|---|
Inpainting de vídeo | Píxeles o fotogramas seleccionados | Resto de imágenes y audio | Logotipos, utilería, ropa y fondos |
Inpainting de audio | Intervalo de audio seleccionado | Vídeo y resto del audio | Diálogo, efectos y ambiente |
Generación con audio bloqueado | Vídeo | Pista sonora existente | Sincronización labial e interpretación musical |
Regeneración exclusiva del audio | Audio | Imagen existente | Rediseño de voz o sonido |
Continuación de vídeo | Nuevos fotogramas | Segmento existente | Prolongar una toma aprobada |
El principio central de producción es sencillo: la referencia orienta, la reutilización conserva y el inpainting regenera de forma selectiva. Esta distinción es especialmente importante en flujos de H3 con muchas referencias.
¿Cómo funciona el inpainting de vídeo y audio de MiniMax H3 en ComfyUI?
H3 separa vídeo y audio dentro del latente audiovisual
H3 no tiene que tratar un clip audiovisual como un objeto inseparable. Su flujo utiliza componentes de vídeo y audio diferenciados, con VAE separados documentados en el ecosistema H3. Esto permite conservar una modalidad y dejar que cambie la otra.
Esa separación importa en la edición real. Una voz definitiva puede estar aprobada mientras la interpretación del personaje aún requiere trabajo. O la imagen puede estar cerrada y una sección del audio necesitar otra pasada. El modelo no necesita libertad creativa sobre ambos flujos a la vez.
Las máscaras de inpainting de H3 definen qué puede regenerarse
LanPaint convierte esta arquitectura en un flujo práctico de edición. Los creadores pueden pintar máscaras de vídeo en fotogramas clave individuales y seleccionar intervalos independientes directamente en la forma de onda del audio. Un valor de máscara de 1 regenera contenido y 0 lo conserva. Después, el vídeo y el audio enmascarados se muestrean juntos y se integran de nuevo en la línea de tiempo original.
Un flujo de producción suele seguir seis pasos:
- Identifica exactamente qué está mal.
- Enmascara la menor región visual o intervalo sonoro que resulte útil.
- Codifica el vídeo y el audio existentes en el latente audiovisual de H3.
- Protege todo lo que ya esté aprobado.
- Regenera únicamente el contenido enmascarado.
- Revisa los bordes, la sincronización y la continuidad antes de terminar.
Desde el punto de vista del diseño, se parece más a trabajar con máscaras y pistas en software creativo profesional que a repetir prompts para conseguir otra toma.
Referencia, reutilización e inpainting de audio en MiniMax H3
Estos tres conceptos resuelven problemas distintos.
La referencia de audio indica a H3 a qué debe parecerse el sonido generado. Puede orientar características como la identidad vocal, el ritmo, la interpretación, el estilo musical o la textura sonora.
La reutilización de audio conserva el audio existente como material de producción, en lugar de pedir al modelo que lo reinterprete.
El inpainting de audio regenera solo una parte seleccionada de la pista sonora y protege todo lo que queda fuera de ese intervalo.
Objetivo | Mejor enfoque H3 |
|---|---|
Crear una voz similar | Referencia de audio |
Conservar exactamente una pista sonora | Reutilización o bloqueo de audio |
Guiar imágenes nuevas con música existente | Bloquear el audio y regenerar el vídeo |
Sustituir una sección de diálogo | Inpainting de audio |
Regenerar el sonido conservando el plano | Inpainting exclusivo del audio |
Nuestra revisión de flujos H3 publicados y preguntas frecuentes de usuarios reveló que confundir la referencia de audio con la conservación exacta del audio es uno de los errores de flujo más habituales. Una referencia puede influir en la voz o interpretación generadas sin garantizar que se mantengan la forma de onda, pronunciación, temporización o acento originales.
Para música con licencia, diálogos aprobados, localización o locuciones de marca, el flujo más seguro suele ser proteger el audio maestro en lugar de tratarlo como una referencia aproximada.
Casos de inpainting de MiniMax H3: resultados reales de vídeo, audio, VRAM y rendimiento
Caso 1: corregir un logotipo sin regenerar todo el plano
Un anuncio terminado con H3 contenía un logotipo deformado, pero el desplazamiento de cámara, las partículas, el movimiento y la toma en conjunto ya funcionaban.
Una regeneración normal podía modificar todos esos elementos. El flujo de edición expuso únicamente la región del logotipo al proceso de eliminación de ruido, protegiendo el latente circundante.
La misma configuración experimental también mostró el valor de regenerar por modalidad: una generación completa de 1664 × 928 y 107 fotogramas en una RTX 3090 tardó unos 845 segundos, mientras que regenerar solo el audio conservando el vídeo tardó unos 360 segundos.
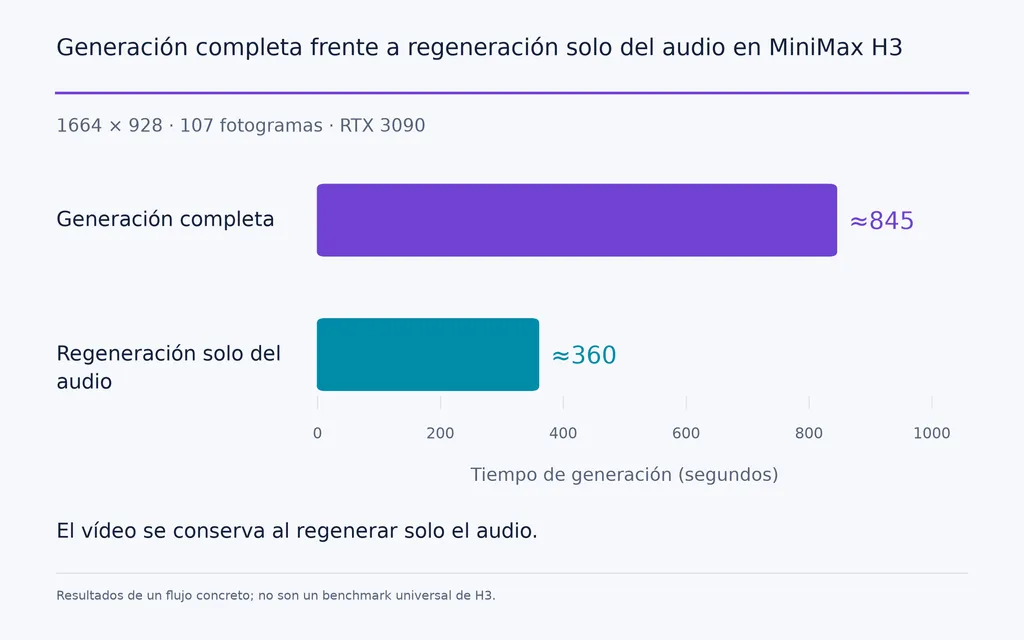
En otro experimento de extensión, el flujo pasó de 39 a 73 fotogramas, con una medición de 37,3 dB en la sección conservada. Fue una única prueba exitosa, no un benchmark reproducible, por lo que demuestra el potencial del flujo y no un rendimiento garantizado.
La lección de producción importa más que la medición: cuando la mayor parte de un plano es correcta, no debería ser necesario autorizar a la IA a reinterpretarlo entero.
Caso 2: conservar la pista sonora y regenerar la interpretación
Otro flujo H3 invierte la relación de edición: protege la pista sonora existente y mantiene generativo el vídeo.
En un flujo local documentado y revisado para este artículo, un plano continuo de 20 segundos, con 25 pasos en una RTX 5090, tardó unos siete minutos. La pista sonora siguió siendo el audio original y la interpretación visual se generó en torno a ella.
Esto es especialmente útil para sincronización labial, vídeos musicales, diálogos localizados, coreografías y locuciones aprobadas. Si el tiempo y el sonido ya son definitivos, el modelo visual debe adaptarse a ellos, no recrearlos.
Caso 3: por qué importa la duración de la referencia con 12 GB de VRAM
El material de referencia puede convertirse en uno de los mayores consumos de memoria de H3.
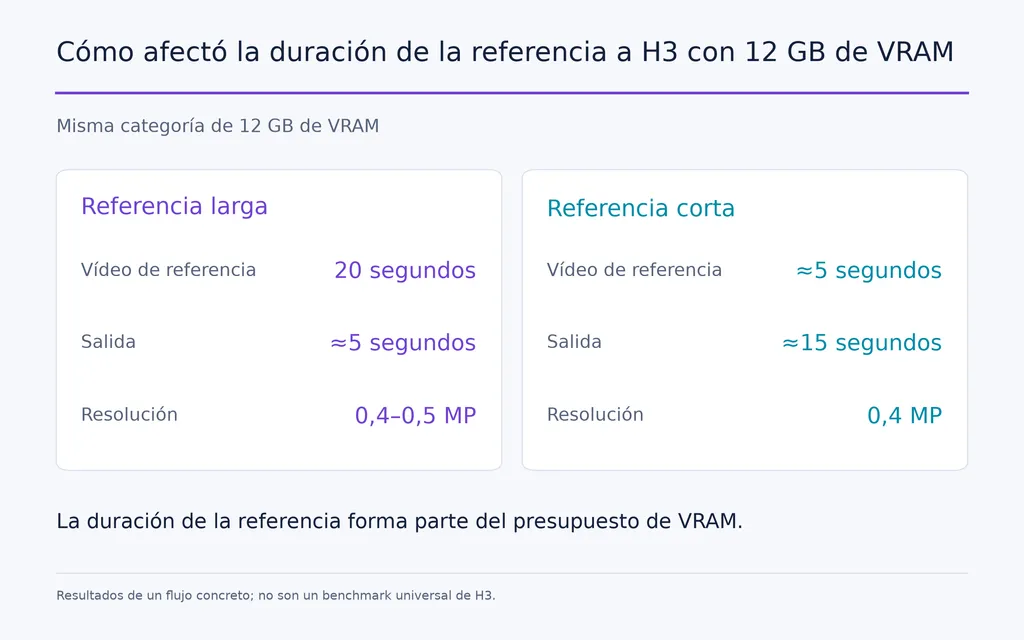
En un flujo de 12 GB de VRAM revisado, un vídeo de referencia de 20 segundos limitaba la salida práctica a unos cinco segundos en 0,4–0,5 MP. Al reducir la referencia a unos cinco segundos, la salida alcanzó aproximadamente 15 segundos en 0,4 MP con una configuración del mismo tipo.
La regla útil es clara: la duración de la referencia forma parte del presupuesto de VRAM. Más contexto no siempre es mejor.
Si la memoria es limitada, acorta las referencias antes de sacrificar todos los demás aspectos del flujo. La mejor referencia suele ser el clip más corto que aún comunique el movimiento, la identidad o la temporización que H3 necesita.
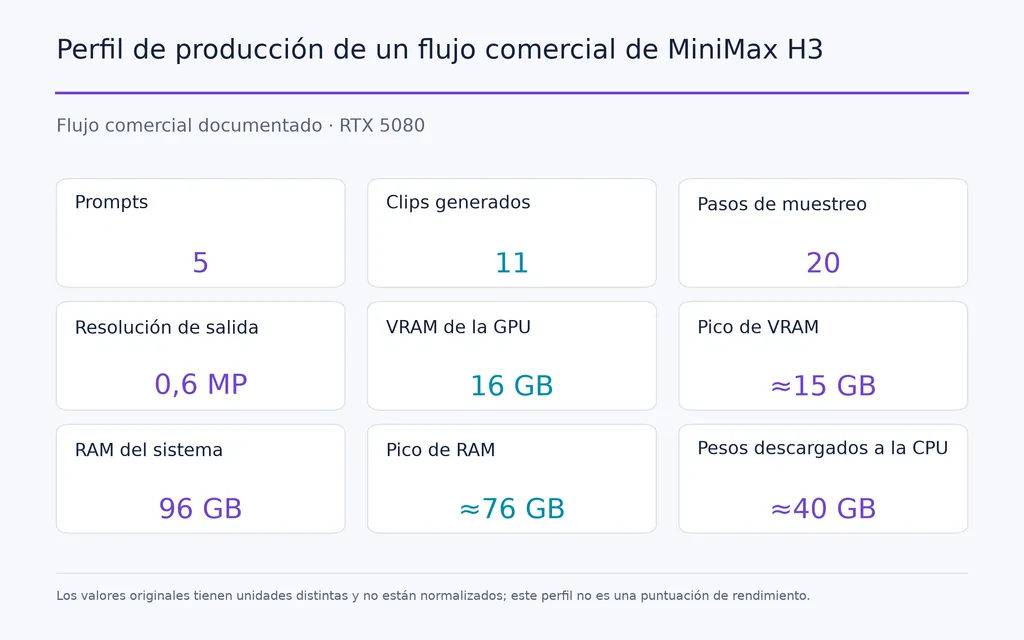
Caso 4: 5 prompts se convirtieron en 11 clips en un flujo comercial
Una producción comercial revisada durante nuestra investigación utilizó ChatGPT y Flux para desarrollar imágenes fijas, inpainting con IA y manual para prepararlas, MiniMax H3 para generar vídeo y audio, y After Effects para el acabado.
El flujo produjo 11 clips a partir de cinco prompts. Funcionó a unos 0,6 MP y 20 pasos en una RTX 5080 con 16 GB de VRAM y 96 GB de RAM del sistema, alcanzando picos de unos 15 GB de VRAM y 76 GB de RAM, mientras unos 40 GB de pesos se gestionaban mediante descarga a la CPU.
La idea importante no es que H3 sustituya la posproducción. Es casi lo contrario: H3 funciona bien como capa de generación y revisión de planos dentro de un proceso de producción más amplio.
Caso 5: por qué el rendimiento de H3 puede desplomarse a mayor resolución
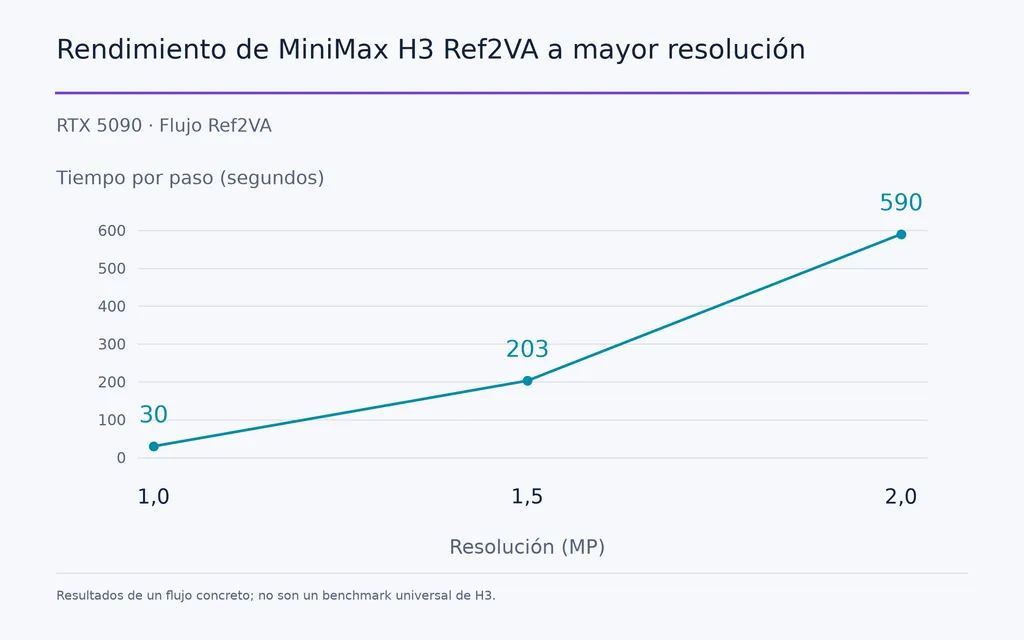
Un flujo Ref2VA en RTX 5090 mostró un rendimiento claramente no lineal al aumentar la resolución:
Resolución | Tiempo observado por paso |
|---|---|
1,0 MP | 30 segundos |
1,5 MP | 203 segundos |
2,0 MP | 590 segundos |
El autor del flujo sospechaba presión de memoria y descarga de datos, aunque la configuración de atención y el comportamiento general de la memoria también pueden afectar al resultado. Por tanto, estas cifras deben tratarse como observaciones de un flujo concreto, no como una curva universal de rendimiento de H3.
Otro experimento optimizado de FastH3 avanzó en sentido contrario: redujo el procesamiento GPU de 26,5 a 19,2 segundos y terminó produciendo 20,1 segundos de material reproducible en 19,2 segundos de tiempo GPU. La optimización abarcó más que el muestreo: decodificación y codificación VAE, movimientos de memoria, resolución y manejo de la salida también influyeron.
¿Cuál es el mejor flujo de edición de audio y vídeo de MiniMax H3 para producción?
En el trabajo creativo profesional, la mejor estrategia H3 es conservar primero y regenerar después.
Empieza identificando lo aprobado: la pista sonora, la identidad del personaje, el movimiento de cámara, la geometría del producto, el tiempo del diálogo o la toma existente. Esos elementos deben convertirse en restricciones.
Después, ofrece a H3 la menor área de incertidumbre posible. Si el problema es un logotipo, no vuelvas a renderizar al intérprete. Si dos segundos de diálogo están mal, no regeneres toda la pista sonora. Si la música maestra es definitiva, no la uses solo como referencia estilística.
Así se obtiene un modelo práctico de decisión en tres partes:
- Usa referencias para orientar la creación.
- Usa reutilización o bloqueo para los recursos aprobados.
- Usa inpainting para correcciones concretas.
La edición final, el color, la tipografía, la composición, la mezcla de sonido y la entrega pueden seguir realizándose con herramientas de producción especializadas. H3 resulta más útil cuando amplía un flujo creativo existente, en lugar de intentar sustituir todas sus partes.
Limitaciones del inpainting de MiniMax H3: VRAM, velocidad, consistencia y complejidad
La VRAM sigue siendo una de las principales restricciones. El vídeo de referencia, el condicionamiento de audio, la resolución, la duración, los pesos del modelo y los latentes audiovisuales compiten por la memoria; por eso, los flujos con muchas referencias pueden resultar inviables incluso en GPU de gama alta.
La velocidad es otra contrapartida. La regeneración selectiva evita cálculos innecesarios cuando solo debe cambiar el vídeo o el audio, pero los flujos avanzados de máscaras e inpainting pueden añadir su propia sobrecarga.
La conservación también depende de la implementación. Las máscaras latentes protegen las regiones aprobadas con mucha más firmeza que una regeneración normal, pero no garantizan que cada píxel decodificado fuera de la máscara sea matemáticamente idéntico en todos los flujos H3. Aún deben revisarse bordes, reflejos, sombras, interacciones de movimiento y transiciones.
Por último, el ecosistema sigue siendo más técnico que un editor convencional. ComfyUI aporta mucha flexibilidad a H3, pero los flujos sofisticados pueden seguir dependiendo de nodos especializados en máscaras, manipulación de latentes audiovisuales, referencias, descarga de datos y decodificación.
Por tanto, la pregunta más útil no es «¿Puede H3 editarlo todo?», sino «¿Qué debería permitirse cambiar a H3?»
Preguntas frecuentes
¿Puede H3 hacer inpainting solo en el área enmascarada sin cambiar el movimiento original?
Sí. El enmascarado del proceso de eliminación de ruido en el latente busca limitar la regeneración a regiones o intervalos temporales seleccionados y proteger el resto del latente. Conserva mucho más que una regeneración Ref2V normal, aunque los bordes de la máscara, reflejos, sombras e interacciones con objetos en movimiento aún requieren revisión fotograma a fotograma.
¿Puede H3 usar mi audio exacto para sincronizar los labios en lugar de generar una voz parecida?
Sí, pero el audio exacto debe reutilizarse o protegerse, no ofrecerse únicamente como referencia. Una referencia puede orientar timbre, interpretación, ritmo o características del habla sin preservar la señal original. Para diálogos, canciones y voces localizadas aprobados, el audio bloqueado suele ser el enfoque de producción más fiable.
¿Puede H3 Ref2V funcionar realmente con 12 GB de VRAM?
Sí, pero la duración de la referencia y la resolución se convierten en restricciones importantes. En un flujo de 12 GB revisado, una referencia de 20 segundos limitaba la salida a unos cinco segundos; al acortarla a cinco segundos, se lograban unos 15 segundos en 0,4 MP. Por eso, referencias más cortas pueden marcar una gran diferencia práctica.
¿Por qué H3 se ralentiza tanto con vídeo de referencia o mayor resolución?
H3 debe gestionar simultáneamente pesos del modelo, latentes audiovisuales, referencias, estados de atención, procesamiento VAE y fotogramas de salida. Cuando el conjunto de trabajo supera la capacidad cómoda de VRAM, las transferencias de memoria y la descarga de datos pueden provocar ralentizaciones no lineales. La causa exacta cambia según el flujo, así que las pruebas de resolución son específicas de cada configuración, no benchmarks universales.
Conclusión: qué cambia el inpainting de audio de MiniMax H3 en la edición de vídeo con IA
MiniMax H3 y su inpainting de audio importan porque acercan la edición de vídeo con IA al control que necesitan los equipos creativos profesionales: mantener fija la información aprobada y regenerar solo la parte incierta. Separar vídeo y audio permite reparar una región visual sin sustituir la pista sonora, regenerar sonido sin cambiar la imagen, conservar una canción exacta mientras se crea otra interpretación o prolongar un plano protegiendo lo que funciona. El mejor flujo H3 no es, por tanto, el que da más libertad a la IA, sino el que distingue claramente referencia, reutilización e inpainting, minimiza la región editable, respeta las restricciones de memoria y utiliza la regeneración selectiva dentro de un proceso de producción controlado.
Más del blog de Virse
Flujo de trabajo

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de octubre de 2026 by Yifan Zhao