
MiniMax H3の音声インペインティング:クリップ全体を再生成せずに映像と音声を編集する方法
 Yifan Zhao読了 12 分 ·
MiniMax H3は現在、映像と音声の両方のインペインティングに使用でき、クリップ全体を作り直さずに、選択した映像領域、フレーム範囲、音声区間を再生成できます。実用的なH3ワークフローでは映像と音声を別々に制御できるため、視覚的な細部の修復、承認済み音声トラックの保持、映像をそのままにした音声の再生成が可能です。
これはAI動画編集の大きな課題を解決します。ショットがほぼ完成していても、小さな修正のために全体の再生成を強いられ、動き、タイミング、人物の演技、音が変わってしまうことがあります。H3のインペインティングは、似た別テイクを生成する工程から、うまくいっている部分を守り、人物の一貫性を保ちながら、より制御された制作ワークフローで問題のある部分だけを再生成する工程へと変えます。
H3をほかの主要な創作モデルとともに試すチーム向けに、Virseは、MiniMax H3、Seedance 2.0、Seedance 2.5、Nano Banana 2、GPT Image 2など40以上のモデルを1つの制作ワークスペースにまとめています。有料プランではNano Banana 2やGPT Image 2などのモデルを無制限に利用でき、ユーザー席数も無制限です。新規ユーザーには、Nano Banana 2画像約10枚またはSeedance 2.0動画1本の生成に使える無料クレジットが付与されます。
MiniMax H3の音声インペインティングとは?動画編集で重要な理由は?
MiniMax H3の音声インペインティングは、選択した音声区間だけを再生成し、残りの音声と映像を保つものです。動画インペインティングでは同じ原則を、選択した画素、物体、フレーム範囲に適用します。この選択的な方法は、より広いMiniMax H3の編集ワークフローを拡張します。
MiniMax H3はテキスト、画像、映像、音声を理解する全モーダル動画モデルで、ネイティブのステレオ音声付き動画を生成します。MiniMaxの仕様では、出力は最長15秒、最大2K解像度です。このマルチモーダル構造により、映像と音声の選択的な編集が特に有効になります。
重要な点として、H3の映像・音声インペインティングは現在、H3の映像・音声潜在表現とマスク機能を利用した推論ワークフローであり、独立したH3 Inpaintingチェックポイントではありません。MiniMaxの連携一覧では、LanPaintはH3向けの追加学習不要の映像・音声インペインティング工程と説明されています。
H3編集モード | 変更される部分 | 保護される部分 | 適した用途 |
|---|---|---|---|
動画インペインティング | 選択した画素やフレーム | その他の映像と音声 | ロゴ、小道具、衣服、背景 |
音声インペインティング | 選択した音声区間 | 映像と残りの音声 | 台詞、効果音、環境音 |
音声を固定した生成 | 映像 | 既存の音声トラック | リップシンク、音楽の演奏・歌唱 |
音声のみの再生成 | 音声 | 既存の映像 | 声や音の再設計 |
動画の継続生成 | 新しいフレーム | 既存の区間 | 承認済みテイクの延長 |
制作の基本原則はシンプルです。参照はガイド、再利用は保持、インペインティングは選択的な再生成です。この区別は、参照を多用するH3ワークフローで特に重要です。
MiniMax H3の映像・音声インペインティングはComfyUIでどう動く?
H3はAV潜在表現内で映像と音声を分離する
H3は映像と音声を切り離せない1つの対象として扱う必要がありません。ワークフローでは映像と音声の別々の構成要素を使い、H3エコシステムでは動画VAEと音声VAEが個別に記載されています。そのため、一方のモダリティを保ちながら、もう一方を変更できます。
この分離は実際の編集に役立ちます。最終音声トラックは承認済みでも、人物の演技には修正が必要かもしれません。逆に、映像は確定済みでも、ある音声区間は再調整が必要かもしれません。モデルに両方のストリームの創作上の自由を同時に与える必要はありません。
H3のインペインティングマスクで再生成できる部分を指定する
LanPaintはこの構造を実用的な編集ワークフローにします。各キーフレームに動画マスクを描き、音声波形上で別々の区間を直接選択できます。マスク値1は内容を再生成し、0は保持します。その後、マスク付き映像と音声を一緒にサンプリングし、元のタイムラインに戻して統合します。
制作工程は通常、6つの手順で進みます。
- 何が問題なのかを正確に特定する。
- 必要最小限の視覚領域または音声区間をマスクする。
- 既存の映像と音声をH3のAV潜在表現にエンコードする。
- 承認済みの内容をすべて保護する。
- マスクした内容だけを再生成する。
- 仕上げ前に境界、同期、連続性を確認する。
デザイン工程の観点では、別テイクを求めて何度もプロンプトを入力するより、専門的な制作ソフトでマスクやトラックを扱う作業に近いものです。
MiniMax H3の音声参照、音声再利用、音声インペインティングの違い
この3つの概念は、それぞれ異なる問題を解決します。
音声参照は、生成音が何に似るべきかをH3に伝えます。声の同一性、リズム、話し方、音楽スタイル、音の質感などを導くことができます。
音声再利用は、モデルに再解釈させるのではなく、既存の音声を制作素材として保持します。
音声インペインティングは、選択した音声トラックの一部だけを再生成し、その区間以外をすべて保護します。
目的 | 適したH3の方法 |
|---|---|
似た声を作る | 音声参照 |
音声トラックをそのまま保持する | 音声再利用または音声固定 |
既存の音楽に合わせて新しい映像を作る | 音声を固定して映像を再生成 |
台詞の一部分を置き換える | 音声インペインティング |
ショットを保って音を再生成する | 音声のみのインペインティング |
公開済みのH3ワークフローと繰り返し寄せられる質問を調べると、音声参照と音声の厳密な保持を混同することが、最もよくある工程上のミスの1つでした。参照は生成される声や演技に影響を与えられますが、元の波形、発音、タイミング、アクセントが変わらないことは保証しません。
ライセンス取得済みの音楽、承認済みの台詞、ローカライズ、ブランドのナレーションでは、マスター音声を大まかな参照として扱うより、保護する工程が通常最も安全です。
MiniMax H3インペインティング事例:映像・音声・VRAM・性能の実測結果
事例1:ショット全体を再生成せずにロゴを修正
完成したH3広告に崩れたロゴがありましたが、カメラの緩やかな移動、粒子、動き、テイク全体はすでにうまくいっていました。
通常の再生成では、そのすべてが変わるおそれがありました。そこで編集工程ではロゴ領域だけをノイズ除去の対象にし、周囲の潜在表現を保護しました。
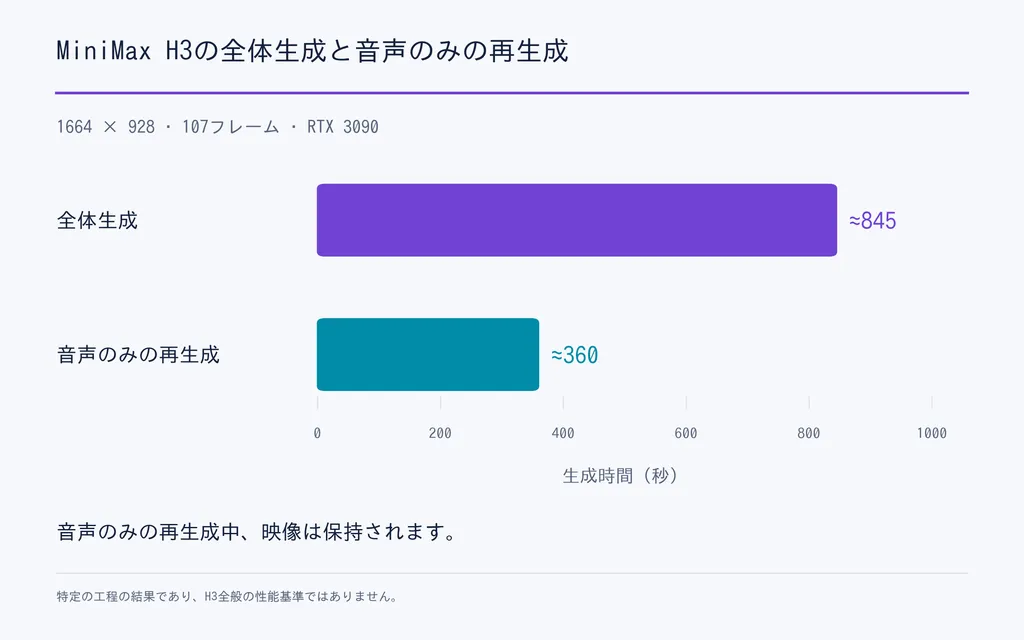
同じ実験設定は、モダリティ別の再生成の価値も示しました。RTX 3090で1664 × 928、107フレームを完全生成すると約845秒かかった一方、映像を保持して音声だけを再生成すると約360秒でした。
別の延長実験では、39フレームから73フレームへ拡張し、保持した区間の測定値は37.3 dBでした。これは1回の成功例であり、再現可能なベンチマークではありません。性能保証ではなく、工程の可能性を示す証拠として捉えるべきです。
測定値より重要な制作上の教訓は、ショットの大部分が正しければ、AIに全体の再解釈を許可する必要はないということです。
事例2:音声トラックを保持して演技を再生成
別のH3ワークフローでは編集の関係を逆にし、既存の音声トラックを保護しながら、映像を生成対象にしています。
本記事で確認した、記録のあるローカル工程の1つでは、RTX 5090で25ステップを使い、20秒の連続ショットを生成するのに約7分かかりました。音声トラックは元音声を維持し、それに合わせて映像の演技を生成しました。
これはリップシンク、ミュージックビデオ、ローカライズした台詞、振付、承認済みナレーションに特に役立ちます。タイミングと音がすでに確定しているなら、映像モデルはそれを作り直すのではなく、適応すべきです。
事例3:12GB VRAMでは参照の長さが重要な理由
参照メディアは、H3のメモリ使用量の大きな要因になり得ます。
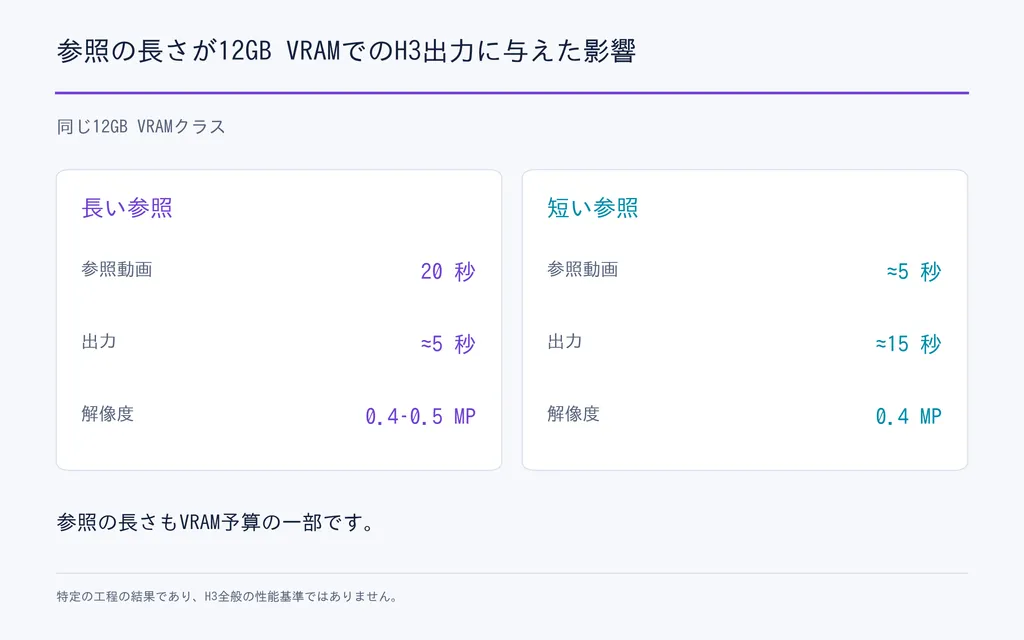
確認した12GB VRAMのある工程では、20秒の参照動画により、実用的な出力は0.4~0.5MPで約5秒に制限されました。参照を約5秒に短縮すると、出力は0.4MPで約15秒に達しました。同等クラスの構成での結果です。
役立つ原則は明確です。参照の長さもVRAM予算の一部です。文脈が多ければ必ず良いわけではありません。
メモリが限られる場合、工程のほかのすべてを犠牲にする前に、参照を短くしましょう。最適な参照は、H3が必要とする動き、同一性、タイミングを伝えられる最短のクリップであることが多いのです。
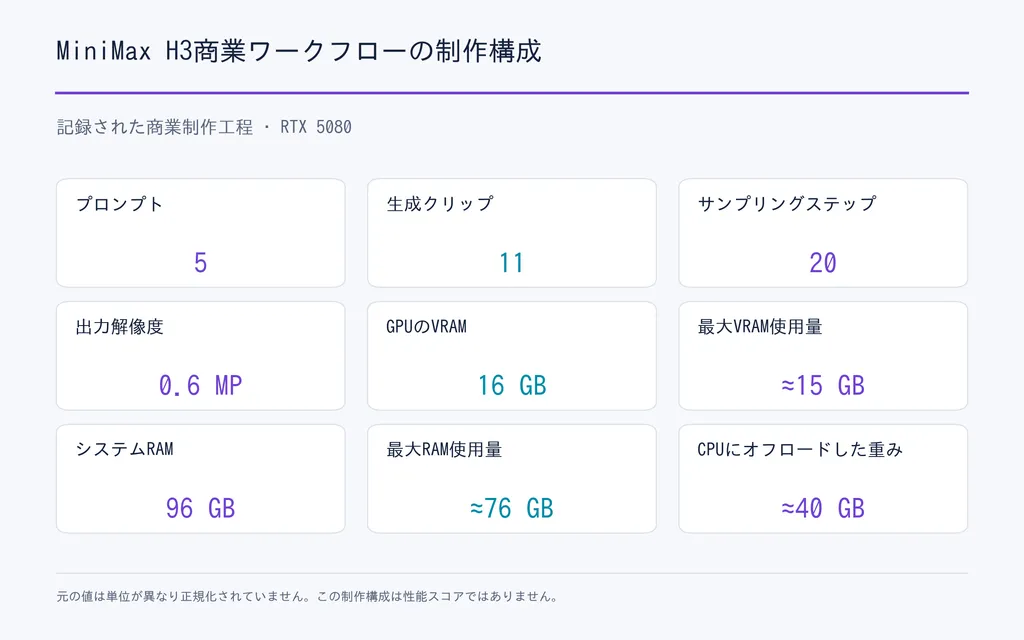
事例4:商業制作で5つのプロンプトから11クリップを作成
調査中に確認したある商業制作では、静止画の開発にChatGPTとFlux、準備にAIと手作業のインペインティング、映像と音声の生成にMiniMax H3、仕上げにAfter Effectsを使いました。
この工程は、5つのプロンプトから11クリップを作成しました。RTX 5080で約0.6MP、20ステップで動作し、構成はVRAM 16GB、システムRAM 96GBでした。最大使用量は約VRAM 15GB、RAM 76GBに達し、約40GBの重みはCPUオフロードで処理しました。
重要なのは、H3がポストプロダクションを置き換えるということではありません。むしろ逆で、H3は、より広い制作工程の中でショット生成・修正を担う層としてよく機能します。
事例5:高解像度でH3の性能が急落し得る理由
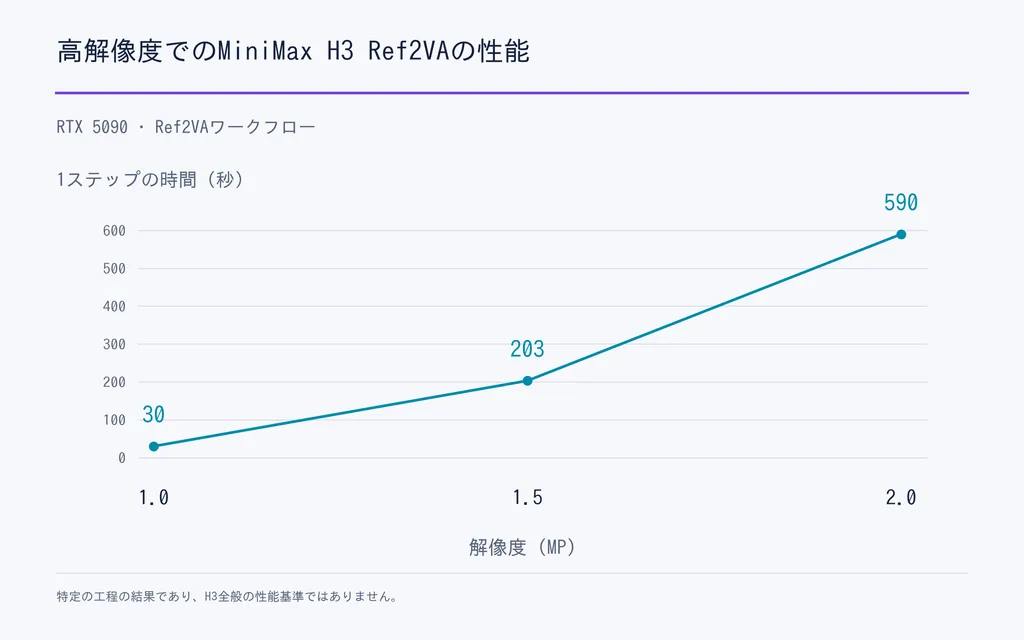
RTX 5090のあるRef2VAワークフローでは、解像度の増加に伴い、性能が大きく非線形に変化しました。
解像度 | 観測された1ステップの時間 |
|---|---|
1.0MP | 30秒 |
1.5MP | 203秒 |
2.0MP | 590秒 |
工程の作者はメモリ圧迫とオフロードを疑っていましたが、アテンション設定や全般的なメモリ挙動も結果に影響します。したがって、この数値はH3全般の性能曲線ではなく、特定のワークフローでの観測結果として扱うべきです。
別の最適化されたFastH3実験は逆方向に進み、GPU処理を26.5秒から19.2秒に短縮し、最終的に19.2秒のGPU時間で20.1秒の再生素材を作成しました。最適化はサンプリングだけでなく、VAEのデコード、エンコード、メモリ移動、解像度、出力処理にも関係していました。
制作に適したMiniMax H3の音声・映像編集ワークフローとは?
専門的な創作作業で最適なH3戦略は、まず保持し、その後に再生成することです。
まず、音声トラック、人物の同一性、カメラの動き、商品の形状、台詞のタイミング、既存のテイクなど、すでに承認された内容を特定します。それらを制約にするべきです。
次にH3に与えるのは、可能な限り小さい不確定な領域です。問題がロゴなら演者を再レンダリングしない。2秒の台詞が間違っているなら音声トラック全体を再生成しない。音楽マスターが確定しているなら、スタイル参照だけに使わないことです。
この考え方から、実用的な3つの判断基準が得られます。
- 創作の方向付けには参照を使う。
- 承認済み素材には再利用や固定を使う。
- 特定箇所の修正にはインペインティングを使う。
最終編集、色調整、文字組み、合成、音声ミックス、納品は、引き続き専用の制作ツールで行えます。H3は既存の創作工程のすべてを置き換えようとするより、その工程を拡張するときに最も有用です。
MiniMax H3インペインティングの限界:VRAM、速度、一貫性、工程の複雑さ
VRAMは依然として主な制約の1つです。参照動画、音声条件付け、解像度、長さ、モデル重み、AV潜在表現がメモリを取り合うため、参照の多い工程は高性能GPUでも実用的でなくなる場合があります。
速度にもトレードオフがあります。映像または音声だけを変える場合、選択的再生成は不要な計算を避けられますが、高度なマスクやインペインティングの工程には独自の追加負荷が生じることもあります。
保持の結果は実装にも左右されます。潜在マスクは通常の再生成よりはるかに厳密に承認済み領域を保護できますが、すべてのH3工程で、マスク外のデコード済み画素が数学的に完全一致するという意味ではありません。境界、反射、影、動きの相互作用、遷移は引き続き確認が必要です。
最後に、エコシステムは一般的な編集ソフトより技術的です。ComfyUIはH3に高い柔軟性を与えますが、複雑な工程では、マスク、AV潜在表現の操作、参照、オフロード、デコードの専用ノードが必要な場合があります。
したがって最も有用な問いは「H3は何でも編集できるか」ではなく、「H3に何を変更させるべきか」です。
よくある質問
H3は元の動きを変えず、マスク領域だけをインペイントできる?
はい。潜在表現のノイズ除去マスクは、残りの潜在表現を保護しながら、選択した領域や時間範囲に再生成を限定するためのものです。通常のRef2V再生成より強く保持できますが、マスク境界、反射、影、動く物体との相互作用は、なおフレームごとの確認が必要です。
H3は似た声を生成する代わりに、手元の音声をそのままリップシンクに使える?
はい。ただし、そのまま使いたい音声は、音声参照として渡すだけでなく、再利用または保護する必要があります。参照は音色、話し方、リズム、発話の特徴を導いても、元信号を保持しません。承認済みの台詞、歌、ローカライズ音声では、通常、音声固定のほうが制作上信頼できます。
H3 Ref2Vは12GB VRAMで実際に動作する?
動作しますが、参照の長さと解像度が大きな制約になります。確認した12GB工程の1つでは、20秒の参照により出力は約5秒に制限されましたが、参照を5秒に短縮すると0.4MPで約15秒が可能になりました。そのため、参照を短くすることは実用上大きな違いを生みます。
参照動画や高解像度でH3が大幅に遅くなるのはなぜ?
H3はモデル重み、AV潜在表現、参照、アテンション状態、VAE処理、出力フレームを同時に管理します。作業データ量がVRAMの余裕を超えると、メモリ転送とオフロードによって非線形な速度低下が起こり得ます。正確な原因は工程ごとに異なるため、解像度テストは普遍的なベンチマークではなく、その構成固有の結果と捉えるべきです。
結論:MiniMax H3音声インペインティングがAI動画編集をどう変えるか
MiniMax H3の音声インペインティングが重要なのは、AI動画編集を、専門の制作チームが実際に必要とする制御方式へ近づけるからです。つまり、承認済みの情報を固定し、不確定な部分だけを再生成することです。映像と音声を分けた工程により、音声トラックを置き換えずに視覚領域を修復し、映像を変えずに音を再生成し、曲をそのまま保ちながら新しい演技を作り、良い部分を保護しながらショットを延長できます。したがって最良のH3工程は、AIに最も多くの自由を与えるものではありません。明確に区別するのは、参照、再利用、そしてインペインティングです。そのうえで編集可能領域を最小化し、メモリ制約を守り、選択的再生成を制御された制作工程に組み込むワークフローが最も有効です。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao