
MiniMax H3 参照ガイド:画像・動画・音声を解説
 Yifan Zhao読了 12 分 ·
MiniMax H3 の参照素材を使うと、クリエイターは異なる素材で動画の見た目、動き方、音を制御できます。画像は同一性、衣装、製品、環境に、動画は動き、演技、カメラの挙動、タイミングに、音声は声質、音楽、リズム、音の特徴に適しています。これらの制御は、MiniMax H3 のモーション転送で特に重要です。異なる参照素材が同一性、動き、カメラ、音をそれぞれ担当できるためです。
課題は、参照素材同士が競合しないようにすることです。動きの動画から外見が混入したり、複数の画像が同一性を取り合ったりすることがあり、Ref2VA は参照の柔軟性と引き換えに鮮明さが下がる場合があります。実際には、生成前に各参照素材から何を維持し、転送し、無視するかを決めると結果が改善します。構造化したMiniMax H3 プロンプトと再現可能なMiniMax H3 ワークフローによって、これらの役割を制御しやすくなります。
これらのワークフローを拡大するチーム向けに、Virseは参照素材、アセット、複数の AI エージェントを 1 つの無限キャンバスに集め、創作の文脈と長期的な視覚記憶を共有します。Virse では Nano Banana 2、GPT Image 2、Seedance 2.0 を含む 50 以上のモデルを 1 つのキャンバスで利用でき、参照素材を使う生成を、より広範なAI デザインワークフローへと発展させる支援をします。新規ユーザーは無料クレジットで始められ、有料プランではプレミアムモデルと、選択された高速モデルの無制限利用が解放され、大規模な制作ワークフローに対応します。
MiniMax H3 の参照素材とは? その仕組みは?
MiniMax H3 の参照素材は、新しい生成物に特定の属性を与える画像、動画、音声アセットです。H3 を確実に使うには、ファイル形式ではなく参照素材の役割を考えることが重要です。
参照素材 | 最も適した用途 | 一般的な役割 |
|---|---|---|
画像 | 安定した外見 | 同一性、衣装、製品、環境 |
画面のアンカー | 特定の視覚的状態 | 構図、フレーミング、開始または終了の状態 |
動画 | 時間的な挙動 | 動き、演技、カメラ、ペース |
音声 | 音の特徴 | 声、音楽、リズム、質感 |
単純な制作上の役割分担なら、画像 1 を同一性、画像 2 を衣装、動画 1 を振り付け、動画 2 をカメラの動き、音声 1 を声質に割り当てます。この「参照素材 1 つに主要な役割 1 つ」という方法は技術的制限ではなく、曖昧さを減らす実践的な手法です。
MiniMax H3 の参照素材の制限
ワークフローを計画する際には、H3 の公式仕様も重要です。
入力または出力 | 制限 |
|---|---|
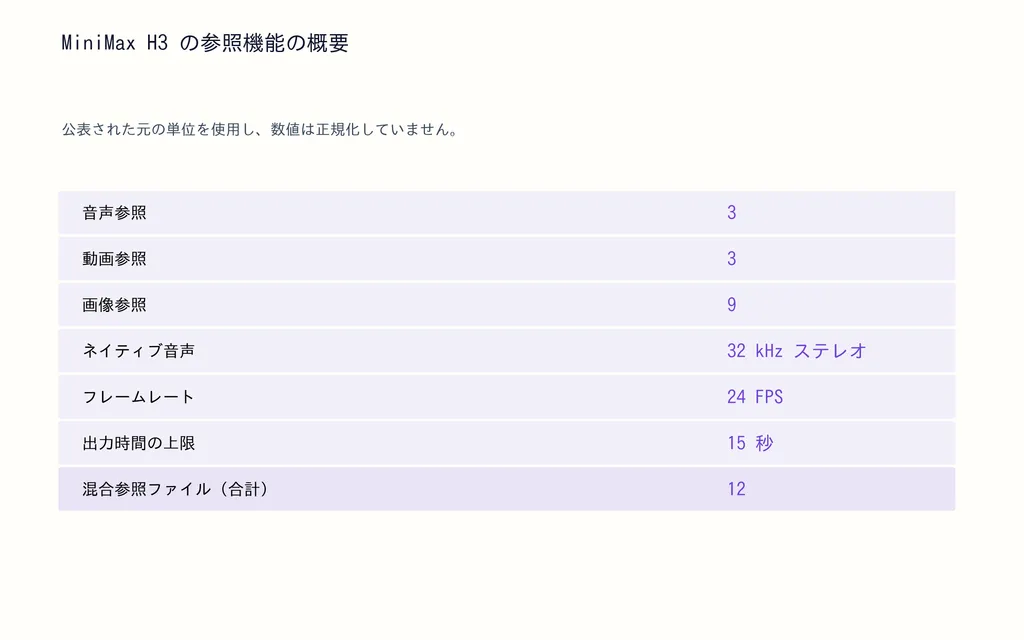
参照画像 | 最大 9 枚 |
参照動画 | 最大 3 本、各 2~15 秒、合計 15 秒 |
参照音声 | 最大 3 本、各 2~15 秒、合計 15 秒 |
混合参照ファイル | 最大 12 個 |
音声のみの Ref2VA 入力 | 非対応 |
出力時間 | 4~15 秒 |
出力フレームレート | 24 FPS |
ネイティブ音声 | 32 kHz ステレオ |
実践上の意味は単純です。使用できる参照素材数は、大半のプロジェクトで実際に使うべき数より多いのです。ショットを明確に定義できる最小限の素材から始めます。
MiniMax H3 の画像参照は同一性と外見をどう制御するのか?
MiniMax H3 の画像参照は、フレームを通じて視覚的に識別できる状態を維持すべき属性に適しています。具体的には、顔、髪型、衣装、製品形状、素材、環境、視覚的スタイルです。
MiniMax H3 の被写体参照と画面アンカーの比較
被写体参照は、繰り返し使う人物や物体を表します。画面のアンカーは、具体的な構図や視覚的状態に近いものです。
要件が「このキャラクターや製品を維持する」なら、被写体を中心とした参照素材を使います。要件が「この特定の画像で始める、または終える」なら、フレームを中心としたワークフローを使います。
キャラクターと製品の一貫性
キャラクターには、互いに一貫性のない複数の肖像よりも、同一性が明確な 1 枚の参照素材の方が有用な場合が多くあります。髪、年齢、服装、体型が競合すると、同一性の維持が弱まることがあります。
製品にはさらに厳密な制約が必要です。映画的なショットでも、ロゴが動いたりシルエットが変わったりすれば使用できません。ブランドの制作では、比率、ロゴの位置、素材、色、特徴的な構造の細部を明確に維持します。
MiniMax H3 の動画参照は動きとカメラをどう制御するのか?
動画参照は、時間とともに展開する情報に最も役立ちます。具体的には、体の動き、振り付け、演技、身振りのタイミング、カメラ軌道、ペース、カット、編集のリズムです。
MiniMax H3 の同一性転送と演技転送の比較
Ref2VA の特に効果的なパターンの 1 つは、次のとおりです。
画像 A がキャラクターの人物像を定義し、動画 B がその行動を定義します。
例えばファッションのワークフローでは、1 枚の画像を同一性、別の画像を衣装、1 本の動画を歩く演技、もう 1 本をカメラの動きに使えます。これにより、1 つのプロンプトに両方を創作させるのではなく、視覚的な同一性と動きを分離できます。
MiniMax H3 のカメラ参照ワークフロー
動画は俳優ではなくカメラを定義することもできます。製品画像で形状を維持しながら、無関係な動画からゆっくりした周回、寄り、手持ちの追従、クレーンのような動きを取り入れられます。
デザインの観点で重要なのは、カメラ表現がクリエイティブディレクションの一部であるためです。同じ製品でも、ショットの動き方次第で、高級感、活気、ドキュメンタリー感が生まれます。
「動きのみ」でも外見が混入する理由
「この動画は動きだけに使う」というのは指示であり、完全な情報抽出の境界ではありません。服装、体型、照明、その他の視覚的特徴が元動画から混入することはあります。
その場合、まず有効なのは通常、参照素材を減らし、目的の同一性を与える素材を強め、動画の役割を絞ることです。
MiniMax H3 の音声参照の仕組みは?
H3 は音声と動画を一緒に生成できるため、音は単なる後処理の層ではなく、創作システムの一部になります。
音声参照は、声質、話し方、音楽、リズム、サウンドトラックの構成、効果音、音の質感に影響を与えられます。
MiniMax H3 の音声再利用と音声参照の比較
音声の再利用とは、既存の信号の全部または一部を維持することです。音声参照とは、生成内容の変化を許しながら特徴を借りることです。
新しい台詞ではこの違いが重要です。元素材で言葉ではなく話者を定義したいなら、クリエイティブディレクションでは声質と話し方を重視し、単に元の音声を再利用する指示にしないようにします。
MiniMax H3 の音声の失敗パターン
記録された H3 ワークフローを調べたところ、次のような問題が繰り返し見られました。
- 音節の繰り返し
- 発話のひずみ
- 意味不明に近い台詞
- キャラクター間の声の混入
- 不十分なリップシンク
- 映像より先に音声が終わる
記録された 20 ステップの Spectrum ワークフローでは、実際の Transformer 評価を 11 回行い、中間の 9 ステップを予測することで、サンプラーの作業量を約45%削減しました。同じワークフローでは、音声が粗くなり、音節の繰り返しも生じました。
制作上の重要な教訓は、許容できる映像を保つ最適化でも、台詞を損なう可能性があるということです。
MiniMax H3 の FL2VA と Ref2VA:どちらを使うべきか?
FL2VA と Ref2VA は異なる制御の課題を解決します。
要件 | 適した選択肢 |
|---|---|
最初のフレームを正確に制御 | FL2VA |
最後のフレームを正確に制御 | FL2VA |
キャラクターと動き | Ref2VA |
キャラクターとカメラ | Ref2VA |
複数の画像参照 | Ref2VA |
音声参照 | Ref2VA |
複雑なマルチモーダル構成 | Ref2VA |
フレーム自体が主な制約なら FL2VA を使います。異なる属性を異なる参照素材から取り入れる必要がある場合は Ref2VA を使います。
FL2VA が適している場面
デザイン済みのキービジュアル、絵コンテのフレーム、必須の終了状態がある場合、FL2VA の方がシンプルな選択になることが多くあります。複数参照の制御が創作上の価値を加えないなら、Ref2VA は不要な複雑さを持ち込む可能性があります。
Ref2VA が適している場面
ショットで異なる素材から同一性、衣装、動き、カメラ、音を組み合わせる場合は、Ref2VA が力を発揮します。
今回調べたワークフローでは、鮮明さの低下、粒状感の増加、知覚される細部の減少が Ref2VA の繰り返し見られる懸念でした。これらは同一シードによる制御されたベンチマークではありませんが、深い参照制御が知覚される画像の忠実度を犠牲にする場合がある、という有用なトレードオフを示しています。
MiniMax H3 の複数の参照素材を競合させずに組み合わせるには?
信頼性の高い複数参照ワークフローは、3 つの問いから始まります。
何を変えずに維持するか。何を転送するか。何を無視するか。
キャラクター動画の場合。
- 維持:顔、髪型、衣装
- 転送:振り付け、カメラ軌道、声の特徴
- 無視:元の演者の同一性、不要な服装、無関係な背景の細部
製品広告の場合。
創作上の変数 | 素材 |
|---|---|
製品形状 | 製品画像 |
俳優 | キャラクター画像 |
環境 | 場所の画像 |
カメラ | 動画参照 |
声またはチャイム | 音声参照 |
タイミング | プロンプト |
レンダリング前に、2 つの参照素材が同じ属性を異なって定義していないか確認します。競合する参照素材を 1 つ除く方が、プロンプトを増やすより制御を改善することがよくあります。
MiniMax H3 の参照プロンプトを改善するには?
優れた H3 プロンプトは、簡潔な制作ブリーフのように読めます。
参照素材の役割と維持する内容を定義する
まず各素材が何を制御するかを示し、次に変えてはいけない細部を固定します。顔、髪型、衣装、製品の形、ロゴ、色、素材などです。
シーンをタイムラインとして書く
動画プロンプトでは、動作がいつ起きるかを記述します。15 秒のショットなら、最初に場面を示し、次に演技を始め、後からカメラの周回を加え、台詞で終える、といった構成にできます。
これにより H3 に時間的構造を与え、クリエイティブチームに明確な確認ポイントを用意できます。
カメラ、音、禁止事項を分ける
カメラの指示では、周回、寄り、手持ちの動き、フォーカス送り、浅い被写界深度など、場面をどう撮るかを記述します。
音の指示では、話者、声の参照、環境音、音楽、タイミングを別々に定義します。禁止事項は、ロゴの変更、誤った俳優の特徴の継承、別の声の混入など、制作上の重大な失敗に絞ります。
目的はプロンプトを長くすることではなく、曖昧な判断を減らすことです。
実用上重要な MiniMax H3 の性能データとは?
今回の調査には複数のローカルワークフローが含まれます。標準化されたベンチマークではありませんが、試行のコストがいかに急増し得るかを示しています。
ハードウェア/ワークフロー | 報告された結果 |
|---|---|
RTX 4070 Ti SUPER 16GB | 640×832:1.63 秒の動画に 2 分 09 秒、736×960:6.58 秒の動画に 6 分 55 秒 |
RTX 6000 PRO 96GB | 1K:ベースライン 14 秒、EasyCache 8 秒。2K:ベースライン 37 秒、EasyCache 22 秒 |
RTX 5090 の長尺制作 | 約 1.5 MP の 15 秒クリップに約 10 分 |
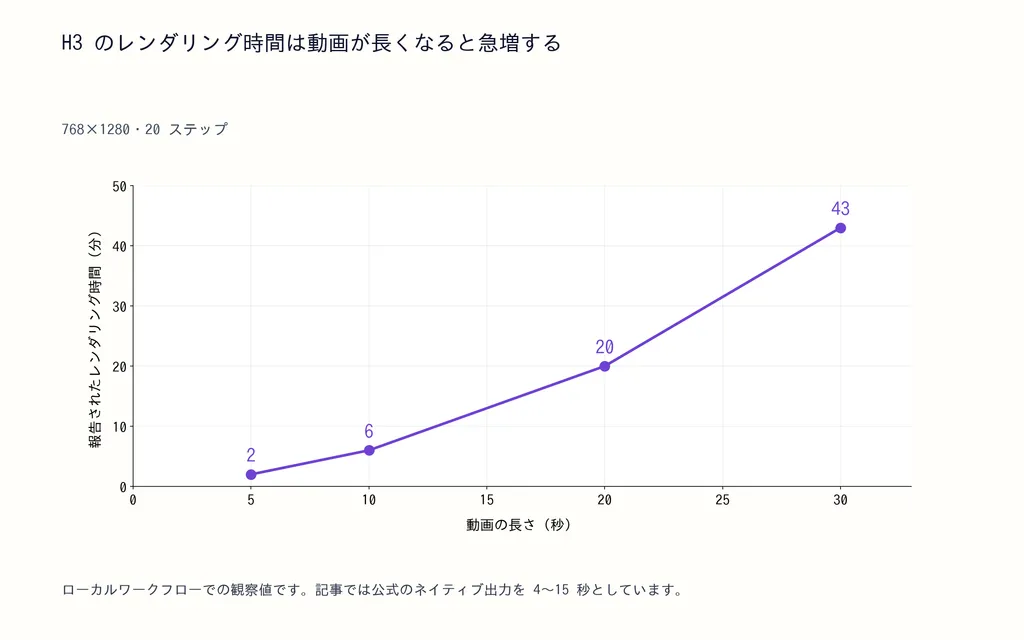
768×1280、20 ステップ | 5 秒:2 分、10 秒:6 分、20 秒:20 分、30 秒:43 分 |
最も重要な実践上の教訓は、生成する動画が長くなると、コストが不釣り合いに増える可能性があることです。最終品質に投資する前に、低コストの試作で参照素材、動き、フレーミング、シードを検証します。
MiniMax H3 は静止画を生成できるのか?
H3 は、ポスター、キャラクター設定シート、衣装編集、場所の変更、カメラアングルの変更といった実験的な静止画ワークフローにも使われています。記録された RTX 5090 RunPod ワークフローでは、1920×1088 の画像編集に約 8 秒と報告されています。
これは公式のネイティブ画像モードではなく、ワークフロー上の工夫と理解する方が適切です。
MiniMax H3 の長い動画で一貫性を保つには?
ネイティブ出力は 4~15 秒なので、長い制作物には通常、セグメント単位の続きの生成が必要です。
ある記録されたワークフローでは、直前の約22 フレームを次の生成に渡していました。別のワークフローでは、約 2 分の作品を組み立てる際、各区間の最後の2~3 秒を再利用していました。
実用的な長尺制作のワークフローは次のとおりです。
- 短いクリップを生成する。
- 成功したテイクを選ぶ。
- 終了時の視覚的状態を保持する。
- 同一性と衣装の参照素材を再利用する。
- 次のセグメントを生成する。
- 成功したクリップをつなぐ。
- 声、環境音、音楽の連続性を個別に確認する。
キャラクター設定シートも、正面、側面、体、髪型、服装、アクセサリーを複数の視点で定義することで役立ちます。
MiniMax H3 の参照素材のベストプラクティス
安定した制作のため、以下の原則を 1 つのチェックリストにまとめます。
- 各参照素材に主要な役割を 1 つ与える。
- 同一性と演技を分離する。
- プロンプトを複雑にする前に、競合する参照素材を除く。
- 時間とシーンの展開を明示する。
- 重要なブランド、製品、同一性の属性を固定する。
- 音声を映像品質とは別に評価する。
- 低コストで試作し、仕上げる価値のある版に計算資源を使う。
これらの原則は、毎回の生成で考え直すより、文書化したMiniMax H3 ワークフローの一部にすることで繰り返し実践しやすくなります。
よくある質問
Ref2VA が FL2VA よりぼやけるのはなぜですか?
今回の調査では、一部の Ref2VA ワークフローで、細部が甘くなる、粒状感が増す、知覚される鮮明さが下がるという報告が繰り返し見られました。これは普遍的な制御ベンチマークではありません。最初または最後のフレームの強い制御だけが必要なら FL2VA の方が簡単な場合があり、複数参照の柔軟性が必要なときに Ref2VA を使います。
FL2VA と Ref2VA のどちらを使うべきですか?
開始または終了のフレームが主要な制約なら FL2VA を使います。異なる素材から同一性、服装、動き、カメラ、音声を組み合わせる必要があるなら Ref2VA を使います。優れたモードは、不要な制御の複雑さが最も少ないものです。
H3 は 15 秒を超える動画を作れますか?
はい。ただし、長い作品は通常、複数の短い生成物を組み合わせます。実用的なワークフローでは、終了フレーム、直前の数秒の映像、キャラクター参照、一貫した音声の方向性を再利用して、セグメント間の不連続を減らします。
H3 は静止画を生成できますか?
H3 は実験的なワークフローで静止画の生成や編集に使えますが、公式のネイティブ画像モードと同じではありません。記録された用途には、ポスター、キャラクター設定シート、衣装編集、カメラアングルの変更があります。
まとめ
MiniMax H3 は、画像・動画・音声の参照素材を、単なる文脈の集合ではなく、創作上の役割をそれぞれ担う独立した素材として扱うときに最も力を発揮します。通常、画像は安定した視覚的同一性、動画は時間的な挙動、音声は音の特徴を定義し、プロンプトは素材同士の関係を説明すべきです。Ref2VA は深いマルチモーダル制御を可能にしますが、その柔軟性には鮮明さ、音声の信頼性、一貫性、計算コストのトレードオフが伴う場合があります。そのため、有効な制作戦略は、各参照素材に明確な役割を与え、同一性と演技を分離し、重要な属性を固定し、時間に沿ってシーンを構成し、音声を独立して検証し、最終レンダリング前に低コストで試行することです。この参照重視の手法が適する場面を検討するチームには、MiniMax H3 を使うべき場面が実践的な次の一歩になります。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao