
MiniMax H3 のモーション転送の使い方:動画から動画への生成ガイド
 Yifan Zhao読了 13 分 ·

MiniMax H3 のモーション転送では、参照動画で動き、タイミング、カメラワーク、演技を制御し、別の画像と音声の参照素材でキャラクターの同一性、外見、声を定義できます。MiniMax H3 の使い方を学ぶ際の中心的な課題は、H3 に動きを認識させることではありません。各参照素材が適切な属性を制御することを確実にすることです。
参照動画には、俳優、背景、フレーミング、表情、カメラの挙動、そして多くの場合は音声も含まれます。これらの信号が競合すると、元の人物の特徴の混入、動きのずれ、背景の変化、顔の不一致が生じることがあります。信頼性の高いMiniMax H3 ワークフローでは、何を維持し、何を変更し、どの参照素材が各判断を担うかを明確にして競合を減らします。構造化したMiniMax H3 プロンプトを使うと、この役割分担を伝えやすくなります。
こうしたワークフローを再現可能な制作工程にしたいチームに向けて、Virseは AI 生成と、プロのクリエイティブな共同作業向けに作られた無限キャンバスのワークスペースを組み合わせています。マルチエージェントのクリエイティブワークフローという手法で参照素材、出力、プロジェクトの文脈を結び付け、さらに幅広い要件整理から納品までの AI デザインワークフローによって、複数モデルへの作業の振り分けを支援します。有料プランでは Nano Banana 2、GPT Image 2 を含む 40 以上のモデルを無制限に利用でき、席数も無制限です。新規ユーザーには、Nano Banana 2 の画像約 10 枚、または Seedance 2.0 の動画 1 本を生成できる無料クレジットも付与されます。
MiniMax H3 のモーション転送と参照生成とは?
MiniMax H3 のモーション転送は、H3 のより広範な参照生成システムの用途の 1 つと捉えると理解しやすくなります。H3 は元動画を丸ごとテンプレートとして扱うのではなく、画像、動画、音声、テキストを組み合わせ、異なる入力が出力の異なる部分に影響するようにできます。
MiniMax H3 のモーション転送と従来の V2V の比較
従来の V2V ワークフローは、見た目を変えながら元動画の構造の多くを維持するのが一般的です。H3 では、より選択的に扱えます。
参照素材 | 最適な役割 | 主なリスク |
|---|---|---|
画像 | 同一性、顔、服装 | ポーズや背景の混入 |
動画 | 動き、タイミング、カメラワーク、演技 | 元の俳優やシーンの混入 |
音声 | 声の特徴 | 声の不一致 |
プロンプト | 関係を定義 | 指示の競合 |
「この動画を変換する」から「この動画から何を取り入れるか決める」へと発想を変えることが役立ちます。
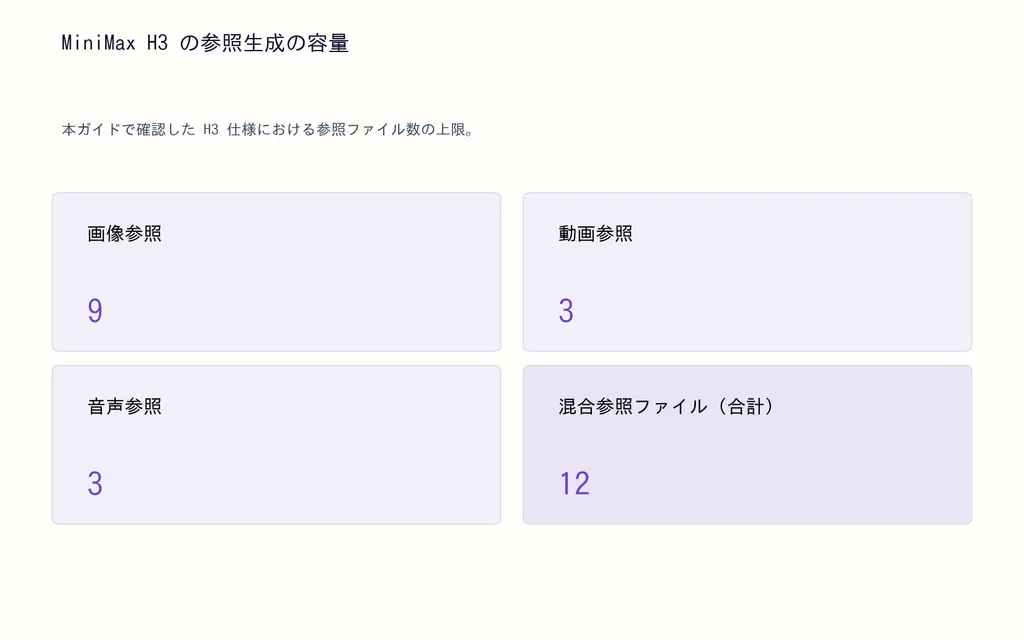
本記事で確認した現行の H3 参照生成の仕様では、最大参照画像 9 枚、参照動画 3 本、参照音声 3 本、異なる種類を合わせて参照ファイル 12 個に対応しています。参照動画は合計 15 秒まで、参照音声も合計 15 秒までで、出力は 4~15 秒です。
MiniMax H3 のモーション転送、動画編集、I2V の比較
これらのワークフローは異なる問題を解決します。モーション転送は、動画を使って動き、タイミング、カメラワーク、演技を導きます。動画編集は既存の動画から始め、残りを維持しようとしながら選択した内容を変更します。I2Vは静止画から新たな動きを生成し、元動画の動きを再現するものではありません。
デザイナーにとってこの違いが重要なのは、モーション転送が単なるアニメーションではなく、根本的に参照素材同士の関係を扱うものだからです。MiniMax H3 を使うべき場面を理解すると、Ref2V、編集、その他の生成手法のどれが適しているか判断しやすくなります。
MiniMax H3 の参照素材への属性割り当てがモーション転送を改善する仕組み
H3 を分析するうえで最も役立つ枠組みは、参照素材への属性割り当てです。各入力には明確な役割を持たせる必要があります。
動き、同一性、カメラ、音声を別々に割り当てる
一般的なキャラクター置換では、次のようにします。
動画 1 が動きとタイミングを、画像 1 が同一性と外見を提供します。プロンプトでは、何を維持し、何を変える必要があるかを定義します。
別のショットでは、動画 1 がカメラの軌道を提供する場合もあります。クローズアップの動画は顔の演技を、音声は声の特徴を提供できます。
複数の素材が同じ属性を取り合うと問題が生じます。キャラクター画像が新しい顔を定義していても、動画が元の俳優の特徴を強く与えてしまうことがあります。
プロンプトの詳細を増やす前に、不要な参照情報の混入を減らす
記録されたワークフローと繰り返し寄せられる質問を調べると、プロンプトの失敗に見えるものの多くは、実際には不要な参照情報の混入の問題であることが分かります。
実践的な手順は次のとおりです。
- 各素材を定義する。
- 主要な役割を 1 つ割り当てる。
- 維持すべき属性を明示する。
- 変更すべき属性を明示する。
- 新たに目指す内容だけを記述する。
通常は、プロンプトの長さよりも明確な役割分担の方が重要です。
MiniMax H3 のモーション転送プロンプトの書き方
優れた MiniMax H3 のモーション転送プロンプトでは、参照素材同士の関係を読み取りやすくします。より広範なMiniMax H3 プロンプトガイドで扱う原則は、複数の参照素材に異なる役割を与える際に特に重要です。
参照素材、役割、維持する内容、目標を使う
実用的なプロンプトは、次のように簡潔に書けます。
動画 1 は動きの参照素材です。画像 1 はキャラクターの参照素材です。画像 1 のキャラクターが、動画 1 の動きとタイミングで演じます。キャラクターの同一性、髪型、体の見た目、服装を維持してください。柔らかい照明の写真スタジオにキャラクターを配置してください。
ここには、参照素材、役割、維持する内容、目標という 4 つの有用な層があります。
参照素材がすでに制御しているものを重ねて制御しない
複数のキャラクターや参照素材が曖昧な場合、詳しいプロンプトは役立ちます。ただし、長ければよいとは限りません。
カメラワークの転送がよい例です。動画 1 に目的のカメラ軌道がすでにある場合、同じ周回、速度、距離、方向を再度記述すると、競合する指示を加えてしまう可能性があります。
テキストは、参照素材の明確な情報を繰り返すのではなく、不確実さを解消するために使います。
MiniMax H3 Ref2V でキャラクターを置き換える方法
キャラクター置換は、動きと同一性を異なる素材から得られるため、H3 の用途として特に分かりやすいものの 1 つです。
単一キャラクターの置換と参照素材のフレーミング
参照素材を目指す演技に合わせます。全身の動きには全身画像を、顔の演技にはクローズアップ画像を使います。
次に、出力を以下の観点で個別に評価します。
- 同一性。
- 服装。
- 動きのタイミング。
- カメラ。
- 環境。
見た目が魅力的でも、顔が変わったり元の演者が一部残ったりしていれば、結果としては失敗になり得ます。
2 人のキャラクター置換の事例
ある記録されたワークフローでは、10 秒の 2 人のダンス動画と、別々のキャラクター画像 2 枚を使用しました。元の動きと環境を維持しながら、両方の演者を置き換えることが目的でした。
維持する内容の指示を改善したところ、このワークフローではその特定の設定で約 90% の置換成功率が報告されました。ただし、シードの変更は引き続き結果に影響しました。
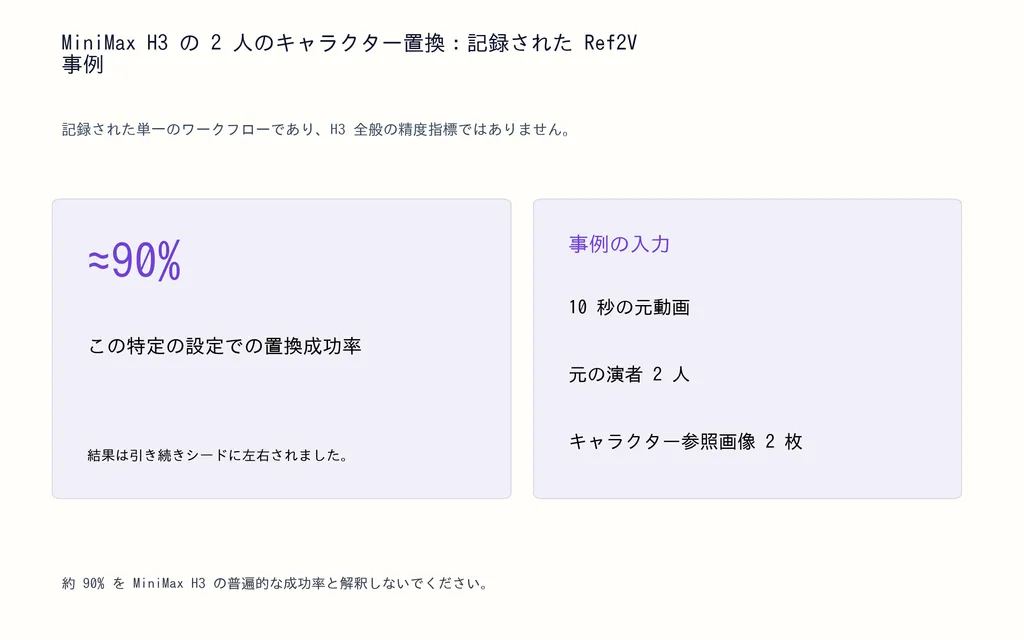
これは H3 全般の精度ではありません。より有用なことを示しています。複数キャラクターの参照素材の役割分担は実用的ですが、結果は依然として確率的であり、決定的ではありません。
MiniMax H3 のモーション転送を崩さずに背景を変更する方法
1 回の生成でキャラクター、動き、環境を変更すると、競合する条件が増えます。
1 回の Ref2V が不安定になる場合
歩く、振り向く、簡単な身振りといった大きな動作は、キャラクターと背景を同時に変更しても維持できる場合があります。
細かな指の動き、顔の演技、唇の動き、複雑な振り付けは影響を受けやすくなります。今回の調査では、同じ処理で環境の置換も行うと、これらの細部がずれやすくなることが分かりました。
複雑な動きと背景変更は 2 回に分ける
難しいショットでは、次のようにします。
- 元の動きと環境を維持しながらキャラクターを置き換える。
- 同一性、手、顔、タイミングを確認する。
- 成功した出力を次の参照動画に使う。
- 2 回目の生成で背景を置き換える。
複数の変更が競合する場合、プロンプトを長くするよりも、処理を分けた方が制御しやすくなることがあります。
MiniMax H3 でカメラの動きと顔の演技を転送する方法
モーション転送は体の動きに限りません。参照動画は、カメラの軌道や演技も提供できます。
MiniMax H3 のカメラワーク転送
参照素材にカメラの動きがすでに含まれる場合、その動きは動画に任せ、プロンプトでは新しい被写体と環境を定義します。
これにより、同じカメラの挙動を 2 つの素材が別々に制御することを避けられます。
カメラワークの転送では、参照動画のカメラがどう動くかを不必要に書き直すより、ショットで新しくなる内容を記述します。
MiniMax H3 の表情と演技の転送
顔の演技は、参照素材で微細な動きが読み取れるときに最もうまく機能します。顔を大きく捉えたクローズアップは、ワイドショットよりも、目や眉の動き、表情の変化、身振りのタイミングについて有用な情報を提供します。
体の形状も重要です。人間の動きを大きく体型の異なるキャラクター、特に四足の被写体に対応させると、より多くの解釈が必要になり、ずれが生じる可能性が高まります。
MiniMax H3 のキャラクターの一貫性を改善する方法
キャラクターの一貫性は、プロンプト設計と同じくらい参照素材の設計に左右されます。
参照素材のフレーミングを目標のショットに合わせる
ある記録された一貫性維持のワークフローでは、1024 × 1024 の上半身のキャラクター参照画像 2 枚を使い、1376 × 768で生成しながら、キャラクターと声の参照素材を組み合わせました。顔がカメラに近い場合に、顔の一貫性が高まることが観察されました。
実践上の教訓は、同一性の維持は撮影技法にも関わる問題であるということです。H3 には、特徴を識別するために十分な視覚情報が必要です。
参照画像の解像度にはトレードオフがある
別のワークフローでは、参照画像の実効サイズを大きくすると似具合が改善したと報告されています。その設定では、長辺がおよそ2,500 ピクセル以下の参照画像は実用的でしたが、4K を超える画像では処理が大幅に遅くなりました。
これは、すべてのワークフローで解像度を最大にすべきだという証拠ではありません。より強く裏付けられているのは、適切なフレーミングと読み取りやすい同一性の情報であり、ピクセル数やアスペクト比を厳密に合わせることではありません。
解像度と計算資源が MiniMax H3 Ref2V に与える影響
解像度を上げると、鮮明さ以外も変わることがあります。プロンプトへの追従性、同一性の一貫性、生成コストにも影響し得ます。
352p、416p、768p では挙動が異なることがある
ある制御された Ref2VA ワークフローでは、B300 4 基のハードウェア上で同じプロンプトを使った際、768p より 352p と 416p の方が、ショット構造、カメラアングル、キャラクターの配置を一貫して維持しました。
サンプリングステップ数を増やすと視覚的な整合性は改善しましたが、構造の制御は完全には回復しませんでした。他の記録されたワークフローでは異なる結果が出ているため、解像度に関する普遍的な規則と捉えるべきではありません。
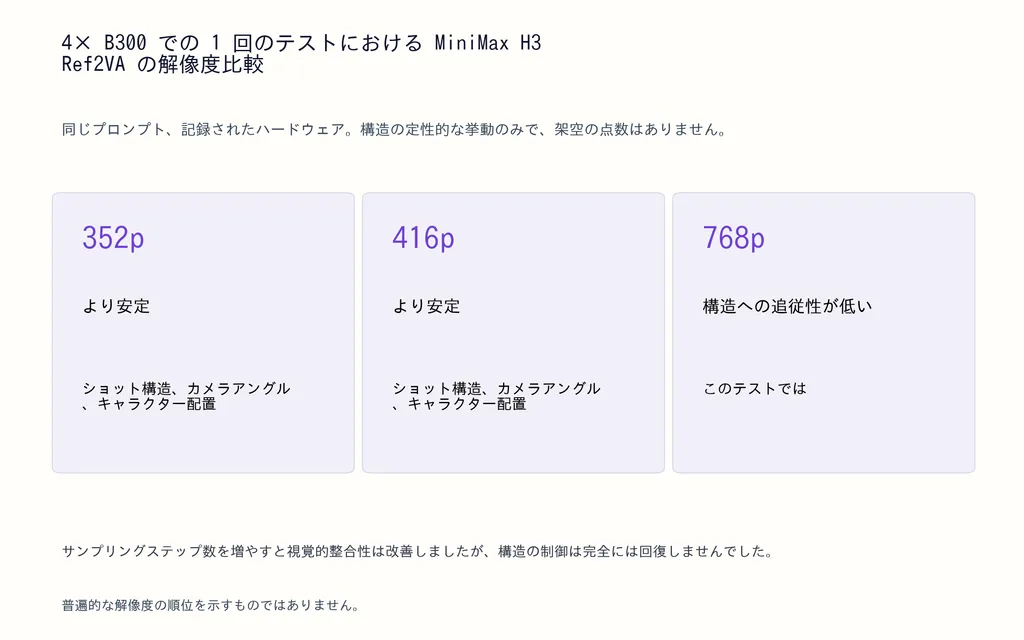
高解像度だからといって、参照素材への追従性が高まるとは限りません。
高性能ハードウェアでも Ref2V の負荷は大きい場合がある
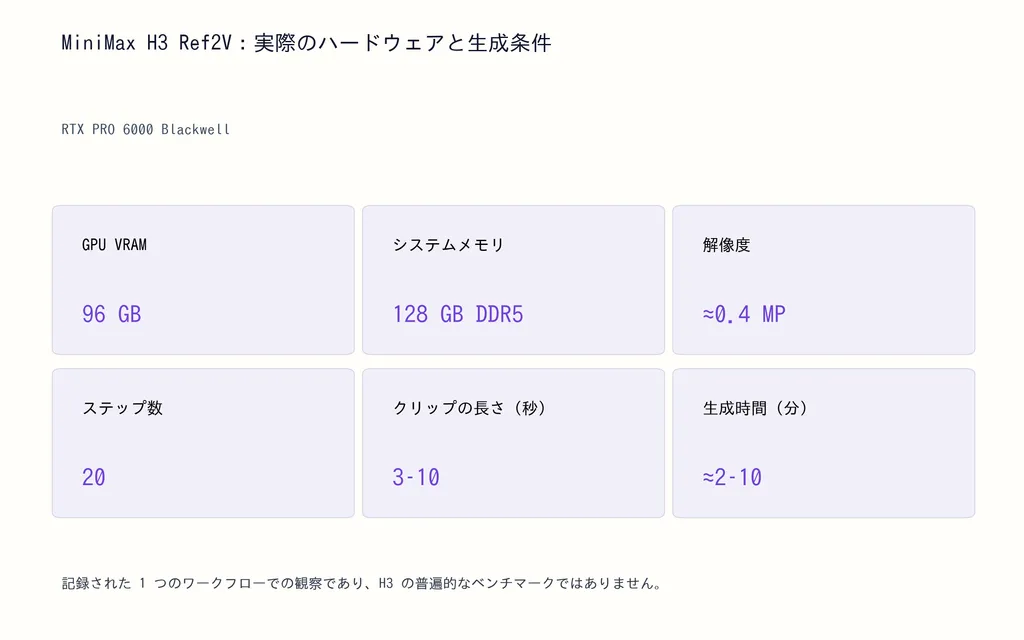
ある複雑な V2V ワークフローでは、VRAM 96GB の RTX PRO 6000 Blackwell と DDR5 128GBを使い、約0.4 MP、20 ステップで、3~10 秒のテイクに約 2~10 分かかったと報告されています。
制作チームにとって効率的なのは、最終解像度で生成する前に、低コストの設定で参照素材の役割分担、同一性、動きを検証することです。
H3 による音声と長尺動画の続きの処理
音声と連続性には、見落としがちな参照制御の問題がさらに 2 つあります。
H3 の声の参照は発話の完全な維持ではない
今回調べたワークフローには、参照音声をそのままコピーせず、再合成するものがありました。記録されたある事例では、動画と参照音声の間の約0.1 秒のずれが、単語の欠落やイントネーションの変化につながる可能性がありました。
重要な違いは単純です。
声を参照することは、波形を正確に維持することとは異なります。
そのため、台詞が重要なワークフローでは、元の音声を独立した制作素材として扱うべきです。
H3 の長尺動画の続きは短いクリップの連結が効果的
ある記録された続きの生成ワークフローでは、10 秒のクリップを生成し、最後の2 秒、つまり 24 fps で 48 フレームを次の生成の文脈として再利用しながら、キャラクター参照も再度入力しました。
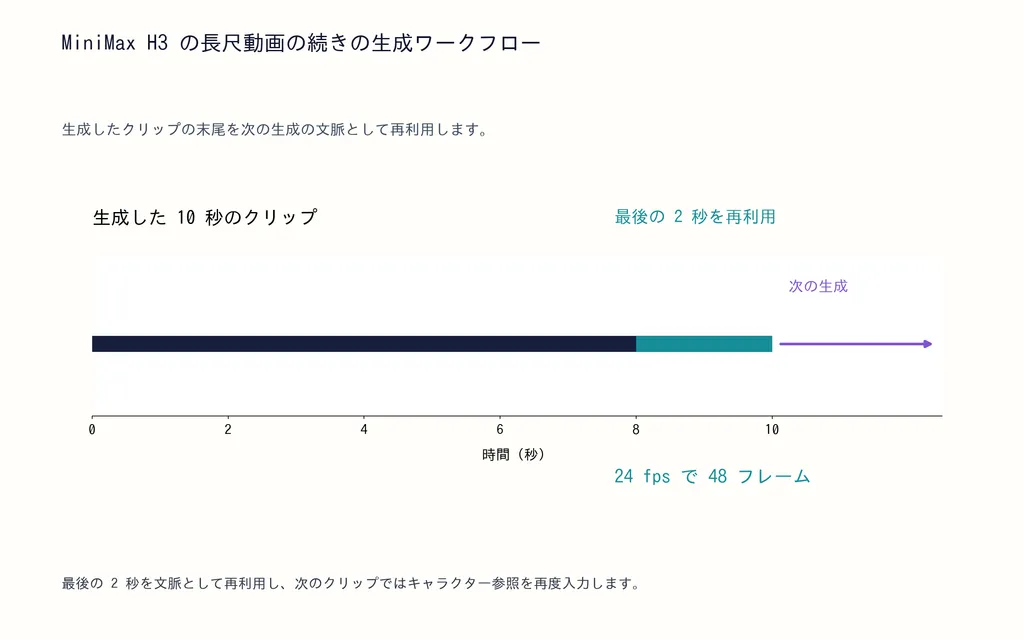
これにより動きの連続性は改善しましたが、色のずれや時折の状態変化は依然として起こり得ました。
長いシーケンスでは、1 回の生成で何もかもいつまでも維持できると想定するより、短いクリップで文脈を引き継ぐ方が実用的です。
MiniMax H3 モーション転送のベストプラクティス
制作では、次の判断が明確な出発点になります。
場面 | 推奨する方法 | 理由 |
|---|---|---|
単純なキャラクター置換 | 1 回の Ref2V | 競合する変更が少ない |
細かな動きと新しい背景 | 2 回に分ける | 微細な動きを守る |
カメラワーク転送 | カメラは動画に任せる | テキストとの競合を減らす |
顔の演技 | クローズアップの参照素材 | 演技が読み取りやすい |
最終的な高解像度出力 | 先に低コストで試す | 計算資源を節約 |
長いシーケンス | 短いクリップを連結 | 文脈を制御しやすい |
全体に共通する原則は次のとおりです。余計な情報の少ない参照素材を使い、目指す演技にフレーミングを合わせ、各素材に明確な役割を与え、忠実度が下がり始めたら変更を分割します。
よくある質問
元の人物をコピーせず、H3 に動きだけをコピーさせるには?
動画は動きの素材として明確に使い、同一性は参照画像に担当させます。画像から何を維持し、動画から何を転送するかを明示してください。元の演者が残る場合は、素材を単純化し、競合する同一性の信号を減らします。
H3 のキャラクター置換で元のキャラクターが残ったり背景が変わったりするのはなぜですか?
動画が動きだけでなく、同一性や環境にも影響している可能性があります。余計な情報の少ない参照素材、相性のよいフレーミング、明確な役割分担、キャラクター置換と背景置換の分離によって、この混入を減らせます。
Ref2V は 1 回と 2 回のどちらで行うべきですか?
単純な動きなら 1 回から始めます。細かな手の動き、顔の演技、唇の動き、複雑な振り付け、背景置換のすべてに正確さが必要な場合は 2 回に分けます。まずキャラクターと動きを確定し、次に環境を変えます。
H3 は参照動画の発話を正確に維持できますか?
ここで調べたワークフローでは、確実にはできません。発話が再合成されたり、変更されたり、タイミングの変化によって不正確になったりすることがあります。台詞の正確さが重要なら、Ref2V がそのまま再現すると考えず、元の音声を別に保持してください。
まとめ
MiniMax H3 のモーション転送は、単純な V2V 効果ではなくマルチモーダルな参照アーキテクチャとして扱うと、はるかに制御しやすくなります。優れたワークフローは、同一性、動き、カメラ、演技、環境、音声を明確な素材に割り当て、競合する指示を最小限に抑え、目指すショットに合う参照素材を使い、解像度を上げる前に効率的に検証し、必要に応じて複雑な変更を複数回に分けます。最も役立つ問いは、もはや「H3 のプロンプトをどう長く書くか」ではなく、「このショットの各部分をどの参照素材に制御させるべきか」です。
著者:Yifan Zhao — AI デザインワークフローのストラテジスト、クリエイティブテクノロジーアドバイザー。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao