
Seedance 2.5 参照ガイド:画像・動画・音声の使い方
Vincent読了 13 分 ·
Seedance 2.5 は、画像で同一性と外見、動画で動きとカメラ、音声で声とリズムを制御すると最も効果的です。目的は参照を増やすことではなく、各参照に 1 つの明確な役割を与え、キャラクター、商品、環境、動作を制御しやすくすることです。この原則は、Seedance 2.5 の使い方と、繰り返し使えるSeedance 2.5 ワークフローを築くうえで中心となります。
これらの制御が重なると問題が起こります。矛盾するキャラクター画像、不整合な絵コンテ、過剰な音声・映像入力は、同一性の崩れ、連続性の誤り、不要なやり直し、制作費の増加を招くことがあります。解決策はシンプルです。生成前に、画像・動画・音声の各参照で何を制御するかを正確に決めます。体系的なSeedance 2.5 プロンプトガイドと意図的な参照素材の計画が、それぞれの役割を明確にする助けになります。
大量の参照素材を使う創作業務を管理するチームにとって、Virse は、AI をチャットのプロンプトだけに縮めず、デザインの過程へ取り込みます。無限キャンバス、マルチエージェントの協働、共有プロジェクト文脈、チームの長期記憶により、デザイナーは参照素材を整理し、並行する創作タスクを調整し、ブランドやワークフローの知識をプロジェクト間で保持できます。この方法は、より広範なAI デザインエージェントの創作ワークフローや、より体系的な依頼から納品までの AI デザインワークフローにも役立ちます。
Seedance 2.5、Seedance 2.0、MiniMax H3は現在、Virseで利用でき、チームは同じ創作ワークフロー内で複数の主要動画モデルを試して比較できます。
Seedance 2.5 R2V とは何か、どう動くのか?
Seedance 2.5 R2V は、テキストに加えて画像・動画・音声を参照として使うマルチモーダル動画ワークフローです。クリエイターはすべての視覚的・時間的な判断をプロンプトで説明せず、専用の元素材に任せることができます。
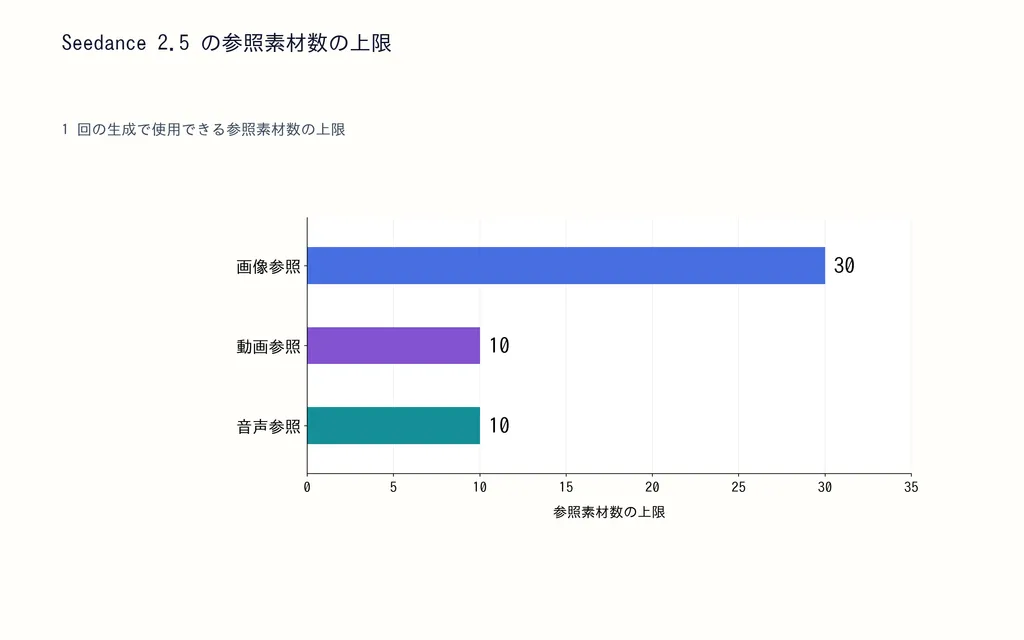
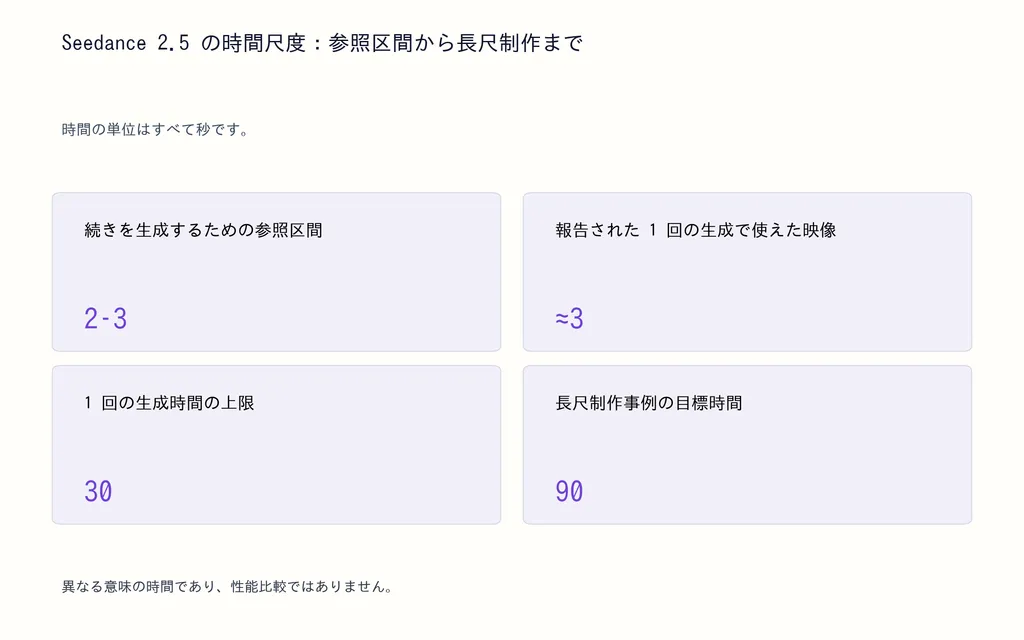
ByteDance の Seedance 2.5 公式発表では、最大30 秒の動画生成と、1 回で最大30 枚の画像、10 本の動画、10 件の音声クリップを使えることが確認されています。この大規模なマルチモーダル入力は、Seedance 2.5 の参照ワークフローの重要な要素です。
画像・動画・音声の参照で何を制御すべきか?
参照素材 | 最適な用途 | 主なリスク |
画像 | 同一性、商品、衣装、環境、主要な視覚状態 | 矛盾する外見の情報 |
動画 | 動き、立ち位置と動線、タイミング、カメラ移動 | 不要な被写体や背景のコピー |
音声 | 声の方向性、セリフ、リズム、音楽、音の合図 | 元の音声が固定されると思い込むこと |
絵コンテ | 構図、順序、シーンの状態 | 内部の連続性の誤り |
前のクリップ | 続きと動きの状態 | 完了した動作の繰り返し |
プロンプトは、割り当ての層として機能し、どの参照がどの属性を制御し、何を引き継がないかを説明すべきです。体系的なSeedance 2.5 プロンプトガイドを使えば、生成前にその割り当てを明確にできます。
Seedance 2.5 の参照競合を避けるには?
最も役立つルールは簡単です。1 つの参照に、1 つの主な役割を与えます。
プロンプトを書く前に参照の対応表を作る
商用動画では、キャラクターの同一性、商品、環境にそれぞれ 1 枚の画像を使い、カメラ移動に動画を、セリフに音声ファイルを使うことが考えられます。
複数の参照で同じ被写体を定義するより、この方が制御しやすくなります。
動画参照では、引き継がない要素も指定しましょう。元クリップをカメラ移動だけに使うなら、その俳優、服装、場所を視覚的な指示として扱わせてはいけません。
デザインシステムの観点では、同一性、環境、動き、音は、できる限りモジュールとして分けるべきです。
指示を増やす前に競合を取り除く
長いプロンプトでも、矛盾する参照を必ず解決できるわけではありません。生成に失敗したら、まず問題を分類します。
- 同一性
- 商品の忠実性
- 環境
- 動き
- カメラ
- 音声
- タイミング
- 連続性
次に、その属性を担う参照だけを確認します。矛盾する素材を 1 つ取り除く方が、プロンプトをもう 1 段落追加するより効果的なことがあります。
Seedance 2.5 では参照をいくつ使うべきか?
Seedance 2.5 の公式参照容量は大きいですが、最大容量が最適な作業セットとは限りません。
最小限で成立する参照セットから始める
単純なショットでは、独自の情報を持つ最小限の素材から始めます。キャラクター、商品、環境、動きの参照だけで足りる場合もあります。
一度生成し、まだ制御できていない要素を確認して、特定の不足変数を補う場合にだけ参照を追加します。
失敗を診断しやすくなり、入力間の不要な競合も減らせます。
5 人のキャラクターのワークフローに見る参照過多
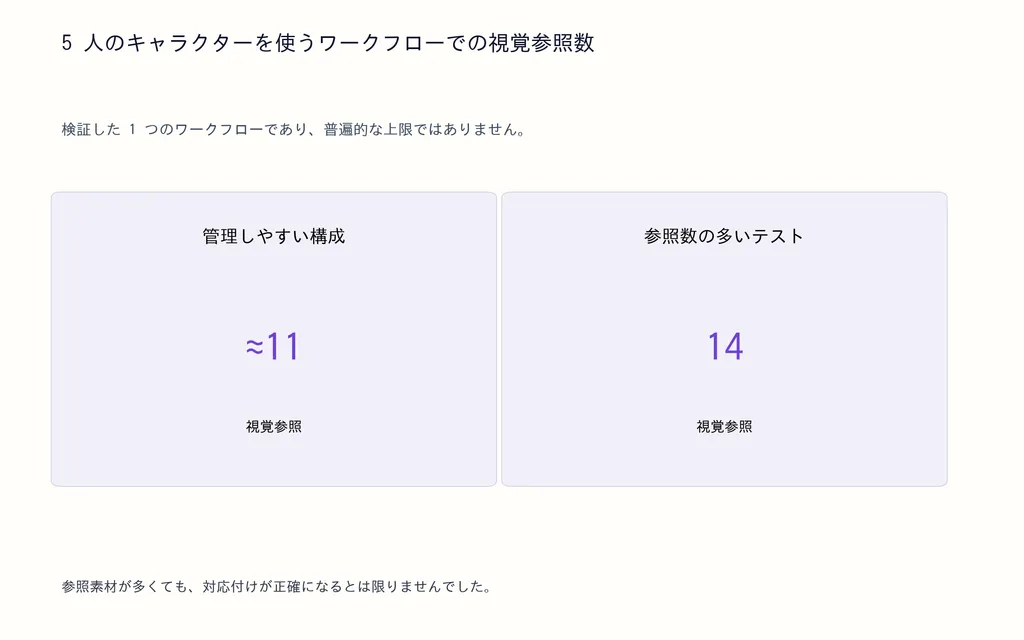
記録のある複数キャラクターのワークフローでは、5 人のキャラクター、5 件の音声参照、最大 14 件の視覚参照を使用しました。視覚参照が約 11 件のときは調整しやすく、14 件に近づけると見た目と声の混同が増えました。
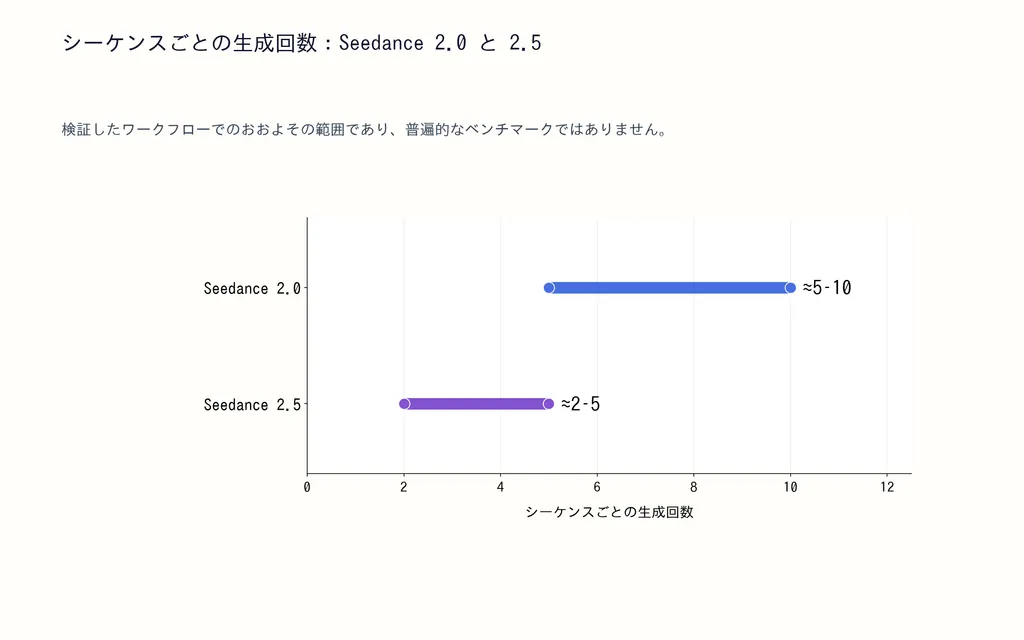
同じ制作比較では、1 シーケンス当たりおよそSeedance 2.0 で 5~10 回、Seedance 2.5 で 2~5 回の生成が必要と報告されました。
専門チームにとってよりよい KPI は参照数ではなく、1 回の生成で得られる使用可能なテイク数です。
Seedance 2.5 で画像参照をどう使うべきか?
画像参照は、動きやショットが変わっても見た目を安定させたい属性に最適です。
キャラクター・商品・環境の参照を分ける
キャラクターでは顔、髪、シルエット、衣装、特徴的なアクセサリーを優先します。商品では形状、比率、包装、ラベル、素材を優先します。環境では建築、照明、空間の雰囲気に注目します。
役割を分けることで反復もしやすくなります。同じ商品を別の環境へ移しても、視覚参照システム全体を作り直す必要がありません。
生成前に絵コンテの連続性を確認する
調査した16 コマの絵コンテワークフローで、重要な制約が明らかになりました。物体の位置やシーン状態の不整合によって、家具が消えたり、背景に想定外の被写体が現れたり、物体の位置が変わったりしました。
空間的な連続性を高めて絵コンテを作り直すと、ほとんどの問題が改善しました。
これは直感に反する教訓です。参照への追従が強いほど、参照設計の弱点が目立つことがあります。生成前にすべてのコマで、継続して登場する小道具、家具、キャラクター、画面内の方向、空間関係を確認してください。
Seedance 2.5 で動画参照をどう使うべきか?
動画参照は、動きとカメラのガイドであり、フレーム単位で正確なモーションキャプチャではないと理解するのが適切です。
動画で動き・動線・カメラ表現を伝える
動画なら、歩く経路、振り付け、カメラの周回、手持ちの動き、ペース、立ち位置や動線をテキストより効率よく伝えられます。
ByteDance は、最終的な素材や照明からカメラ移動、被写体の軌道、空間設計を分離するクレイレンダー参照も紹介しています。専門的なワークフローでは、プリビズで動きを制御し、画像参照で最終的な外見を制御できるため有用です。
すっきりした背景、グリーンバックでの演技、簡略化したプリビズは、不要な情報をさらに減らせます。
俳優の置き換えにはなおトレードオフがある
調査したアクション動画のワークフローでは、Seedance 2.5 は服装と髪をうまく変更した一方、顔の置き換えは不安定でした。その特定事例では Seedance 2.0 の方が顔をうまく扱いましたが、不要なカットや追加の動きが入りました。
R2V を決定論的な編集と捉えるべきでない理由がここにあります。動きへの忠実性、同一性への忠実性、カメラの維持が競合することがあります。
Seedance 2.5 で音声参照をどう使うべきか?
音声参照は、声、セリフ、リズム、音楽、環境音、音の合図を導けますが、音声のガイドは最終音源の固定と同じではありません。
声・音楽・効果音の役割を分ける
声の一貫性が重要なら、参照の主な用途を声に絞ります。音楽で映像のタイミングを制御するなら、重要な動作を拍に対応させます。Seedance 2.5 ワークフローで層を分けられるなら、1 つの混合トラックで声の同一性、音楽のタイミング、効果音を同時に制御しようとしないでください。
音声参照で正確なリップシンクが保証されると思わない
調査したドイツ語のワークフローでは、元の言葉と声を保持しながら対応する映像を生成しようとしていました。しかし、出力が単語、セリフ、声の特徴を変える場合がありました。ユーザーの質問には、声の変化や不要なアクセント変更も繰り返し登場します。
プロジェクトで正確な文言、変更のない録音音声、音素単位の精密なリップシンクが必要なら、一般的な音声参照で自動的に固定されると考えず、別々の制作要件として扱ってください。
Seedance 2.5 の 30 秒プロンプトをどう書くか?
対象がSeedance 2.5 の 30 秒生成なら、最も難しいのは状態の連続性であり、尺ではありません。
各段階を動作・カメラ・終了状態で構成する
シーケンスをいくつかの時間付き段階に分け、それぞれで次を定義します。
- 主な動作
- 対象となる被写体
- カメラの動作
- 終了状態
次の段階には論理的な開始点が必要なため、終了状態が重要です。キャラクターが商品を持って戸口の脇に立つ状態で段階を終えたら、次の動作はその配置から始めるべきです。
タイムスタンプは、フレーム単位で正確な編集点ではなく、ペースを調整する手段として扱ってください。
すべてを再生成せずタイムスタンプ単位で編集する
ByteDance の公式発表によると、Seedance 2.5 にはタイムスタンプ単位の対象を絞った編集も追加されています。
長いショットのワークフローが変わります。特定の動作、音、部分が違うなら、対象を絞った編集は 30 秒全体の作り直しより効率的な場合があります。制作チームにとっては、生成の判断と修正の判断を分けることを意味します。まずショット全体を作り、編集ワークフローが対応していれば局所的な問題を直します。
30 秒では複雑すぎる場面を見極める
セリフと複数の相互作用を含む 7 人の俳優のシーンでは、高額な失敗を重ねた後、より単純なショットに分割しました。
対照的に、記録のある商品ワークフローでは、商品画像 1 枚とプロンプト 1 つから、30 秒の vlog 風広告を 1 回で生成しました。
つまり、30 秒は可能な能力であり、自動的に理想のショット長になるわけではありません。キャラクター数、セリフ、動作の密度、カメラ変更が、実用的な複雑さの上限を決めます。
Seedance 2.5 でより長い動画へ延長するには?
Seedance 2.5 は 30 秒生成に加えて、公式に複数回の延長に対応しています。制作上の課題は、次の部分に前の映像が実際にどれだけ必要かを決めることです。
連続性に必要な直前の状態だけを使う
実用的な続きのワークフローは、前クリップのおよそ最後の 2~3 秒を渡し、一貫したキャラクターと環境の参照を再利用し、次のプロンプトを前の終了状態から始める方法です。
不要な過去の映像を再入力すると、モデルがすでに起きた動作を繰り返すことがあります。
90 秒の事例が示す長尺 AI 動画の実際のコスト
調査の中で最も有力な長尺制作事例は、90 秒の仮想ワンショットを目指したものでした。
このワークフローには次が必要でした。
- 32 回の生成
- 7 つの使用可能なセグメント
- 約 3 日
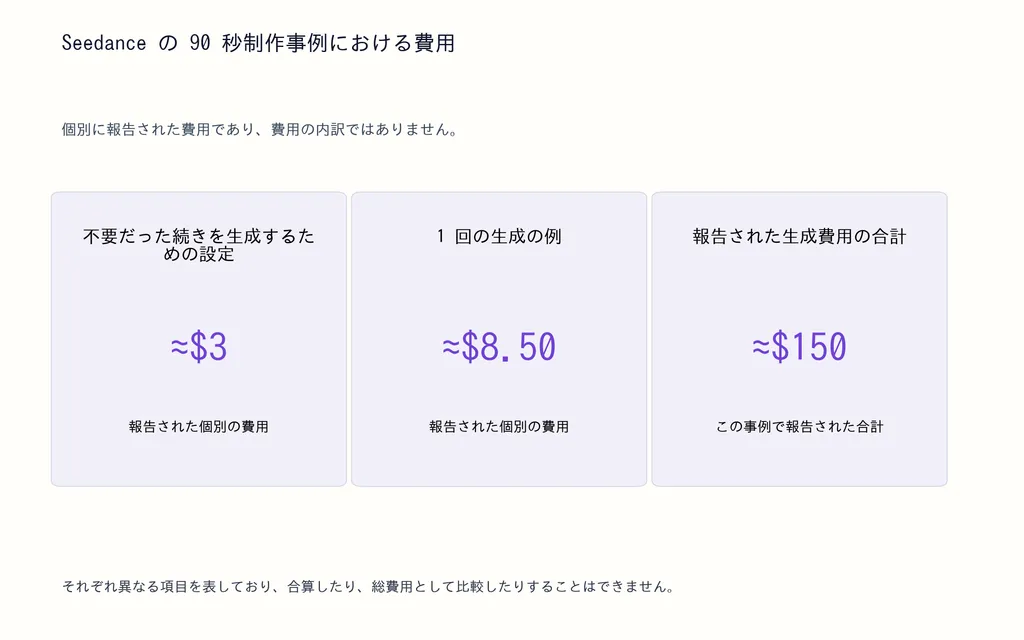
- 約 150 ドルの生成費用
報告では、不要な続きの設定で約 3 ドルを無駄にし、別の約 8.50 ドルの生成では使える部分が約 3 秒しか得られませんでした。
シーケンスには、オプティカルフローや軽微な画角修正を含む、ノンリニア編集ソフトでの仕上げも必要でした。
ここから、より有用な制作指標は、使える 1 秒当たりのコストであり、1 回の生成費用ではないと考えられます。
制作事例から分かる Seedance 2.5 の限界は?
Seedance 2.5 は、被写体、声、相互作用、カメラ変更、シーン状態が増えるほど予測しにくくなります。
複数キャラクターの一貫性は向上したが、複雑さは依然重要
5 人のキャラクターの事例では、2.0 ワークフローよりやり直しが減りました。一方、7 人の俳優の事例は、シーンを単純化して初めて信頼性が上がりました。
ByteDance も、Seedance 2.5 には複雑な動きの物理的な妥当性と、複数被写体の相互作用の安定性を改善する余地があるとしています。
これは制作事例とも一致しています。参照処理が高性能になっても、シーンの複雑さの限界がなくなるわけではありません。
Seedance 2.5 と Seedance 2.0、どちらがよいか?
Seedance 2.5 は、30 秒のストーリーテリング、大規模なマルチモーダル参照セット、構造化された参照利用、対象を絞った編集に強みがありますが、特定のタスクでは 2.0 が異なる挙動を示すこともあります。
バージョン番号ではなくショットの要件で選ぶ
調査したSeedance 2.5 ワークフローでは、2.5 は参照をより文字通りに追従し、複雑なキャラクターシーケンスのやり直しを減らす傾向がありました。その厳密さは、絵コンテの不整合も露呈させました。
一方、2.0 の事例には指定のない動きを積極的に補うものがあり、俳優の置き換えでは、不要な動きが加わる代わりに顔の同一性をよりよく保った例もありました。
実務上の問いは、この特定のショットで、使える出力の割合が最も高いのはどのバージョンか、ということです。
Seedance 2.5 のトラブルシューティングチェックリスト
やり直す前に、失敗した制御を診断します。
まず参照システムを確認する
次を確認します。
- 各参照は独自の情報を提供しているか?
- 2 つの参照が同じ属性で競合していないか?
- 絵コンテの空間は一貫しているか?
- タイムラインの各段階は明確な状態で終わるか?
- 重要な制御を失わずに参照を 1 つ減らせるか?
顔が変化したらキャラクター参照を確認します。動きに失敗したら動作の元素材を単純化します。声が入れ替わるなら競合する音声入力を減らします。続きで映像が繰り返されるなら、前の動画参照を短くします。
プロンプトを増やす前に、失敗した属性を修正します。この診断方法も、体系的なSeedance 2.5 ワークフローの中心です。
よくある質問
Seedance 2.5 では参照をいくつ使えばよいか?
Seedance 2.5 は最大30 件の画像参照、10 件の動画参照、10 件の音声参照に対応しますが、ほとんどのワークフローでは、ショットを明確に説明できる最小セットから始めるべきです。既存素材にない情報を追加できる場合にだけ参照を増やしてください。
Seedance 2.5 は動画参照の動きを正確にコピーできるか?
R2V をモーションキャプチャとして扱えるほどの信頼性はありません。動画参照は、カメラ経路、立ち位置や動線、タイミング、動きの意図に適しています。制御を強めるには、単純化した動作映像やプリビズを使い、同一性と最終的なビジュアルデザインは別の画像参照に任せてください。
Seedance 2.5 は元の音声と正確なリップシンクを維持できるか?
音声参照が音声を完全に固定すると思わないでください。調査したワークフローには、言葉、声の特徴、アクセントが変わった例があります。録音したセリフを正確に保持する必要があるなら、音声の保持と精密なリップシンクを別々の要件として扱ってください。
参照を増やすと Seedance 2.5 の結果が悪くなるのはなぜか?
参照が増えると、制御が競合する可能性も増えます。複数の素材が同一性、スタイル、動き、環境、声を異なる形で示すと、どの情報が採用されるか予測しにくくなります。冗長な参照を減らし、各素材に 1 つの主な役割を与え、素材を増やす前に失敗した属性を診断してください。
結論
Seedance 2.5 は、プロンプトだけの動画生成器ではなく、マルチモーダル参照システムとして扱うと最も役立ちます。30 秒生成、大容量の画像・動画・音声参照、延長ワークフロー、対象を絞った編集は専門制作の可能性を広げますが、記録された事例では、成功は依然としてSeedance 2.5 の参照設計に依存しています。単純な商品広告は 1 回で生成できても、90 秒の連続シーケンスには 32 回の試行と多くのポストプロダクションが必要になる場合があります。そのため、最も有効なワークフローは入力を増やすことではなく、各参照の役割を明確にし、生成前に連続性を設計し、モデルの理論上の限界より使える出力に向けて最適化することです。実験から制作へ進むチームには、体系的なSeedance 2.5 ワークフローが最も明確な次の一歩になります。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao