
Control de pose y profundidad en MiniMax H3: qué hace, cómo funciona y cuándo usarlo
Vincent11 min de lectura ·
El control de pose y profundidad de MiniMax H3 permite controlar con más precisión el movimiento y la estructura espacial mediante Fun ControlNet. Pose restringe la postura y el movimiento corporal, mientras que Depth restringe la geometría de la escena, la posición del sujeto y la estructura relativa a la cámara. Así separa identidad, movimiento, geometría y dirección creativa en lugar de obligar a H3 a deducirlo todo de una sola referencia.
El problema es que entender una referencia no equivale a reproducirla con precisión. Al reemplazar personajes, transferir bailes o hacer retargeting de movimiento, pequeños errores de sincronización, posición corporal, escala o distancia a la cámara pueden causar desviaciones y obligar a generar repetidamente.
Pose y Depth facilitan dirigir H3 al asignar una función más clara a cada entrada: Reference controla la apariencia y la identidad, Pose controla el movimiento, Depth controla la geometría espacial y el prompt controla la dirección creativa. Para los equipos que quieren gestionar estas referencias visualmente, Virse reúne agentes de IA, recursos conectados y contexto del proyecto en un lienzo infinito, facilitando organizar e iterar flujos de H3 controlados sin tratar cada generación como un prompt aislado. MiniMax H3, Seedance 2.5 y Seedance 2.0 ya están disponibles en Virse, para explorar y comparar varios modelos de vídeo destacados en un mismo flujo creativo.
¿Qué es el control de pose y profundidad de MiniMax H3?
Pose Control de MiniMax H3 restringe la postura y el movimiento corporal, mientras que Depth Control restringe la geometría espacial y la estructura relativa a la cámara. Estas funciones proceden de MiniMax-H3-Fun-Controlnet-Union, no de las funciones originales del lanzamiento de H3.
El checkpoint de Fun ControlNet ocupa aproximadamente 6.8 GB y añade una rama de control a 5 de los 50 bloques Transformer de H3. Un solo checkpoint unificado admite varias condiciones estructurales.
Control | Ideal para | Restricción principal |
Pose | Baile, acción y reemplazo de personajes | Movimiento corporal |
Depth | Composición de escena y distancia a la cámara | Geometría 3D |
Canny | Animación guiada por bocetos | Bordes y distribución |
HED | Guía estructural más suave | Límites de los objetos |
MLSD | Arquitectura y productos | Líneas rectas |
El cambio de diseño importante es que el creador puede decidir qué debe permanecer estructuralmente fijo y qué puede reinterpretar H3 de forma creativa.
Vídeo de referencia frente a control de pose en MiniMax H3: ¿qué diferencia hay?
La distinción más clara es:
Reference Video aporta guía semántica. Pose y Depth aportan restricciones estructurales.
El sistema de referencias de H3 admite varias imágenes, vídeos y audios, lo que le permite comprender bien la apariencia, las acciones, las escenas, las expresiones y el comportamiento de cámara.
Cuándo basta con Reference Video de H3
Reference Video resulta útil para transferir la actuación global o la intención visual dejando cierta libertad a H3 para reinterpretar el resultado.
Nuestra revisión de flujos de H3 documentados revela una limitación recurrente: entender una acción no equivale a reproducir con precisión su sincronización y posición corporal.
Eso suele ser aceptable para la exploración creativa. Lo es menos cuando la coreografía o la ubicación del sujeto son requisitos estrictos.
Cuándo conviene más Pose Control de H3
Pose resulta más útil cuando el propio movimiento debe mantenerse constante, por ejemplo:
- transferencia de baile;
- reemplazo de actores;
- ciclos de caminar o correr;
- bloqueo inicial de animación;
- retargeting de movimiento.
Una forma útil de entenderlo es:
Reference controla quién es el sujeto. Pose controla qué hace. Depth controla dónde se sitúa en el espacio.
Pose frente a Depth en MiniMax H3: ¿cuál conviene usar?
Pose y Depth resuelven problemas diferentes, y el tamaño del sujeto puede afectar a la utilidad de cada control.
Por qué Pose funcionó mejor con un personaje pequeño en una prueba
Un flujo documentado generó a 1280 × 704, produciendo una cuadrícula espacial latente de aproximadamente 40 × 22. El personaje ocupaba solo unas 3 de las 22 posiciones latentes verticales.
En ese caso, Depth aún permitía que la figura se acercara a la cámara y aumentara de tamaño, mientras que Pose mantenía su posición de forma más fiable.
Esto no permite concluir que «Pose siempre es mejor que Depth». Muestra que un sujeto pequeño puede aportar información de profundidad relativamente débil tras reducir la resolución.
Cuándo Depth es la mejor opción
Depth es más adecuado para:
- relaciones entre primer plano y fondo;
- movimiento hacia la cámara o alejándose de ella;
- habitaciones y entornos;
- productos grandes;
- objetos no humanos;
- geometría de la escena.
Por tanto, la pregunta correcta no es «¿Pose o Depth?», sino «¿Necesito fijar el movimiento articulado o la geometría espacial?»
Cómo cambia Pose Control el reemplazo de personajes y el retargeting en H3
El reemplazo de personajes es uno de los usos más sólidos porque Fun ControlNet ayuda a separar la transferencia de apariencia de la transferencia de movimiento.
Nuestra revisión de preguntas recurrentes identificó tres problemas comunes:
- El personaje sustituto no sigue la actuación original con suficiente fidelidad.
- La identidad pierde estabilidad durante movimientos complejos.
- Rasgos visuales del intérprete original se filtran al nuevo personaje.
Pose no resuelve la identidad por sí solo. Permite que cada entrada tenga una función más clara:
Personaje objetivo → Reference
Actuación original → Pose
Geometría de la escena → Depth cuando haga falta
Estilo creativo → Prompt
Esto se acerca más a un sistema de diseño profesional: si falla el movimiento, ajusta el movimiento. Si falla la apariencia, ajusta la referencia. Ya no necesitas cambiar todas las variables a la vez.
Cómo ajustar Pose y Depth en H3 sin controlar en exceso
Más condicionamiento no implica automáticamente un control mejor.
Trata Pose y Depth como un presupuesto de control compartido
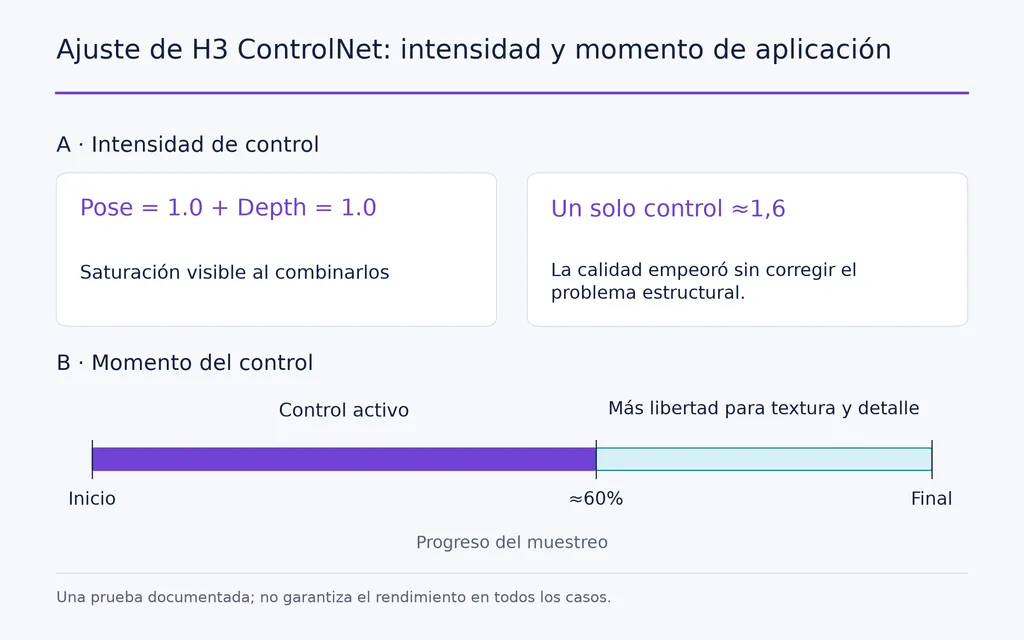
En un flujo con varios controles, Pose con intensidad 1.0 más Depth con intensidad 1.0 produjo saturación visible. Subir un único control hasta aproximadamente 1.6 tampoco corrigió el problema estructural y redujo la calidad visual.
Un flujo más prudente consiste en elegir primero el control principal e introducir gradualmente el secundario.
El momento de control importa tanto como su intensidad
El control estructural puede ser contraproducente si sigue siendo demasiado fuerte al final de la difusión.
Una prueba documentada observó que terminar el control hacia el 60% del programa de muestreo preservaba la estructura importante y daba más libertad a los pasos posteriores para recuperar texturas y detalles de superficie.
El principio práctico es sencillo:
Usa los primeros pasos para establecer la estructura. Deja suficiente libertad a los últimos para terminar la imagen.
Aún no hay suficientes pruebas estandarizadas para recomendar una intensidad o un porcentaje de finalización universal.
Requisitos de VRAM de MiniMax H3 y memoria del vídeo de referencia
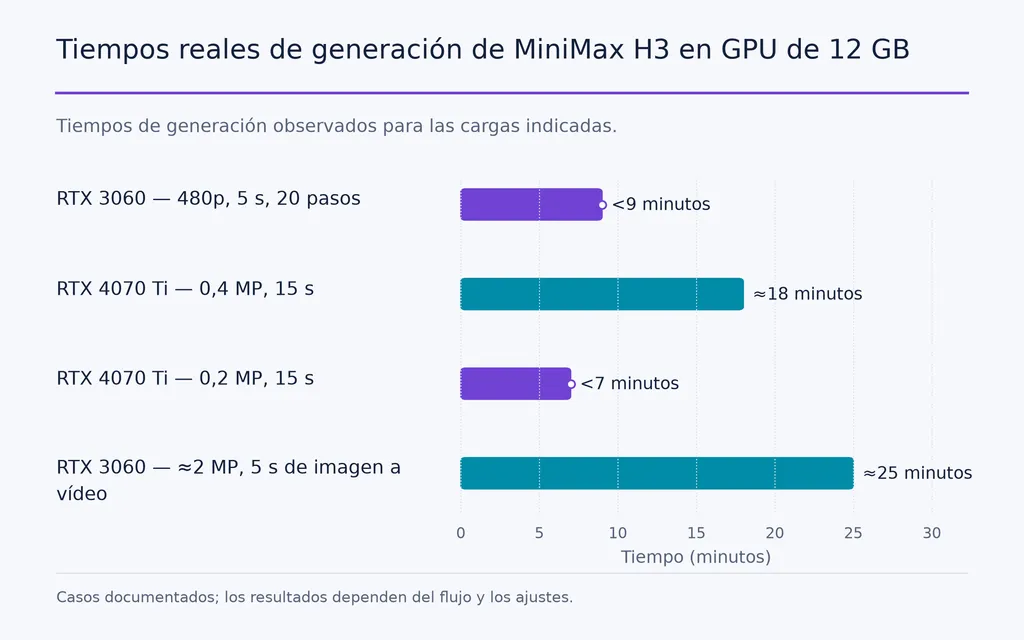
H3 puede ejecutarse en GPU de consumo, pero la VRAM mínima y la VRAM para producir con comodidad no son lo mismo.
GPU | Carga de trabajo | Tiempo observado |
RTX 3060 12GB | 480p, 5 s, 20 pasos | menos de 9 min |
RTX 4070 Ti 12GB | 0.4MP, 15 s | unos 18 min |
RTX 4070 Ti 12GB | 0.2MP, 15 s | menos de 7 min |
RTX 3060 12GB | unos 2MP, 5 s de imagen a vídeo | unos 25 min |
También encontramos flujos funcionales con 8GB y 6GB, pero dependen más de cuantización, descarga a otras memorias, carga por etapas y RAM del sistema.
La duración de la referencia puede ocultar un cuello de botella de VRAM
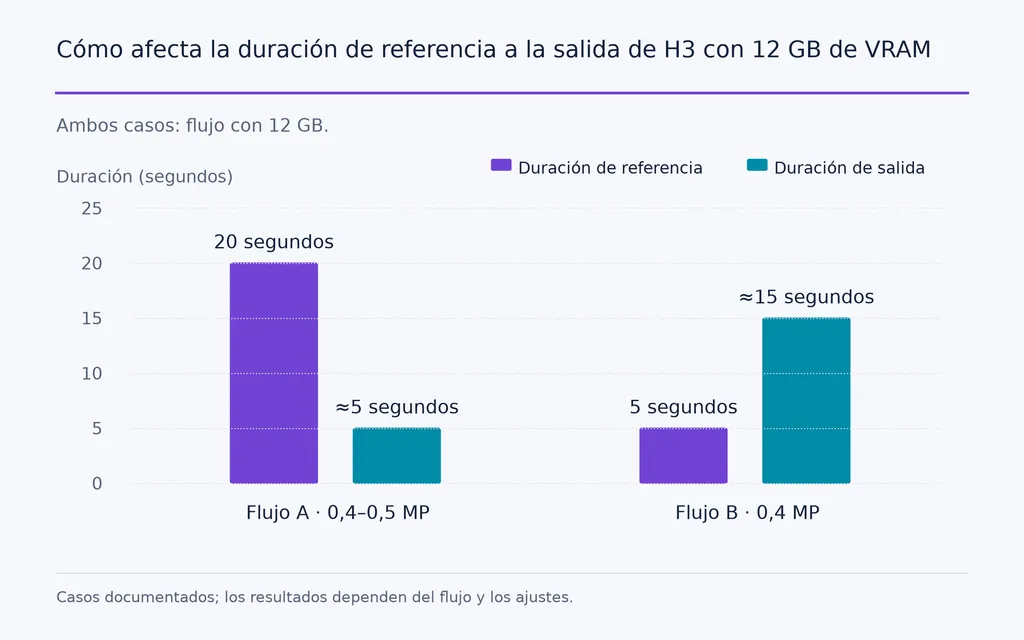
Un caso especialmente útil con 12GB mostró:
- Referencia de 20 segundos → salida de unos 5 segundos a 0.4–0.5MP
- Referencia de 5 segundos → salida de unos 15 segundos a 0.4MP
La referencia más larga acercaba repetidamente el flujo a quedarse sin memoria (OOM).
La lección es importante: los medios de condicionamiento forman parte del presupuesto de memoria. Si H3 agota la VRAM, recorta la referencia antes de sacrificar automáticamente la calidad final.
Rendimiento de GPU de MiniMax H3 y coste en RunPod
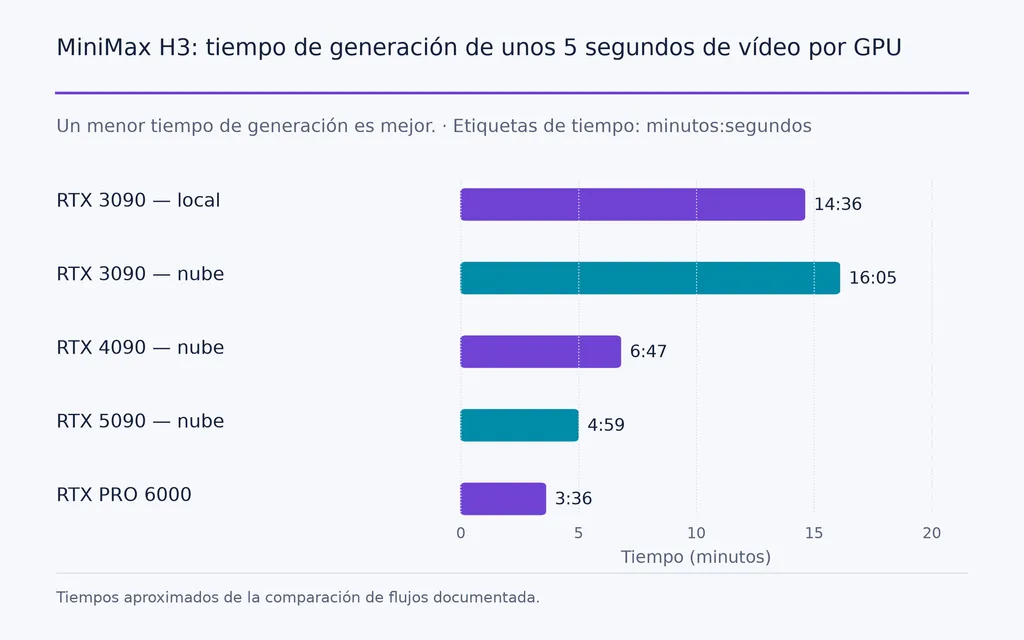
Los datos de flujos comparables muestran también que más VRAM no se traduce linealmente en una generación H3 más rápida.
GPU | VRAM | Tiempo aproximado para 5 s |
RTX 3090 local | 24GB | 14 min 36 s |
RTX 3090 en la nube | 24GB | 16 min 05 s |
RTX 4090 en la nube | 24GB | 6 min 47 s |
RTX 5090 en la nube | 32GB | 4 min 59 s |
RTX PRO 6000 | 96GB | 3 min 36 s |
En este caso, la 4090 fue más del doble de rápida que la 3090 pese a tener la misma capacidad de VRAM.
Un flujo de H3 optimizado en una RTX 4090, con INT8, SageAttention, Turbo LoRA, ocho pasos, aproximadamente 0.9MP y salida de 10 segundos, tardó unos 9–10 minutos, con un coste de cómputo estimado de $0.12 por generación bajo esa configuración específica en la nube.
Eso no es un precio universal de H3. Una métrica más útil es el coste por clip aprovechable.
También hay que separar la optimización de memoria y la de velocidad. Un flujo documentado con una 5090 redujo la memoria GPU compartida en unos 14GB mediante componentes optimizados, pero apenas cambió la velocidad bruta. Otra combinación de optimizaciones para una 4090, con cuantización, cambios en CUDA/Triton y optimización de atención, informó de una mejora global de velocidad de aproximadamente 2.6×.
¿Cuál es el mejor flujo H3 de bajo coste?
La optimización de coste más fiable suele ser previsualizar antes de renderizar el plano final.
- Genera una vista previa de 1–2 segundos a baja resolución.
- Comprueba el encuadre y la escala del sujeto.
- Confirma que Pose sigue realmente el movimiento deseado.
- Valora si Depth ayuda o restringe demasiado el plano.
- Comprueba la identidad y la dirección visual general.
- Aumenta duración y resolución solo cuando la estructura sea estable.
En un flujo con 12GB, las vistas previas cortas terminaban en alrededor de un minuto o menos, frente a muchos minutos para una secuencia completa.
Esto sigue un principio básico del diseño profesional: validar la estructura antes de invertir en el acabado.
¿Cuáles son los problemas más comunes de ControlNet en H3?
Fun ControlNet añade precisión, pero también nuevas formas de fallo.
Los problemas habituales de nuestra revisión incluyen:
- dimensiones incompatibles;
- recuentos de fotogramas incorrectos;
- formas de tensor incompatibles;
- checkpoints incompatibles;
- lotes de control incorrectos;
- conflictos entre backends de atención;
- señales de control que dejan de funcionar sin aviso.
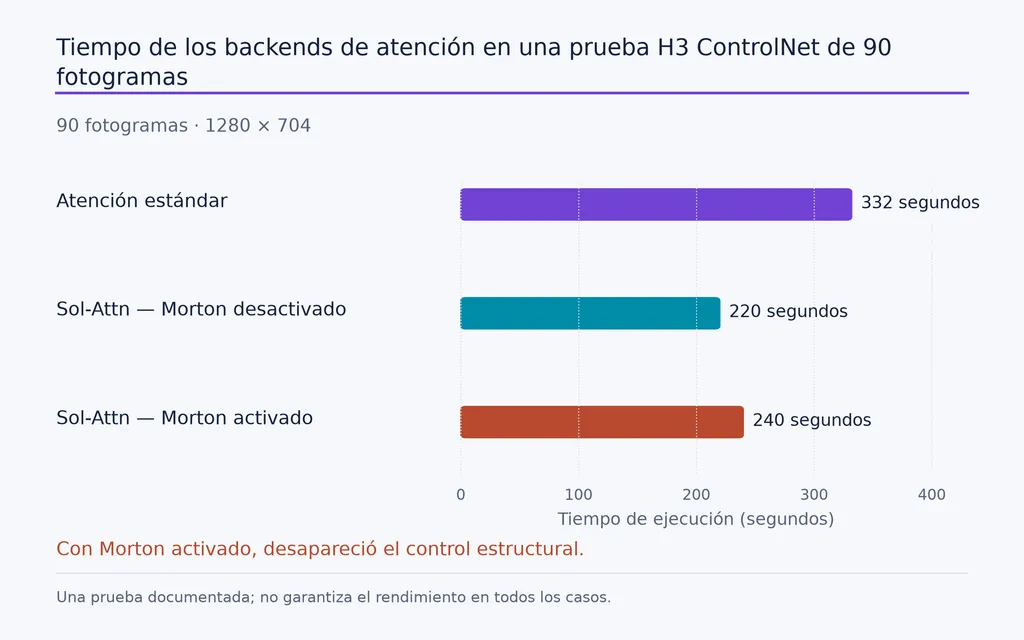
Una prueba de atención especialmente útil comparó el mismo flujo de 90 fotogramas, 1280 × 704:
- atención estándar: 332 segundos
- Sol-Attn sin reordenación Morton: 220 segundos
- Sol-Attn con reordenación Morton: 240 segundos
La última configuración aún generaba vídeo plausible, pero el control estructural prácticamente desaparecía porque el orden de los tokens ya no se alineaba correctamente.
Por eso, toda nueva configuración de ControlNet debería incluir una prueba A/B con el control activado y desactivado usando la misma semilla.
Lo que Pose y Depth todavía no pueden resolver
Pose y Depth mejoran el control estructural, pero no garantizan automáticamente:
- identidad facial perfecta;
- coherencia de la ropa;
- estabilidad del color en vídeos largos;
- manos perfectas;
- menor uso de VRAM;
- generación más rápida;
- cero repeticiones.
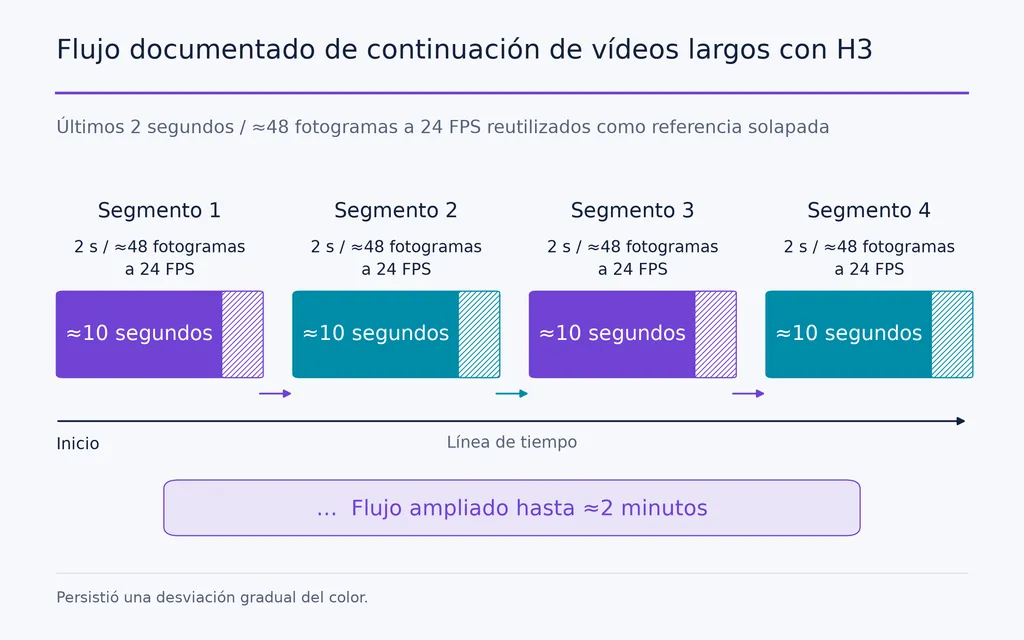
La continuidad larga sigue siendo especialmente difícil. Un flujo documentado generaba segmentos de unos 10 segundos y reutilizaba los últimos 2 segundos, unos 48 fotogramas a 24 FPS, como referencia del siguiente segmento.
El método se extendió hasta unos dos minutos, pero seguía apreciándose una deriva gradual del color.
Esta distinción importa: coherencia del movimiento y coherencia visual están relacionadas, pero no son el mismo problema.
Conclusión
El control de pose y profundidad de MiniMax H3 importa porque Fun ControlNet convierte H3 en un flujo de vídeo más modular: Reference aporta identidad y apariencia, Pose restringe el movimiento articulado, Depth restringe la geometría espacial y los prompts definen la dirección creativa. Los casos documentados también explican por qué sigue exigiendo una mentalidad de producción cuidadosa: varios controles pueden saturar, los sujetos pequeños pueden responder distinto a Depth, las referencias largas consumen mucha VRAM, las optimizaciones de atención pueden romper el control sin aviso y el rendimiento del hardware varía enormemente entre configuraciones. La mejora real no es solo «más control», sino poder diagnosticar, dirigir e iterar movimiento, geometría y apariencia como variables creativas independientes.
Preguntas frecuentes
¿H3 admite Pose y Depth de forma nativa?
No. Pose y Depth no formaban parte de las funciones nativas originales de H3. Se añaden mediante la posterior extensión Fun ControlNet, que también admite controles estructurales como Canny, HED y MLSD.
¿Qué diferencia hay entre Reference Video y Pose Control en H3?
Reference Video ofrece a H3 una guía semántica rica sobre una actuación, mientras que Pose impone una restricción más explícita del movimiento corporal. Usa Reference cuando sea aceptable la interpretación creativa y Pose cuando la coreografía o el movimiento deban seguir una estructura más clara.
¿Pose de H3 puede mantener la identidad del personaje?
No por sí solo. Pose controla la estructura y el movimiento corporal, no la identidad. Para reemplazar personajes, usa Reference para apariencia e identidad, Pose para movimiento y Depth si el plano también necesita más control espacial.
¿H3 puede ejecutarse con 12GB de VRAM?
Sí. Los flujos de H3 documentados en RTX 3060 y RTX 4070 Ti muestran que 12GB de VRAM permiten ejecutar H3, pero resolución, duración, longitud de referencia, cuantización y descarga a otras memorias afectan mucho al rendimiento. Los flujos con menos VRAM sirven para experimentar, aunque suelen exigir más compromisos que las configuraciones de producción con más VRAM.
Más del blog de Virse
Flujo de trabajo

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de octubre de 2026 by Yifan Zhao