
Controle de pose e profundidade do MiniMax H3: funções, funcionamento e quando usar
Vincent11 min de leitura ·
O controle de pose e profundidade do MiniMax H3 oferece controle mais preciso de movimento e estrutura espacial por meio do Fun ControlNet. Pose restringe a postura e os movimentos do corpo, enquanto Depth restringe a geometria da cena, a posição do sujeito e a estrutura relativa à câmera. Isso separa identidade, movimento, geometria e direção criativa em vez de obrigar o H3 a deduzir tudo de uma única referência.
O problema é que entender uma referência não significa reproduzi-la com precisão. Em trocas de personagens, transferência de dança e redirecionamento de movimento, pequenos erros de sincronia, posição corporal, escala ou distância da câmera podem causar desvios e repetidas gerações.
Pose e Depth tornam o H3 mais fácil de dirigir ao definir melhor cada entrada: Reference controla aparência e identidade, Pose controla movimento, Depth controla geometria espacial e o prompt controla a direção criativa. Para equipes que desejam gerenciar essas referências visualmente, Virse reúne agentes de IA, recursos conectados e contexto do projeto em uma tela infinita, facilitando organizar e iterar fluxos controlados do H3 sem tratar cada geração como um prompt isolado. MiniMax H3, Seedance 2.5 e Seedance 2.0 já estão disponíveis no Virse, permitindo explorar e comparar vários modelos de vídeo de destaque no mesmo fluxo criativo.
O que é o controle de pose e profundidade do MiniMax H3?
Pose Control do MiniMax H3 restringe postura e movimento corporal, enquanto Depth Control restringe geometria espacial e estrutura relativa à câmera. Essas capacidades vêm do MiniMax-H3-Fun-Controlnet-Union, não dos recursos originais de lançamento do H3.
O checkpoint do Fun ControlNet tem aproximadamente 6.8 GB e adiciona um ramo de controle a 5 dos 50 blocos Transformer do H3. Um único checkpoint unificado suporta várias condições estruturais.
Controle | Mais indicado para | Restrição principal |
Pose | Dança, ação, troca de personagens | Movimento corporal |
Depth | Composição da cena, distância da câmera | Geometria 3D |
Canny | Animação guiada por esboços | Bordas e disposição |
HED | Orientação estrutural mais suave | Limites dos objetos |
MLSD | Arquitetura, produtos | Linhas retas |
A mudança de design importante é permitir ao criador decidir o que deve permanecer estruturalmente fixo e o que o H3 pode reinterpretar criativamente.
Reference Video e Pose Control no MiniMax H3: qual a diferença?
A distinção mais clara é:
Reference Video fornece orientação semântica. Pose e Depth fornecem restrições estruturais.
O sistema de referências do H3 aceita várias imagens, vídeos e áudios, tornando-o eficaz para entender aparência, ações, cenas, expressões e comportamento da câmera.
Quando Reference Video do H3 é suficiente
Reference Video é útil para transferir a atuação geral ou a intenção visual mantendo alguma liberdade para o H3 reinterpretar o resultado.
Nossa análise de fluxos do H3 documentados mostra uma limitação recorrente: entender uma ação não significa reproduzir precisamente seu tempo e sua posição corporal.
Isso costuma ser aceitável na exploração criativa. Torna-se menos aceitável quando a coreografia ou a posição do sujeito são requisitos rígidos.
Quando Pose Control do H3 é melhor
Pose é mais útil quando o próprio movimento deve permanecer consistente, como em:
- transferência de dança;
- substituição de atores;
- ciclos de caminhada ou corrida;
- bloqueio inicial de animação;
- redirecionamento de movimento.
Uma maneira útil de entender é:
Reference controla quem é o sujeito. Pose controla o que ele faz. Depth controla onde ele está no espaço.
Pose ou Depth no MiniMax H3: qual usar?
Pose e Depth resolvem problemas diferentes, e o tamanho do sujeito pode afetar a utilidade de cada controle.
Por que Pose funcionou melhor para um personagem pequeno em um teste
Um fluxo documentado gerava em 1280 × 704, produzindo uma grade espacial latente de aproximadamente 40 × 22. O personagem ocupava apenas cerca de 3 das 22 posições latentes verticais.
Nesse caso, Depth ainda permitia que a figura se aproximasse da câmera e aumentasse de tamanho, enquanto Pose mantinha a posição do sujeito com mais confiabilidade.
Isso não deve ser generalizado como “Pose é sempre melhor que Depth”. Mostra que um sujeito pequeno pode fornecer informações de profundidade relativamente fracas após a redução de resolução.
Quando Depth é a melhor escolha
Depth é mais apropriado para:
- relações entre primeiro plano e fundo;
- movimento em direção à câmera ou para longe dela;
- cômodos e ambientes;
- produtos grandes;
- objetos não humanos;
- geometria da cena.
Portanto, a pergunta correta não é “Pose ou Depth?”, mas “Preciso fixar o movimento articulado ou a geometria espacial?”
Como Pose Control muda a troca de personagens e o redirecionamento de movimento no H3
A substituição de personagens é um dos usos mais fortes porque o Fun ControlNet ajuda a separar transferência de aparência e transferência de movimento.
Nossa análise de dúvidas recorrentes identificou três problemas comuns:
- O personagem substituto não acompanha a atuação original com fidelidade suficiente.
- A identidade fica menos estável durante movimentos complexos.
- Traços visuais do intérprete original vazam para o novo personagem.
Pose não resolve a identidade sozinho. Ele permite que cada entrada tenha uma função mais clara:
Personagem alvo → Reference
Atuação original → Pose
Geometria da cena → Depth quando necessário
Estilo criativo → Prompt
Isso se aproxima de um sistema profissional de design: se o movimento está errado, ajuste o movimento. Se a aparência está errada, ajuste a referência. Você não precisa mais mudar todas as variáveis ao mesmo tempo.
Como ajustar Pose e Depth no H3 sem controle excessivo
Mais condicionamento não significa automaticamente melhor controle.
Trate Pose e Depth como um orçamento de controle compartilhado
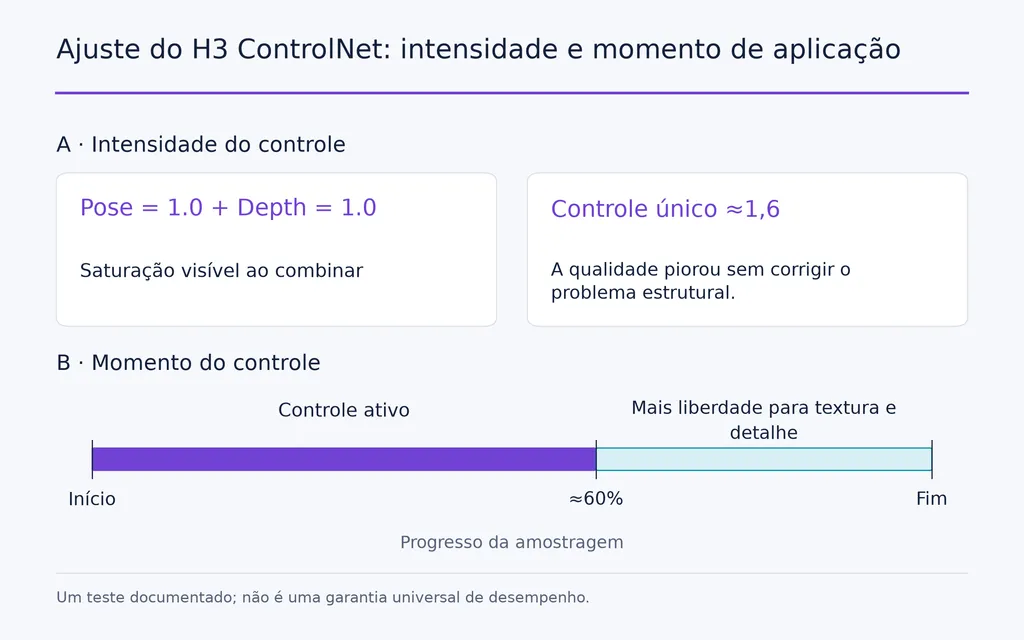
Em um fluxo com vários controles, Pose com intensidade 1.0 mais Depth com intensidade 1.0 produziu saturação visível. Aumentar um único controle para cerca de 1.6 também não corrigiu o problema estrutural e reduziu a qualidade visual.
Um fluxo mais seguro é escolher primeiro o controle mais importante e introduzir o secundário gradualmente.
O momento do controle importa tanto quanto a intensidade
O controle estrutural pode ser contraproducente se continuar forte demais no fim da difusão.
Um teste documentado mostrou que encerrar o controle por volta de 60% do cronograma de amostragem preservava a estrutura importante e dava liberdade às etapas finais para recuperar texturas e detalhes de superfície.
O princípio prático é simples:
Use as etapas iniciais para estabelecer a estrutura. Dê liberdade suficiente às finais para concluir a imagem.
Ainda não há testes padronizados suficientes para recomendar uma intensidade ou porcentagem de encerramento universal.
Requisitos de VRAM do MiniMax H3 e memória do vídeo de referência
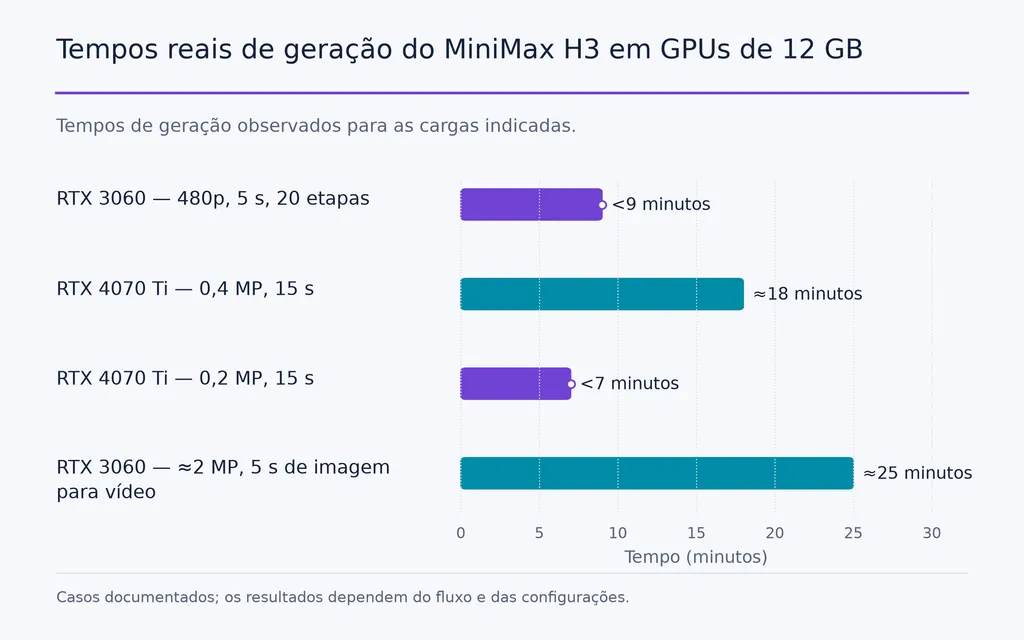
H3 pode rodar em GPUs de consumo, mas VRAM mínima e VRAM confortável para produção não são a mesma coisa.
GPU | Carga de trabalho | Tempo observado |
RTX 3060 12GB | 480p, 5 s, 20 etapas | menos de 9 min |
RTX 4070 Ti 12GB | 0.4MP, 15 s | cerca de 18 min |
RTX 4070 Ti 12GB | 0.2MP, 15 s | menos de 7 min |
RTX 3060 12GB | cerca de 2MP, 5 s de imagem para vídeo | cerca de 25 min |
Nossa pesquisa também encontrou fluxos funcionais com 8GB e 6GB, mas eles dependem mais de quantização, descarregamento de memória, carregamento em etapas e RAM do sistema.
A duração da referência pode esconder um gargalo de VRAM
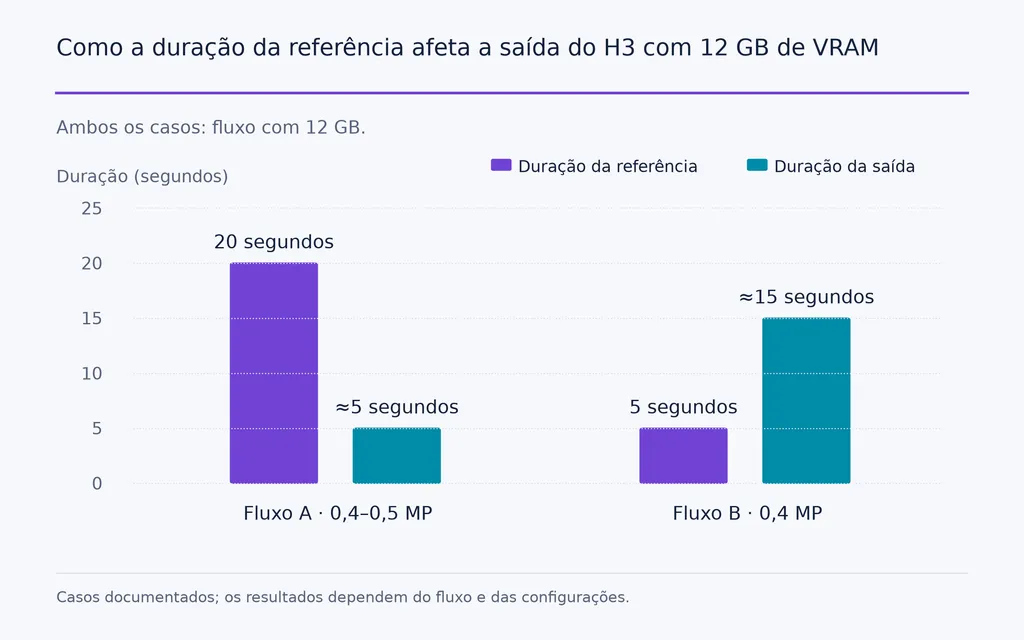
Um caso de 12GB especialmente útil mostrou:
- Referência de 20 segundos → saída de cerca de 5 segundos em 0.4–0.5MP
- Referência de 5 segundos → saída de cerca de 15 segundos em 0.4MP
A referência longa levava repetidamente o fluxo para perto de ficar sem memória (OOM).
A lição é importante: a mídia de condicionamento faz parte do orçamento de memória. Se o H3 fica sem VRAM, encurte a referência antes de sacrificar automaticamente a qualidade final.
Desempenho de GPU do MiniMax H3 e custo no RunPod
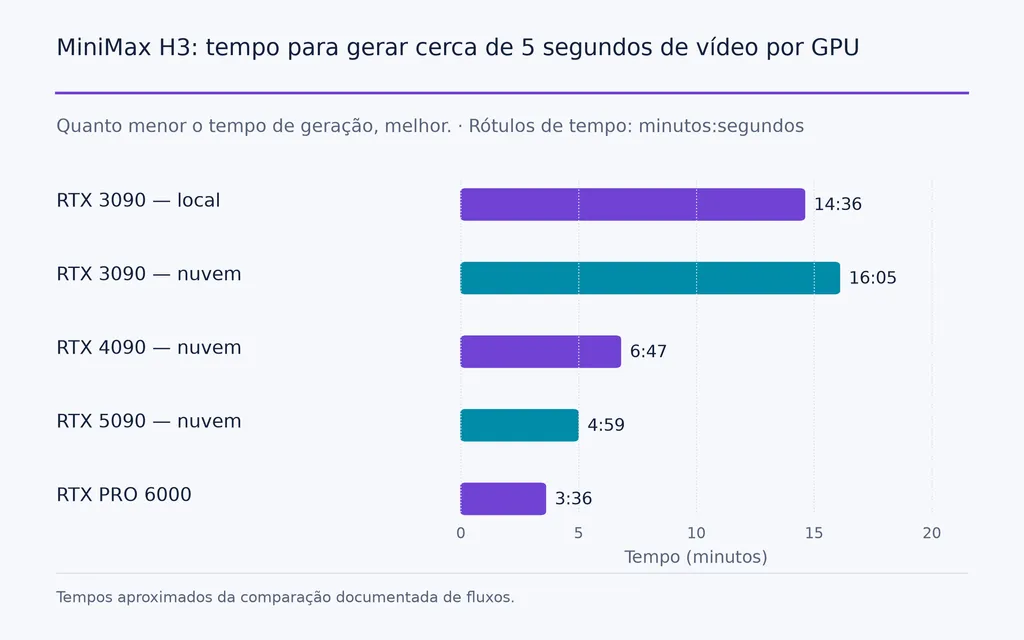
Dados de fluxos comparáveis também mostram que mais VRAM não se traduz linearmente em geração H3 mais rápida.
GPU | VRAM | Tempo aproximado para 5 s |
RTX 3090 local | 24GB | 14 min 36 s |
RTX 3090 na nuvem | 24GB | 16 min 05 s |
RTX 4090 na nuvem | 24GB | 6 min 47 s |
RTX 5090 na nuvem | 32GB | 4 min 59 s |
RTX PRO 6000 | 96GB | 3 min 36 s |
Nesse caso, a 4090 foi mais de duas vezes mais rápida que a 3090, apesar da mesma capacidade de VRAM.
Um fluxo H3 otimizado em RTX 4090, usando INT8, SageAttention, Turbo LoRA, oito etapas, aproximadamente 0.9MP e saída de 10 segundos, levou cerca de 9–10 minutos, com custo estimado de computação de aproximadamente $0.12 por geração naquela configuração específica de nuvem.
Isso não é um preço universal do H3. A métrica mais útil é o custo por clipe utilizável.
Também é preciso separar otimização de memória e de velocidade. Um fluxo documentado em 5090 reduziu a memória compartilhada da GPU em cerca de 14GB com componentes otimizados, mas alterou pouco a velocidade bruta de geração. Outra combinação em 4090, com quantização, mudanças CUDA/Triton e otimização de atenção, relatou aproximadamente 2.6× de melhoria na velocidade geral.
Qual é o melhor fluxo H3 de baixo custo?
A otimização de custo mais confiável costuma ser pré-visualizar antes de renderizar a tomada final.
- Gere uma prévia de 1–2 segundos em baixa resolução.
- Confira o enquadramento e a escala do sujeito.
- Confirme que Pose realmente acompanha o movimento desejado.
- Avalie se Depth ajuda ou restringe demais a tomada.
- Confira a identidade e a direção visual geral.
- Aumente duração e resolução só depois que a estrutura estiver estável.
Em um fluxo de 12GB, prévias curtas terminavam em cerca de um minuto ou menos, enquanto uma sequência completa levava vários minutos.
Isso segue um princípio básico do design profissional: validar a estrutura antes de investir no acabamento.
Quais são os problemas mais comuns do ControlNet no H3?
Fun ControlNet acrescenta precisão, mas também novos modos de falha.
Os problemas comuns na nossa análise incluem:
- incompatibilidade de dimensões;
- contagens incorretas de quadros;
- incompatibilidade de formas de tensores;
- incompatibilidade de checkpoints;
- lotes de controle incorretos;
- conflitos de backends de atenção;
- sinais de controle que param de funcionar sem aviso.
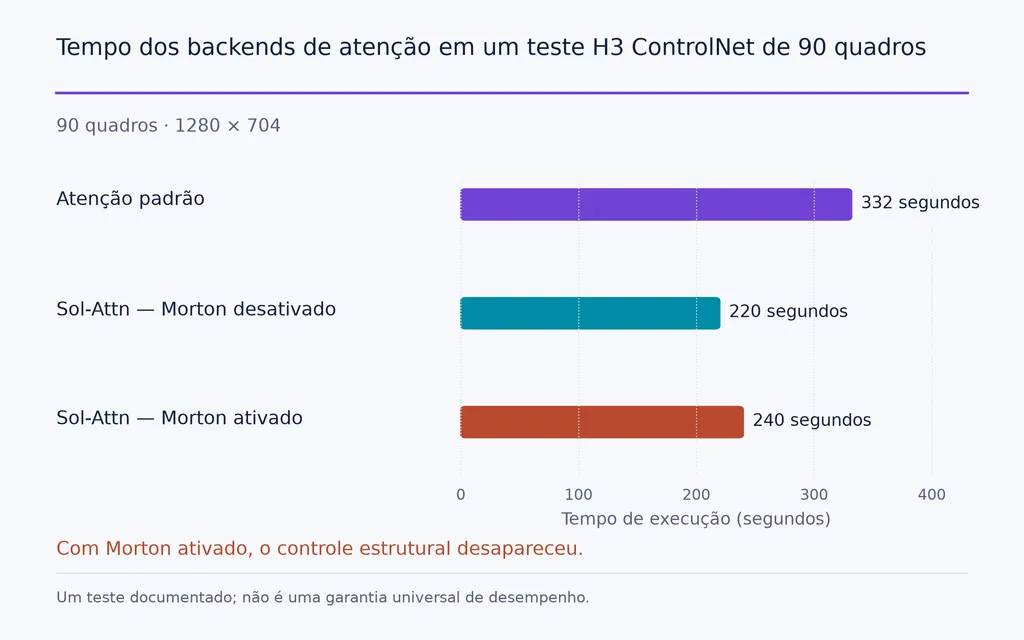
Um teste de atenção especialmente útil comparou o mesmo fluxo de 90 quadros, 1280 × 704:
- atenção padrão: 332 segundos
- Sol-Attn sem reordenação Morton: 220 segundos
- Sol-Attn com reordenação Morton: 240 segundos
A última configuração ainda gerava vídeo plausível, mas o controle estrutural praticamente desaparecia porque a ordem dos tokens deixava de se alinhar corretamente.
Por isso, toda nova configuração de ControlNet deve incluir um teste A/B com controle ativado e desativado usando a mesma semente.
O que Pose e Depth ainda não resolvem
Pose e Depth melhoram o controle estrutural, mas não garantem automaticamente:
- identidade facial perfeita;
- consistência de roupas;
- estabilidade de cor em vídeos longos;
- mãos perfeitas;
- menor uso de VRAM;
- geração mais rápida;
- nenhuma nova tentativa.
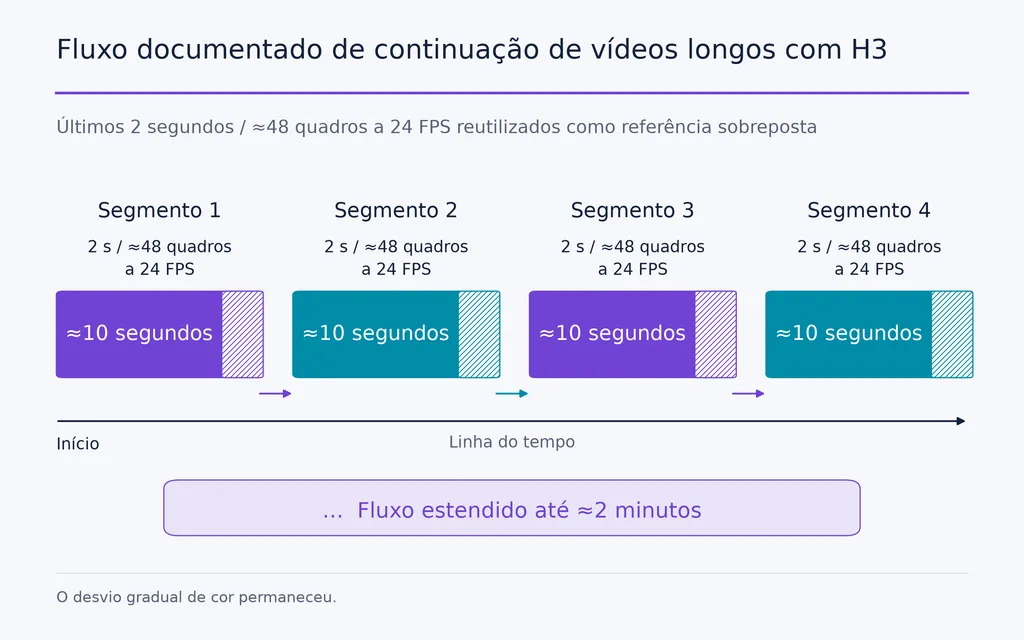
A continuidade longa continua especialmente difícil. Um fluxo documentado gerava segmentos de aproximadamente 10 segundos e reutilizava os últimos 2 segundos, ou cerca de 48 quadros a 24 FPS, como referência para o segmento seguinte.
A abordagem foi estendida até cerca de dois minutos, mas o desvio gradual de cor continuou visível.
Essa distinção importa: consistência de movimento e consistência visual são relacionadas, mas não são o mesmo problema.
Conclusão
O controle de pose e profundidade do MiniMax H3 importa porque Fun ControlNet transforma H3 em um fluxo de vídeo mais modular: Reference carrega identidade e aparência, Pose restringe movimento articulado, Depth restringe geometria espacial e os prompts definem a direção criativa. Os casos documentados também mostram por que o sistema ainda exige raciocínio de produção cuidadoso: controles múltiplos podem saturar, sujeitos pequenos podem reagir diferente a Depth, referências longas consomem muita VRAM, otimizações de atenção podem quebrar o controle silenciosamente e o desempenho do hardware varia muito entre configurações. A melhoria real não é apenas “mais controle”, mas a capacidade de diagnosticar, dirigir e iterar movimento, geometria e aparência como variáveis criativas separadas.
Perguntas frequentes
H3 suporta Pose e Depth nativamente?
Não. Pose e Depth não faziam parte dos recursos nativos de lançamento do H3. Eles são adicionados pela posterior extensão Fun ControlNet, que também suporta controles estruturais como Canny, HED e MLSD.
Qual a diferença entre Reference Video e Pose Control no H3?
Reference Video fornece ao H3 orientação semântica rica sobre uma atuação, enquanto Pose oferece uma restrição mais explícita do movimento corporal. Use Reference quando a interpretação criativa for aceitável e Pose quando a coreografia ou o movimento precisarem seguir uma estrutura mais clara.
Pose do H3 consegue manter a identidade do personagem?
Não sozinho. Pose controla estrutura e movimento corporal, não identidade. Para substituição de personagens, use Reference para aparência e identidade, Pose para movimento e Depth se a tomada também precisar de controle espacial mais forte.
H3 pode rodar com 12GB de VRAM?
Sim. Os fluxos H3 documentados em RTX 3060 e RTX 4070 Ti mostram que 12GB de VRAM podem executar H3, mas resolução, duração, comprimento da referência, quantização e descarregamento de memória afetam bastante o desempenho. Fluxos com menos VRAM servem para experimentar, mas geralmente exigem mais concessões que configurações de produção com mais VRAM.
Mais do blogue da Virse
Fluxo de trabalho

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de outubro de 2026 by Yifan Zhao