
MiniMax H3のポーズ・深度制御:機能、仕組み、使いどころ
Vincent読了 10 分 ·
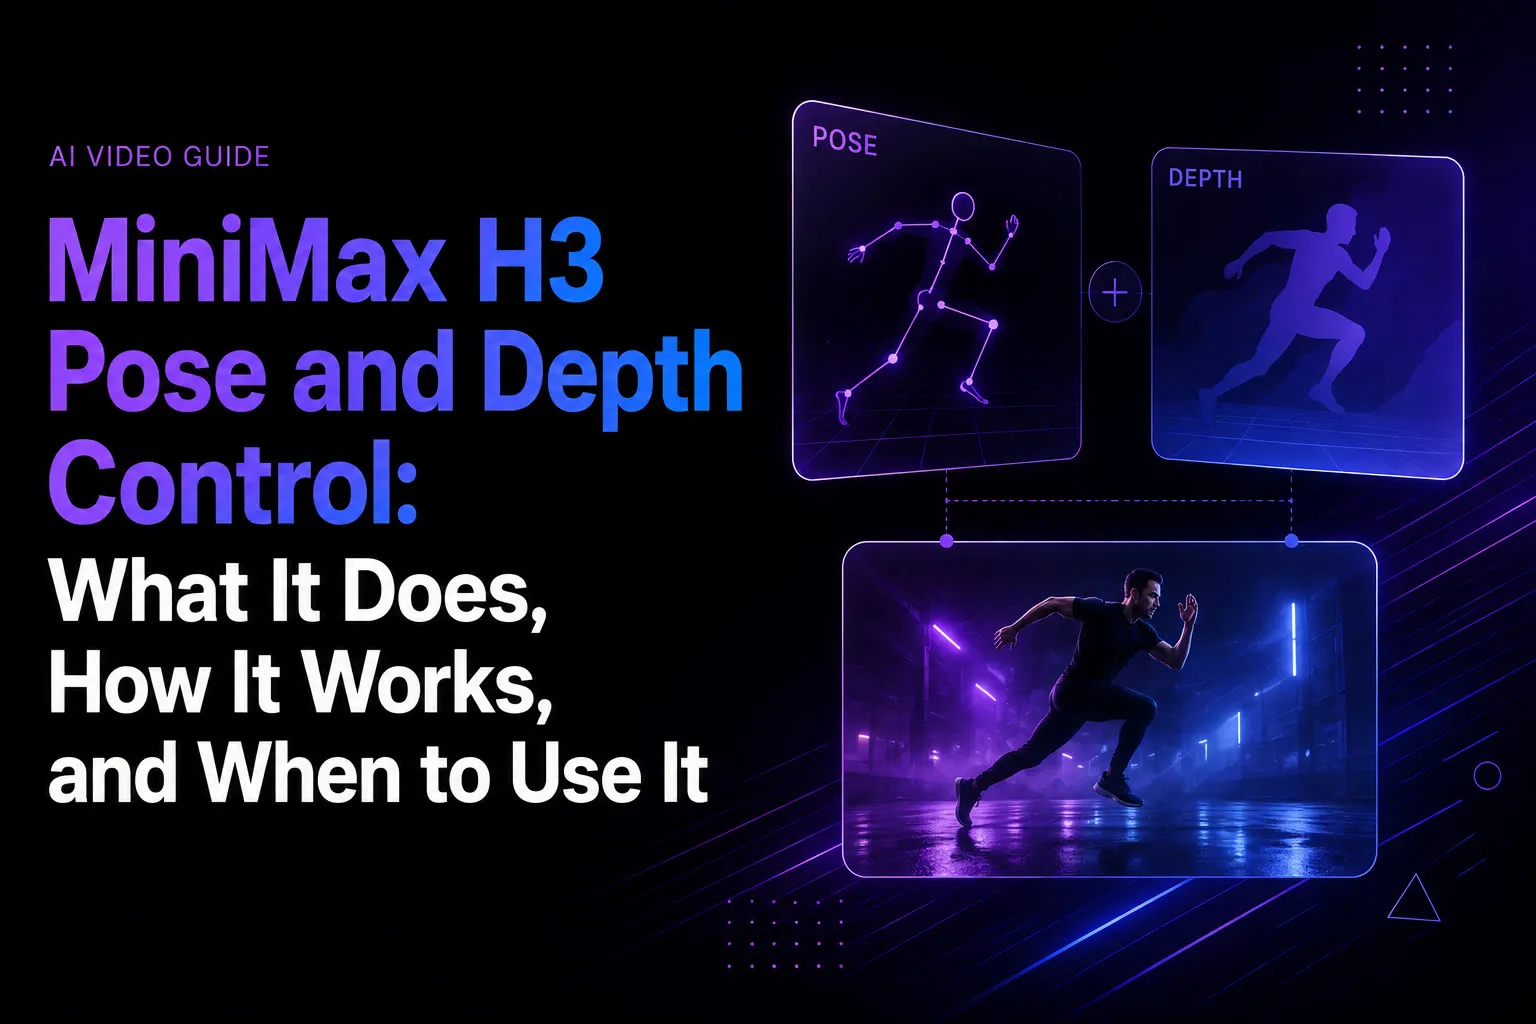
MiniMax H3のポーズ・深度制御は、Fun ControlNetを通じて動きと空間構造をより精密に制御できます。Poseが制約するのは身体の姿勢と動きで、Depthが制約するのはシーンの幾何構造、被写体の位置、カメラに対する相対構造です。これにより、同一性、動き、幾何構造、創作の方向性を分けて扱い、H3が単一の参照からすべてを推測する必要をなくします。
問題は、参照を理解することと正確に再現することは同じではない点です。キャラクター置換、ダンス転写、モーションリターゲティングでは、タイミング、身体の位置、大きさ、カメラとの距離のわずかな誤差がずれを生み、再生成を繰り返す原因になります。
PoseとDepthは各入力の役割を明確にし、H3を指示しやすくします。Referenceは外見と同一性を制御し、Poseは動き、Depthは空間の幾何構造、プロンプトは創作の方向性を制御します。参照を視覚的に管理したいチーム向けに、VirseはAIエージェント、関連素材、プロジェクトの文脈を無限キャンバスに集約し、生成を孤立したプロンプトとして扱わずに、制御付きH3ワークフローを整理・反復しやすくします。 MiniMax H3、Seedance 2.5、Seedance 2.0は現在、Virseで利用でき、同じ創作ワークフローで複数の主要動画モデルを試して比較できます。
MiniMax H3のポーズ・深度制御とは?
MiniMax H3のPose Controlは身体の姿勢と動きを制約し、Depth Controlは空間の幾何構造とカメラに対する相対構造を制約します。これらはH3の初期リリース機能ではなく、MiniMax-H3-Fun-Controlnet-Unionによる機能です。
Fun ControlNetのチェックポイントは約6.8 GBで、H3の50個のTransformerブロックのうち5個に制御分岐を追加します。単一の統合チェックポイントで複数の構造条件に対応できます。
制御方式 | 適した用途 | 主な制約 |
Pose | ダンス、アクション、キャラクター置換 | 身体の動き |
Depth | シーン構図、カメラとの距離 | 3D幾何構造 |
Canny | スケッチ駆動のアニメーション | 輪郭と配置 |
HED | より柔らかな構造ガイド | 物体の境界 |
MLSD | 建築、製品 | 直線 |
設計上の重要な変化は、制作者が構造的に固定すべき部分と、H3が創造的に解釈し直してよい部分を決められることです。
MiniMax H3のReference VideoとPose Controlの違いは?
最も明確な違いは次のとおりです。
Reference Videoは意味に関するガイドを与え、PoseとDepthは構造上の制約を与えます。
H3の参照システムは複数の画像、動画、音声入力を扱えるため、キャラクターの外見、動作、シーン、表情、カメラの挙動を理解するのが得意です。
H3 Reference Videoだけで十分な場合
Reference Videoは、演技全体や視覚的な意図を転写しつつ、H3に再解釈の自由をある程度残したい場合に役立ちます。
記録されたH3ワークフローを検討すると、繰り返し現れる制約があります。動作の理解と、そのタイミングや身体位置の正確な再現は同じではないという点です。
これは創作上の探索では許容できることが多いものの、振り付けや被写体位置が厳密な要件になると許容しにくくなります。
H3 Pose Controlの方が適している場合
Poseは、次のように動きそのものの一貫性が必要な場面でより有効です。
- ダンスの転写;
- 俳優の置換;
- 歩行や走行のループ;
- アニメーションのブロッキング;
- モーションリターゲティング。
次のように考えると分かりやすくなります。
Referenceは被写体が誰か、Poseは何をするか、Depthは空間のどこにいるかを制御します。
MiniMax H3のPoseとDepth:どちらを使うべき?
PoseとDepthは異なる問題を解決し、被写体の大きさも各制御の有効性に影響します。
あるテストで小さなキャラクターにPoseが有効だった理由
記録されたあるワークフローは1280 × 704で生成し、約40 × 22の潜在空間グリッドを作りました。キャラクターが占めたのは約縦22位置のうち3位置だけでした。
そのケースではDepthでも人物がカメラに近づいて大きくなるずれが起きましたが、Poseは被写体の位置をより確実に維持しました。
ここから「Poseは常にDepthより優れている」と一般化すべきではありません。小さな被写体はダウンサンプリング後に比較的弱い深度情報しか持たない可能性を示しています。
Depthがより適している場合
Depthは次の用途に適しています。
- 前景と背景の関係;
- カメラに近づく、または遠ざかる動き;
- 室内や環境;
- 大きな製品;
- 人間以外の物体;
- シーンの幾何構造。
したがって問うべきなのは「PoseかDepthか」ではなく、「関節の動きを固定したいのか、空間の幾何構造を固定したいのか」です。
Pose ControlがH3のキャラクター置換とモーションリターゲティングを変える仕組み
キャラクター置換は特に有力な用途です。Fun ControlNetが外見の転写と動きの転写の分離を助けるためです。
繰り返し寄せられる質問を調べたところ、次の3つがよくある問題でした。
- 置換後のキャラクターが元の演技を十分忠実に追わない。
- 複雑な動きの中で同一性が不安定になる。
- 元の演者の視覚的特徴が新しいキャラクターに混ざる。
Poseだけで同一性を解決できるわけではありません。各入力の役割を明確にできます。
目的のキャラクター → Reference
元の演技 → Pose
シーンの幾何構造 → 必要に応じてDepth
創作上のスタイル → プロンプト
これは専門的な設計システムに近い考え方です。動きが違えば動きを調整し、外見が違えば参照を調整します。すべての変数を同時に変える必要はありません。
過剰制御を避けてH3のPoseとDepthを調整する方法
条件付けを増やしても、必ず制御が改善するわけではありません。
PoseとDepthを共通の制御予算として扱う
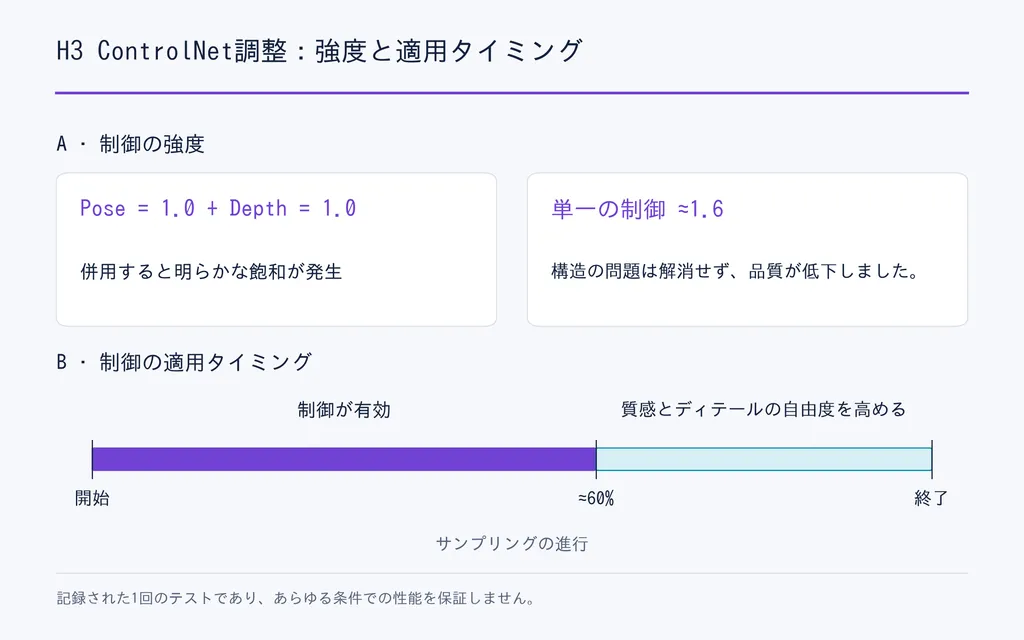
ある複数制御ワークフローでは、Pose強度1.0とDepth強度1.0の併用で目に見える飽和が生じました。単一制御を約1.6に上げても構造問題は直らず、画質も低下しました。
より堅実なのは、最も重要な制御を先に選び、補助的な制御を徐々に加える方法です。
制御のタイミングは強度と同じくらい重要
拡散の後半まで構造制御が強すぎると、逆効果になる場合があります。
ある記録済みテストでは、約サンプリング工程の60%で制御を終えると重要な構造を保ちつつ、後半のステップで質感や表面の細部を回復する自由が増えました。
実践上の原則はシンプルです。
前半のステップで構造を確立し、後半には画像を仕上げる自由を十分残します。
普遍的な強度や終了割合を推奨できるほど、標準化されたテストはまだありません。
MiniMax H3のVRAM要件と参照動画のメモリ
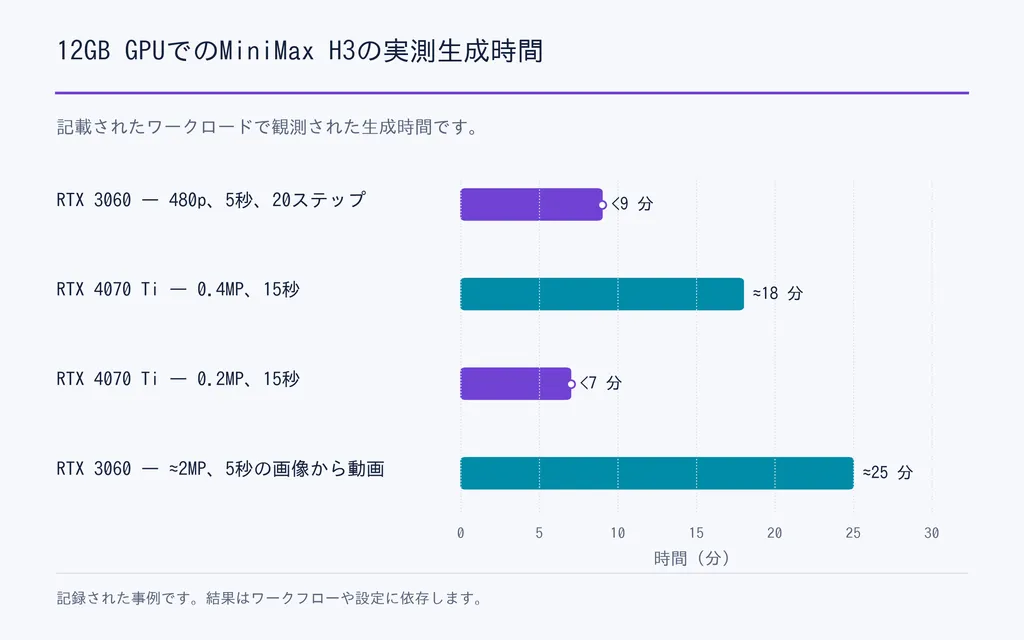
H3は一般向けGPUで動きますが、最低VRAM容量と快適な制作に必要なVRAM容量は別です。
GPU | 処理内容 | 観測時間 |
RTX 3060 12GB | 480p、5秒、20ステップ | 9分未満 |
RTX 4070 Ti 12GB | 0.4MP、15秒 | 約18分 |
RTX 4070 Ti 12GB | 0.2MP、15秒 | 7分未満 |
RTX 3060 12GB | 約2MP、5秒の画像から動画生成 | 約25分 |
調査では動作する8GBおよび6GBのワークフローも見つかりましたが、量子化、オフロード、段階的読み込み、システムRAMへの依存がより大きくなります。
参照の長さが隠れたVRAMのボトルネックになる
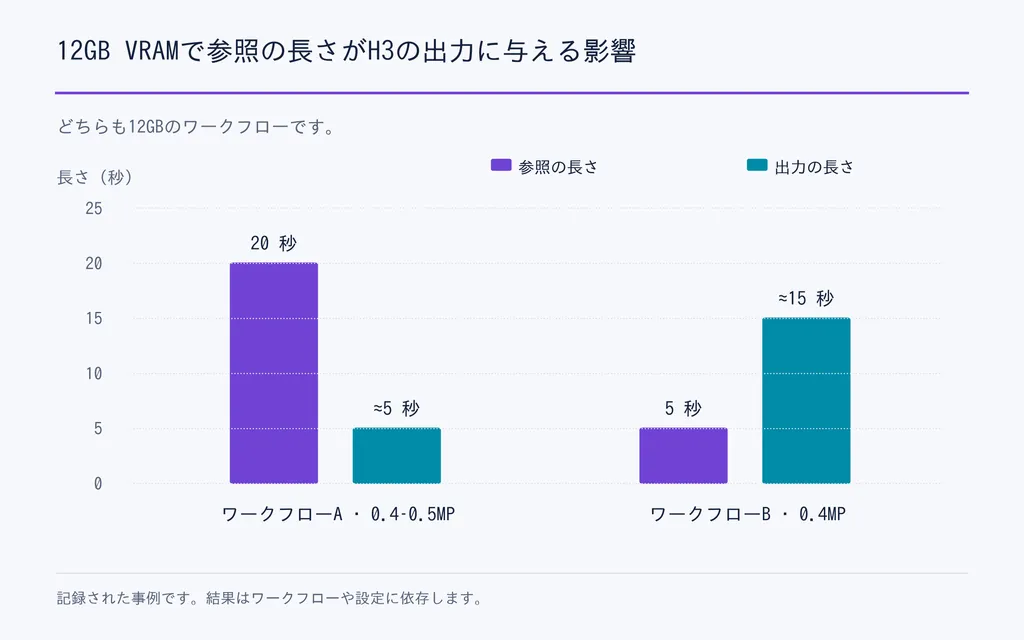
特に参考になる12GBのケースでは次の結果でした。
- 20秒の参照 → 0.4–0.5MPで約5秒の出力
- 5秒の参照 → 0.4MPで約15秒の出力
長い参照はワークフローを繰り返しメモリ不足(OOM)に近づけました。
重要な教訓は、条件付け用メディアもメモリ予算に含まれることです。H3のVRAMが足りなければ、最終画質を下げる前に参照を短くしてください。
MiniMax H3のGPU性能とRunPodのコスト
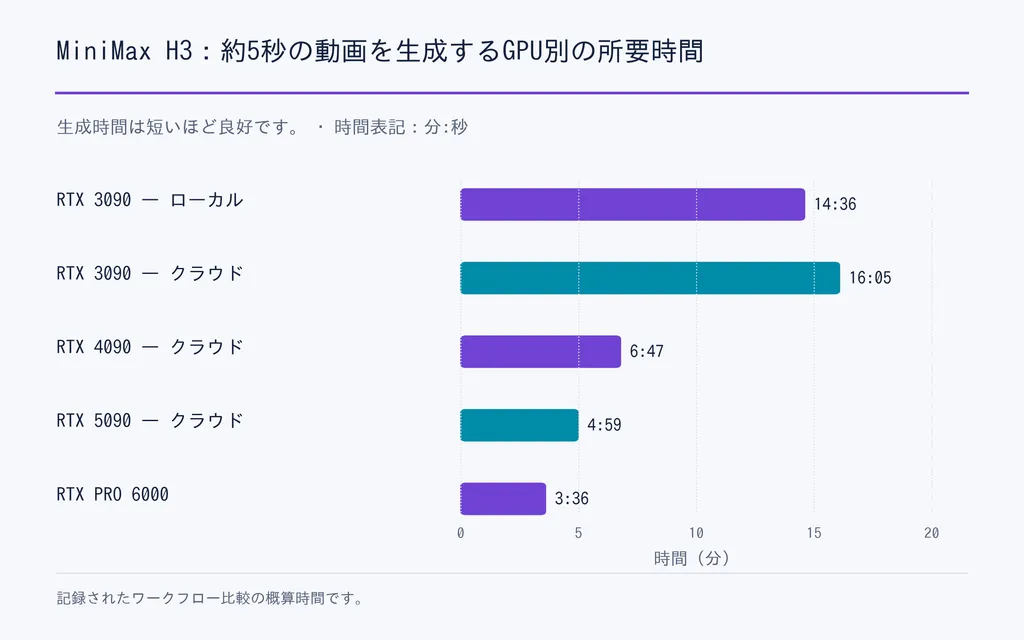
比較可能なワークフローデータは、VRAMの増加とH3の生成速度向上は比例しないことも示しています。
GPU | VRAM | 約5秒の生成時間 |
ローカルRTX 3090 | 24GB | 14分36秒 |
クラウドRTX 3090 | 24GB | 16分05秒 |
クラウドRTX 4090 | 24GB | 6分47秒 |
クラウドRTX 5090 | 32GB | 4分59秒 |
RTX PRO 6000 | 96GB | 3分36秒 |
このケースではVRAM容量が同じでも、4090は3090の2倍以上高速でした。
最適化したRTX 4090のH3ワークフローでは、INT8、SageAttention、Turbo LoRA、8ステップ、約0.9MP、10秒出力を使い、所要時間は約9–10分でした。その特定のクラウド構成での推定計算コストは約1回の生成につき$0.12です。
これは普遍的なH3の料金ではありません。より有用な指標は使えるクリップ1本あたりのコストです。
メモリ最適化と速度最適化も分けて考えるべきです。記録された5090のワークフローでは、モデル部品の最適化で共有GPUメモリが約14GB減った一方、生成そのものの速度はほぼ変わりませんでした。別の4090の最適化構成では、量子化、CUDA/Tritonの変更、Attention最適化によって約2.6倍の全体高速化が報告されています。
低コストで最適なH3ワークフローとは?
最も確実なコスト削減は、多くの場合、最終ショットをレンダリングする前のプレビューです。
- まず1–2秒の低解像度プレビューを生成します。
- 構図と被写体の大きさを確認します。
- Poseが意図した動きを実際に追っているか確認します。
- Depthが役立つか、ショットを制約しすぎているか評価します。
- 同一性と全体的な視覚の方向性を確認します。
- 構造が安定してから長さと解像度を上げます。
ある12GBワークフローでは、短いプレビューは約1分以内で終わりましたが、全体のシーケンスには何分もかかりました。
これは専門的な設計の基本原則、仕上げに投資する前に構造を検証するという考え方です。
H3 ControlNetでよくある問題とは?
Fun ControlNetは精度を高める一方、新たな失敗パターンも生みます。
ワークフロー調査で見られた主な問題は次のとおりです。
- 寸法の不一致;
- フレーム数の誤り;
- テンソル形状の不一致;
- チェックポイントの非互換性;
- 制御バッチの誤り;
- Attentionバックエンドの競合;
- 警告なく停止する制御信号。
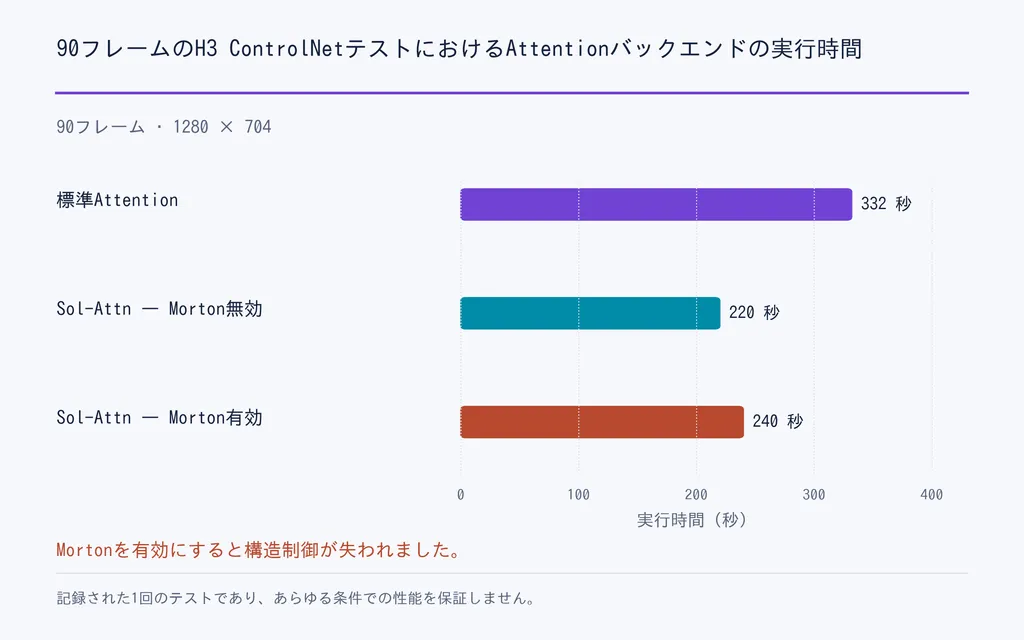
特に参考になるAttentionテストでは、同じ90フレーム、1280 × 704のワークフローを比較しました。
- 標準Attention:332秒
- Morton並べ替えなしのSol-Attn:220秒
- Morton並べ替えありのSol-Attn:240秒
最後の構成でももっともらしい動画は生成されましたが、構造制御は事実上失われました。トークンの順序が正しく整合しなくなったためです。
そのため、新しいControlNet構成では必ず、簡単な同じシードで制御オンとオフを比較するA/Bテストを行うべきです。
PoseとDepthでも解決できないこと
PoseとDepthは構造制御を改善しますが、次を自動的に保証しません。
- 完全な顔の同一性;
- 衣服の一貫性;
- 長い動画の色の安定性;
- 完璧な手;
- VRAM使用量の削減;
- 生成の高速化;
- 再生成が一切不要になること。
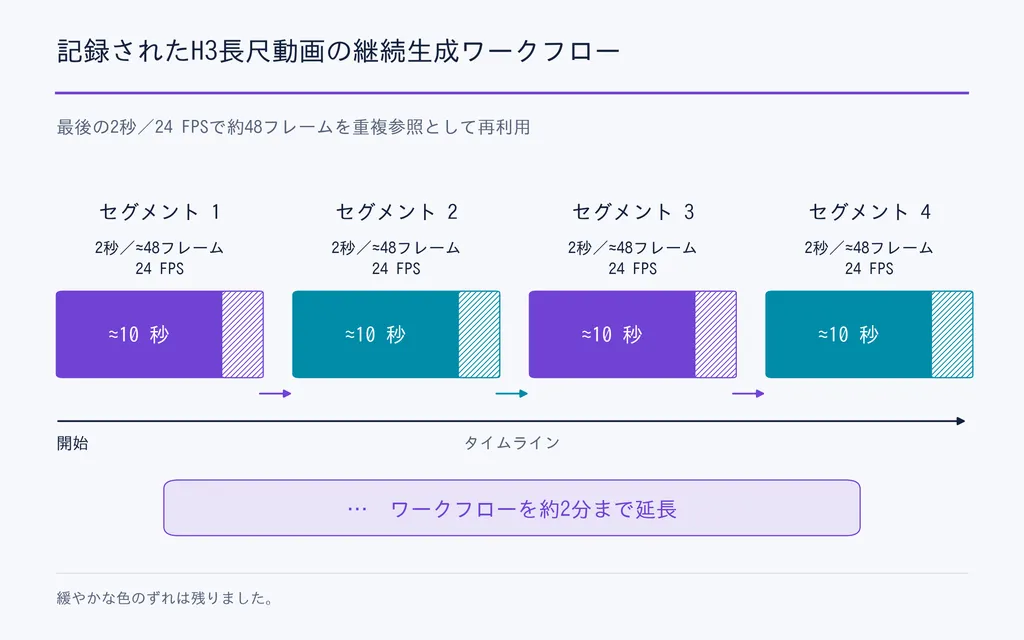
長尺の連続性は依然として特に難しい課題です。ある記録済みワークフローでは約10秒の区間を生成し、その末尾の2秒、つまり24 FPSで約48フレームを次の区間の参照に再利用しました。
この方法で約2分まで延長しましたが、徐々に色がずれる現象は残りました。
重要なのは、動きの一貫性と視覚的一貫性は関係していても同じ問題ではない、という区別です。
結論
MiniMax H3のポーズ・深度制御が重要なのは、Fun ControlNetがH3をよりモジュール化した動画ワークフローにするためです。Referenceは同一性と外見、Poseは関節の動き、Depthは空間の幾何構造、プロンプトは創作の方向性を担当できます。記録された事例からは、慎重な制作上の判断がなお必要な理由も分かります。複数制御は飽和し、小さな被写体はDepthへの反応が異なり、長い参照は大量のVRAMを使い、Attention最適化は警告なく制御を壊し、構成によってハードウェア性能も大きく変わります。真の改善は単なる「制御の増加」ではなく、動き、幾何構造、外見を独立した創作変数として問題を切り分け、指示し、反復できることです。
よくある質問
H3はPoseとDepthに標準対応していますか?
いいえ。PoseとDepthはH3初期リリースの標準機能ではありません。後から追加されたFun ControlNet拡張によるもので、Canny、HED、MLSDなどの構造制御にも対応します。
H3 Reference VideoとPose Controlの違いは?
Reference Videoは演技に関する豊かな意味情報をH3に与え、Poseは身体の動きにより明示的な制約を与えます。創造的な解釈を許せる場合はReference、振り付けや動きに明確な構造が必要な場合はPoseを使います。
H3 Poseでキャラクターの同一性を維持できますか?
単独ではできません。Poseが制御するのは身体構造と動きであり、同一性ではありません。そこで、キャラクター置換ではReferenceで外見と同一性、Poseで動きを制御し、さらに空間制御が必要ならDepthも使います。
H3は12GBのVRAMで動きますか?
はい。記録されたRTX 3060とRTX 4070 TiのH3ワークフローでは、12GBのVRAMでH3を動かせることが示されています。ただし解像度、長さ、参照の長さ、量子化、オフロードは性能を大きく左右します。低VRAM構成は実験に使えますが、大容量VRAMの制作構成より多くの妥協が通常必要です。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao