
Kontrol Pose dan Kedalaman MiniMax H3: Fungsi, Cara Kerja, dan Waktu Penggunaannya
Vincent9 menit baca ·
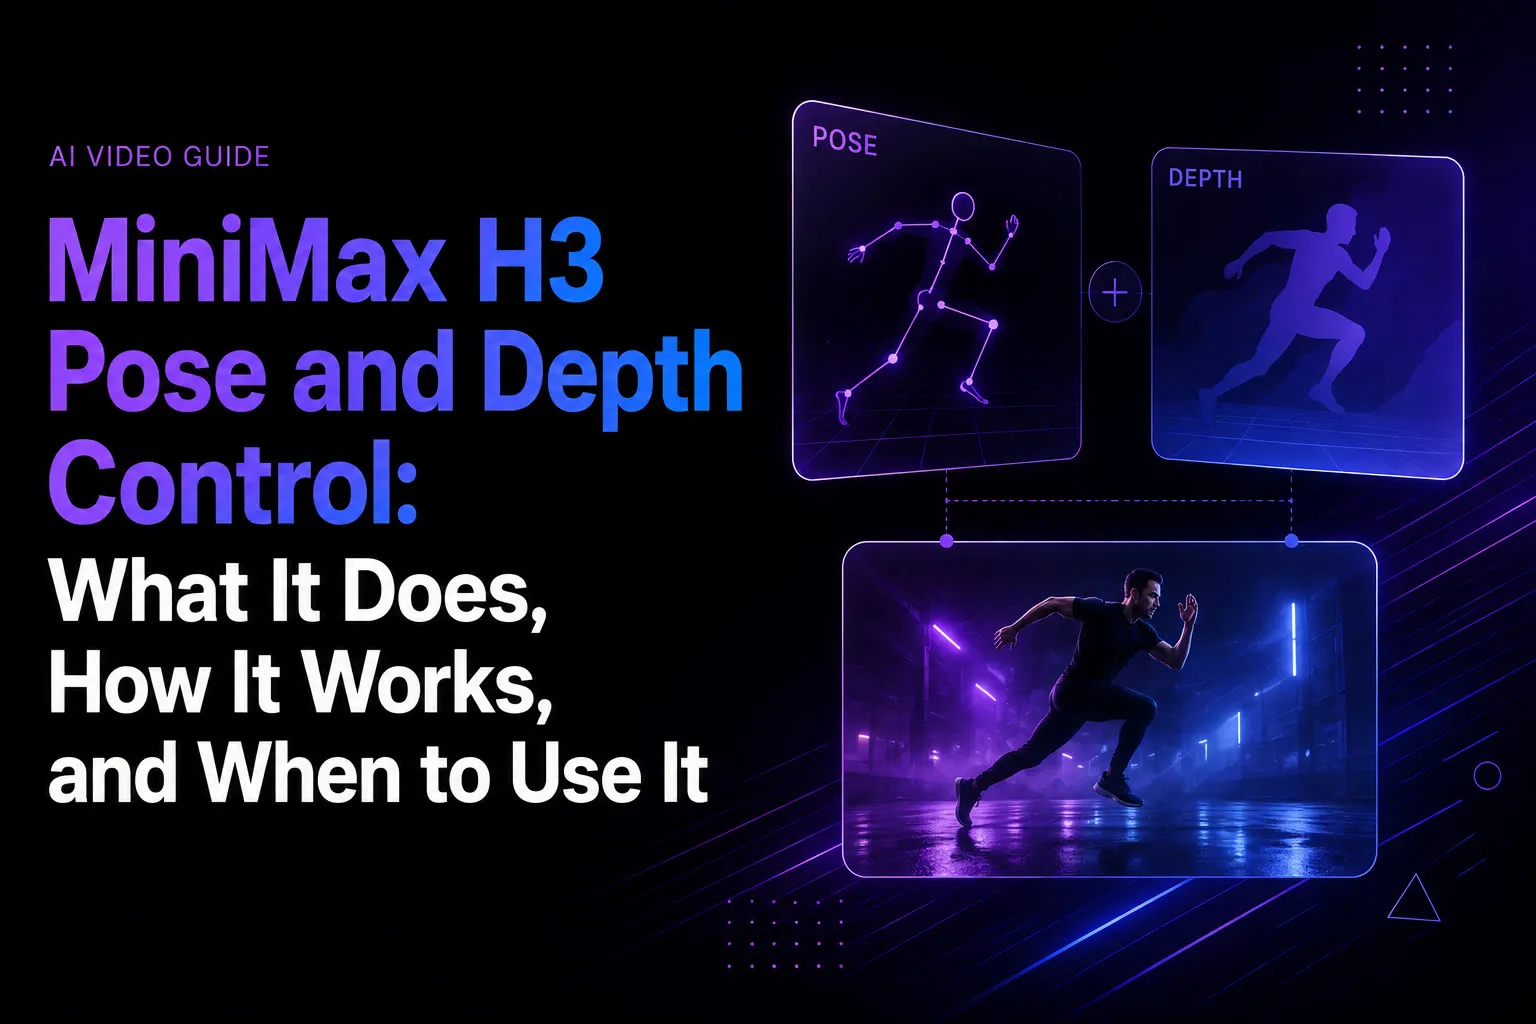
Kontrol Pose dan Depth MiniMax H3 memberi kreator kendali lebih presisi atas gerakan dan struktur ruang melalui Fun ControlNet. Pose membatasi postur dan gerakan tubuh, sedangkan Depth membatasi geometri adegan, posisi subjek, dan struktur relatif terhadap kamera. Ini memisahkan identitas, gerakan, geometri, dan arah kreatif agar H3 tidak harus menyimpulkan semuanya dari satu referensi.
Masalahnya, memahami referensi tidak sama dengan mereproduksinya secara presisi. Dalam penggantian karakter, transfer tarian, dan penargetan ulang gerak, kesalahan kecil pada waktu, posisi tubuh, skala, atau jarak kamera dapat menimbulkan penyimpangan dan pembuatan berulang.
Pose dan Depth membuat H3 lebih mudah diarahkan dengan memberi tiap masukan tugas lebih jelas: Reference mengontrol penampilan dan identitas, Pose mengontrol gerakan, Depth mengontrol geometri ruang, dan prompt mengontrol arah kreatif. Bagi tim yang ingin mengelola referensi secara visual, Virse menyatukan agen AI, aset terhubung, dan konteks proyek dalam kanvas tanpa batas, sehingga alur H3 terkontrol lebih mudah ditata dan diulang tanpa menganggap tiap pembuatan sebagai prompt terpisah. MiniMax H3, Seedance 2.5 dan Seedance 2.0 kini tersedia di Virse, sehingga tim dapat mengeksplorasi dan membandingkan beberapa model video terkemuka dalam satu alur kreatif.
Apa Itu Kontrol Pose dan Depth MiniMax H3?
Pose Control MiniMax H3 membatasi postur dan gerakan tubuh, sedangkan Depth Control membatasi geometri ruang dan struktur relatif kamera. Kemampuan ini berasal dari MiniMax-H3-Fun-Controlnet-Union, bukan fitur peluncuran awal H3.
Checkpoint Fun ControlNet berukuran sekitar 6.8 GB dan menambahkan cabang kontrol pada 5 dari 50 blok Transformer H3. Satu checkpoint gabungan dapat mendukung beberapa kondisi struktur.
Kontrol | Paling Cocok untuk | Batasan Utama |
Pose | Tarian, aksi, penggantian karakter | Gerakan tubuh |
Depth | Komposisi adegan, jarak kamera | Geometri 3D |
Canny | Animasi berbasis sketsa | Tepi dan tata letak |
HED | Panduan struktur lebih lembut | Batas objek |
MLSD | Arsitektur, produk | Garis lurus |
Perubahan desain pentingnya adalah kreator dapat menentukan bagian yang harus tetap secara struktural dan bagian yang boleh ditafsirkan ulang secara kreatif oleh H3.
Reference Video vs Pose Control MiniMax H3: Apa Bedanya?
Perbedaan paling jelas adalah:
Reference Video memberi panduan semantik. Pose dan Depth memberi batasan struktur.
Pada H3, Sistem referensi dapat memakai beberapa gambar, video, dan masukan audio, sehingga kuat dalam memahami penampilan karakter, aksi, adegan, ekspresi, dan perilaku kamera.
Kapan Reference Video H3 Sudah Cukup
Reference Video berguna ketika Anda ingin memindahkan penampilan keseluruhan atau maksud visual sambil memberi H3 kebebasan tertentu untuk menafsirkan ulang hasil.
Tinjauan kami terhadap alur kerja H3 yang terdokumentasi menunjukkan batasan berulang: memahami aksi tidak sama dengan mereproduksi waktu dan posisi tubuhnya secara presisi.
Hal ini sering dapat diterima untuk eksplorasi kreatif. Namun, lebih sulit diterima jika koreografi atau penempatan subjek menjadi syarat mutlak.
Kapan Pose Control H3 Lebih Baik
Pose lebih berguna saat gerakannya sendiri harus konsisten, misalnya:
- transfer tarian;
- penggantian aktor;
- siklus berjalan atau berlari;
- blocking animasi;
- penargetan ulang gerak.
Cara memahami yang berguna adalah:
Reference mengontrol siapa subjeknya. Pose mengontrol yang dilakukannya. Depth mengontrol letak subjek dalam ruang.
Pose vs Depth MiniMax H3: Mana yang Sebaiknya Dipakai?
Pose dan Depth menyelesaikan masalah berbeda, dan ukuran subjek dapat memengaruhi kegunaan tiap kontrol.
Mengapa Pose Lebih Baik untuk Karakter Kecil dalam Satu Tes
Satu alur terdokumentasi membuat hasil pada 1280 × 704, menghasilkan kisi ruang laten sekitar 40 × 22. Karakter hanya menempati sekitar 3 dari 22 posisi laten vertikal.
Dalam kasus itu, Depth masih membiarkan sosok bergeser mendekati kamera dan membesar, sedangkan Pose mempertahankan posisi subjek lebih andal.
Ini tidak boleh digeneralisasi menjadi “Pose selalu lebih baik daripada Depth.” Ini menunjukkan subjek kecil mungkin memberi informasi kedalaman relatif lemah setelah penurunan resolusi.
Kapan Depth Lebih Tepat
Depth lebih sesuai untuk:
- hubungan latar depan dan belakang;
- gerakan mendekati atau menjauhi kamera;
- ruangan dan lingkungan;
- produk besar;
- objek bukan manusia;
- geometri adegan.
Jadi pertanyaan yang tepat bukan “Pose atau Depth?”, melainkan “Apakah saya perlu mengunci gerakan sendi atau geometri ruang?”
Cara Pose Control Mengubah Penggantian Karakter dan Penargetan Ulang Gerak H3
Penggantian karakter merupakan salah satu penggunaan terkuat karena Fun ControlNet membantu memisahkan transfer penampilan dari transfer gerakan.
Tinjauan kami atas pertanyaan berulang menemukan tiga masalah umum:
- Karakter pengganti tidak mengikuti penampilan sumber dengan cukup dekat.
- Identitas menjadi kurang stabil selama gerakan kompleks.
- Ciri visual pemeran asli terbawa ke karakter baru.
Pose tidak menyelesaikan identitas sendiri. Sebaliknya, tiap masukan dapat memiliki peran lebih jelas:
Karakter target → Reference
Penampilan sumber → Pose
Geometri adegan → Depth jika diperlukan
Gaya kreatif → Prompt
Ini lebih mirip sistem desain profesional: jika gerakan salah, sesuaikan gerakan. Jika penampilan salah, sesuaikan referensi. Anda tidak perlu mengubah semua variabel sekaligus.
Cara Menyetel Pose dan Depth H3 Tanpa Kontrol Berlebihan
Lebih banyak pengondisian tidak otomatis berarti kontrol lebih baik.
Anggap Pose dan Depth Memakai Anggaran Kontrol Bersama
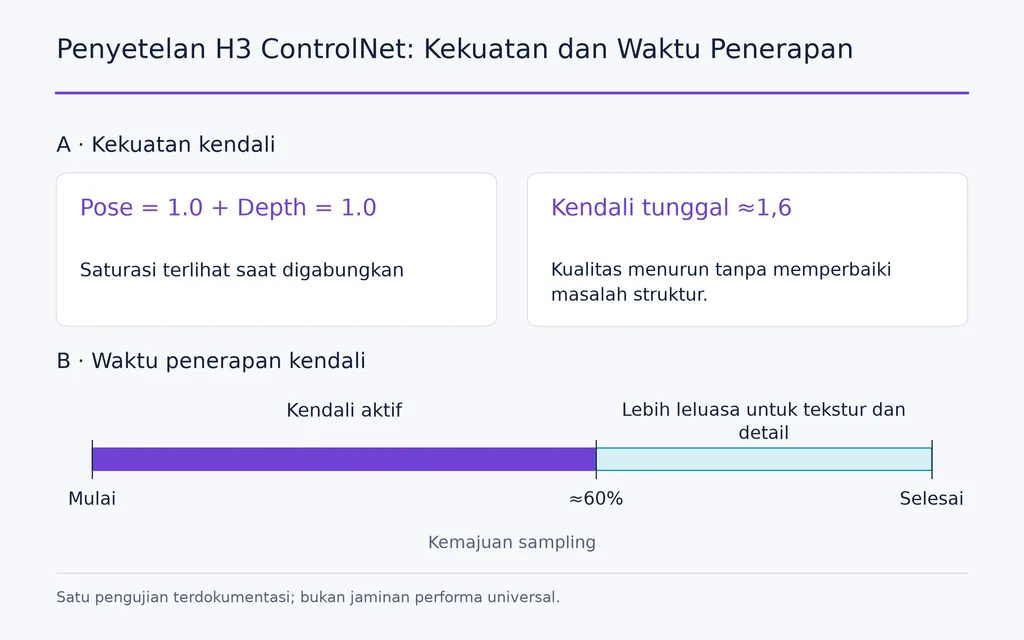
Dalam satu alur multikontrol, kekuatan Pose 1.0 ditambah kekuatan Depth 1.0 menghasilkan saturasi yang terlihat. Menaikkan satu kontrol ke sekitar 1.6 juga gagal memperbaiki struktur sekaligus menurunkan kualitas visual.
Alur lebih aman adalah memilih kontrol terpenting dahulu, lalu memperkenalkan kontrol sekunder secara bertahap.
Waktu Kontrol Sama Pentingnya dengan Kekuatan
Kontrol struktur bisa merugikan jika tetap terlalu kuat pada akhir difusi.
Satu tes terdokumentasi menemukan bahwa mengakhiri kontrol sekitar 60% dari jadwal sampling mempertahankan struktur penting sambil memberi tahap akhir kebebasan memulihkan tekstur dan detail permukaan.
Prinsip praktisnya sederhana:
Gunakan langkah awal untuk menetapkan struktur. Beri langkah akhir kebebasan cukup untuk menyelesaikan gambar.
Belum cukup pengujian terstandar untuk merekomendasikan satu kekuatan atau persentase akhir universal.
Kebutuhan VRAM MiniMax H3 dan Memori Video Referensi
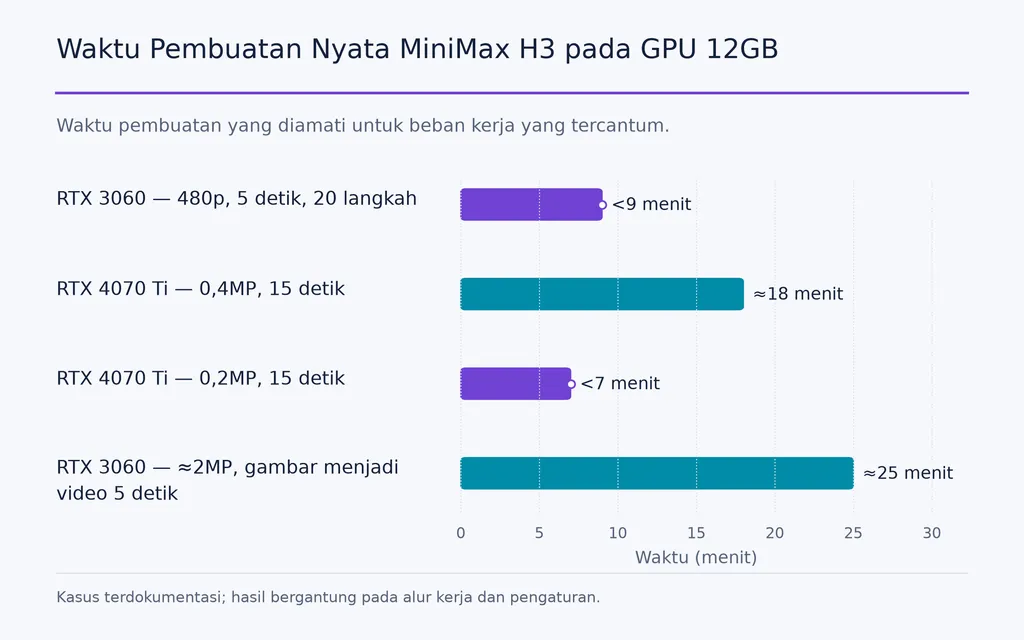
H3 dapat berjalan pada GPU konsumen, tetapi VRAM minimum tidak sama dengan VRAM untuk produksi nyaman.
GPU | Beban Kerja | Waktu Teramati |
RTX 3060 12GB | 480p, 5 detik, 20 langkah | di bawah 9 menit |
RTX 4070 Ti 12GB | 0.4MP, 15 detik | sekitar 18 menit |
RTX 4070 Ti 12GB | 0.2MP, 15 detik | di bawah 7 menit |
RTX 3060 12GB | sekitar 2MP, 5 detik gambar-ke-video | sekitar 25 menit |
Riset kami juga menemukan alur 8GB dan 6GB yang berfungsi, tetapi lebih bergantung pada kuantisasi, offloading, pemuatan bertahap, dan RAM sistem.
Panjang Referensi Bisa Menjadi Hambatan VRAM Tersembunyi
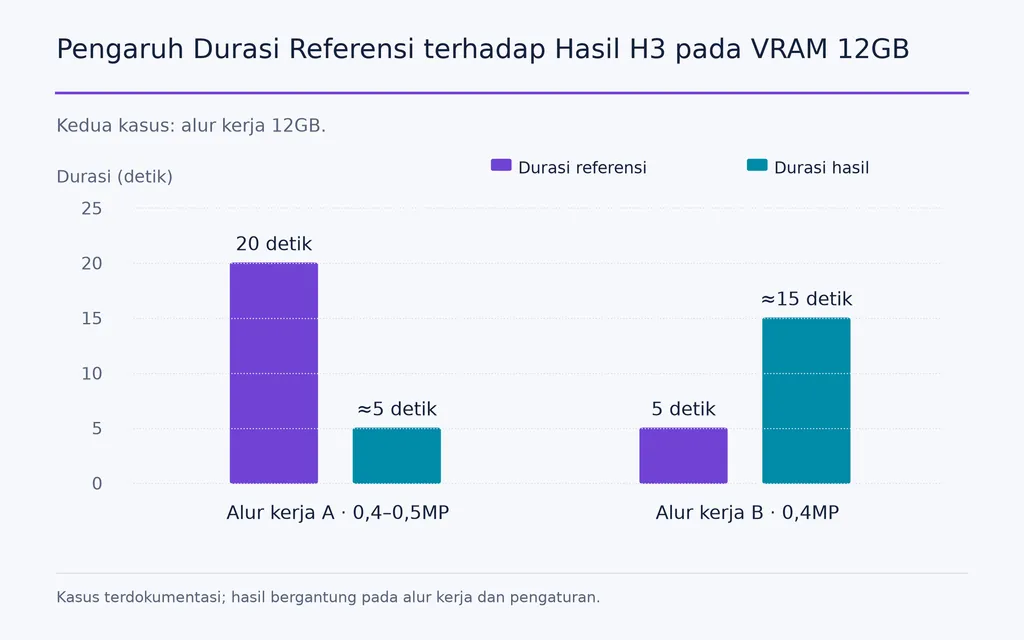
Satu kasus 12GB yang sangat berguna menunjukkan:
- Referensi 20 detik → hasil sekitar 5 detik pada 0.4–0.5MP
- Referensi 5 detik → hasil sekitar 15 detik pada 0.4MP
Referensi lebih panjang berulang kali mendorong alur mendekati kehabisan memori (OOM).
Pelajarannya penting: media pengondisian merupakan bagian anggaran memori. Jika VRAM H3 habis, pendekkan referensi sebelum langsung mengorbankan kualitas hasil akhir.
Performa GPU MiniMax H3 dan Biaya RunPod
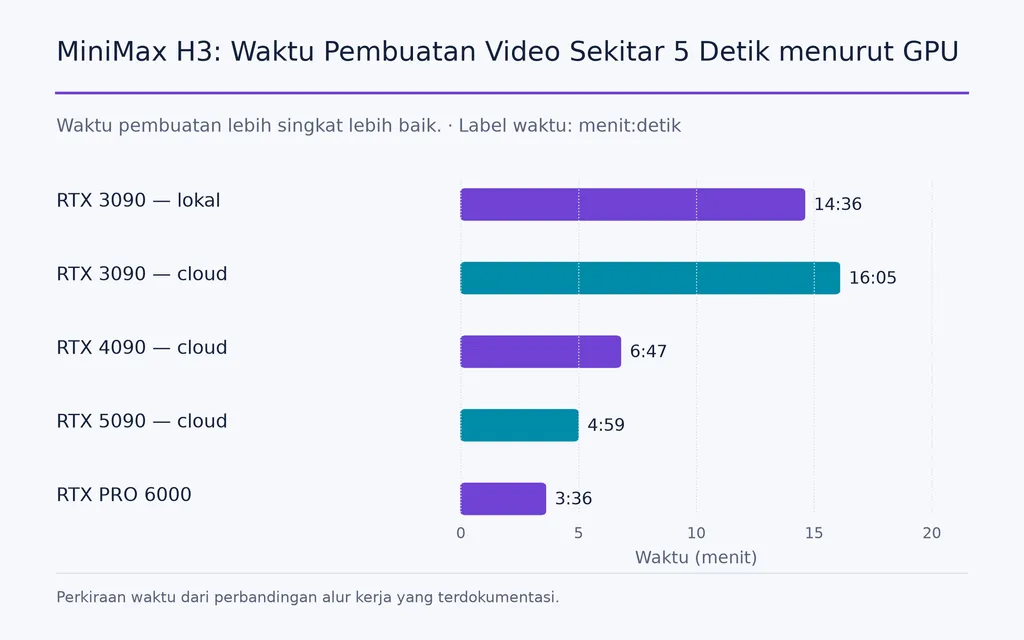
Data alur yang sebanding juga menunjukkan bahwa VRAM lebih besar tidak membuat H3 lebih cepat secara linear.
GPU | VRAM | Waktu Perkiraan untuk 5 Detik |
RTX 3090 lokal | 24GB | 14 menit 36 detik |
RTX 3090 cloud | 24GB | 16 menit 05 detik |
RTX 4090 cloud | 24GB | 6 menit 47 detik |
RTX 5090 cloud | 32GB | 4 menit 59 detik |
RTX PRO 6000 | 96GB | 3 menit 36 detik |
Pada kasus ini, 4090 lebih dari dua kali lebih cepat daripada 3090 meskipun kapasitas VRAM sama.
Satu alur H3 RTX 4090 yang dioptimalkan memakai INT8, SageAttention, Turbo LoRA, delapan langkah, sekitar 0.9MP, dan hasil 10 detik membutuhkan sekitar 9–10 menit, dengan perkiraan biaya komputasi sekitar $0.12 per pembuatan pada konfigurasi cloud tertentu tersebut.
Itu bukan harga H3 universal. Ukuran yang lebih berguna adalah biaya per klip yang dapat dipakai.
Optimasi memori dan kecepatan juga harus dibedakan. Satu alur 5090 terdokumentasi mengurangi memori GPU bersama sekitar 14GB dengan komponen model teroptimasi, tetapi kecepatan pembuatan mentah hampir tidak berubah. Susunan optimasi 4090 lain yang melibatkan kuantisasi, perubahan CUDA/Triton, dan optimasi atensi melaporkan sekitar peningkatan kecepatan keseluruhan 2.6×.
Apa Alur H3 Berbiaya Rendah Terbaik?
Optimasi biaya paling andal sering kali adalah membuat pratinjau sebelum merender bidikan akhir.
- Buat pratinjau resolusi rendah 1–2 detik.
- Periksa pembingkaian dan skala subjek.
- Pastikan Pose benar-benar mengikuti gerakan yang diinginkan.
- Nilai apakah Depth membantu atau terlalu membatasi bidikan.
- Periksa identitas dan arah visual umum.
- Naikkan durasi dan resolusi hanya setelah struktur stabil.
Dalam satu alur 12GB, pratinjau singkat dapat selesai sekitar satu menit atau kurang, dibandingkan banyak menit untuk rangkaian penuh.
Ini mengikuti prinsip dasar desain profesional: validasi struktur sebelum berinvestasi pada polesan.
Apa Masalah ControlNet H3 yang Paling Umum?
Fun ControlNet menambah presisi, tetapi juga memperkenalkan bentuk kegagalan baru.
Masalah umum dalam tinjauan alur kami meliputi:
- ketidakcocokan dimensi;
- jumlah bingkai salah;
- ketidakcocokan bentuk tensor;
- checkpoint tidak kompatibel;
- batch kontrol salah;
- konflik backend atensi;
- sinyal kontrol yang diam-diam berhenti berfungsi.
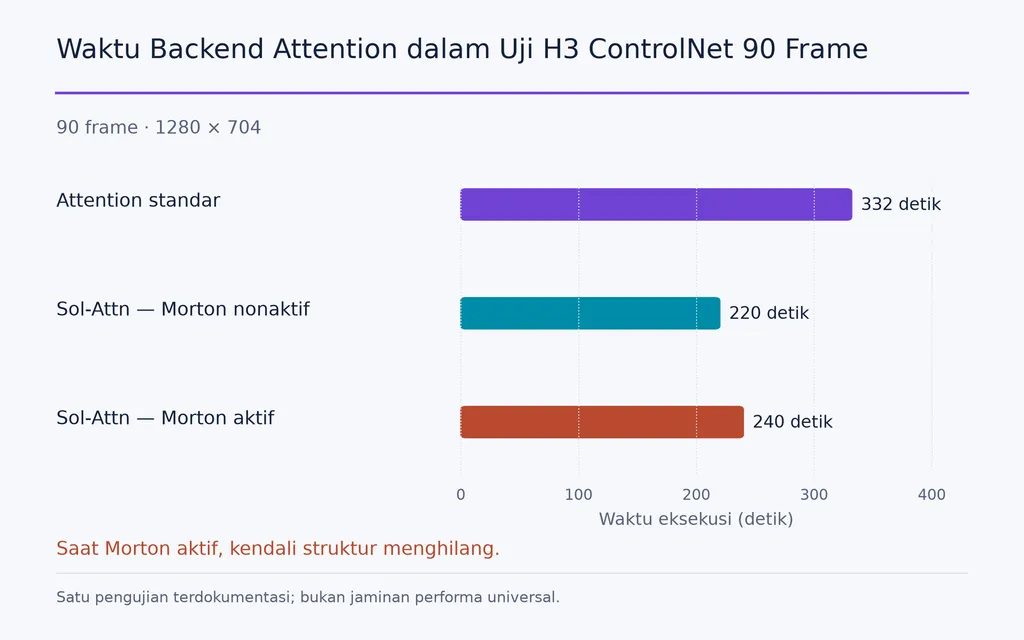
Satu tes atensi yang sangat berguna membandingkan alur yang sama, 90 bingkai, 1280 × 704:
- atensi standar: 332 detik
- Sol-Attn tanpa pengurutan ulang Morton: 220 detik
- Sol-Attn dengan pengurutan ulang Morton: 240 detik
Konfigurasi terakhir tetap membuat video masuk akal, tetapi kontrol struktur praktis hilang karena urutan token tidak lagi selaras dengan benar.
Karena itu setiap konfigurasi ControlNet baru perlu menyertakan uji A/B kontrol aktif versus nonaktif dengan seed yang sama.
Hal yang Belum Bisa Diselesaikan Pose dan Depth
Pose dan Depth meningkatkan kontrol struktur, tetapi tidak otomatis menjamin:
- identitas wajah sempurna;
- konsistensi pakaian;
- stabilitas warna video panjang;
- tangan sempurna;
- pemakaian VRAM lebih rendah;
- pembuatan lebih cepat;
- tanpa pengulangan sama sekali.
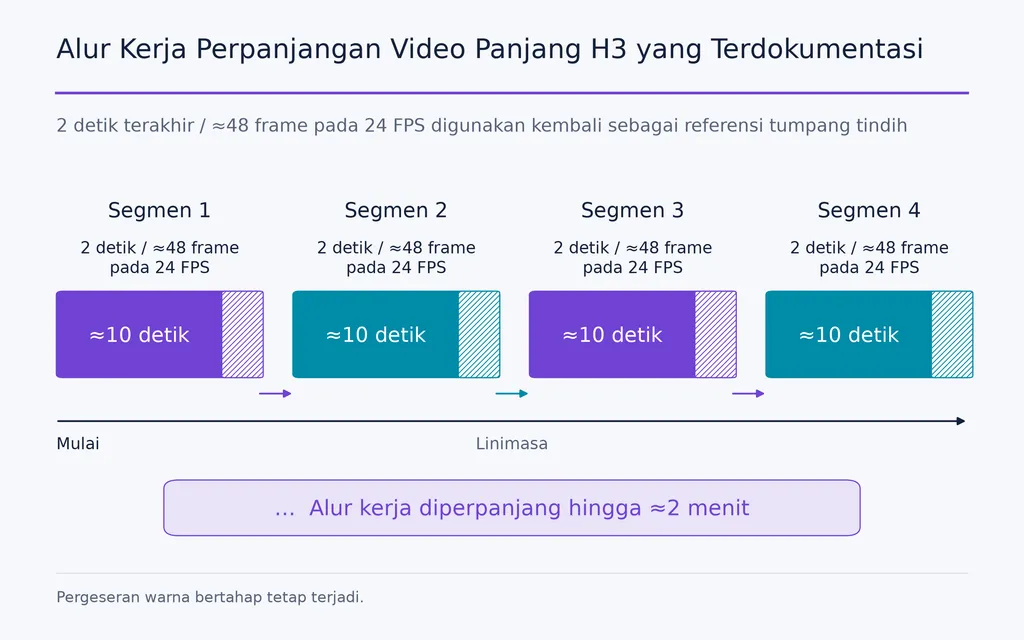
Kontinuitas panjang masih sangat sulit. Satu alur terdokumentasi membuat segmen sekitar 10 detik, lalu memakai kembali 2 detik terakhir, atau sekitar 48 bingkai pada 24 FPS, sebagai referensi segmen berikutnya.
Pendekatan itu diperpanjang hingga sekitar dua menit, tetapi penyimpangan warna bertahap tetap terlihat.
Pembedaan ini penting: konsistensi gerakan dan konsistensi visual berhubungan, tetapi bukan masalah yang sama.
Kesimpulan
Pada MiniMax H3, kontrol Pose dan Depth penting karena Fun ControlNet membuat H3 menjadi alur video lebih modular: Reference membawa identitas dan penampilan, Pose membatasi gerakan sendi, Depth membatasi geometri ruang, dan prompt menentukan arah kreatif. Kasus terdokumentasi juga menunjukkan mengapa sistem tetap membutuhkan pemikiran produksi yang cermat: multikontrol bisa jenuh, subjek kecil merespons Depth secara berbeda, referensi panjang memakan banyak VRAM, optimasi atensi dapat diam-diam merusak kontrol, dan performa perangkat sangat bervariasi antarkonfigurasi. Jadi perbaikan sesungguhnya bukan sekadar “lebih banyak kontrol”, melainkan kemampuan mendiagnosis, mengarahkan, dan mengulangi gerakan, geometri, serta penampilan sebagai variabel kreatif terpisah.
Pertanyaan Umum
Apakah H3 mendukung Pose dan Depth secara native?
Tidak. Pose dan Depth bukan bagian fitur native peluncuran awal H3. Keduanya ditambahkan melalui ekstensi Fun ControlNet yang hadir kemudian, yang juga mendukung kontrol struktur Canny, HED, dan MLSD.
Apa perbedaan Reference Video dan Pose Control H3?
Reference Video memberi H3 panduan semantik kaya tentang penampilan, sedangkan Pose memberi batasan gerakan tubuh yang lebih eksplisit. Gunakan Reference jika penafsiran kreatif dapat diterima, dan Pose jika koreografi atau gerakan subjek harus mengikuti struktur lebih jelas.
Bisakah Pose H3 menjaga identitas karakter tetap konsisten?
Tidak sendirian. Pose mengontrol struktur dan gerakan tubuh, bukan identitas karakter. Untuk penggantian karakter, gunakan Reference bagi penampilan dan identitas, Pose bagi gerakan, dan Depth jika bidikan memerlukan kontrol ruang lebih kuat.
Bisakah H3 berjalan pada VRAM 12GB?
Ya. Alur H3 terdokumentasi pada RTX 3060 dan RTX 4070 Ti menunjukkan VRAM 12GB dapat menjalankan H3, tetapi resolusi, durasi, panjang referensi, kuantisasi, dan offloading sangat memengaruhi performa. Alur VRAM rendah praktis untuk eksperimen, tetapi biasanya membutuhkan lebih banyak kompromi daripada konfigurasi produksi ber-VRAM tinggi.
Artikel lainnya dari Blog Virse
Alur kerja

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 Oktober 2026 by Yifan Zhao
Alur kerja

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 Oktober 2026 by Yifan Zhao
Alur kerja

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 Oktober 2026 by Yifan Zhao