
Guía de MiniMax H3: coherencia de personajes, VRAM, LoRA y flujos reales
 Yifan Zhao10 min de lectura ·
MiniMax H3 es un modelo de vídeo multimodal abierto para la generación guiada por referencias de texto, imágenes, vídeo y audio. Su ventaja para los diseñadores va más allá de la calidad: Ref2VA convierte personajes, productos, movimientos, voces y entornos en contexto creativo reutilizable. H3 admite audio nativo, clips de hasta 15 segundos y regeneración a mayor resolución dentro de un flujo de producción H3 más amplio.
El problema es que un buen resultado con H3 sigue dependiendo mucho del diseño del flujo de trabajo. Los personajes pueden cambiar entre planos, las referencias entrar en conflicto y las resoluciones altas agotar la VRAM. La producción local suele incluir ComfyUI, aceleradores, LoRA y herramientas de ampliación. En nuestra revisión, la diferencia entre una demostración impresionante y un sistema repetible normalmente estaba en organizar referencias, iteraciones y recursos aprobados mediante una estrategia disciplinada de prompts para H3.
Virse reduce esa carga al reunir modelos, referencias y tareas creativas en un lienzo visual. MiniMax H3, Seedance 2.0 y Seedance 2.5 están disponibles en Virse. Los planes de pago incluyen uso ilimitado de más de 40 modelos, como Nano Banana 2 y GPT Image 2, y puestos ilimitados. Los nuevos usuarios reciben créditos gratuitos para hasta 10 imágenes Nano Banana 2 o un vídeo Seedance 2.0. Virse se centra en contexto visual, colaboración entre agentes y conocimiento reutilizable del proyecto, sin tratar cada generación como una conversación aislada.
¿Qué es MiniMax H3 y cómo funciona su sistema multimodal?
MiniMax H3 se entiende mejor como un modelo de producción multimodal que como un generador básico de texto a vídeo. Combina referencias diferentes para no tener que comprimir identidad, movimiento, composición, diálogo y sonido en un solo prompt.
Su flujo separa interpretación del contexto, generación base y regeneración a mayor resolución. Esto importa profesionalmente porque un proyecto contiene relaciones: qué rostro pertenece a cada personaje, qué voz corresponde al hablante, qué movimiento seguir y qué detalles deben permanecer intactos.
MiniMax H3: FL2VA frente a Ref2VA
Los dos modos principales resuelven problemas de producción diferentes.
Modo | Uso más adecuado | Estrategia de referencias |
|---|---|---|
FL2VA | T2V, I2V, control del primer fotograma o del primero y último | Encuadre y control de plano sencillos |
Ref2VA | Personajes, productos, movimiento, escenas, voces | Varias referencias de imagen, vídeo y audio |
Ref2VA admite flujos con hasta nueve imágenes más referencias de vídeo y audio, con un máximo de 12 archivos mixtos dentro de los límites compatibles. La ventaja no es solo añadir entradas, sino asignar funciones distintas a los recursos creativos.
Por ejemplo, unas imágenes definen al personaje, otras la ropa; un vídeo aporta movimiento y un audio proporciona voz o contexto interpretativo.
¿Cómo mejora Ref2VA la coherencia de personajes?
Ref2VA mejora la coherencia de personajes al reutilizar su identidad visual en vez de reconstruirla con texto en cada plano. Sin embargo, nuestra investigación sugiere que la calidad de las referencias importa más que su cantidad máxima.
Construir un sistema reutilizable de referencias de personaje
Uno de los flujos más sólidos utilizó H3 para crear una secuencia controlada de giro de 360 grados, extraer fotogramas útiles y reutilizar esas vistas. Así, un vídeo logrado se convierte en un recurso de personaje reutilizable, no en un resultado desechable.
Un flujo práctico consiste en:
- Fijar rostro, peinado, proporciones corporales, ropa y accesorios clave.
- Preparar vistas frontal, de perfil, de tres cuartos y de cuerpo entero.
- Eliminar referencias con apariencia o estilo contradictorios.
- Usar solo las referencias pertinentes para cada plano.
- Incorporar los fotogramas logrados a la biblioteca de referencias.
El principio clave es lograr coherencia mediante selección, no volumen de referencias.
Por qué varios personajes aún pueden perder coherencia
Los problemas de identidad aumentan cuando aparecen dos personajes juntos, se superponen varias referencias faciales o cambian los entornos entre planos.
Conviene establecer cada personaje por separado antes de crear interacciones. Al introducir dos grupos de referencias a la vez, asignar claramente sus funciones importa más que añadir texto descriptivo.
¿Cuánta VRAM necesita MiniMax H3 para generar localmente?
H3 puede ejecutarse en GPU de consumo con flujos optimizados, pero la velocidad útil de iteración depende de mucho más que de que el modelo quepa en la VRAM.
Los resultados reales de nuestra investigación muestran lo amplio que puede ser el rango.
GPU y flujo | Salida | Resultado comunicado |
|---|---|---|
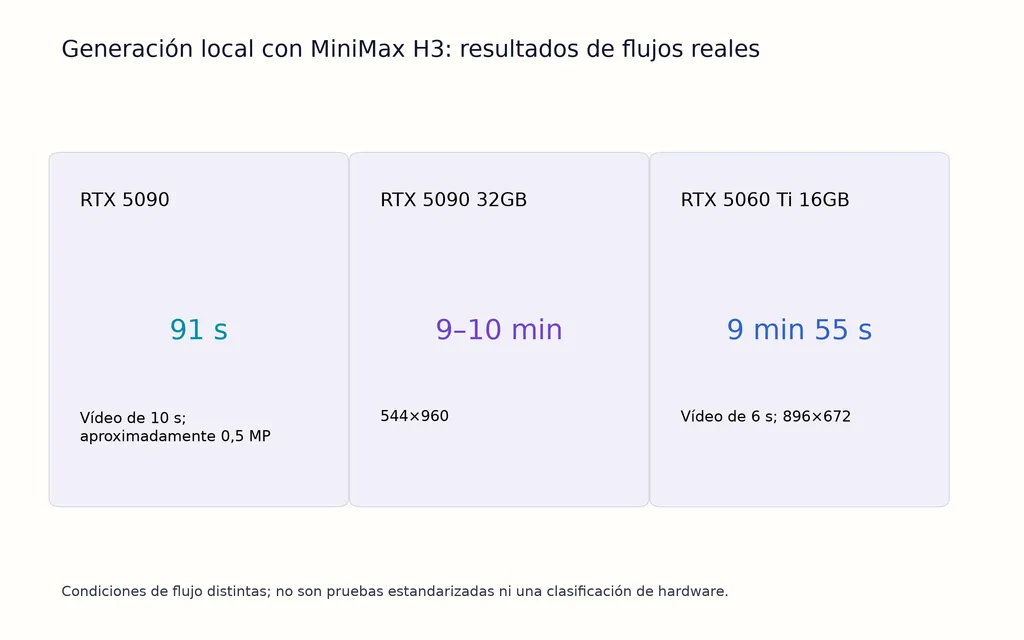
RTX 5090 | 10 s, aproximadamente 0,5 MP | 91 s |
RTX 5090 de 32 GB | 544×960 | 9–10 min |
RTX 5060 Ti de 16 GB | 896×672, 6 s, varias referencias | 9 min 55 s |
RTX 5090 de 32 GB | Aumento de aproximadamente 1 MP a 2 MP | De 30 s/paso a 590 s/paso |
Son observaciones de flujos concretos, no pruebas estandarizadas, por lo que no garantizan un rendimiento universal. Aun así, muestran el cuello de botella: al superar el margen cómodo de memoria de la GPU, la descarga y el movimiento de datos pueden dominar el tiempo de generación.
Por qué una mayor resolución puede ralentizar H3 drásticamente
El caso de la 5090, cuyo tiempo por paso pasó de unos 30 a 590 segundos al acercarse a 2 MP, ilustra claramente el riesgo.
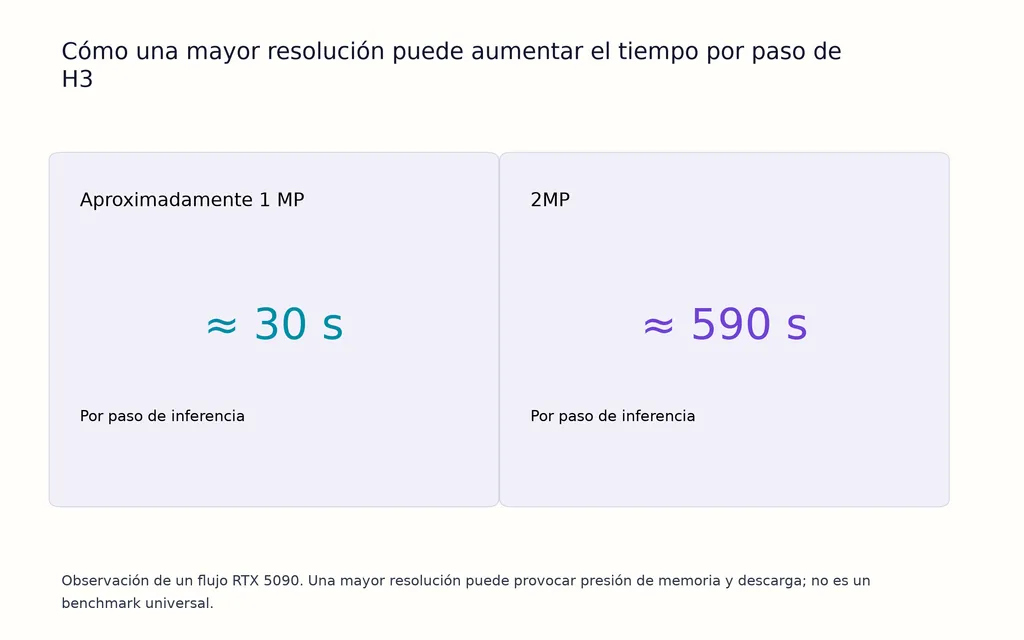
Para equipos creativos, la regla es sencilla: no incluir el renderizado de alta resolución en la exploración inicial. Validar primero movimiento, composición y referencias; después dedicar cómputo a los planos aprobados.
¿Qué flujo de MiniMax H3 conviene para producir vídeo con IA?
Un flujo práctico separa contexto creativo, iteración económica, renderizado final y acabado.
Organizar las referencias antes de generar
Separar recursos por propósito: identidad, ropa, entorno, producto, composición, movimiento, voz y estilo. Facilita diagnosticar fallos y reduce el contexto contradictorio.
Una carpeta grande de referencias sin ordenar no es un prompt más potente; suele ser menos predecible.
Prototipar con menor coste y ampliar los planos aprobados
Un flujo generaba a 544×960 en unos 9–10 minutos con una RTX 5090 y luego utilizaba LTX 2.3 para aumentar la salida a 1152×2048.
La lección general, más allá de esa configuración, es que la resolución de generación y la de entrega no siempre deben resolverse en el mismo paso.
Estructurar prompts por sujeto, movimiento, cámara y audio
Los prompts son más fiables cuando cada instrucción tiene una función clara. Definir quién o qué aparece, qué hace, cómo se comporta la cámara, qué referencia corresponde a cada sujeto y qué debe escucharse.
Revisamos fallos en los que había diálogo sin una asociación clara con el hablante visible. Relacionar explícitamente personaje y diálogo mejora el control. Si no debe haber música de fondo, también hay que indicarlo.
Es más eficaz que alargar el prompt sin más.
Usar aceleradores para iterar, no automáticamente para el resultado final
Spectrum, SageAttention, Sol Attention, Turbo LoRA y otras optimizaciones reducen la inferencia. Sin embargo, también encontramos informes de peor movimiento, anatomía, seguimiento del prompt o relleno de imágenes con aceleraciones agresivas.
Una estrategia mejor es configuraciones rápidas para explorar y de mayor fidelidad para entregar.
Casos de MiniMax H3: qué revelan los flujos reales
Los flujos reales explican las fortalezas de H3 mejor que una lista de funciones.
Caso 1: un vídeo de 10 segundos en 91 segundos
Un flujo local con RTX 5090 generó un clip de 10 segundos a unos 0,5 MP en 91 segundos.
A esa velocidad, una estación local de gama alta permite iterar repetidamente sobre prompts y referencias durante una sesión creativa. Pero el resultado no debe extrapolarse a renderizados de 1 o 2 MP.
Caso 2: Ref2V en una RTX 5060 Ti de 16 GB
Un flujo más limitado utilizó dos referencias de personajes, dos pistas de diálogo y varias optimizaciones de inferencia en una RTX 5060 Ti con 16 GB de VRAM.
El resultado fue 896×672, seis segundos, en 9 minutos y 55 segundos.
Demuestra que 16 GB permiten trabajo útil con H3, pero iterar resulta lo bastante costoso como para que preparar mejor las referencias ahorre tiempo directamente.
Caso 3: convertir una salida de H3 en un recurso de personaje reutilizable
Otro flujo creaba un giro lento del personaje, extraía varias vistas y usaba esos fotogramas en generaciones posteriores.
El resultado importante no es un solo vídeo mejor, sino un sistema persistente de referencias de personaje. Es valioso para equipos profesionales porque los recursos generados pasan a ser entradas estructuradas para trabajos futuros.
¿Cuándo entrenar una LoRA en vez de usar Ref2VA?
Empezar con Ref2VA si las referencias ya describen bien al sujeto. Entrenar una LoRA cuando un estilo, identidad, movimiento o voz recurrente no pueda reproducirse de forma fiable solo con referencias.
Coste de entrenar LoRA de H3 con imágenes frente a vídeo
Una prueba de entrenamiento incluida en la investigación produjo estos resultados.
Entrada de entrenamiento | VRAM | Tiempo por paso |
|---|---|---|
Imágenes, RTX PRO 4500 | 20,49 GB | 0,72 s |
Vídeo, RTX PRO 4500 | 20,9 GB | 3,01 s |
Imágenes, Tesla T4 | 12,7 GB | 16,2 s |
En esta prueba, el vídeo utilizó una VRAM similar, pero cada paso tardó unas cuatro veces más que con imágenes en la RTX PRO 4500.
Una conclusión práctica es usar imágenes fijas para la apariencia cuando sea posible y reservar el vídeo para movimientos que realmente haya que aprender.
LoRA de H3 puede combinar apariencia, movimiento y voz
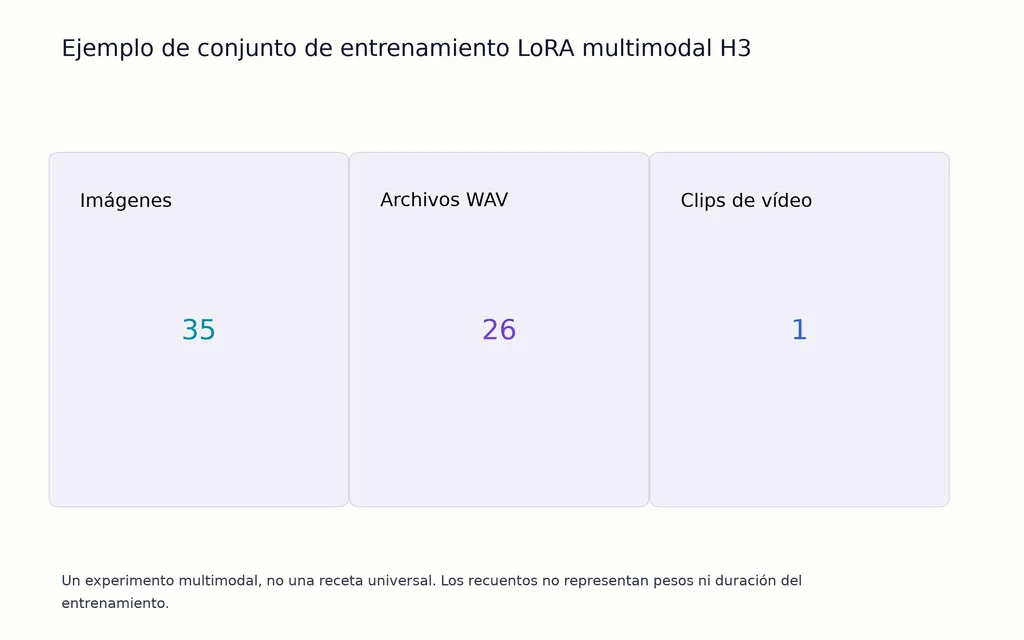
Un experimento multimodal utilizó 35 imágenes, 26 archivos WAV y un clip de vídeo. Después de la época 40, pasó hacia entrenamiento solo de audio para reforzar la voz y limitar el sobreajuste visual adicional.
Es un experimento individual, no una receta universal. Pero apunta a una dirección importante: un personaje de IA puede ser una combinación reutilizable de apariencia, voz, movimiento y comportamiento.
¿Cuáles son las mayores limitaciones de MiniMax H3?
Las limitaciones se centran cada vez más en el control de producción que en la calidad básica de generación.
Aparecieron repetidamente seis problemas: complejidad de ComfyUI, coherencia entre personajes, lentitud a alta resolución, compromisos de calidad de aceleradores, entrenamiento LoRA inmaduro y sensibilidad al prompt.
Por eso el siguiente paso no es solo un modelo mejor. Los diseñadores necesitan conservar referencias aprobadas, relaciones entre personajes, contexto de escena, historial y recursos reutilizables. Aquí son relevantes espacios visuales como Virse: la interfaz debe comprender el proyecto alrededor del modelo, no solo el último prompt.
Preguntas frecuentes sobre MiniMax H3
¿Cuánta VRAM necesita H3: 16, 24 o 32 GB?
16 GB permiten ejecutar flujos optimizados de H3, aunque pueden requerir cuantización, descarga de memoria o más tiempo. Revisamos una RTX 5060 Ti de 16 GB que completó seis segundos a 896×672 con varias referencias en 9:55. Más VRAM ofrece flexibilidad, pero incluso 32 GB pueden ralentizarse mucho si la resolución supera el margen cómodo de memoria.
¿Ref2VA o LoRA para mantener la identidad del personaje?
Empezar con Ref2VA cuando hay buenas referencias: facilita iterar y evita entrenar. Usar LoRA si las referencias fallan repetidamente al reproducir identidad, movimiento, estilo o voz en muchas generaciones. Para muchos proyectos, seleccionar referencias de varios ángulos resulta más económico que entrenar inmediatamente un adaptador.
¿Por qué Turbo y otros aceleradores pueden reducir la calidad?
La aceleración cambia la inferencia y los ajustes agresivos pueden sacrificar fidelidad. Movimiento, anatomía, seguimiento de instrucciones y relleno fueron áreas susceptibles de deteriorarse. Conviene experimentar con ajustes rápidos, comparar con una base más lenta y reservar la mayor fidelidad para renderizados finales aprobados.
¿Por qué añadir referencias puede reducir la coherencia?
Más referencias añaden relaciones que el modelo debe resolver. Rostros, ropa, entornos o estilos contradictorios compiten. Usar grupos de referencias más reducidos y limpios, asignarlos explícitamente a los sujetos y establecer cada personaje por separado antes de reunir identidades en un plano complejo.
Conclusión
MiniMax H3 aporta más valor como sistema de producción multimodal que como generador de vídeo de un solo prompt. Ref2VA transforma personajes, productos, movimiento, voces y escenas en contexto reutilizable; los flujos locales abarcan desde 16 GB optimizados hasta GPU de gama alta; y las nuevas técnicas LoRA extienden la identidad a movimiento y audio. La investigación apunta al mismo principio: organizar referencias primero, explorar con poco coste, conservar los resultados logrados y dedicar cómputo de alta calidad cuando las decisiones creativas estén estables. Pasar de generaciones aisladas a contexto creativo persistente es lo que hace especialmente valioso a H3 para diseñadores y equipos.
Más del blog de Virse
Flujo de trabajo

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de octubre de 2026 by Yifan Zhao
Flujo de trabajo

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de octubre de 2026 by Yifan Zhao