
MiniMax H3 가이드: 캐릭터 일관성, VRAM, LoRA와 실제 작업 과정
 Yifan Zhao9분 읽기 ·
MiniMax H3는 텍스트, 이미지, 영상, 오디오를 아우르는 참조 기반 생성을 위한 개방형 멀티모달 영상 모델입니다. 디자이너에게 장점은 화질만이 아닙니다. Ref2VA는 캐릭터, 제품, 동작, 목소리, 환경을 재사용 가능한 창작 맥락으로 바꿉니다. H3는 기본 오디오 생성, 최대15초 클립, 더 높은 해상도의 재생성을 폭넓은 H3 제작 과정에서 지원합니다.
문제는 좋은 H3 결과가 여전히 작업 과정 설계에 크게 의존한다는 점입니다. 샷 사이에서 캐릭터가 달라지고, 참조가 충돌하며, 고해상도가 VRAM을 압박할 수 있습니다. 로컬 제작에는 ComfyUI, 가속기, LoRA, 업스케일러가 자주 관여합니다. 검토 결과 인상적인 데모와 반복 가능한 시스템의 차이는 대체로 체계적인 H3 프롬프트 전략으로 참조, 반복, 승인 자산을 어떻게 정리하느냐에 있었습니다.
Virse는 모델, 참조, 창작 작업을 하나의 시각 캔버스에 모아 이 부담을 줄입니다. MiniMax H3, Seedance 2.0, Seedance 2.5를 사용할 수 있으며 유료 요금제는 Nano Banana 2와 GPT Image 2 등40개 이상 모델의 무제한 사용과 무제한 좌석을 제공합니다. 신규 사용자는 Nano Banana 2 이미지 최대10장 또는 Seedance 2.0 영상1편에 해당하는 무료 크레딧을 받습니다. Virse는 생성을 개별 채팅으로 다루는 대신 시각 맥락, 다중 에이전트 협업, 재사용 가능한 프로젝트 지식을 중심으로 설계되었습니다.
MiniMax H3는 무엇이며 멀티모달 영상 시스템은 어떻게 작동할까요?
MiniMax H3는 기본적인 텍스트 영상 생성기보다 멀티모달 제작 모델로 이해하는 편이 좋습니다. 여러 참조를 결합해 정체성, 동작, 구성, 대사, 소리를 하나의 프롬프트에 압축하지 않아도 됩니다.
과정은 맥락 해석, 기본 생성, 고해상도 재생성을 분리합니다. 전문 프로젝트에는 어느 얼굴이 어느 캐릭터인지, 어느 목소리가 화자에 해당하는지, 어떤 동작을 따르고 어떤 세부를 유지할지라는 관계가 있어 이 구조가 중요합니다.
MiniMax H3: FL2VA와 Ref2VA 비교
두 핵심 모드는 서로 다른 제작 문제를 해결합니다.
모드 | 적합한 용도 | 참조 전략 |
|---|---|---|
FL2VA | T2V, I2V, 첫 프레임 및 첫/마지막 프레임 제어 | 간단한 구도와 샷 제어 |
Ref2VA | 캐릭터, 제품, 동작, 장면, 목소리 | 여러 이미지, 영상, 오디오 참조 |
Ref2VA는 이미지 최대9장에 영상과 오디오를 더해 지원 범위 내에서 혼합 참조 파일 최대12개를 사용하는 과정을 지원합니다. 단순히 입력을 늘리는 것이 아니라 자산마다 다른 역할을 줄 수 있습니다.
예를 들어 한 이미지 묶음은 캐릭터를, 다른 묶음은 의상을 정하고, 영상은 동작을, 오디오는 목소리나 연기 맥락을 제공합니다.
Ref2VA는 캐릭터 일관성을 어떻게 개선할까요?
Ref2VA는 시각 정체성을 재사용해 일관성을 높이고, 매 샷마다 텍스트로 다시 만들 필요를 줄입니다. 다만 연구는 참조 개수를 극대화하기보다 품질이 더 중요함을 시사합니다.
재사용 가능한 H3 캐릭터 참조 시스템 만들기
효과적인 한 과정은 H3로 통제된 360도 캐릭터 회전 시퀀스를 만들고, 유용한 프레임을 추출해 후속 생성에 재사용했습니다. 성공한 영상이 일회성 결과가 아닌 재사용 자산이 됩니다.
실용적인 과정은 다음과 같습니다.
- 얼굴, 머리, 신체 비율, 의상, 주요 액세서리를 고정합니다.
- 정면, 측면, 사선, 전신 뷰를 준비합니다.
- 외모나 스타일이 충돌하는 참조를 제거합니다.
- 샷마다 관련 참조만 사용합니다.
- 성공한 프레임을 프로젝트 참조 라이브러리에 넣습니다.
핵심은 참조 양이 아니라 선별로 일관성을 확보하는 것입니다.
여러 캐릭터에서 일관성이 깨지는 이유
검토에서는 두 인물이 함께 등장하거나 얼굴 참조가 겹치거나 샷 사이의 환경이 바뀔 때 정체성 문제가 더 흔했습니다.
상호작용 샷을 만들기 전에 캐릭터를 각각 확립하세요. 두 참조 묶음을 동시에 도입할 때는 설명문 추가보다 명확한 역할 배정이 중요합니다.
로컬 생성에 필요한 MiniMax H3 VRAM은 얼마일까요?
최적화하면 소비자 GPU에서도 실행되지만 실용적인 반복 속도는 모델이 VRAM에 들어가는지 이상에 달려 있습니다.
실제 결과는 그 차이가 얼마나 커질 수 있는지 보여줍니다.
GPU와 과정 | 출력 | 보고 결과 |
|---|---|---|
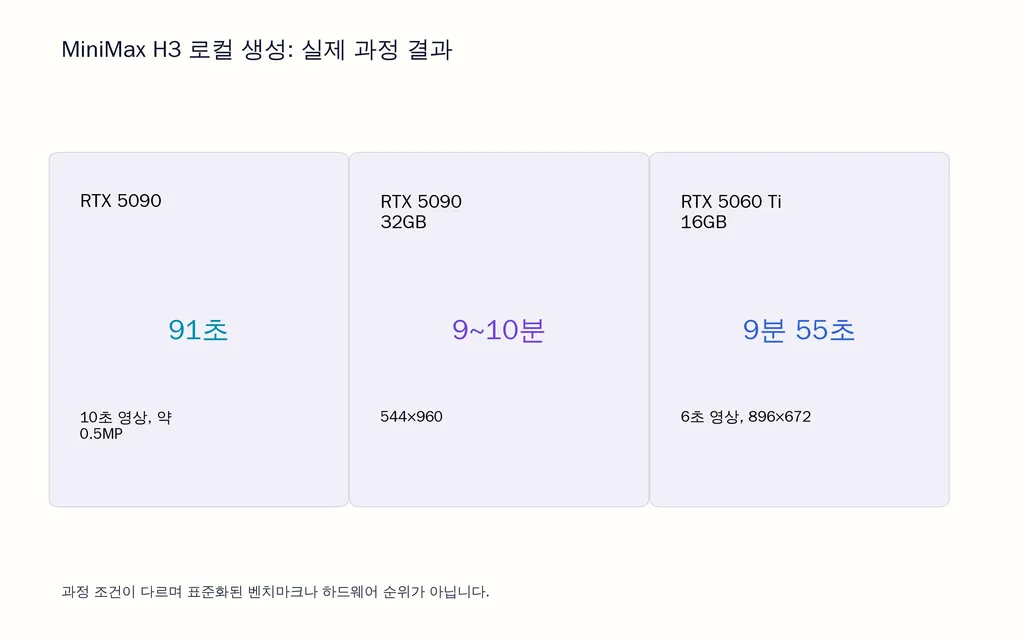
RTX 5090 | 10초, 약0.5MP | 91초 |
RTX 5090 32GB | 544×960 | 9~10분 |
RTX 5060 Ti 16GB | 896×672, 6초, 다중 참조 | 9분55초 |
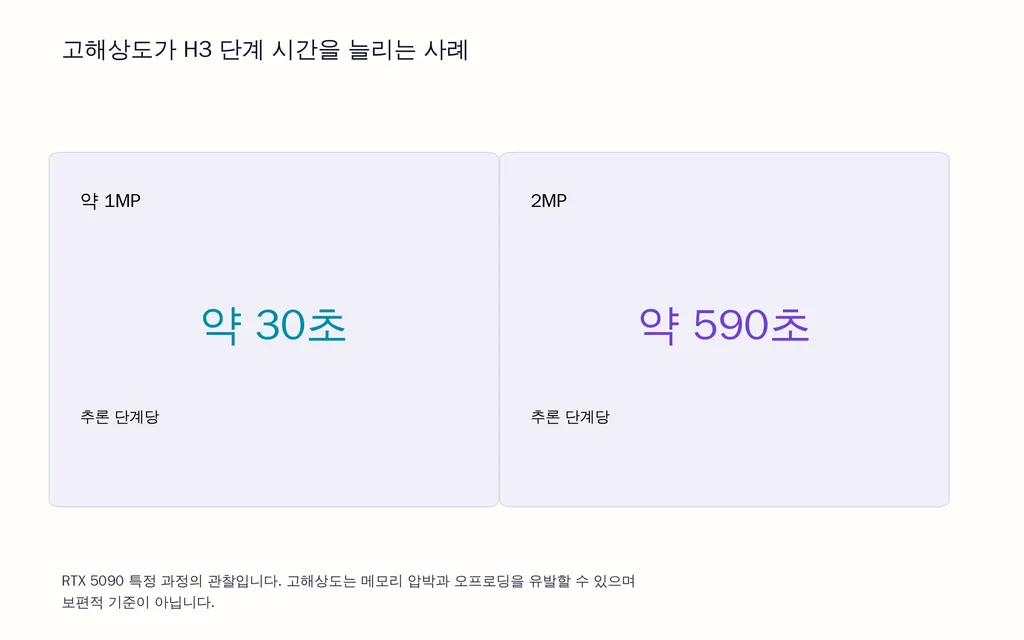
RTX 5090 32GB | 약1MP에서2MP로 증가 | 단계당30초에서590초로 |
이는 특정 과정의 관찰이며 표준화된 벤치마크가 아니므로, 보편적 성능 보장에 쓰면 안 됩니다. 다만 실제 병목을 보여줍니다. GPU 메모리의 여유를 넘으면 오프로딩과 데이터 이동이 생성 시간을 지배할 수 있습니다.
고해상도가 H3를 크게 느리게 만드는 이유
5090에서 약2MP로 높인 뒤 단계 시간이 약 30초에서590초로 늘어난 사례는 위험을 분명히 보여줍니다.
창작팀의 간단한 원칙은 초기 탐색에 고해상도 렌더링을 넣지 않는 것입니다. 동작, 구도, 참조를 먼저 검증하고 승인된 샷에 연산을 쓰세요.
AI 영상 제작에 적합한 H3 작업 과정은 무엇일까요?
실용적인 과정은 창작 맥락, 저비용 반복, 최종 렌더링, 마무리를 분리합니다.
생성 전에 참조 정리하기
캐릭터 정체성, 의상, 환경, 제품, 구도, 동작, 목소리, 스타일 등 목적별로 자산을 나눕니다. 실패를 진단하기 쉽고 상충 맥락이 줄어듭니다.
정리되지 않은 참조가 가득한 폴더는 더 강한 프롬프트가 아닙니다. 오히려 예측하기 어려워집니다.
저비용으로 시제품을 만들고 승인 샷을 업스케일하기
한 과정은 RTX 5090에서544×960을 약9~10분에 생성한 뒤 LTX 2.3으로 1152×2048까지 높였습니다.
이 설정을 넘어 적용되는 교훈은 생성 해상도와 납품 해상도를 같은 단계에서 해결할 필요는 없다는 것입니다.
대상, 동작, 카메라, 오디오로 프롬프트 구성하기
지시마다 역할이 명확하면 더 안정적입니다. 누가 또는 무엇이 나오고, 무엇을 하며, 카메라는 어떻게 움직이고, 참조가 어느 대상에 해당하며, 무엇이 들려야 하는지를 정하세요.
대사는 있지만 보이는 화자와 연결이 불명확한 실패도 있었습니다. 캐릭터와 대사의 관계를 명시하면 제어가 좋아집니다. 배경 음악이 없어야 할 때도 분명히 적으세요.
프롬프트를 길게만 만드는 것보다 효과적입니다.
가속기는 반복에 쓰고 최종 결과에 자동 적용하지 않기
Spectrum, SageAttention, Sol Attention, Turbo LoRA 같은 최적화는 추론 시간을 줄입니다. 하지만 공격적인 가속에서 동작, 인체 구조, 프롬프트 준수, 인페인팅 품질이 약해졌다는 보고도 있었습니다.
더 나은 전략은 탐색에는 빠른 설정, 납품에는 충실도가 높은 설정입니다.
MiniMax H3 사례: 실제 제작 과정이 알려주는 것
실제 과정은 기능 목록보다 H3의 강점을 잘 설명합니다.
사례1: 10초 영상을91초에 생성
로컬 RTX 5090 과정에서 약0.5MP의10초 클립을91초에 생성했습니다.
이 속도라면 고급 로컬 워크스테이션에서 창작 중 프롬프트와 참조를 여러 번 시험할 수 있습니다. 그러나 결과를1MP나2MP 렌더링에 그대로 적용하면 안 됩니다.
사례2: 16GB RTX 5060 Ti에서 Ref2V
더 제한된 과정은16GB VRAM의 RTX 5060 Ti에서 캐릭터 참조2개, 대사 오디오2개, 여러 추론 최적화를 사용했습니다.
결과는 896×672, 6초 영상으로9분55초에 완료되었습니다.
16GB 하드웨어도 의미 있는 작업을 할 수 있지만 반복 비용이 높아, 참조 준비를 개선하면 제작 시간이 직접 절약됩니다.
사례3: H3 출력을 재사용 캐릭터 자산으로 바꾸기
다른 과정은 천천히 회전하는 캐릭터를 만들고 여러 시점을 추출해 후속 생성에 넣었습니다.
핵심 결과는 영상 하나의 개선이 아니라 지속적인 캐릭터 참조 시스템입니다. 생성 자산을 후속 작업의 구조화된 입력으로 만들 수 있어 전문팀에 유용합니다.
Ref2VA 대신 H3 LoRA를 언제 학습해야 할까요?
기존 참조가 대상을 잘 설명하면 Ref2VA로 시작하세요. 반복되는 스타일, 정체성, 동작, 목소리를 참조만으로 안정적으로 재현하지 못할 때 LoRA를 학습하세요.
H3 이미지와 영상 LoRA 학습 비용 비교
검토한 학습 벤치마크 하나는 다음 결과를 제시했습니다.
학습 입력 | VRAM | 단계당 시간 |
|---|---|---|
이미지, RTX PRO 4500 | 20.49GB | 0.72초 |
영상, RTX PRO 4500 | 20.9GB | 3.01초 |
이미지, Tesla T4 | 12.7GB | 16.2초 |
이 테스트에서 영상 학습은 비슷한 VRAM을 썼지만 RTX PRO 4500의 이미지 학습보다 단계당 약4배 오래 걸렸습니다.
실용적인 결론은 외모에는 가능하면 정지 이미지를 쓰고, 영상 학습은 실제로 배워야 할 동작에 남겨두는 것입니다.
H3 LoRA는 외모, 동작, 목소리를 결합할 수 있습니다
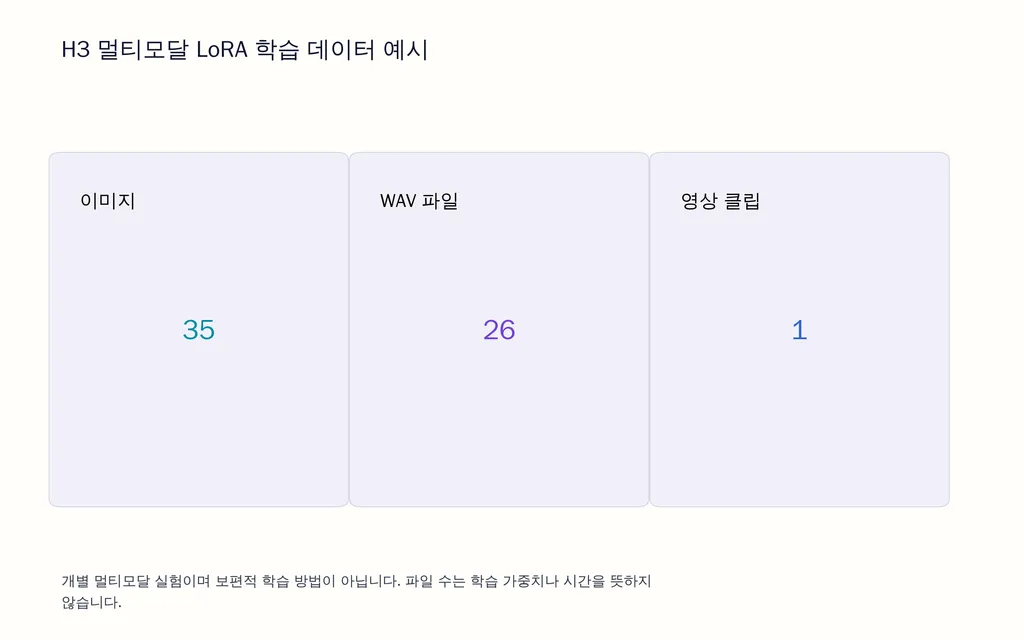
한 멀티모달 실험은 이미지35장, WAV 파일26개, 영상1편을 사용했습니다. 에포크40 이후 오디오 전용 학습으로 전환해 목소리 특징을 강화하면서 추가 시각 과적합을 제한했습니다.
이는 개별 실험이며 보편적 방법은 아닙니다. 다만 AI 캐릭터가 외모, 목소리, 동작, 행동의 재사용 가능한 조합이 되는 중요한 방향을 보여줍니다.
MiniMax H3의 가장 큰 한계는 무엇일까요?
주요 한계는 점점 기본 생성 품질보다 제작 제어에 집중됩니다.
반복된 문제는 복잡한 ComfyUI 과정, 다중 캐릭터 일관성, 느린 고해상도 생성, 가속기의 품질 절충, 미성숙한 LoRA 학습, 프롬프트 민감성의 여섯 가지입니다.
다음 단계에는 더 나은 모델뿐 아니라 승인 참조, 캐릭터 관계, 장면 맥락, 프로젝트 이력, 재사용 자산을 보존할 시스템이 필요합니다. Virse 같은 시각 AI 공간이 중요한 이유입니다. 인터페이스는 최신 프롬프트만이 아니라 모델 주변의 프로젝트를 이해해야 합니다.
MiniMax H3 자주 묻는 질문
H3에 필요한 VRAM은16GB, 24GB, 32GB 중 무엇인가요?
16GB도 최적화된 H3 과정을 실행할 수 있지만, 양자화, 오프로딩, 더 긴 렌더링이 필요할 수 있습니다. 검토에는16GB RTX 5060 Ti가896×672, 6초 다중 참조 작업을9분55초에 마친 사례가 있습니다. 더 큰 VRAM은 유연성을 주지만 해상도가 메모리 여유를 넘으면32GB도 크게 느려질 수 있습니다.
캐릭터 일관성에는 Ref2VA와 LoRA 중 무엇이 낫나요?
좋은 참조가 있다면 Ref2VA로 시작하세요. 반복이 빠르고 학습 부담이 없습니다. 여러 생성에서 필요한 정체성, 동작, 스타일, 목소리를 참조가 계속 재현하지 못할 때 LoRA를 쓰세요. 많은 프로젝트에서는 선별한 다각도 참조가 곧바로 어댑터를 학습하는 것보다 경제적입니다.
Turbo 같은 가속기는 왜 품질을 낮출 수 있나요?
가속은 추론 과정을 바꾸며 공격적인 설정은 충실도를 속도와 바꿀 수 있습니다. 검토한 과정에서 동작, 인체 구조, 지시 준수, 인페인팅이 저하될 수 있었습니다. 빠른 설정으로 실험하고 느린 기준과 비교하며 승인된 최종 렌더링에는 고충실도 구성을 쓰는 것이 실용적입니다.
참조를 늘리면 왜 일관성이 떨어질 수 있나요?
추가 참조는 해결할 관계를 늘립니다. 상충하는 얼굴, 의상, 환경, 스타일이 경쟁할 수 있습니다. 더 적고 정돈된 참조 묶음을 사용하고 대상에 명시적으로 배정하세요. 복잡한 샷에서 여러 정체성을 합치기 전에 캐릭터를 각각 확립하세요.
결론
MiniMax H3는 프롬프트 하나로 영상을 만드는 도구보다 멀티모달 제작 시스템으로 다룰 때 가장 유용합니다. Ref2VA는 캐릭터, 제품, 동작, 목소리, 장면을 재사용 맥락으로 만들고, 로컬 과정은 최적화된16GB부터 고급 GPU까지 확장됩니다. 새 LoRA 기술은 정체성을 외모에서 동작과 오디오로 넓힙니다. 연구의 공통 원칙은 참조를 먼저 정리하고, 저비용으로 탐색하고, 성공 결과를 보존하며, 창작 결정이 안정된 뒤 고품질 연산을 쓰는 것입니다. 개별 생성에서 지속적인 창작 맥락으로 옮겨가는 점이 팀에게 H3의 가치를 만듭니다.
Virse 블로그의 다른 글
워크플로

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026년 10월 9일 by Yifan Zhao
워크플로

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026년 10월 9일 by Yifan Zhao
워크플로

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026년 10월 9일 by Yifan Zhao