
MiniMax H3ガイド:キャラクターの一貫性、VRAM、LoRAと実践工程
 Yifan Zhao読了 9 分 ·
MiniMax H3は、テキスト、画像、動画、音声を扱う参照に基づく生成のためのオープンなマルチモーダル動画モデルです。デザイナーにとっての利点は画質だけではありません。Ref2VAは人物、商品、動き、声、環境を再利用可能な創作コンテキストに変えます。H3はネイティブ音声、最長15秒のクリップ、より高い解像度での再生成を、広いH3の制作工程の中で支えます。
課題は、良いH3出力には依然としてワークフローの設計が強く影響することです。ショット間でキャラクターが変わる、参照が競合する、高解像度でVRAMが不足するといった問題があります。ローカル制作にはComfyUI、アクセラレーター、LoRA、アップスケーラーも関わります。調査では、印象的なデモと再現可能な仕組みの違いは、多くの場合、体系的なH3プロンプト戦略で参照、反復、承認済み素材をどう整理するかにありました。
Virseはモデル、参照、創作作業を一つの視覚キャンバスにまとめ、この負担を減らします。 MiniMax H3、Seedance 2.0、Seedance 2.5を利用でき、有料プランではNano Banana 2やGPT Image 2など40以上のモデルを無制限で使え、席数も無制限です。新規ユーザーにはNano Banana 2画像最大10枚、またはSeedance 2.0動画1本分の無料クレジットが付与されます。Virseは生成を個別のチャットと見なすのではなく、視覚的文脈、複数エージェントの協力、再利用可能なプロジェクト知識を中心に設計されています。
MiniMax H3とは?マルチモーダル動画システムの仕組み
MiniMax H3は、単純なテキスト動画生成よりも、マルチモーダルな制作モデルと捉えると理解しやすくなります。参照を組み合わせ、人物の同一性、動き、構図、台詞、音を一つのプロンプトに詰め込まずに済みます。
工程は文脈の解釈、基礎生成、高解像度の再生成に分かれます。専門的な仕事には、どの顔がどの人物に属するか、どの声が話者に対応するか、何の動きに従うか、どの細部を変えないかという関係があるため、この構造が重要です。
MiniMax H3:FL2VAとRef2VA
主な二つのモードは異なる制作課題を解決します。
モード | 適した用途 | 参照の使い方 |
|---|---|---|
FL2VA | T2V、I2V、最初のフレームや最初・最後のフレームの制御 | 単純な構図とショットの制御 |
Ref2VA | キャラクター、商品、動き、場面、声 | 複数の画像・動画・音声参照 |
Ref2VAでは、最大9枚の画像に動画と音声を加え、対応制限内で最大12個の混合参照ファイルを使えます。利点は入力を増やすだけでなく、素材ごとに役割を与えられることです。
例えば、一組の画像で人物を、別の画像で服装を定義し、動画で動きを、音声で声や演技の文脈を示せます。
Ref2VAはキャラクターの一貫性をどう改善するか
Ref2VAは視覚的な同一性を再利用して一貫性を改善し、各ショットで文章から再構築する必要を減らします。ただし、調査では参照の最大数より品質が重要と示唆されています。
再利用できるキャラクター参照システムをつくる
有効な事例では、H3で制御された360度のキャラクター回転シーケンスを作り、有用なフレームを抜き出して後の生成に再利用しました。成功した動画を使い捨てず、繰り返し使える人物素材に変えます。
実用的な手順は次の通りです。
- 顔、髪型、体の比率、服装、重要な装飾品を固定する。
- 正面、横顔、斜め、全身の画像を準備する。
- 外見やスタイルが競合する参照を取り除く。
- 各ショットに必要な参照だけを使う。
- 成功した生成フレームを参照ライブラリに加える。
重要なのは、参照の量ではなく選別によって一貫性を保つことです。
複数人物で一貫性が崩れる理由
調査では、二人が同時に現れる、複数の顔参照が重なる、ショット間で環境が変わる場合に同一性の問題が増えました。
相互作用のショットを作る前に、それぞれの人物を個別に確立します。二組の参照を同時に入れる場合、説明文の追加より明確な役割分担が重要です。
ローカル生成に必要なVRAM量
最適化すれば一般向けGPUでも動きますが、実用的な反復速度は、モデルがVRAMに収まるかだけでは決まりません。
調査の実例は、その差が大きくなり得ることを示します。
GPUと工程 | 出力 | 報告結果 |
|---|---|---|
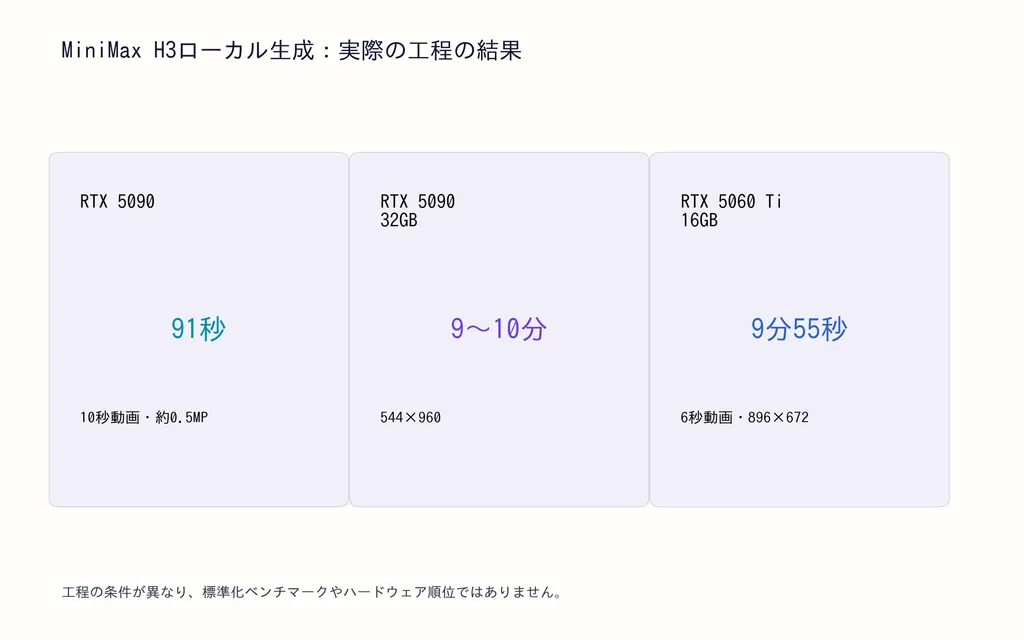
RTX 5090 | 10秒、約0.5MP | 91秒 |
RTX 5090 32GB | 544×960 | 9~10分 |
RTX 5060 Ti 16GB | 896×672、6秒、複数参照 | 9分55秒 |
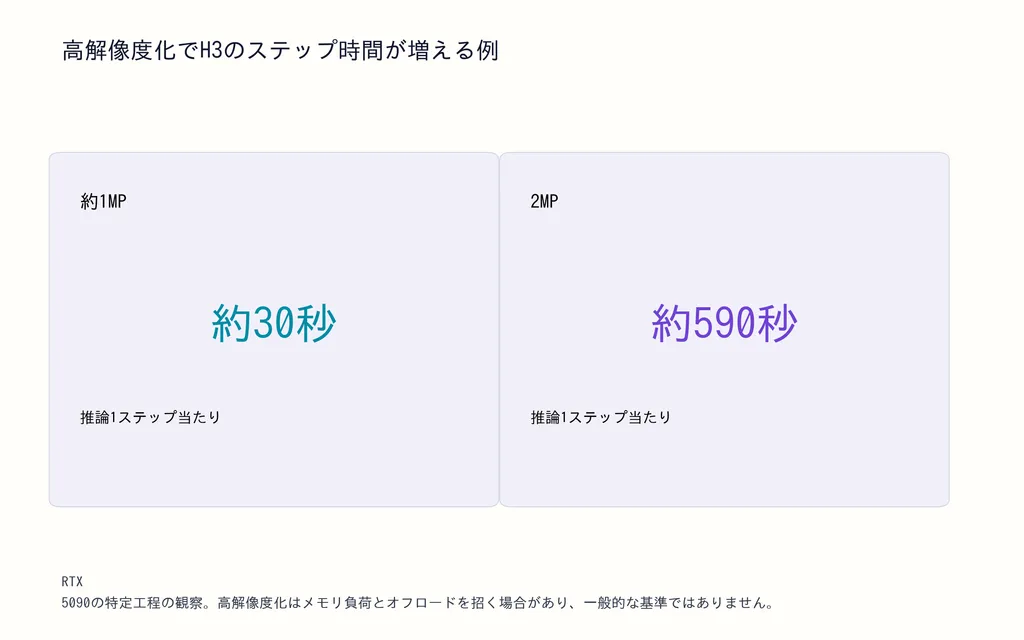
RTX 5090 32GB | 約1MPから2MPへ増加 | 1ステップ30秒から590秒へ |
これらは特定の工程での観察であり、標準化されたベンチマークではありません。一般的な性能保証には使えませんが、実際のボトルネックを示します。GPUメモリの余裕を超えると、オフロードやデータ移動が生成時間を支配することがあります。
高解像度でH3が大幅に遅くなる理由
5090で約2MPに近づけた際、1ステップが約30秒から590秒になった事例は、その危険を明確に示します。
チームにとっての簡単な原則は、初期の創作探索に高解像度レンダリングを組み込まないことです。動き、構図、参照を先に確かめ、承認したショットに計算資源を使います。
AI動画制作に適したH3の工程
実用的な工程は、創作文脈、安価な反復、最終レンダリング、仕上げを分けます。
生成前に参照を整理する
人物の同一性、服装、環境、商品、構図、動き、声、スタイルといった目的別に素材を分けます。失敗を診断しやすくし、矛盾する文脈を減らします。
未整理の参照が大量にあるフォルダは、強いプロンプトではありません。むしろ予測しにくくなる場合があります。
低コストで試作し、承認ショットを高解像度化する
ある工程はRTX 5090で544×960を約9~10分で生成し、LTX 2.3で1152×2048に拡大しました。
この設定に限らない教訓は、生成解像度と納品解像度を同じ段階で解決する必要はないことです。
被写体、動き、カメラ、音声でプロンプトを構成する
指示の役割が明確になると信頼性が上がります。誰や何が映るか、何をするか、カメラの動き、参照と被写体の対応、聞こえるべき音を定義します。
台詞があっても、画面の話者との対応が曖昧な失敗例がありました。人物と台詞を明示的に結びつけると制御しやすくなります。BGMが不要な場合も明記します。
単にプロンプトを長くするより効果的です。
加速は反復に使い、最終出力に自動適用しない
Spectrum、SageAttention、Sol Attention、Turbo LoRAなどは推論を短縮します。一方、強い加速で動き、人体構造、指示への忠実さ、インペインティングが弱くなる報告もありました。
より良い戦略は、探索には速い設定、納品には高忠実度の設定を使うことです。
MiniMax H3の実例から分かること
実際の工程は、機能一覧よりH3の強みをよく説明します。
事例1:10秒の動画を91秒で生成
ローカルRTX 5090の工程で、約0.5MPの10秒クリップを91秒で生成しました。
この速度なら、高性能なローカル機で創作中に参照やプロンプトを繰り返し試せます。ただし、1MPや2MPのレンダリングへ結果を外挿してはいけません。
事例2:16GB RTX 5060 TiでのRef2V
より制約のある工程では、16GB VRAMのRTX 5060 Tiで二人分の参照、二本の台詞音声、複数の推論最適化を使用しました。
結果は、896×672、6秒の動画を9分55秒で完成というものでした。
16GBでも有用な作業はできますが、反復コストが高いため、参照の準備を改善することが直接時間短縮につながります。
事例3:生成結果を再利用可能な人物素材に変える
別の工程ではゆっくり回転する人物を生成し、複数視点を抽出して後の生成に使いました。
重要なのは動画一本の改善ではなく、持続的なキャラクター参照システムを作ることです。専門チームにとって、生成素材を後の仕事の構造化入力にできる点が有用です。
Ref2VAではなくLoRAを学習すべきタイミング
既存の参照で十分に表現できるなら、まずRef2VAを使います。繰り返し使うスタイル、同一性、動き、声を参照だけで安定再現できない場合にLoRAを学習します。
画像と動画によるH3 LoRA学習コスト
調査した学習ベンチマークの一例は以下の結果でした。
学習入力 | VRAM | 1ステップの時間 |
|---|---|---|
画像、RTX PRO 4500 | 20.49GB | 0.72秒 |
動画、RTX PRO 4500 | 20.9GB | 3.01秒 |
画像、Tesla T4 | 12.7GB | 16.2秒 |
このテストのRTX PRO 4500では、動画学習のVRAMは画像学習と近い一方、1ステップの時間は約4倍でした。
実用的には、外見には可能な限り静止画を使い、動画学習は本当に学ぶ必要のある動きに限定するとよいでしょう。
H3 LoRAは外見、動き、声を組み合わせられる
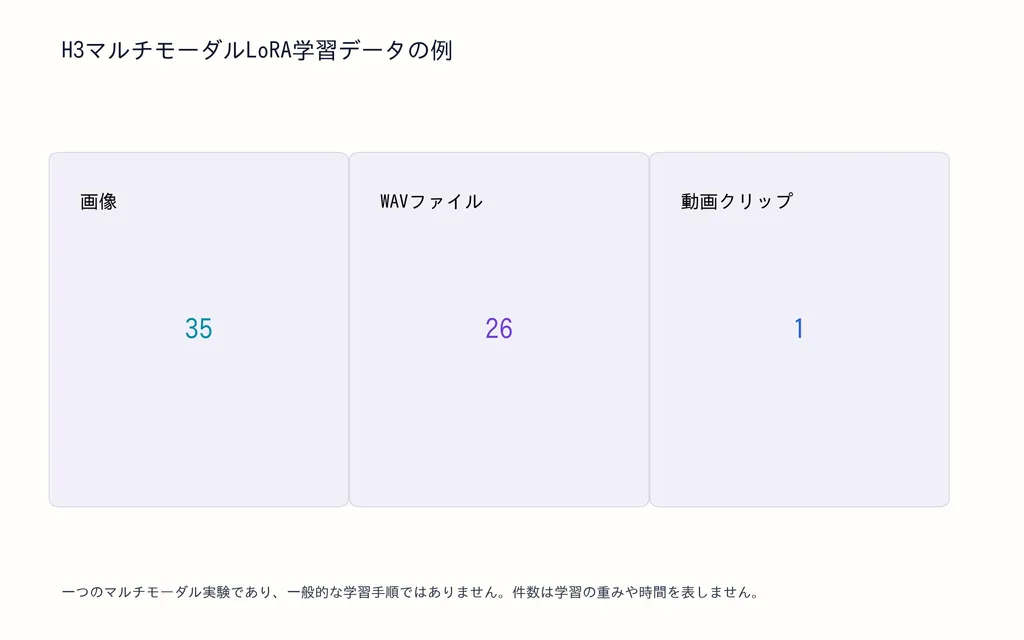
あるマルチモーダル実験では、35枚の画像、26個のWAVファイル、1本の動画を使用しました。40エポック後に音声のみの学習へ移り、声の特徴を強化しつつ視覚面のさらなる過学習を抑えました。
これは個別の実験であり、共通の処方箋ではありません。ただし、AIキャラクターを外見、声、動き、振る舞いの再利用可能な組み合わせにする方向を示します。
MiniMax H3の主な限界
主な限界は、基礎的な生成品質より制作の制御に移りつつあります。
繰り返し見られた問題は、複雑なComfyUI工程、複数人物の一貫性、高解像度の遅さ、加速と品質の交換条件、未成熟なLoRA学習、プロンプトへの敏感さの六つです。
次の段階に必要なのはモデル改善だけではありません。承認参照、人物間の関係、場面の文脈、履歴、再利用素材を保持する仕組みが必要です。Virseのような視覚ワークスペースでは、最新プロンプトだけでなく、モデルを取り巻くプロジェクトを理解するインターフェースが重要になります。
MiniMax H3のよくある質問
必要なVRAMは16GB、24GB、32GBのどれですか?
16GBでも最適化したH3工程を実行できますが、量子化、オフロード、長いレンダリングが必要な場合があります。調査には、16GB RTX 5060 Tiで896×672、6秒、複数参照を9分55秒で完成した例があります。多いVRAMは柔軟性を高めますが、解像度が余裕を超えると32GBでも大幅に遅くなり得ます。
人物の一貫性にはRef2VAとLoRAのどちらが適しますか?
良い参照があるなら、まずRef2VAです。反復が速く、学習費用を避けられます。多数の生成で同一性、動き、スタイル、声を繰り返し再現できない場合はLoRAを使います。多くの案件では、選別した多角度参照の方が即座にアダプターを学習するより経済的です。
Turboなどの加速で品質が下がる理由は?
加速は推論を変え、強い設定は忠実度を速度と交換する場合があります。動き、人体構造、指示への忠実さ、インペインティングが劣化対象になりました。速い設定で試し、遅い基準と比較し、承認済み最終出力には高忠実度設定を使うのが実用的です。
参照を増やすと一貫性が下がる理由は?
増えた参照は解くべき関係を増やします。矛盾する顔、服、環境、スタイルが競合します。少数の整理された参照グループを使い、被写体への対応を明示し、個々の人物を確立してから複雑なショットで組み合わせます。
まとめ
MiniMax H3は、一つのプロンプトで動画を作る道具より、マルチモーダルな制作システムとして扱うと有用です。Ref2VAは人物、商品、動き、声、場面を再利用可能な文脈に変え、ローカル工程は最適化した16GBから高性能GPUまで対応します。新しいLoRA手法は同一性を動きや音にも拡張します。調査の共通原則は、参照を先に整理し、安価に試し、成功出力を保存し、創作判断が固まってから高品質の計算資源を使うことです。孤立した生成から持続的な創作文脈への移行が、チームにとってのH3の価値を生みます。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao