
Guia do MiniMax H3: consistência de personagens, VRAM, LoRA e fluxos reais
 Yifan Zhao10 min de leitura ·
MiniMax H3 é um modelo aberto de vídeo multimodal feito para geração guiada por referências de texto, imagens, vídeo e áudio. Para designers, a vantagem vai além da qualidade: Ref2VA transforma personagens, produtos, movimentos, vozes e ambientes em contexto criativo reutilizável. H3 oferece áudio nativo, clipes de até 15 segundos e regeneração em maior resolução dentro de um fluxo de produção H3 mais amplo.
O problema é que bons resultados com H3 ainda dependem muito do planejamento do fluxo de trabalho. Personagens podem mudar entre planos, referências podem entrar em conflito e altas resoluções esgotar a VRAM. A produção local costuma envolver ComfyUI, aceleradores, LoRAs e ampliadores. Na revisão, a diferença entre uma demonstração impressionante e um sistema repetível geralmente vinha da organização de referências, iterações e ativos aprovados por uma estratégia disciplinada de prompts para H3.
Virse reduz esse esforço reunindo modelos, referências e tarefas criativas em uma tela visual. MiniMax H3, Seedance 2.0 e Seedance 2.5 estão disponíveis no Virse. Os planos pagos incluem uso ilimitado de mais de 40 modelos, como Nano Banana 2 e GPT Image 2, além de assentos ilimitados. Novos usuários recebem créditos gratuitos para até 10 imagens Nano Banana 2 ou um vídeo Seedance 2.0. Virse prioriza contexto visual, colaboração entre agentes e conhecimento reutilizável do projeto, em vez de tratar cada geração como uma conversa isolada.
O que é MiniMax H3 e como funciona seu sistema multimodal?
MiniMax H3 é melhor entendido como um modelo de produção multimodal do que como um gerador básico de texto para vídeo. Combina diferentes referências para não comprimir identidade, movimento, composição, diálogo e som em um único prompt.
O fluxo separa interpretação do contexto, geração-base e regeneração em maior resolução. Isso importa profissionalmente porque um projeto contém relações: qual rosto pertence a cada personagem, qual voz pertence ao falante, qual movimento seguir e quais detalhes devem permanecer intactos.
MiniMax H3: FL2VA versus Ref2VA
Os dois modos principais resolvem problemas de produção diferentes.
Modo | Melhor aplicação | Estratégia de referências |
|---|---|---|
FL2VA | T2V, I2V, controle do primeiro quadro ou do primeiro e último | Enquadramento e controle de plano simples |
Ref2VA | Personagens, produtos, movimento, cenas, vozes | Múltiplas referências de imagem, vídeo e áudio |
Ref2VA aceita fluxos com até nove imagens mais referências de vídeo e áudio, chegando a 12 arquivos mistos dentro dos limites suportados. A vantagem não é apenas adicionar entradas, mas atribuir funções diferentes aos recursos criativos.
Por exemplo, um conjunto de imagens define o personagem, outro a roupa; um vídeo fornece movimento e o áudio oferece voz ou contexto de interpretação.
Como Ref2VA melhora a consistência dos personagens?
Ref2VA melhora a consistência dos personagens permitindo reutilizar a identidade visual em vez de reconstruí-la por texto em cada plano. Porém, a pesquisa indica que a qualidade das referências importa mais que maximizar sua quantidade.
Crie um sistema reutilizável de referências de personagem
Um dos fluxos mais sólidos criou com H3 uma sequência controlada de rotação de 360 graus, extraiu quadros úteis e reutilizou as vistas nas próximas gerações. Um vídeo bem-sucedido vira um recurso reutilizável, não um resultado descartável.
Um fluxo prático é:
- Fixar rosto, cabelo, proporções corporais, roupa e acessórios principais.
- Preparar vistas frontal, de perfil, de três quartos e de corpo inteiro.
- Remover referências com aparência ou estilo conflitantes.
- Usar somente as referências relevantes para cada plano.
- Incorporar os quadros bem-sucedidos à biblioteca de referências.
O princípio central é consistência por curadoria, não por volume de referências.
Por que vários personagens ainda podem perder consistência
Problemas de identidade ficam mais comuns quando dois personagens aparecem juntos, referências faciais se sobrepõem ou os ambientes mudam entre planos.
Estabeleça cada personagem separadamente antes de criar interações. Ao introduzir dois conjuntos de referências ao mesmo tempo, atribuir papéis claros importa mais que acrescentar texto descritivo.
Quanta VRAM MiniMax H3 precisa para geração local?
H3 pode rodar em GPUs de consumo com fluxos otimizados, mas a velocidade útil de iteração depende de muito mais que o modelo caber na VRAM.
Os resultados reais da pesquisa mostram a amplitude dessa variação.
GPU e fluxo | Saída | Resultado relatado |
|---|---|---|
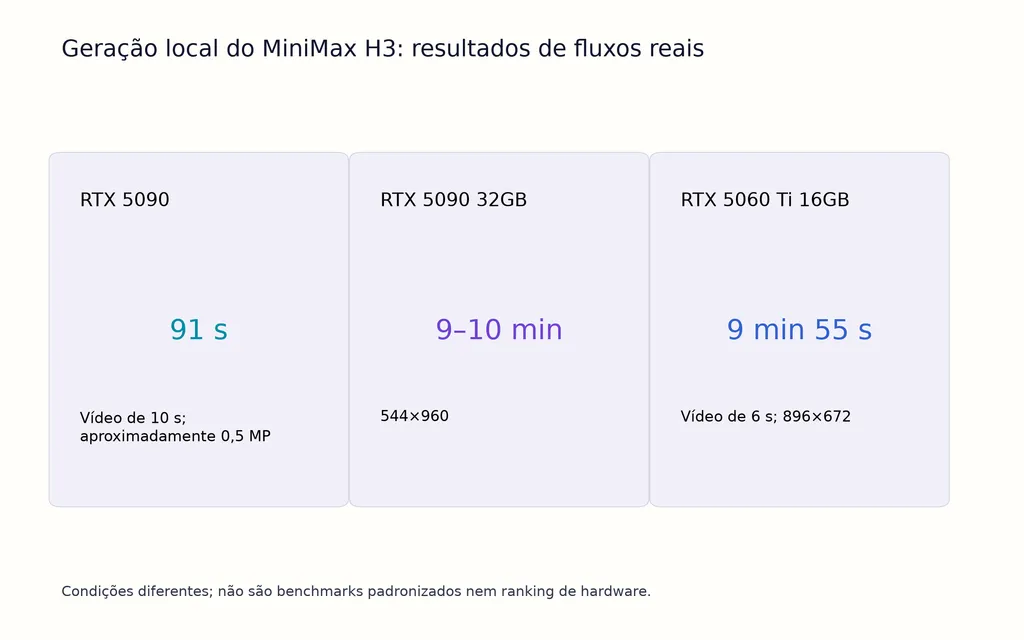
RTX 5090 | 10 s, cerca de 0,5 MP | 91 s |
RTX 5090 de 32 GB | 544×960 | 9–10 min |
RTX 5060 Ti de 16 GB | 896×672, 6 s, múltiplas referências | 9 min 55 s |
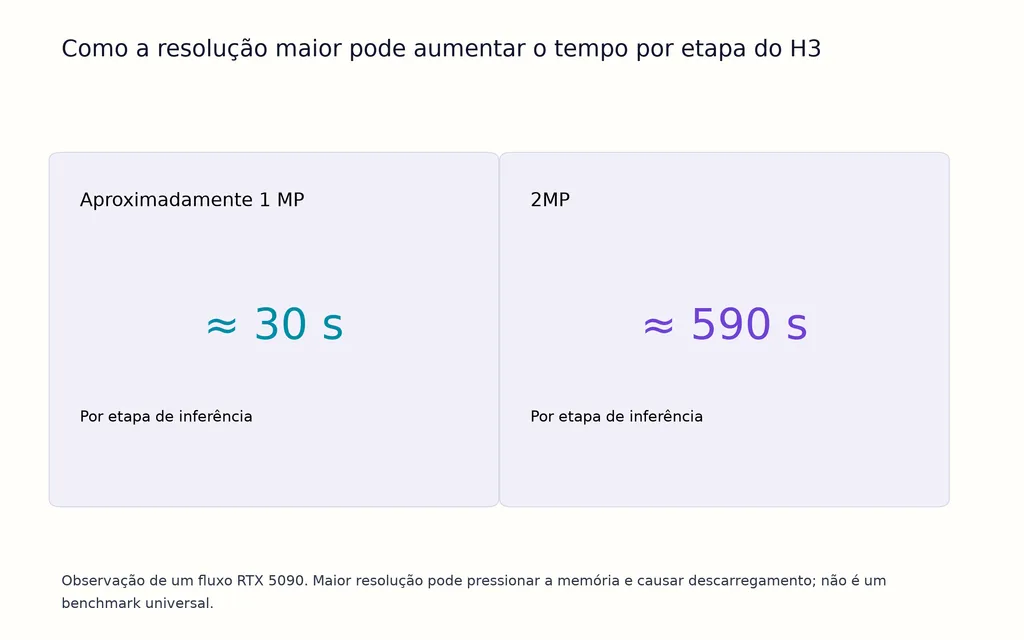
RTX 5090 de 32 GB | Aumento de cerca de 1 MP para 2 MP | De 30 s/etapa para 590 s/etapa |
São observações de fluxos específicos, não benchmarks padronizados, portanto não garantem desempenho universal. Ainda assim, revelam o gargalo: quando o fluxo excede a margem confortável da memória da GPU, descarregamento e movimentação de dados podem dominar o tempo.
Por que resoluções maiores podem desacelerar H3 drasticamente
O caso da 5090 em que o tempo por etapa passou de aproximadamente 30 para 590 segundos ao se aproximar de 2 MP ilustra bem o risco.
Para equipes criativas, a regra é simples: não inclua renderização em alta resolução na exploração inicial. Valide movimento, composição e referências antes de gastar computação nos planos aprovados.
Qual fluxo de MiniMax H3 usar na produção de vídeo com IA?
Um fluxo prático separa contexto criativo, iteração econômica, renderização final e acabamento.
Organize referências antes de gerar
Separe recursos por finalidade: identidade, roupas, ambiente, produto, composição, movimento, voz e estilo. Isso facilita diagnosticar falhas e reduz contextos contraditórios.
Uma pasta grande de referências desorganizadas não é um prompt mais forte; costuma ser menos previsível.
Prototipe com menor custo e amplie os planos aprovados
Um fluxo gerava em 544×960 em cerca de 9–10 minutos numa RTX 5090 e depois usava LTX 2.3 para ampliar a saída para 1152×2048.
A lição mais ampla é que resolução de geração e resolução de entrega nem sempre precisam ser resolvidas na mesma etapa.
Estruture prompts por sujeito, movimento, câmera e áudio
Prompts ficam mais confiáveis quando cada instrução tem função clara. Defina quem ou o que está no plano, o que faz, como a câmera se comporta, qual referência corresponde a cada sujeito e o que deve ser ouvido.
Revisamos falhas em que havia diálogo sem associação clara com o falante visível. Relacionar personagens e falas explicitamente melhora o controle. Se a cena não deve ter trilha de fundo, isso também precisa ser declarado.
É mais eficaz que simplesmente alongar o prompt.
Use aceleradores para iterar, não automaticamente para a saída final
Spectrum, SageAttention, Sol Attention, Turbo LoRA e otimizações semelhantes reduzem a inferência. Mas a revisão encontrou relatos de pior movimento, anatomia, adesão ao prompt ou inpainting sob aceleração agressiva.
Uma estratégia melhor usa configurações rápidas na exploração e de maior fidelidade na entrega.
Casos de MiniMax H3: o que fluxos reais revelam
Fluxos reais explicam os pontos fortes de H3 melhor que listas de recursos.
Caso 1: vídeo de 10 segundos em 91 segundos
Um fluxo local com RTX 5090 gerou um clipe de 10 segundos em cerca de 0,5 MP em 91 segundos.
Nessa velocidade, uma estação local de alto desempenho permite várias iterações de prompts e referências durante uma sessão criativa. Mas esse resultado não deve ser extrapolado para renderizações de 1 ou 2 MP.
Caso 2: Ref2V em uma RTX 5060 Ti de 16 GB
Um fluxo mais limitado usou duas referências de personagens, duas faixas de diálogo e várias otimizações de inferência numa RTX 5060 Ti com 16 GB de VRAM.
O resultado foi 896×672, seis segundos, concluído em 9 minutos e 55 segundos.
Isso mostra que 16 GB permitem trabalho útil com H3, mas a iteração custa o bastante para que referências mais bem preparadas economizem tempo diretamente.
Caso 3: transformar uma saída de H3 em recurso reutilizável de personagem
Outro fluxo produziu uma rotação lenta, extraiu vários ângulos e usou esses quadros nas gerações seguintes.
O resultado importante não é um vídeo melhor, mas um sistema persistente de referências de personagem. Isso é valioso para equipes profissionais porque recursos gerados viram entradas estruturadas para trabalhos posteriores.
Quando treinar uma LoRA em vez de usar Ref2VA?
Comece com Ref2VA quando as referências já descrevem bem o sujeito. Treine uma LoRA quando estilo, identidade, movimento ou voz recorrentes não puderem ser reproduzidos de forma confiável só com referências.
Custo de treinamento LoRA H3: imagens versus vídeo
Um benchmark de treinamento da pesquisa apresentou os resultados abaixo.
Entrada de treinamento | VRAM | Tempo por etapa |
|---|---|---|
Imagens, RTX PRO 4500 | 20,49 GB | 0,72 s |
Vídeo, RTX PRO 4500 | 20,9 GB | 3,01 s |
Imagens, Tesla T4 | 12,7 GB | 16,2 s |
Nesse teste, o vídeo usou VRAM semelhante, mas levou cerca de quatro vezes mais tempo por etapa que imagens na RTX PRO 4500.
Uma conclusão prática é usar imagens estáticas para aparência quando possível e reservar vídeo para movimentos que realmente precisam ser aprendidos.
LoRA H3 pode combinar aparência, movimento e voz
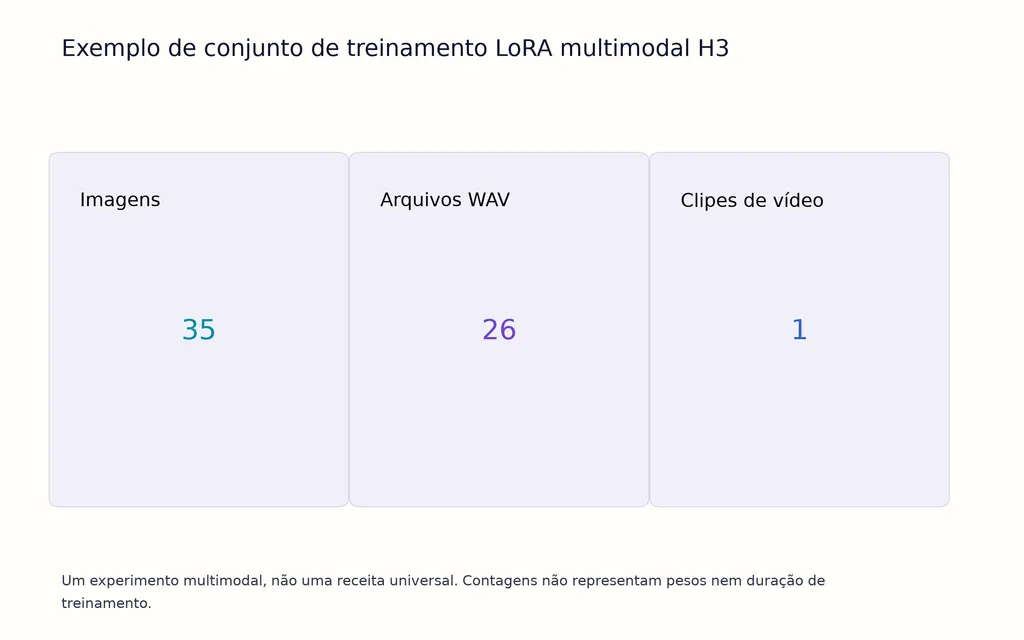
Um experimento multimodal utilizou 35 imagens, 26 arquivos WAV e um clipe de vídeo. Após a época 40, o fluxo passou a priorizar treinamento apenas de áudio para reforçar características da voz e limitar sobreajuste visual adicional.
É um experimento individual, não uma receita universal. Mas aponta uma direção importante: personagens de IA podem combinar de forma reutilizável aparência, voz, movimento e comportamento.
Quais são as maiores limitações de MiniMax H3?
As limitações se concentram cada vez mais em controle de produção, não na qualidade básica de geração.
Seis problemas apareceram repetidamente: fluxos ComfyUI complexos, consistência entre personagens, geração lenta em alta resolução, trocas de qualidade dos aceleradores, treinamento LoRA imaturo e sensibilidade ao prompt.
O próximo passo não é apenas um modelo melhor. Designers precisam preservar referências aprovadas, relações entre personagens, contexto de cena, histórico e recursos reutilizáveis. É onde espaços visuais como Virse se tornam relevantes: a interface deve entender o projeto em torno do modelo, não apenas o último prompt.
Perguntas frequentes sobre MiniMax H3
H3 precisa de 16, 24 ou 32 GB de VRAM?
16 GB permitem executar fluxos H3 otimizados, mas podem exigir quantização, descarregamento ou renderizações mais longas. Revisamos uma RTX 5060 Ti de 16 GB que concluiu seis segundos em 896×672 com várias referências em 9:55. Mais VRAM aumenta a flexibilidade, porém até 32 GB podem desacelerar muito quando a resolução excede a margem confortável de memória.
Ref2VA ou LoRA para consistência de personagens?
Comece com Ref2VA quando houver boas referências: a iteração é mais rápida e dispensa treinamento. Use LoRA quando referências falham repetidamente em reproduzir identidade, movimento, estilo ou voz ao longo de muitas gerações. Em vários projetos, selecionar referências de múltiplos ângulos custa menos que treinar um adaptador imediatamente.
Por que Turbo e outros aceleradores podem reduzir a qualidade?
A aceleração muda a inferência, e ajustes agressivos podem trocar fidelidade por velocidade. Movimento, anatomia, adesão ao prompt e inpainting foram aspectos sujeitos a degradação. É útil experimentar com ajustes rápidos, comparar com uma base mais lenta e reservar maior fidelidade para renderizações finais aprovadas.
Por que adicionar referências pode reduzir a consistência?
Mais referências introduzem mais relações a resolver. Rostos, roupas, ambientes ou estilos contraditórios podem competir. Use grupos de referências menores e mais limpos, associe-os explicitamente aos sujeitos e estabeleça cada personagem antes de combinar identidades num plano complexo.
Conclusão
MiniMax H3 é mais útil como sistema de produção multimodal do que como gerador de vídeo de um único prompt. Ref2VA transforma personagens, produtos, movimento, vozes e cenas em contexto reutilizável; fluxos locais vão de configurações otimizadas de 16 GB a GPUs de ponta; técnicas LoRA emergentes estendem identidade para movimento e áudio. A pesquisa aponta o mesmo princípio: organize referências primeiro, explore com baixo custo, preserve os resultados bem-sucedidos e invista em computação de alta qualidade quando as decisões criativas estiverem estáveis. Para equipes, a passagem de gerações isoladas para contexto criativo persistente torna H3 especialmente valioso.
Mais do blogue da Virse
Fluxo de trabalho

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 de outubro de 2026 by Yifan Zhao
Fluxo de trabalho

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 de outubro de 2026 by Yifan Zhao