
Guide MiniMax H3 : cohérence des personnages, VRAM, LoRA et workflows réels
 Yifan Zhao10 min de lecture ·
MiniMax H3 est un modèle vidéo multimodal ouvert conçu pour la génération guidée par références textuelles, visuelles, vidéo et audio. Pour les designers, son avantage dépasse la qualité : Ref2VA transforme personnages, produits, mouvements, voix et environnements en contexte créatif réutilisable. H3 prend en charge l’audio natif, des clips jusqu’à 15 secondes et la régénération en résolution supérieure dans un workflow de production H3 plus large.
Le problème est qu’un bon résultat avec H3 dépend encore fortement de la conception du workflow. Les personnages peuvent changer entre les plans, les références se contredire et les hautes résolutions saturer la VRAM. La production locale implique souvent ComfyUI, accélérateurs, LoRA et outils d’agrandissement. Notre revue montre que la différence entre une démonstration impressionnante et un système reproductible tient souvent à l’organisation des références, itérations et ressources validées par une stratégie rigoureuse de prompts H3.
Virse réduit cette charge en réunissant modèles, références et tâches créatives sur un canevas visuel. MiniMax H3, Seedance 2.0 et Seedance 2.5 y sont disponibles. Les offres payantes incluent l’usage illimité de plus de 40 modèles, dont Nano Banana 2 et GPT Image 2, avec des places illimitées. Les nouveaux utilisateurs reçoivent des crédits gratuits pour jusqu’à 10 images Nano Banana 2 ou une vidéo Seedance 2.0. Virse privilégie contexte visuel, collaboration multi-agents et connaissances réutilisables du projet, plutôt que des générations traitées comme des conversations isolées.
Qu’est-ce que MiniMax H3 et comment fonctionne son système multimodal ?
MiniMax H3 est davantage un modèle de production multimodale qu’un simple générateur texte-vers-vidéo. Il combine plusieurs références pour ne pas devoir condenser identité, mouvement, composition, dialogue et son dans une seule consigne.
Le workflow sépare interprétation du contexte, génération de base et régénération en résolution supérieure. C’est important en production professionnelle, car un projet comprend des relations : quel visage appartient à quel personnage, quelle voix correspond au locuteur, quel mouvement suivre et quels détails préserver.
MiniMax H3 : FL2VA ou Ref2VA
Les deux modes principaux répondent à des problèmes différents.
Mode | Usage privilégié | Stratégie de références |
|---|---|---|
FL2VA | T2V, I2V, contrôle de la première image ou des première et dernière images | Cadrage et contrôle de plan simples |
Ref2VA | Personnages, produits, mouvement, scènes, voix | Plusieurs références image, vidéo et audio |
Ref2VA accepte des workflows avec jusqu’à neuf images, plus des références vidéo et audio, pour un maximum de 12 fichiers mixtes dans les limites prises en charge. L’intérêt n’est pas seulement d’ajouter des entrées, mais d’attribuer des rôles différents aux ressources.
Par exemple, un ensemble d’images définit un personnage, un autre ses vêtements, une vidéo fournit le mouvement et l’audio apporte une voix ou un contexte d’interprétation.
Comment Ref2VA améliore-t-il la cohérence des personnages ?
Ref2VA améliore la cohérence des personnages en réutilisant leur identité visuelle plutôt qu’en la reconstruisant par texte à chaque plan. Notre recherche suggère néanmoins que la qualité des références compte davantage que leur quantité maximale.
Construire un système réutilisable de références de personnage
Un workflow particulièrement solide créait avec H3 une séquence contrôlée de rotation à 360 degrés, puis extrayait des images utiles pour les générations suivantes. Une vidéo réussie devient ainsi une ressource réutilisable, plutôt qu’un résultat jetable.
Un workflow pratique consiste à :
- Fixer visage, coiffure, proportions, tenue et accessoires essentiels.
- Préparer des vues de face, de profil, de trois quarts et en pied.
- Écarter les références aux apparences ou styles contradictoires.
- Utiliser uniquement les références pertinentes pour chaque plan.
- Intégrer les images générées réussies à la bibliothèque du projet.
Le principe clé est la cohérence par sélection, non par volume de références.
Pourquoi plusieurs personnages peuvent encore perdre leur cohérence
Les problèmes d’identité deviennent plus fréquents lorsque deux personnages apparaissent ensemble, plusieurs références faciales se chevauchent ou les environnements changent entre plans.
Mieux vaut établir chaque personnage séparément avant les interactions. Quand deux groupes de références sont introduits ensemble, une attribution claire des rôles importe plus que des descriptions supplémentaires.
Combien de VRAM faut-il pour générer localement avec H3 ?
H3 fonctionne sur des GPU grand public avec des workflows optimisés, mais une vitesse d’itération utile dépend de bien plus que de la capacité du modèle à tenir en VRAM.
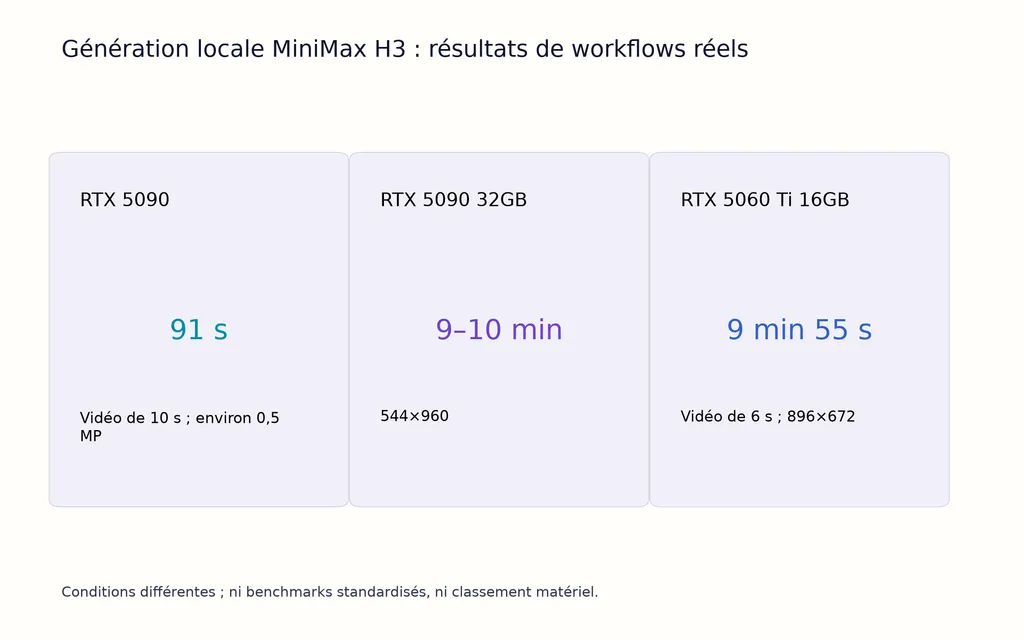
Les résultats réels examinés montrent l’ampleur des écarts possibles.
GPU et workflow | Sortie | Résultat rapporté |
|---|---|---|
RTX 5090 | 10 s, environ 0,5 MP | 91 s |
RTX 5090 32 Go | 544×960 | 9–10 min |
RTX 5060 Ti 16 Go | 896×672, 6 s, plusieurs références | 9 min 55 s |
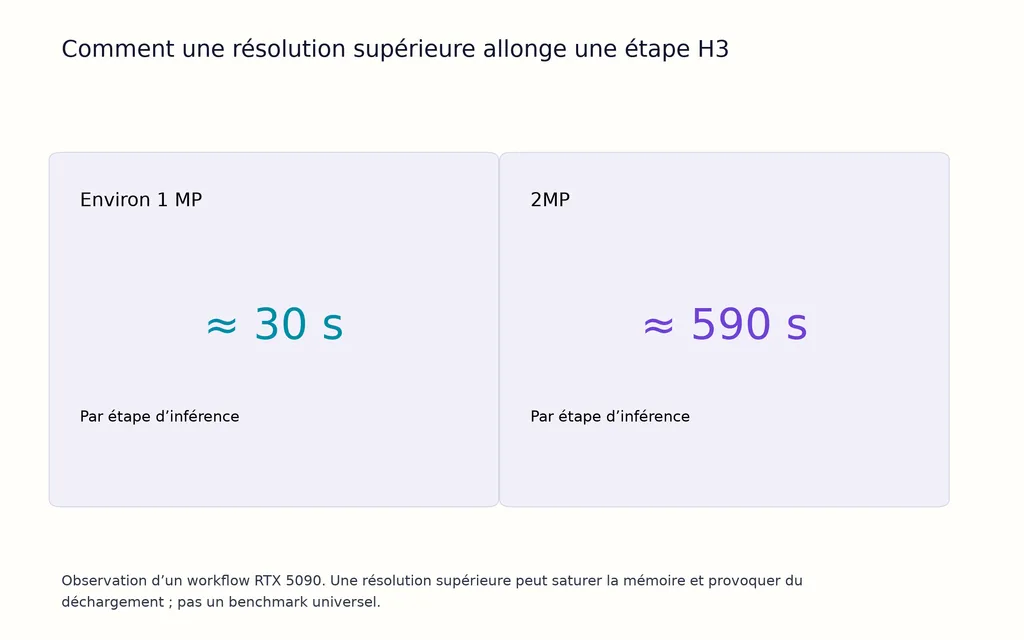
RTX 5090 32 Go | Passage d’environ 1 MP à 2 MP | De 30 s/étape à 590 s/étape |
Ce sont des observations propres à des workflows, pas des benchmarks standardisés, donc pas des garanties universelles. Elles révèlent néanmoins le goulet d’étranglement : au-delà d’une marge mémoire confortable, le déchargement et les transferts peuvent dominer le temps de génération.
Pourquoi la haute résolution peut fortement ralentir H3
Le cas de la 5090, où le temps par étape passe d’environ 30 à 590 secondes en approchant 2 MP, illustre clairement ce risque.
Pour une équipe créative, la règle est simple : ne pas intégrer le rendu haute résolution à l’exploration initiale. Valider mouvement, composition et références avant de consacrer le calcul aux plans approuvés.
Quel workflow H3 adopter pour produire des vidéos avec l’IA ?
Un workflow pratique sépare contexte créatif, itération économique, rendu final et finition.
Organiser les références avant de générer
Séparer les ressources par rôle : identité, vêtements, environnement, produit, composition, mouvement, voix et style. Cela facilite le diagnostic des échecs et réduit les contradictions.
Un gros dossier de références non triées ne constitue pas une meilleure consigne ; il rend souvent le résultat moins prévisible.
Prototyper à moindre coût, puis agrandir les plans validés
Un workflow générait en 544×960 en environ 9–10 minutes sur RTX 5090, puis utilisait LTX 2.3 pour passer à 1152×2048.
Au-delà de cette configuration, la leçon est que résolution de génération et résolution de livraison ne doivent pas toujours être résolues dans la même étape.
Structurer les prompts autour du sujet, du mouvement, de la caméra et du son
Chaque instruction devient plus fiable avec un rôle clair. Définir qui ou quoi apparaît, l’action, le comportement de la caméra, les références attribuées à chaque sujet et ce qui doit être entendu.
Nous avons observé des dialogues sans association claire au locuteur visible. Relier explicitement personnages et répliques améliore le contrôle. L’absence souhaitée de musique de fond doit également être précisée.
C’est plus efficace que d’allonger simplement la consigne.
Employer les accélérateurs pour itérer, pas automatiquement pour livrer
Spectrum, SageAttention, Sol Attention, Turbo LoRA et d’autres optimisations réduisent le temps d’inférence. Mais la revue relève aussi des dégradations du mouvement, de l’anatomie, du respect des consignes ou de l’inpainting avec une accélération agressive.
Une meilleure stratégie associe réglages rapides pour explorer et réglages plus fidèles pour livrer.
Cas MiniMax H3 : les enseignements des workflows réels
Les workflows réels expliquent mieux les atouts de H3 qu’une liste de fonctions.
Cas 1 : une vidéo de 10 secondes en 91 secondes
Un workflow local sur RTX 5090 produit un clip de 10 secondes à environ 0,5 MP en 91 secondes.
À cette vitesse, une station haut de gamme permet de multiples itérations sur les prompts et références pendant une séance créative. Mais ce résultat ne doit pas être extrapolé aux rendus 1 ou 2 MP.
Cas 2 : Ref2V sur RTX 5060 Ti 16 Go
Un workflow plus contraint utilise deux références de personnages, deux pistes de dialogue et plusieurs optimisations d’inférence sur RTX 5060 Ti avec 16 Go de VRAM.
Le résultat est 896×672, six secondes, terminé en 9 minutes 55 secondes.
Le matériel 16 Go permet donc un travail utile, mais l’itération coûte assez cher pour qu’une meilleure préparation des références fasse directement gagner du temps.
Cas 3 : transformer une sortie H3 en ressource de personnage réutilisable
Un autre workflow crée une rotation lente, extrait plusieurs angles et les réutilise dans les générations suivantes.
Le résultat important n’est pas une seule meilleure vidéo, mais un système persistant de références de personnage. Pour les équipes professionnelles, les ressources générées deviennent des entrées structurées pour les travaux futurs.
Quand entraîner une LoRA plutôt qu’utiliser Ref2VA ?
Commencer par Ref2VA lorsque les références décrivent déjà bien le sujet. Entraîner une LoRA lorsqu’un style, une identité, un mouvement ou une voix récurrents ne peuvent pas être reproduits fiablement par références seules.
Coût d’entraînement LoRA H3 : images ou vidéo
Un benchmark d’entraînement étudié donne les résultats suivants.
Entrée d’entraînement | VRAM | Temps par étape |
|---|---|---|
Images, RTX PRO 4500 | 20,49 Go | 0,72 s |
Vidéo, RTX PRO 4500 | 20,9 Go | 3,01 s |
Images, Tesla T4 | 12,7 Go | 16,2 s |
Dans ce test sur RTX PRO 4500, la vidéo consomme une VRAM similaire, mais prend environ quatre fois plus de temps par étape que les images.
La conclusion pratique est d’utiliser si possible des images fixes pour l’apparence et de réserver la vidéo aux mouvements qui nécessitent réellement un apprentissage.
La LoRA H3 peut combiner apparence, mouvement et voix
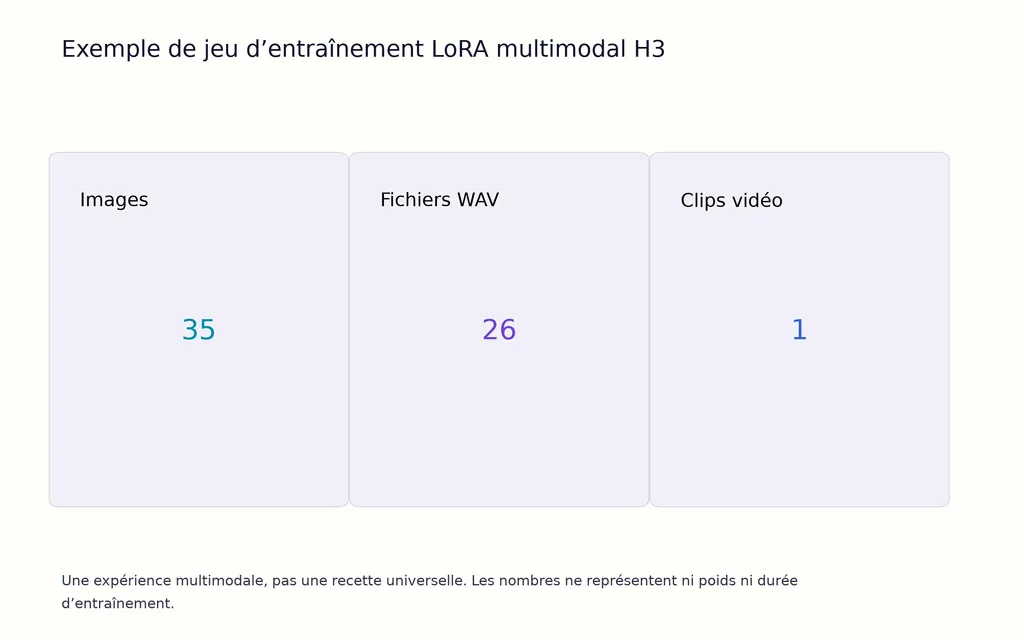
Une expérience multimodale utilisait 35 images, 26 fichiers WAV et un clip vidéo. Après l’époque 40, le workflow s’est orienté vers un entraînement audio seul pour renforcer la voix tout en limitant le surapprentissage visuel supplémentaire.
C’est une expérience individuelle, pas une recette universelle. Elle indique néanmoins une direction importante : un personnage IA peut devenir une combinaison réutilisable d’apparence, de voix, de mouvement et de comportement.
Quelles sont les principales limites de MiniMax H3 ?
Les limites concernent de plus en plus le contrôle de production plutôt que la qualité de génération de base.
Six problèmes reviennent : workflows ComfyUI complexes, cohérence multi-personnages, lenteur haute résolution, compromis qualité des accélérateurs, entraînement LoRA immature et sensibilité aux consignes.
La prochaine étape ne consiste donc pas seulement à améliorer le modèle. Il faut préserver références validées, relations entre personnages, contexte de scène, historique et ressources réutilisables. C’est le rôle pertinent d’espaces visuels comme Virse : comprendre le projet autour du modèle, pas seulement le dernier prompt.
Questions fréquentes sur MiniMax H3
H3 exige-t-il 16, 24 ou 32 Go de VRAM ?
16 Go permettent des workflows H3 optimisés, mais peuvent nécessiter quantification, déchargement ou rendus plus longs. Nous avons étudié une RTX 5060 Ti 16 Go produisant six secondes en 896×672 avec plusieurs références en 9:55. Davantage de VRAM apporte de la souplesse, mais même 32 Go peuvent ralentir fortement si la résolution dépasse la marge mémoire confortable.
Ref2VA ou LoRA pour la cohérence des personnages ?
Commencer par Ref2VA avec de bonnes références : l’itération est plus rapide et sans coût d’entraînement. Employer une LoRA quand les références échouent régulièrement à reproduire identité, mouvement, style ou voix au fil des générations. Pour beaucoup de projets, des références multi-angles sélectionnées coûtent moins cher qu’un adaptateur entraîné immédiatement.
Pourquoi Turbo et d’autres accélérateurs peuvent-ils réduire la qualité ?
L’accélération modifie l’inférence et les réglages agressifs peuvent échanger fidélité contre vitesse. Mouvement, anatomie, respect des consignes et inpainting figurent parmi les aspects dégradables. Il est utile d’expérimenter rapidement, de comparer à une base plus lente et de réserver la fidélité supérieure aux rendus finaux validés.
Pourquoi davantage de références peut-il réduire la cohérence ?
Chaque référence ajoute des relations à résoudre. Visages, vêtements, environnements et styles contradictoires peuvent rivaliser. Utiliser des groupes de références moins nombreux et plus propres, les attribuer explicitement aux sujets et établir chaque personnage avant de combiner plusieurs identités dans un plan complexe.
Conclusion
MiniMax H3 est le plus utile comme système de production multimodale plutôt que générateur vidéo à consigne unique. Ref2VA transforme personnages, produits, mouvements, voix et scènes en contexte réutilisable ; les workflows locaux vont de configurations 16 Go optimisées aux GPU haut de gamme ; les techniques LoRA étendent l’identité au mouvement et à l’audio. La recherche souligne le même principe : organiser d’abord les références, explorer à faible coût, conserver les résultats réussis et investir dans le calcul de haute qualité une fois les décisions créatives stabilisées. Pour les équipes, ce passage de générations isolées à un contexte persistant fait la valeur particulière de H3.
Plus d’articles du blog Virse
Flux de travail

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
9 octobre 2026 by Yifan Zhao
Flux de travail

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
9 octobre 2026 by Yifan Zhao
Flux de travail

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
9 octobre 2026 by Yifan Zhao