
Six niveaux de qualité
low, medium, high, xhigh, max et auto. Les deux niveaux supérieurs sont nouveaux dans la version 2.5.
ChatGPT Images 2.5 d’OpenAI arrive dans Virse avec ses deux éditions API, GPT Image 2.5 Flare et GPT Image 2.5 Sunburst, six niveaux de qualité et une sortie jusqu’à 4K.
Ouvrez cette page sur un navigateur de bureau pour commencer à créer.
ChatGPT Images 2.5 a été lancé le 8 septembre 2026 sous la forme de deux modèles plutôt qu’un seul, et la différence entre eux tient au temps.
GPT Image 2.5 Flare est le plus rapide, qu’OpenAI décrit comme le choix par défaut pour la plupart des applications. GPT Image 2.5 Sunburst prend plus de temps par image et est conçu pour les travaux où la précision des retouches compte le plus. Sur la plupart des plateformes, ce choix est aussi un choix budgétaire, et l’édition précise devient discrètement celle que vous réservez au rendu final.
Dans Virse, les deux figurent dans le même menu de modèles et coûtent le même nombre de crédits à chaque niveau de qualité, depuis 1K Low jusqu’à 4K Max. Préparez vos brouillons sur Flare parce qu’il répond plus vite, passez à Sunburst lorsque l’image doit résister à un examen attentif, et laissez le travail décider plutôt que la facture.
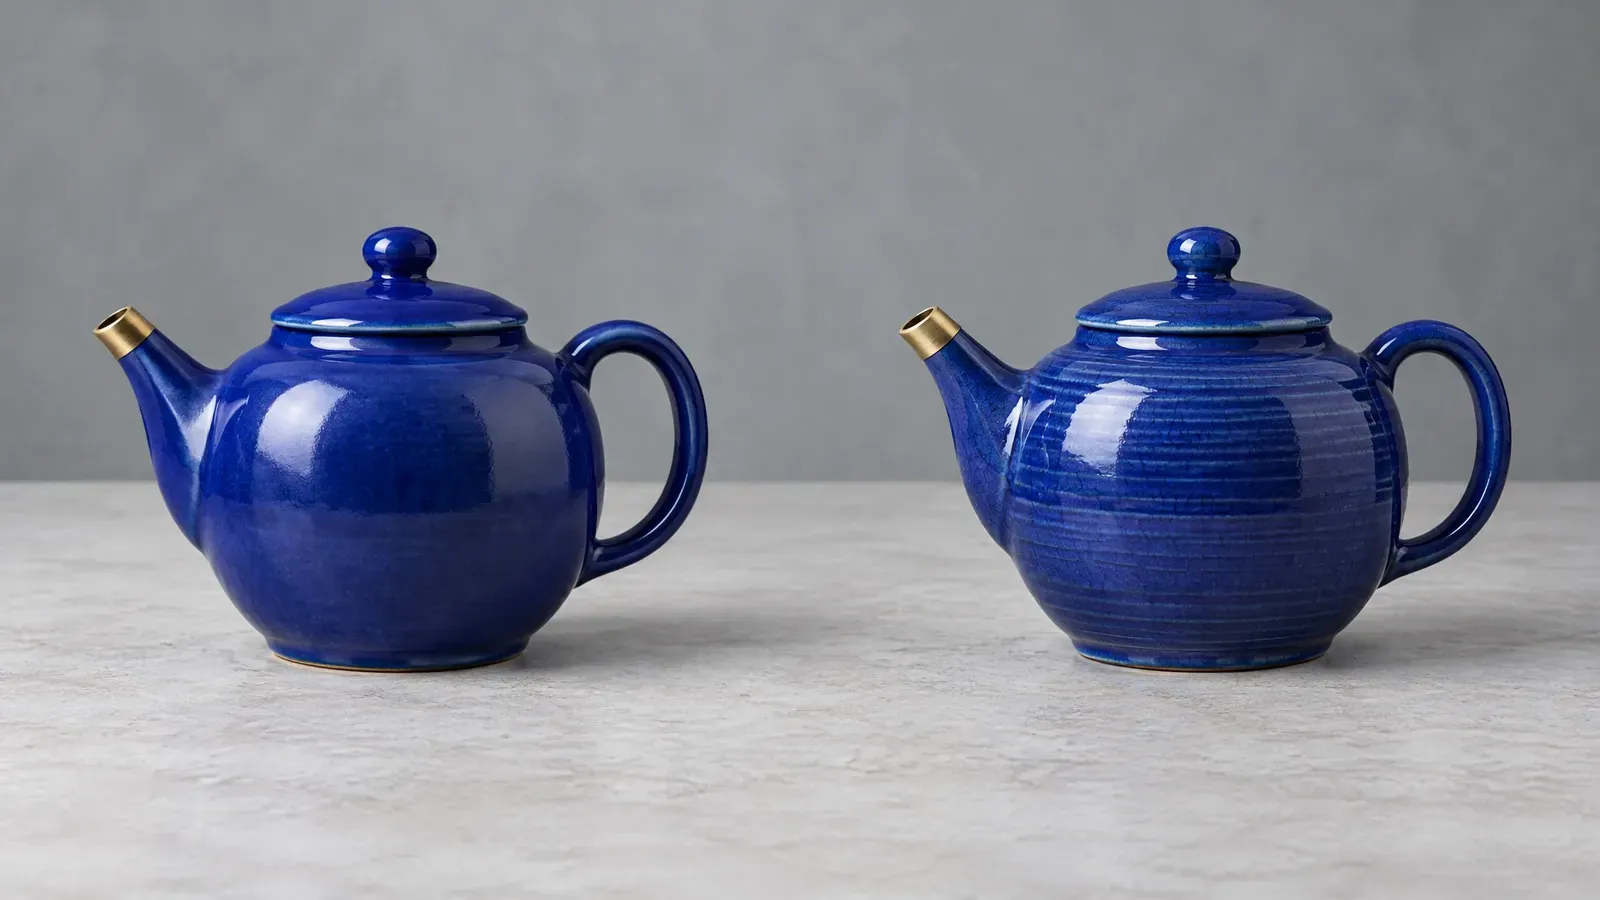
ChatGPT Images 2.5 est le modèle d’image d’OpenAI publié le 8 septembre 2026, disponible pour tous les utilisateurs de ChatGPT, ChatGPT Work et Codex, à tous les niveaux, sur ordinateur, mobile et web. OpenAI résume cette version par des détails plus nets, une édition plus précise et une génération plus rapide.
Le nom fonctionne à deux niveaux. ChatGPT Images 2.5 est le nom du produit dans ChatGPT. Dans l’API, et dans Virse, la même génération apparaît sous la forme de deux modèles : gpt-image-2.5-flare et gpt-image-2.5-sunburst, tous deux portant une date d’instantané 2026-09-08.
OpenAI cite trois améliorations par rapport à la génération précédente :
Parallèlement au modèle, OpenAI a introduit Sketch, des modèles, des modifications basées sur les commentaires et le partage de prompts. Ces quatre éléments sont des fonctionnalités de l’interface ChatGPT plutôt que des paramètres de modèle, et ce n’est pas ce que Virse expose. Ce que Virse expose, c’est le modèle lui-même, aux niveaux de qualité, tailles et comportements d’image de référence décrits dans la propre documentation d’OpenAI.
Cette page s’adresse aux personnes qui décident s’il faut déplacer le travail d’image en production vers 2.5, et vers laquelle des deux éditions l’orienter.
low, medium, high, xhigh, max et auto. Les deux niveaux supérieurs sont nouveaux dans la version 2.5.
Le nombre total de pixels va de 655 360 à 8 294 400, sans qu’aucun côté ne dépasse 3840 pixels.
Toute dimension WIDTHxHEIGHT dont les deux côtés sont des multiples de 16 et dont le ratio d’aspect est compris entre 1:3 et 3:1.
Les briefs écrits et les images de référence sont tous deux acceptés. La sortie est toujours une image.
Définissez l’arrière-plan sur transparent et récupérez le résultat au format PNG ou WebP, sans étape supplémentaire de détourage.
gpt-image-2.5-flare et gpt-image-2.5-sunburst, tous deux datés de l’instantané du 2026-09-08.
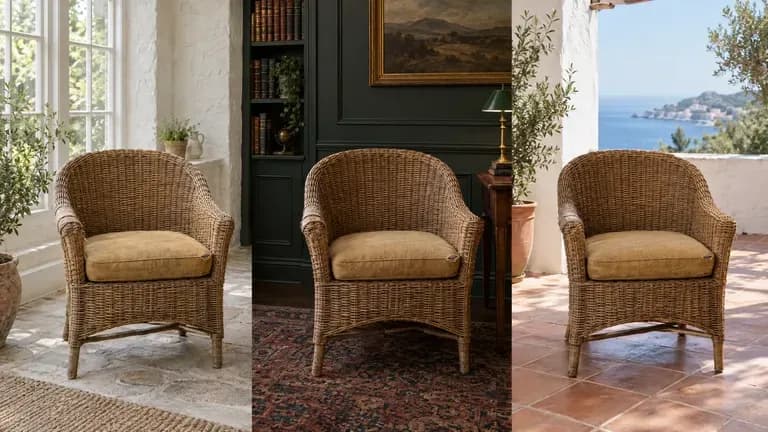
OpenAI a conçu 2.5 pour travailler davantage à partir de photos de référence, en conservant les caractéristiques distinctives lorsqu’un sujet passe dans un nouveau décor, style ou composition. Le même visage, la même bouteille, la même pièce, ailleurs.
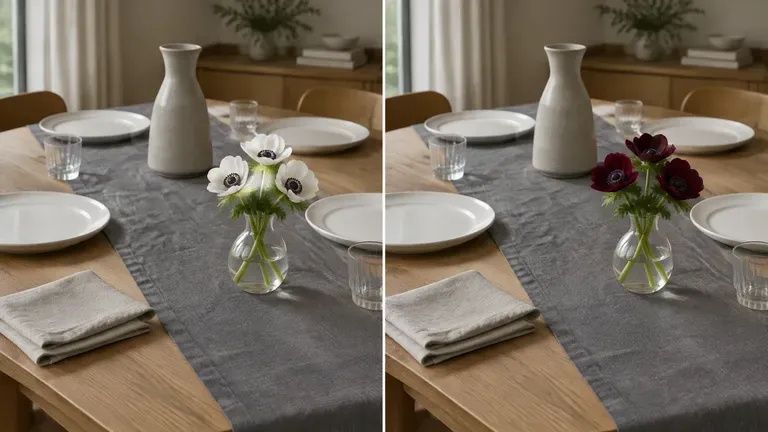
Demandez une seule modification et le reste du cadre a davantage de chances de rester en place. OpenAI décrit le modèle comme plus apte à ne modifier que ce que vous avez demandé, tout en conservant les détails environnants à l’identique, y compris sur des sujets et arrière-plans complexes.
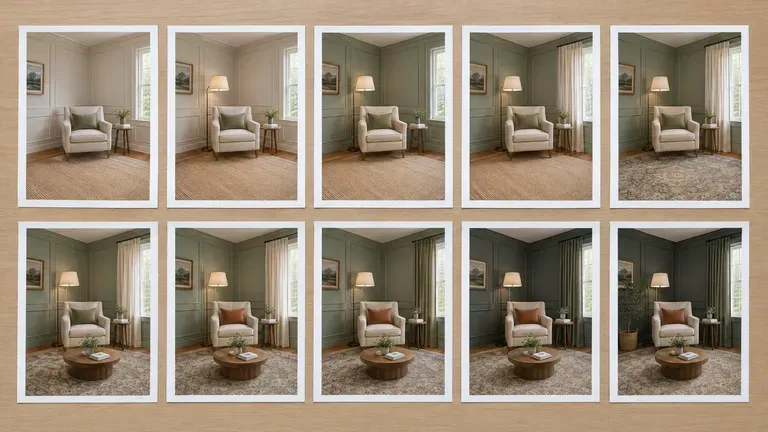
Les longues sessions de retouche avaient tendance à se dégrader. OpenAI affirme que les modifications précédentes sont désormais conservées à mesure que de nouvelles arrivent, de sorte que la dixième révision conserve toujours les neuf premières au lieu de les annuler discrètement.
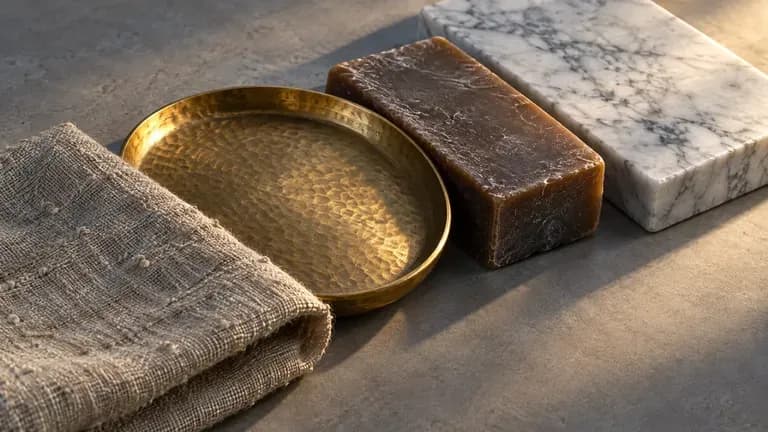
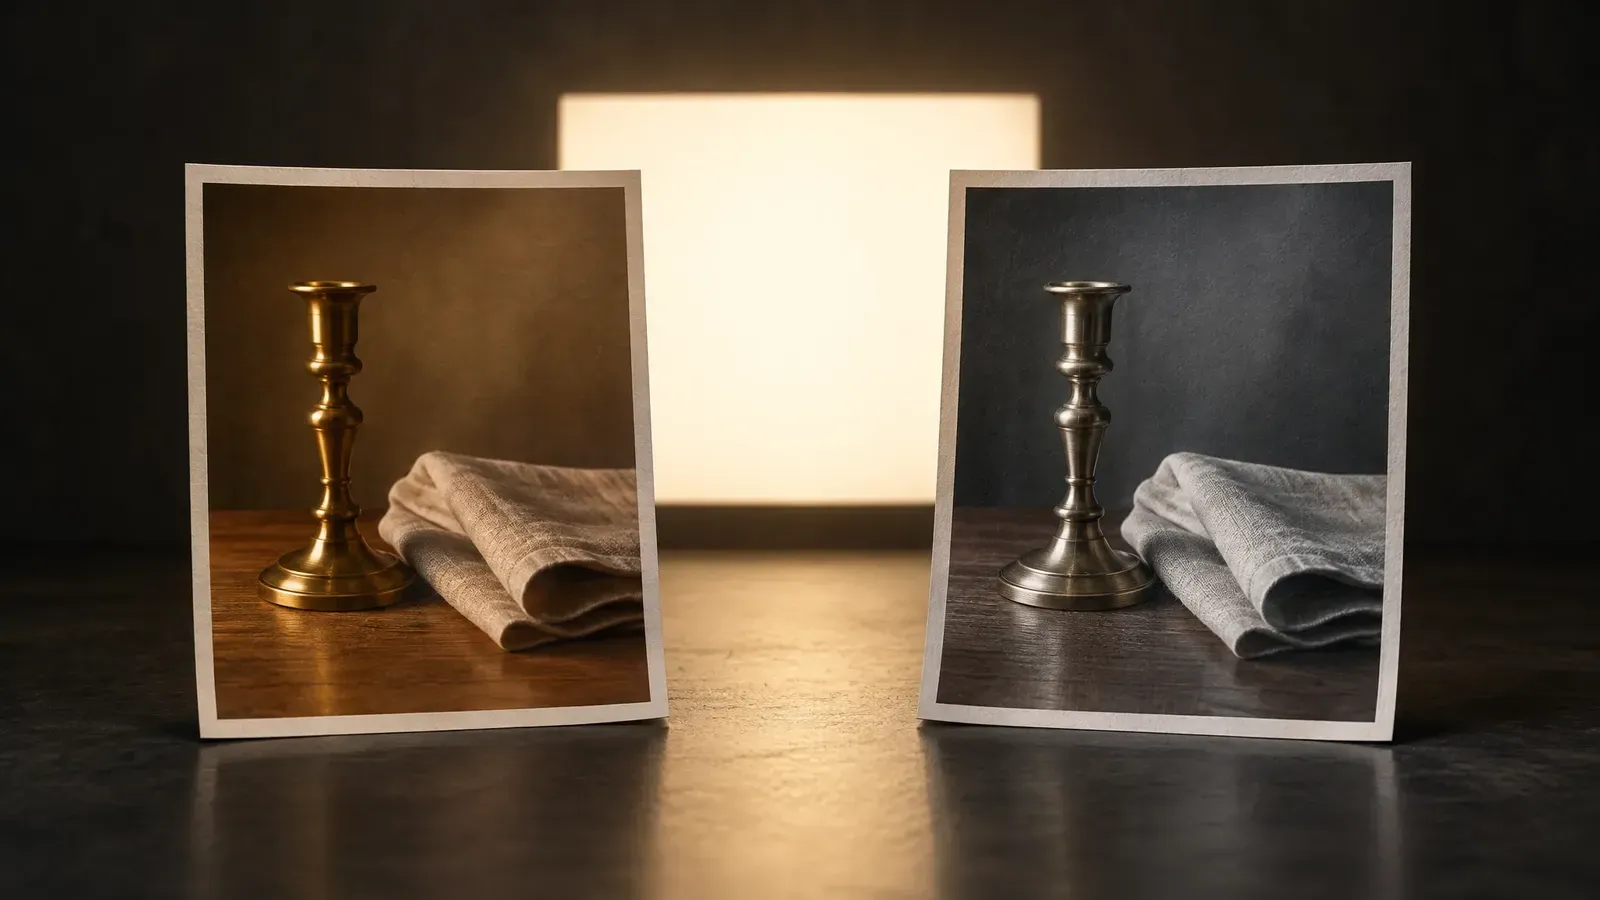
Le modèle comprend plus précisément les instructions visuelles complexes et restitue plus fidèlement un style visuel décrit, ce qui se voit surtout sur les surfaces : tissu, peau, métal, et tout élément éclairé depuis une direction que vous avez spécifiée.
Les agencements denses conservent leur hiérarchie, et les arrière-plans transparents sont traités comme faisant partie de la mise en page plutôt que comme une réflexion après coup. Les assets détourés sortent prêts à être placés.
OpenAI indique une latence de génération d’images réduite jusqu’à 50 % par rapport à Images 2.0. Flare bénéficie de ce gain ; Sunburst l’échange contre davantage de précision.
Les deux éditions 2.5 acceptent les mêmes paramètres et coûtent le même nombre de crédits dans Virse. Ce qui les distingue, c’est le temps nécessaire pour générer chaque image.
| Critère | GPT Image 2.5 Flare | GPT Image 2.5 Sunburst | GPT Image 2 | Source |
|---|---|---|---|---|
| Description d’OpenAI | "Génération d’images du quotidien rapide et de haute qualité" | "Notre modèle le plus performant pour la génération et la retouche d’images" | La génération précédente, toujours sélectionnable dans Virse | Source |
| Conçu pour | Le choix par défaut pour la plupart des travaux, du contenu pour les réseaux sociaux aux productions à grande échelle | Travail visuel premium qui bénéficie d’un contrôle plus précis au fil des modifications | Briefs longs à contraintes multiples | Source |
| Niveaux de qualité | Six niveaux, jusqu’à max | Six niveaux, jusqu’à max | Trois niveaux, jusqu’à high | Source |
| Vitesse | Latence jusqu’à 50 % inférieure à Images 2.0 | Temps de génération plus longs, en contrepartie d’une plus grande précision | Référence de base | Source |
| Crédits en 2K High dans Virse | 18 | 18 | 36 | Source |
| Crédits en 2K Max dans Virse | 69 | 69 | Niveau non disponible | Source |
Le travail guidé par des références tient rarement en une seule invite. C’est une photo, une règle de marque, quatre essais et une remarque de quelqu’un d’autre à propos du troisième. Virse garde tout cela sur un même canevas. La référence utilisée pour la génération, le brief que vous avez rédigé et chaque version reçue restent côte à côte, si bien que comparer un résultat à sa source se fait d’un coup d’œil plutôt qu’en fouillant dans des fichiers.
Placez la photo source sur le canevas à côté des générations qu’elle a produites, et évaluez la fidélité du sujet en regardant les deux en même temps.
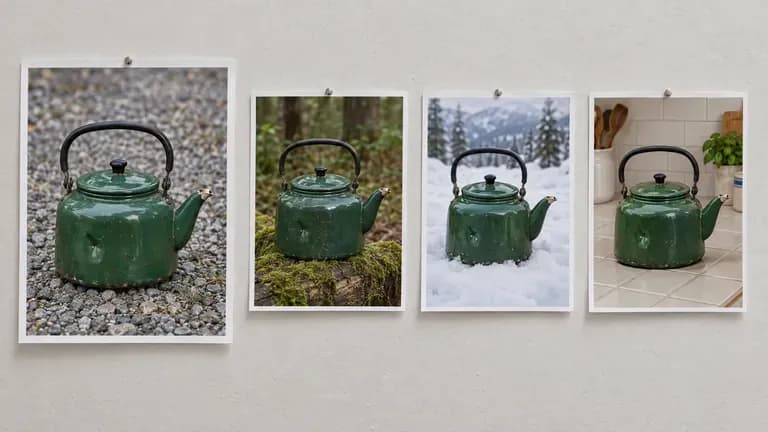
Validez la composition sur l’édition rapide, puis relancez le brief convenu sur Sunburst. Le coût en crédits par image est le même à tous les niveaux, donc seul le temps d’attente change.
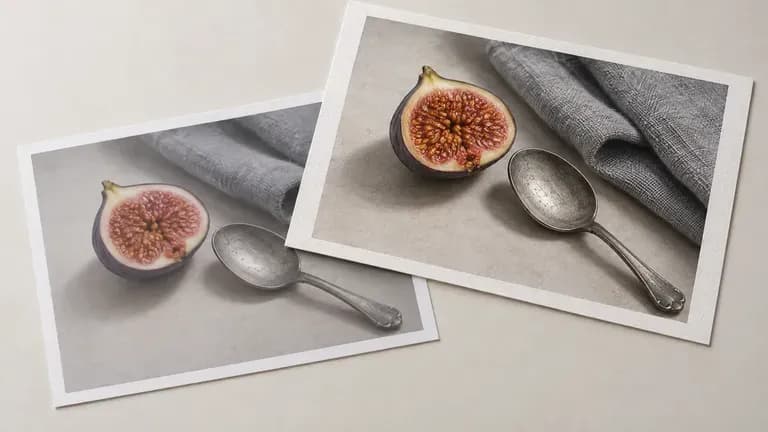
Passez de ChatGPT Images 2.5 à plus de 30 autres modèles d’image et de vidéo sans quitter le canevas ni réécrire le brief.
Chaque révision apparaît à côté de la précédente, de sorte qu’une session de retouche en dix tours reste lisible et que vous puissiez revenir au quatrième tour sans la régénérer.
Travail en série où chaque asset doit conserver la même direction visuelle, la même hiérarchie et le même traitement.
Une seule photographie de produit placée dans autant de décors, de saisons et de surfaces que la campagne l’exige.
Mises en page de faces avant d’emballage comportant les noms exacts des produits, des descriptifs et les mentions légalement requises.
Éléments à fond transparent pour présentations, bannières et mises en page qui n’ont pas besoin d’une passe de cache ensuite.
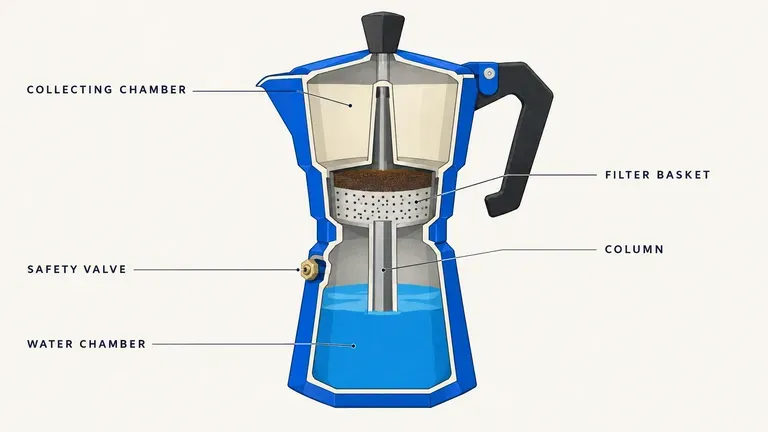
Graphiques de processus et coupes transversales où les libellés doivent être corrects plutôt que décoratifs.
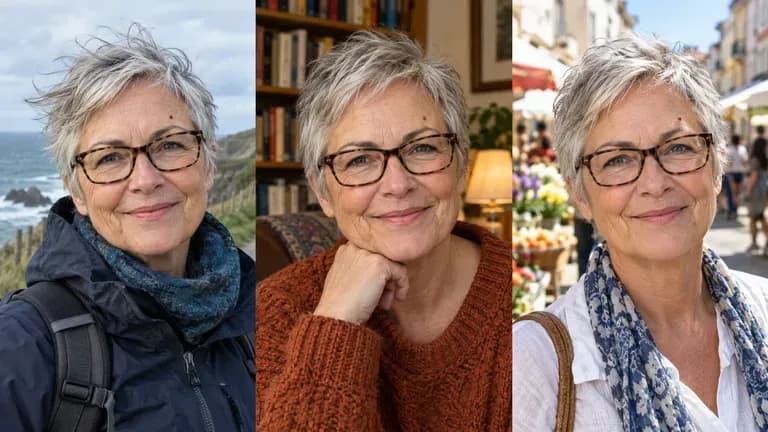
Photographies de personnes et de lieux réels déplacés dans de nouveaux environnements tout en gardant le sujet reconnaissable.
Sélectionnez le modèle dans le menu. Commencez avec Flare tant que l’image est encore en cours de définition, car il donne un résultat plus rapidement pour le même coût en crédits.
Téléversez les photos et nommez chacune selon son objectif : celle-ci est le sujet, celle-ci est le style, celle-ci est l’arrière-plan. Indiquez comment elles doivent se combiner.
Décrivez le résultat et son usage prévu, puis listez ce qui ne doit pas changer et ce qui ne doit pas apparaître. Mettez entre guillemets tous les mots qui doivent figurer sur l’image.
Renvoyez la sortie comme entrée pour la retouche suivante, demandez une seule modification et répétez les détails que vous voulez préserver.
Le propre guide de prompting d’OpenAI pour 2.5 construit un prompt en six parties, dans cet ordre. Écrire les contraintes une première fois permet de les reformuler lorsqu’une modification ultérieure s’en écarte.
Au lieu d’écrire
Faites une belle photo produit de la bouteille sur un joli arrière-plan, avec un rendu professionnel.
Écrivez
Une photographie de produit pour une fiche e-commerce, au format carré, avec la bouteille centrée et occupant les 70 pour cent centraux du cadre. Verre ambré, bouchon en aluminium brossé, condensation sur le tiers inférieur. Arrière-plan en papier mat couleur sable, une lumière douce venant du haut à gauche, une seule ombre douce tombant vers la droite. L’étiquette avant indique "NORTH FIELD" en petites capitales sur le tiers supérieur et "500 ml" sur le bord inférieur. La référence 1 est la bouteille et le graphisme de son étiquette ; conservez la géométrie et la typographie de l’étiquette exactement telles qu’elles sont fournies. Aucun texte supplémentaire, aucun logo, aucun filigrane.
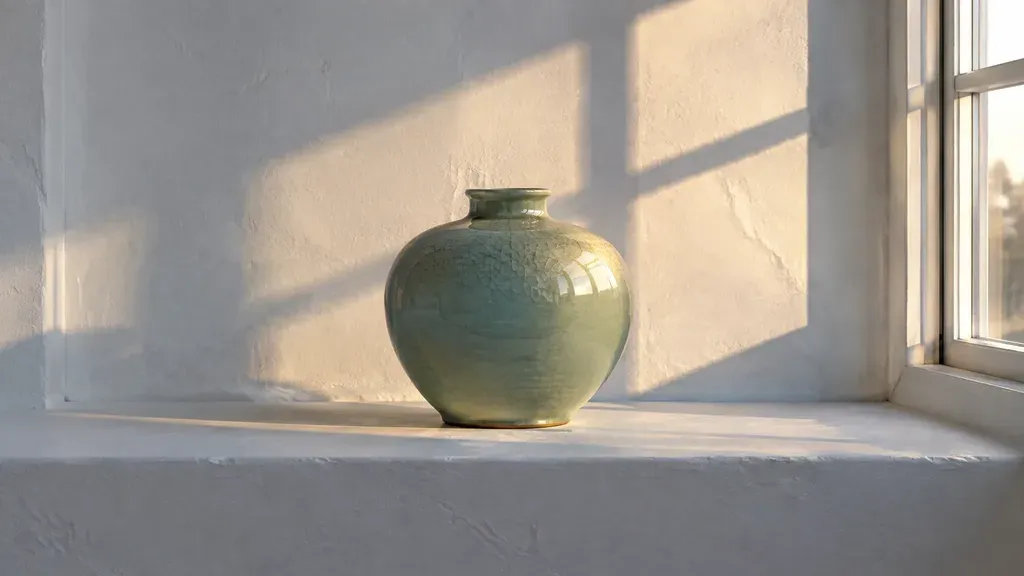
Une photographie du vase en céramique de la Référence 1, déplacé sur un rebord de fenêtre ensoleillé dans une pièce blanche enduite, prise de face à deux mètres de distance, à hauteur des yeux. Lumière de fin d’après-midi entrant par la droite à un angle bas, projetant l’ombre du cadre de la fenêtre sur le mur derrière. Conserver la couleur de l’émail du vase, le motif craquelé et les proportions du col exactement tels qu’ils apparaissent dans la référence. Modifier uniquement le décor et la lumière. Aucun objet supplémentaire sur le rebord. Aucun texte, aucun logo, aucun filigrane.
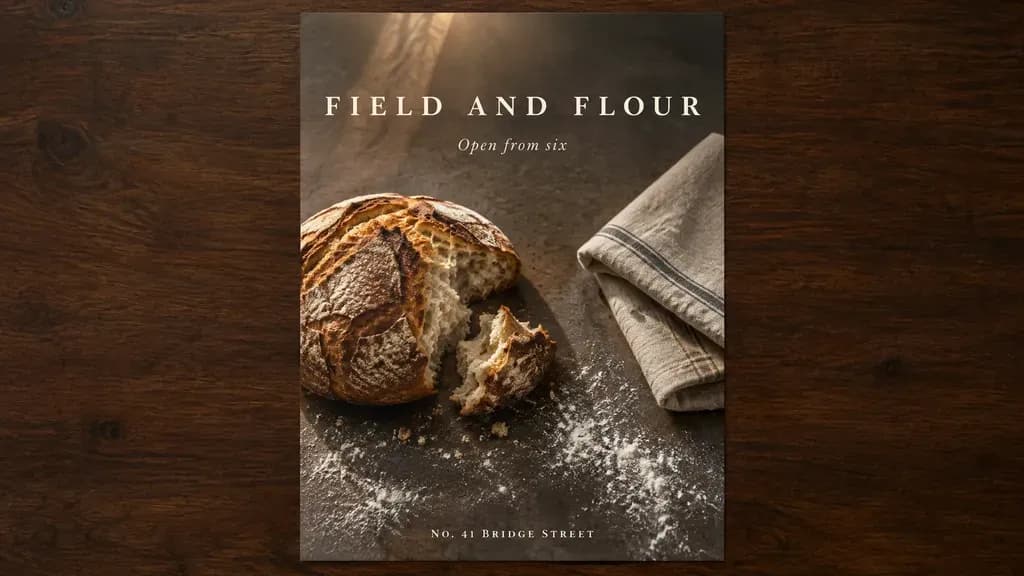
Une affiche en flat lay pour une boulangerie de quartier, en orientation portrait, photographiée directement d’en haut sur une table en noyer foncé. Sur le tiers supérieur, les mots "FIELD AND FLOUR" composés dans une large police à empattements, avec un espacement entre les lettres, en crème. En dessous, "Open from six" en petite italique, à un tiers de la taille. Sur le bord inférieur, "No. 41 Bridge Street" en petites capitales. Une miche de pain au levain déchirée en bas à gauche, un linge en lin plié deux fois à droite, de la farine saupoudrée irrégulièrement sur le quart inférieur. Une lumière zénithale légèrement derrière le sujet, de longues ombres douces vers l’appareil. Aucun autre texte nulle part dans le cadre.
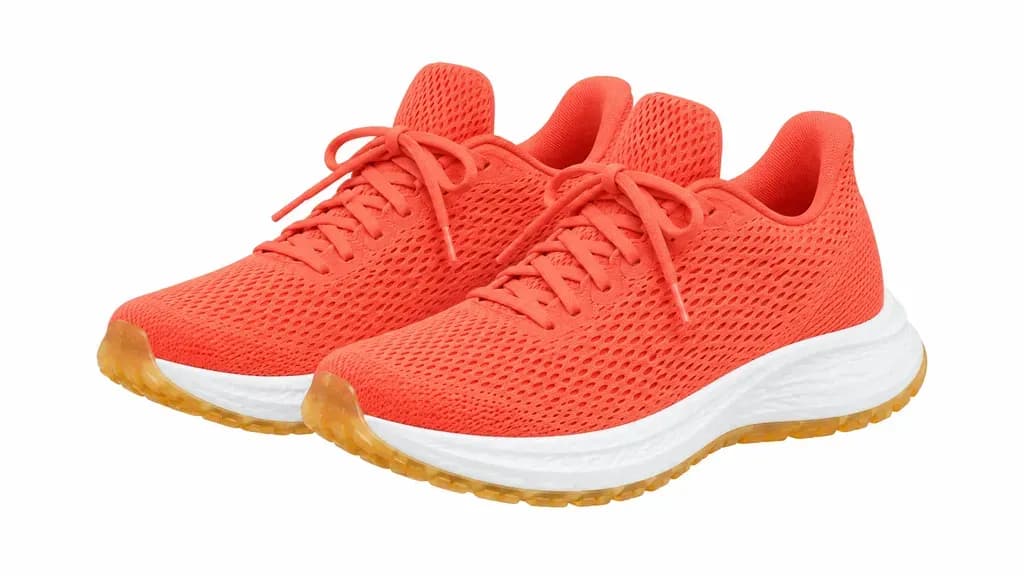
Une seule paire de chaussures de running, vue de trois quarts depuis l’avant gauche, posée à plat avec la chaussure gauche chevauchant légèrement la droite. Tige en mesh corail vif avec une semelle intermédiaire blanche et une semelle extérieure ambre translucide. Lacets noués, languette dressée, aucun pli au niveau de la pointe. Lumière diffuse uniforme directement depuis le dessus, aucune ombre portée, contours nets et complets, lacets inclus. Arrière-plan transparent. Aucune surface sous les chaussures, aucun texte, aucun logo, aucun filigrane.
Numérotez-les et indiquez à quoi sert chacune. Une référence non expliquée est diluée dans le résultat au lieu d’être utilisée pour l’unique élément que vous vouliez en tirer.
Nommez la géométrie, les libellés, l’éclairage et l’identité qui doivent être préservés. Ensuite, demandez la modification. Procéder dans cet ordre, c’est ce qui permet de garder les retouches locales.
Il vaut mieux exclure explicitement le texte, les logos et les filigranes indésirables. Il en va de même pour une deuxième source de lumière que vous n’avez jamais demandée.
Le niveau de qualité modifie le rendu, pas ce que contient l’image. Décider du contenu en basse qualité puis augmenter le niveau ensuite permet de traiter ces deux questions séparément.
Découvrez des outils spécialisés pour créer, modifier et préparer vos ressources de design.
La plupart des prompts de design échouent sur les détails ingrats : mauvais ratio d’image, couleur de marque manquante, aucune mention du texte qui doit tenir à tel ou tel endroit. Indiquez l’objectif, l’audience, le format et les contraintes, et cet outil rédige un prompt structuré pour qu’un modèle d’image puisse réellement les prendre tous en compte, en commençant avec des crédits Virse gratuits.
Des lettres sculptées dans le bois réagissent à la lumière différemment de lettres coulées dans du métal liquide, et aucun prompt unique ne réussit les deux par hasard. Saisissez votre texte, indiquez la matière, et obtenez un effet qui préserve le libellé tout en déterminant comment cette matière doit réellement capter la lumière. Les crédits gratuits vous offrent la première version.
Une page qui n’est jamais construite ne coûte pas une semaine de développeur. Importez vos photos produit et vos arguments de vente, puis visualisez la page complète avant que quiconque ne touche à un constructeur de pages : hero shot, blocs de bénéfices, offre finale, le tout dans un seul défilement, et la première version est offerte.
GPT Image 2.0 d’OpenAI lit un descriptif de cent mots et tente de l’appliquer entièrement, avec des réglages indépendants de qualité et de résolution allant de 1K à 4K.
Générez des images 4K de qualité studio avec Nano Banana Pro, en combinant plusieurs références tout en préservant la cohérence des personnages, produits et textes.
La toute dernière génération Seedream de ByteDance, disponible sous forme de Seedream 5.0 Pro et Seedream V5 Lite, toutes deux à partir du même brief écrit.
Importez la photo, indiquez ce qui change et ce qui ne change pas, puis passez le résultat au niveau supérieur une fois l’image validée.