
MiniMax H3 の絵コンテ動画化:メモリ不足を避けて複数ショットの一貫性を保つ方法
Vincent読了 10 分 ·
不要なメモリ不足(OOM)を避けながらMiniMax H3 の絵コンテ動画化で複数ショットの一貫性を保つには、絵コンテ、参照の明確な役割分担、連続性に基づくショットのグループ化、最終レンダリング前の低解像度テストを組み合わせるのが効果的です。人物、環境、動き、音声を個別の参照で指定する場合は Ref2VA、2枚の絵コンテで開始から終了までの変化を制御する場合は FL2VA を使います。
問題は、ショットや参照を増やしても、自動的に一貫性が高まるわけではないことです。つながるショットを別々に生成すると、人物、背景、製品、光、声が変わることがあります。長い参照動画、高解像度、過剰な Ref2VA 入力は、VRAM の負荷と OOM 失敗を増やします。鍵は、各参照が何を制御するか、どのショットをまとめるか、どこを個別に再生成できるかを決めることです。
実用的な流れは、絵コンテ → 参照の役割 → 連続性によるグループ化 → 低解像度テスト → 選択的な再生成 → 最終レンダリングです。Virse の無限キャンバスでは、絵コンテ、参照、素材、生成タスクを一つの空間で整理でき、H3 の複数ショット制作をより視覚的で、一貫し、再現しやすい工程にできます。現在、MiniMax H3、Seedance 2.5、Seedance 2.0 は Virse で利用でき、同じ制作工程で複数の主要動画モデルを試して比較できます。
MiniMax H3 の絵コンテ動画化はどう動くか
絵コンテをシーケンスの視覚的な仕様とし、静止画で伝えきれない情報を別の入力に任せると、H3 を活用しやすくなります。
H3 は複数コマの絵コンテ全体を読めるか
調査には、約15秒の動画を表す絵コンテを個別のキーフレームに分けず、一枚の視覚参照として渡した例があります。結果は複数の構図を十分に追従し、全体を渡す方法が素早い試作に実用的だと示しました。
有効だった流れは次のとおりです。
アイデア → 絵コンテ → 全体を参照として入力 → H3 → 確認
デザイナーがすべての構図を文章で説明しなくて済む点が重要です。
ただし、主張できる範囲には限界があります。検証済みの普遍的なコマ数上限、コマ順の正確さの保証、小さな文字を確実に読む証拠は見つかりませんでした。複雑な絵コンテは、単純な10~15秒のシーケンスと同様に動くと決めつけず、実際に試す必要があります。
絵コンテが H3 の指示を簡単にする理由
絵コンテなら、文章化すると不必要に長くなる次の情報を伝えられます。
- 構図
- フレーミング
- 被写体の位置
- 製品の配置
- ショット同士の関係
- 視覚的な展開
文章の指示は、動き、カメラの挙動、タイミング、せりふ、音声、意図した変化に集中できます。
専門的な制作では、文章の中よりキャンバス上で視覚方針を確認・修正するほうが容易なことが多く、この分担は重要です。
H3 の FL2VA と Ref2VA:絵コンテにはどちらが適するか
適切なH3 のモードを選ぶと、絵コンテで制御できる範囲が変わります。
明確な始点・終点の変化には FL2VA
FL2VA は最初と最後のフレームを中心に動作します。2つの視覚状態が連続した変化を定義する場合に有用です。例は次のとおりです。
- ポーズの変化
- 製品の変形
- カメラ移動
- 人物の動き
- 絵コンテ2コマ間のアニメーション
MiniMax の案内は、このモードで連続する動作経路を重視しています。そのため FL2VA は、単一ショットの変化やコマ間の連結に特に適します。
つまり、絵コンテの隣り合うコマを始点・終点にして短い区間を複数作り、後からつなげられます。
複数の参照を使う絵コンテには Ref2VA
Ref2VA は、動画が複数種類の参照に依存する場合に適しています。
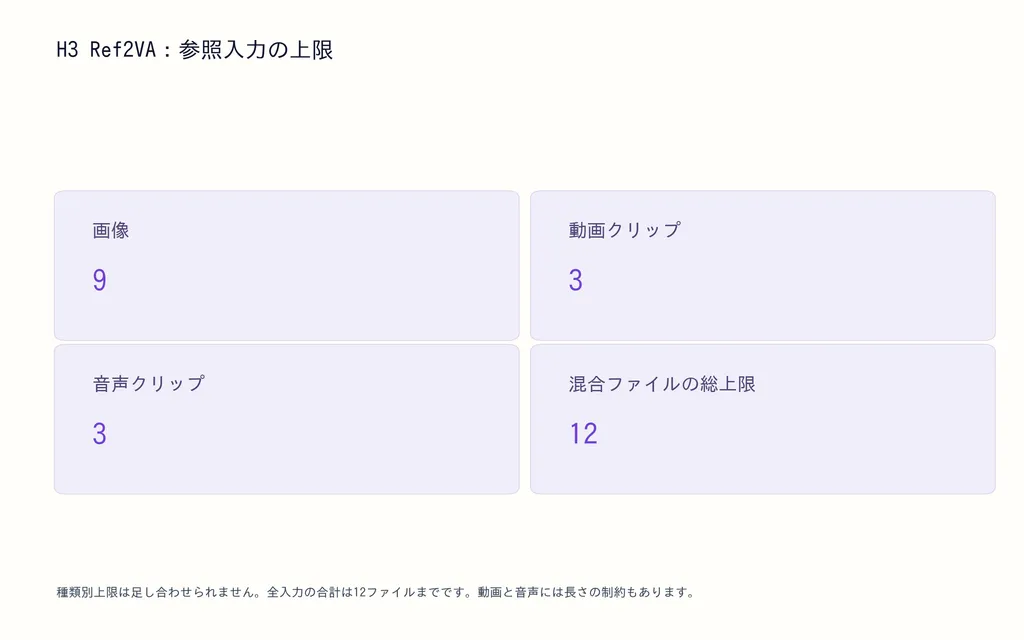
MiniMax の公開仕様は最大画像9枚、動画参照3本、音声参照3本に対応し、混在させた入力ファイルの合計上限は12個です。動画・音声参照には長さの制限もあるため、すべての枠を埋めることが最善とは限りません。
一つのシーケンスに次が必要なら、Ref2VA が向いています。
- 絵コンテ
- 人物の参照
- 製品の参照
- 環境の参照
- 動きの参照
- 音声の参照
H3 のマルチモーダル文脈システムは、これらの入力を組み合わせて推論する設計ですが、役割を明確にすることは不可欠です。
H3 Ref2VA の参照をどう整理するか
調査で最も有力だった考え方は単純です。
一つの参照に、一つの主な責任を持たせる。
参照 | 主な役割 |
絵コンテ | 構図とショットの順番 |
人物画像 | 人物の同一性と衣装 |
製品画像 | 形状と外観 |
環境画像 | 場所と光 |
参照動画 | 動きやカメラの挙動 |
音声参照 | 声、タイミング、リズム |
参照の役割を明確にする理由
絵コンテの構図は正しくても、製品の形が不正確な場合を考えます。明瞭な製品画像があれば、それを製品の正しい姿の基準とし、絵コンテにはフレーミングを任せます。
一つの参照にすべてを任せるより確実です。
参照は多いほど良いとは限らない
実際の H3 に関する質問を確認すると、参照の過剰投入に伴う2つの問題が繰り返し見られました。
まず、参照同士が矛盾することがあります。人物の衣装が素材ごとに違ったり、2枚の環境画像が異なる照明を示したりします。
次に、参照動画はメモリ負荷を大きく増やすことがあります。
問うべきなのは、H3 が何個の参照に対応するかより、各参照が何を制御する必要があるかです。
最適な H3 絵コンテ動画化の手順は
適切な制作ワークフローでは、最終品質に計算資源を使う前に創作の方向を検証します。
手順1:最終尺に合わせて絵コンテを作る
10~15秒のシーケンスでは、意味のある視覚状態に絞ります。
- 冒頭の構図
- 主な動作
- 移行
- 見せ場の提示
- 終了状態
コマを増やしても、自動的に良い結果にはなりません。
手順2:生成前に絵コンテを点検する
調査した一例では絵コンテへの忠実度が高かった一方、絵コンテ自体に縮尺、色、物体の細部の誤りがあり、その誤りが動画にも引き継がれました。
実務上の原則は次のとおりです。
忠実度が高いほど、入力品質が重要になる。
生成前に、比率、色、人物の位置、製品の形状、画面比率、コマの論理を確認します。
手順3:参照の役割とショットの意図を定める
何を安定させるべきか決めます。
例えば次のように分けます。
人物の参照 → 同一性
絵コンテ → 構図
環境の参照 → 場所
動きの参照 → 動作
音声の参照 → 声
プロンプトは、参照で示されない情報だけを補います。
手順4:時間軸を説明する
静止したコマが示すのは状態であり、時間配分ではありません。
ショットごとに現在の状態、動作、カメラの挙動、移行、終了状態を定義します。H3 がコマを一貫してつなぐための時間構造になります。
手順5:まず低解像度で試す
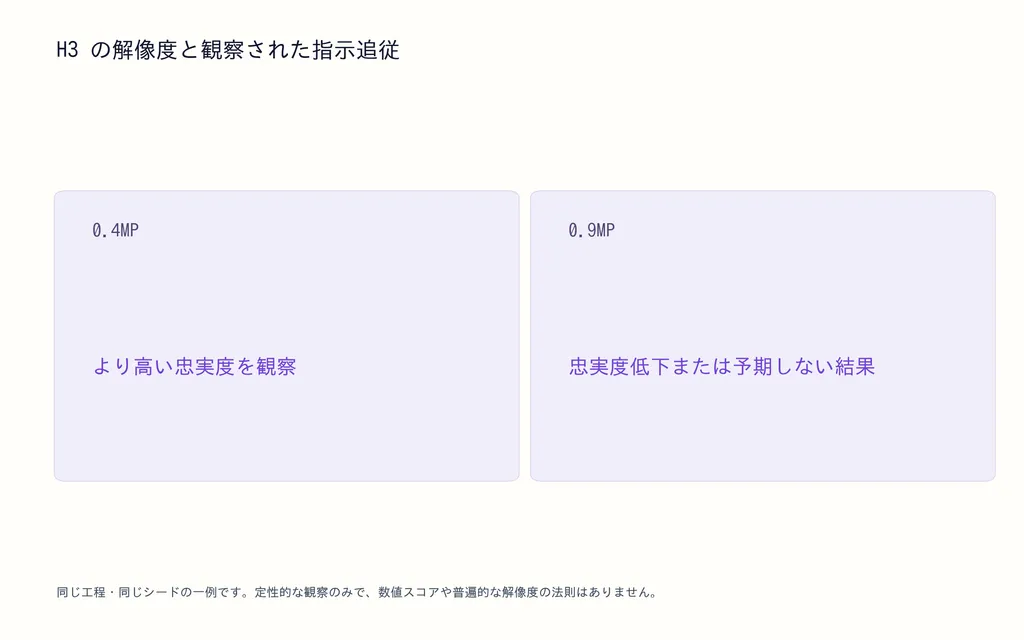
調査には、同じシードで約0.4MPのほうが0.9MPより指示に忠実だった比較例がありました。
普遍的なベンチマークではありませんが、役立つ原則を示します。
精細さより先に方向を固める。
低解像度で構図と動きを試し、最も良い結果を仕上げます。
H3 の複数ショット一括生成と個別生成:どちらが良いか
唯一の正解はありません。連続性と再試行の効率の兼ね合いです。
関連するショットはまとめて連続性を保つ
次を共有するショットは、一緒に生成する利点があります。
- 同じ人物
- 同じ環境
- 連続した動作
- 連続した対話
- 同期した音声
別々の生成の間でモデルが再構築すべき連続性を減らせます。
独立したショットは個別生成で反復を速める
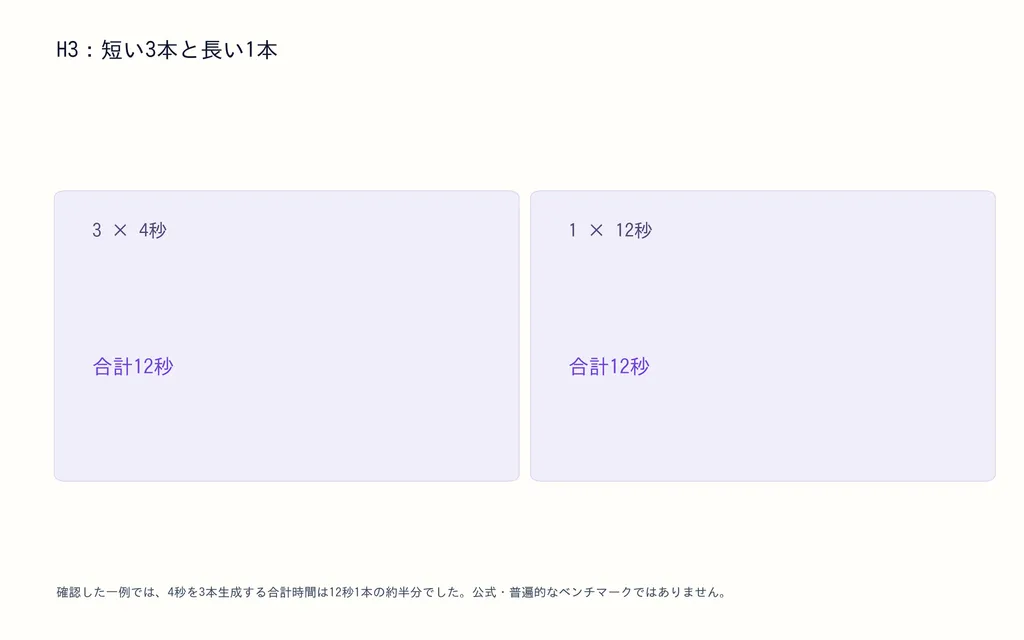
調査した例では、4秒のクリップ3本と12秒のクリップ1本を比較しました。その設定では、短い3本の合計生成時間が約半分でした。
公式ベンチマークではありませんが、長いシーケンスの再試行が高くつく理由を示しています。
連続性スコアで絵コンテをグループ化する
各移行を次の観点で評価すると実用的です。
- 同じ人物
- 同じ場面
- 連続した動作
- 連続した対話
- 共有する音声
- 直接的な時間関係
連続性スコアが高い場合:ショットをまとめる。
連続性スコアが低い場合:分ける。
すべてを一本の長い生成にする、または完全に独立したクリップにするより、この併用方式のほうが実用的なことが多いです。
実際の H3 VRAM テストから分かること
H3 の性能は、最低 VRAM 容量一つでは説明できません。
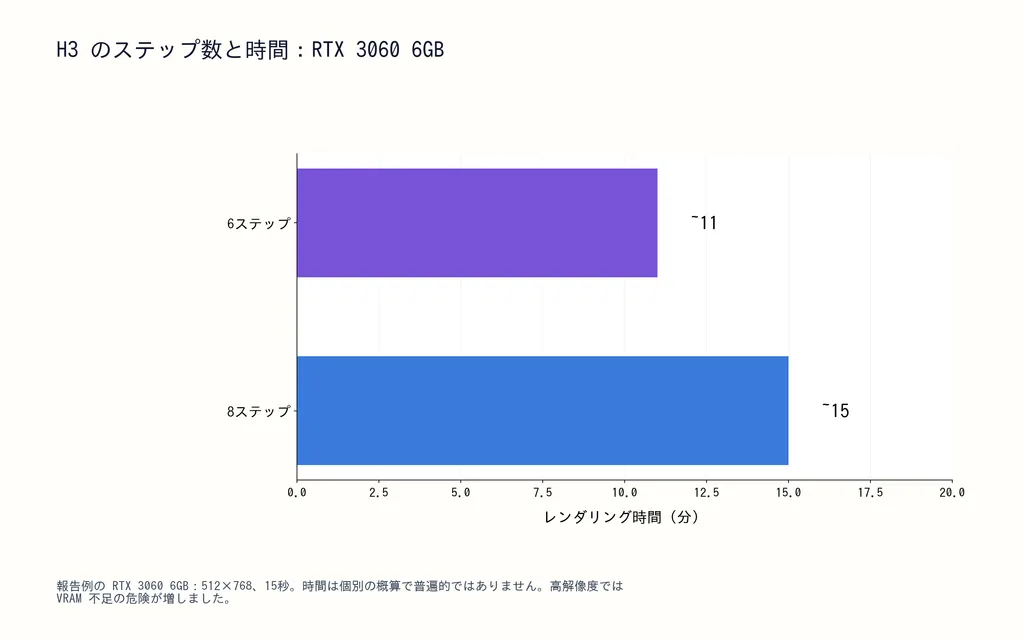
VRAM 6GB:動作するが遅い
RTX 3060 6GB の例は次を生成しました。
- 512 × 768
- 15秒
- 約6ステップで11分
- 約8ステップで15分
この構成では、高解像度の試行で OOM が発生しました。
VRAM 12GB:参照の長さが重要
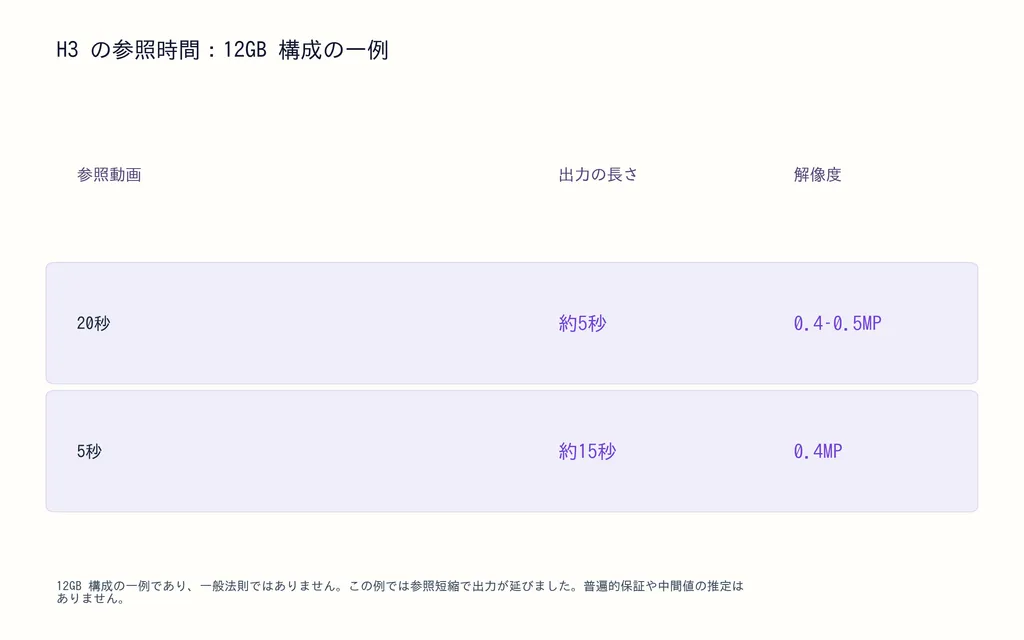
12GB の例では、当初20秒の参照動画を使い、約0.4~0.5MPで5秒しか生成できませんでした。
参照を5秒に短縮すると、同じ工程で約0.4MPで15秒を生成できました。
教訓は明確です。長い参照が自動的に良い参照になるわけではありません。
VRAM 16GB:OOM は工程の問題でもある
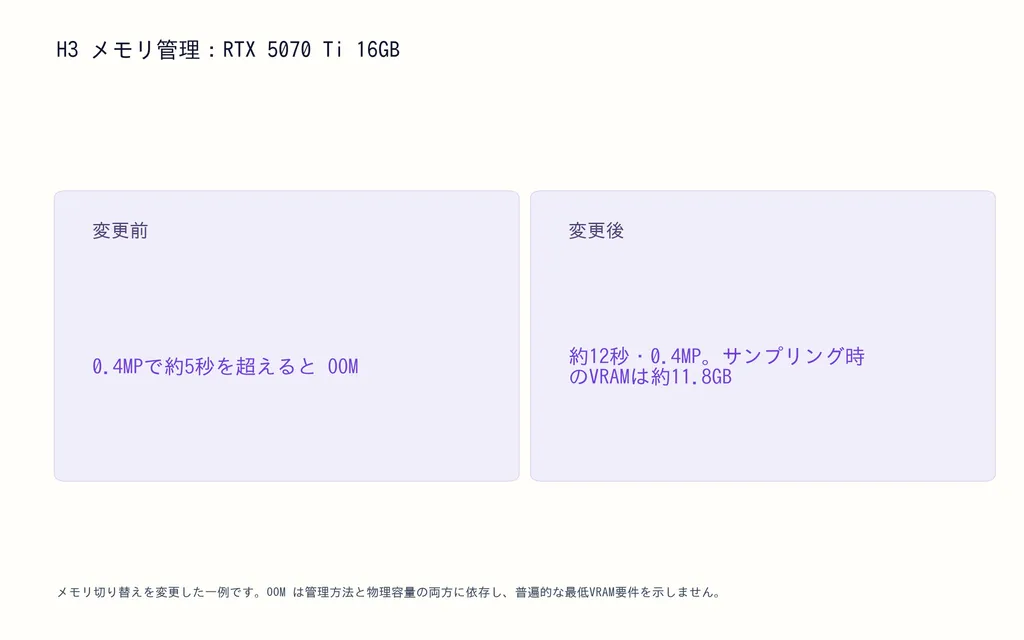
RTX 5070 Ti 16GB の構成では、当初0.4MPで約5秒を超えると OOM が起きました。
メモリの切り替え手順を変えると、約0.4MPで12秒に達し、サンプリング中の VRAM は約11.8GBと報告されました。
これは OOM が、物理容量だけでなくメモリ管理にも依存すると示しています。
H3 の人物・場面・声の一貫性を改善するには
連続性は、顔の一貫性だけではありません。
人物参照だけでは場面の変化を防げない
人物画像は同一性を安定させますが、別々に生成すると次が変わることがあります。
- 背景の建築
- 照明
- 物体の位置
- 脇役
- 空間的な関係
繰り返し使う場所では、専用の環境参照も人物参照と同じくらい重要なことが多いです。
別々の生成で声が変わることがある
調査した例では、約12秒と10秒の区間に分けて生成しました。外見は使える状態を保ちましたが、人物の声は生成ごとに変化しました。
音声参照は追加の固定点になりますが、声を完全に連続させられるという証拠はありません。
対話が多いシーケンスでは、可能な限りつながる会話のショットをまとめます。
H3 に「絵コンテコンパイラ」が必要な理由
絵コンテ動画化で欠けているのは、もう一つのプロンプト生成器ではなく、絵コンテコンパイラです。
より高度な制作システムは、絵コンテを次のように変換します。
コマ検出 → ショット理解 → 参照割り当て → 連続性評価 → ショットのグループ化 → 生成計画 → 選択的な再生成
これは H3 の公式機能ではなく、調査から導いた作業の枠組みです。
どのコマをまとめるか、各視覚属性をどの参照が制御するか、失敗したどの区間を作り直すかを、毎回デザイナーが手で判断しなくて済む点に価値があります。
ここで Virse のようなキャンバス型制作システムも関わります。可能性は生成品質の向上だけでなく、制作全体をより良く組み立てることにあります。
よくある質問
H3 は絵コンテ全体を読めますか?
はい。調査には一枚の複数コマ絵コンテで約15秒のシーケンスを作れた例があります。ただし、コマ数、複雑さ、小さな文字は個別に試す必要があり、常に信頼できると考えるべきではありません。
H3 の絵コンテはコマごとに分けるべきですか?
常に分ける必要はありません。短いシーケンスの素早い検討には全体を使い、始点と終点を強く固定したい場合は FL2VA 型の連結、個別ショットの修正が多い場合は別々の生成を使います。
H3 にはどの程度の VRAM が必要ですか?
確認した工程には6GB、12GB、16GBがありますが、性能は大きく異なります。解像度、参照の長さ、出力尺、ステップ数、メモリ管理が、容量そのものと同じくらい重要なことがあります。
H3 で人物・場面・声の一貫性が失われるのはなぜですか?
関連するショットを別々に生成すると維持が難しくなります。人物、環境、音声の参照は役立ちますが、連続性への依存が強いショットを可能な限り同じ生成グループにまとめるのが最も確実です。
結論
MiniMax H3 の絵コンテ動画化は、ワンクリックのアニメーション機能ではなく、構造化した制作工程として最も効果を発揮します。絵コンテは視覚構造、FL2VA は明確な始点・終点の変化、Ref2VA は役割を定めたマルチモーダル参照を担当します。関連ショットを連続性でまとめ、仕上げ前に低解像度で試します。実用的な流れは、絵コンテ → 参照の役割 → 時間軸 → 連続性スコア → ショット群 → 制御した生成 → 選択的な再試行 → 仕上げです。指示を簡単にし、デザイナーが複数ショットの AI 動画を明確で再現可能な方法で演出できます。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao