
MiniMax H3キーフレーム制御ガイド:任意のフレームに画像・音声参照を追加
 Yifan Zhao読了 12 分 ·
MiniMax H3のキーフレーム制御では、最初や最後のフレームだけに頼らず、生成動画内の指定位置に画像・動画・音声の参照を配置できます。MiniMax H3のComfyUIワークフローを使うと、重要な絵コンテ上の場面を固定点にし、複数キーフレームのシーケンスを構築し、映像と音声の文脈を続きを生成するワークフローに引き継げます。
ただし、フレームの固定点を設けても、フレーム単位で正確なタイミングが保証されるわけではありません。シーケンスが長く複雑になるほど、タイミングのずれ、人物の同一性の変化、動きの連続性の低下、画質の劣化が起こり得ます。そのため、信頼性の高いH3ワークフローでは、時間的ガイドに、プロンプトによる時間指定、継続的な視覚参照、複数フレームの文脈を組み合わせます。
よりシンプルな制作環境を求めるチーム向けに、Virseは、MiniMax H3、Seedance 2.0、Seedance 2.5などの主要モデルを1つの共同デザインキャンバスにまとめています。有料プランにはNano Banana 2やGPT Image 2など40以上のモデルの無制限利用と、人数制限のないユーザー席が含まれます。新規ユーザーには、Nano Banana 2の画像約10枚またはSeedance 2.0の動画1本を生成できる登録クレジットも付与されます。
MiniMax H3のキーフレーム制御とは?AddGuideはどう動く?
MiniMax H3のキーフレーム制御は、AI動画生成にタイムラインを考慮した条件付けを加えます。開始フレームと終了フレームの間のすべての状態をモデルに推測させる代わりに、AddGuideでは選んだ位置に視覚や音声のガイドを置けます。これは、より広いMiniMax H3の制作ワークフローにも自然に組み込めます。
このワークフローは、次のように考えると分かりやすくなります。
プロンプトは動作を定義し、参照は外観を定義します。キーフレームガイドは、重要な状態をいつ動画に反映させるかを定義します。
AddGuideは静止画、対応する複数フレームのシーケンス、音声、または画像と音声を組み合わせた文脈を扱えます。複数の場面を強く制御したいときは、複数のガイドを連結することもできます。
MiniMax H3 AddGuideと先頭・末尾フレーム制御の比較
制御方法 | 適した用途 | 主な強み | 主な制限 |
|---|---|---|---|
先頭フレーム | 冒頭のショットを定める | 開始時の構図を強く制御 | 後半の制御は限定的 |
先頭+末尾フレーム | 方向性のある遷移 | 始点と終点を強く制御 | 中間状態には自由度が残る |
AddGuide | 動画途中の視覚的な目標 | 選んだ時点にガイドを配置 | タイミングはずれる場合がある |
複数のAddGuide | 絵コンテのシーケンス | 複数の主要な展開を制御 | 制約が競合する場合がある |
複数フレームガイド | 動画の継続生成 | 動きの文脈を保持 | 対応するフレーム数が必要 |
画像+音声ガイド | 映像と音声の連続性 | 映像と音を一緒に引き継ぐ | 音声は依然として予測しにくい |
制作の観点では、途中の特定の場面に創作上または商業上の重要性があるとき、AddGuideの価値が最も高まります。商品の登場、人物のポーズ、カメラの構図、台詞の節目、場面転換などが該当します。
MiniMax H3の任意のフレームに画像・音声参照を追加する方法は?
効果的なMiniMax H3のキーフレームワークフローは、追加の制御が必要な場面だけを見極めることから始まります。体系的なMiniMax H3の参照ワークフローを使うと、生成前に同一性、動き、画角、音声の役割を切り分けられます。
- 意味のある参照を選ぶ。絵コンテの1コマ、商品の角度、人物のポーズ、カメラ構図、映像と音声の一場面などを使います。
- 画像、クリップ、音声、または複合ガイドを意図した位置に置きます。
- その場面の前後で起こることをプロンプトに記述する。固定点の前後の動作も含めます。
- 一貫性が重要な場合は、同一性の参照を継続して有効にします。
- 生成後にタイミングを確認する。要求した正確なフレームに必ず目標が現れるとは考えないでください。
複数フレームガイドに対応するクリップ長は、5、22、39フレーム、その後は17フレームずつ増加といった規則的な並びになります。このため、短い動きの文脈は継続生成に特に役立ちます。
事例:124フレーム中の60フレーム目に絵コンテ画像を配置
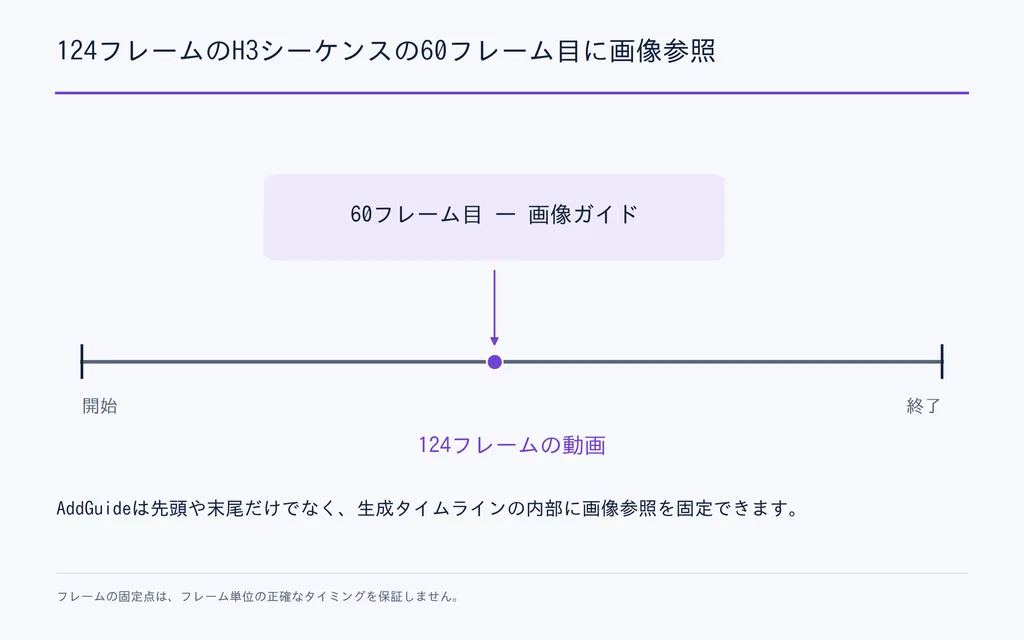
記録されたH3ワークフローでは、静止画を124フレームの動画内の60フレーム目前後に配置しました。
モデルが歩き始め、途中で商品を見せる明確なスリークォーターのポーズになり、最後はクローズアップで終わる商品動画を考えてみましょう。先頭フレームの参照で冒頭を定めることはできますが、ショットの中ほどの主役となる構図を強く制御することはできません。
60フレーム目前後にガイドを追加すると、その構図が明示的な目標になります。
実践上の教訓は、小さな動きの変化すべてではなく、主要な視覚的判断にキーフレームを使うことです。違いの少ない固定点を増やしすぎると、制御が改善しないまま複雑さだけが増すことがあります。
MiniMax H3の複数キーフレームは絵コンテ制御をどう改善する?
複数のH3キーフレームを使うと、単純な開始から終了への遷移だけでなく、計画した複数の視覚状態を1回の生成に含められます。
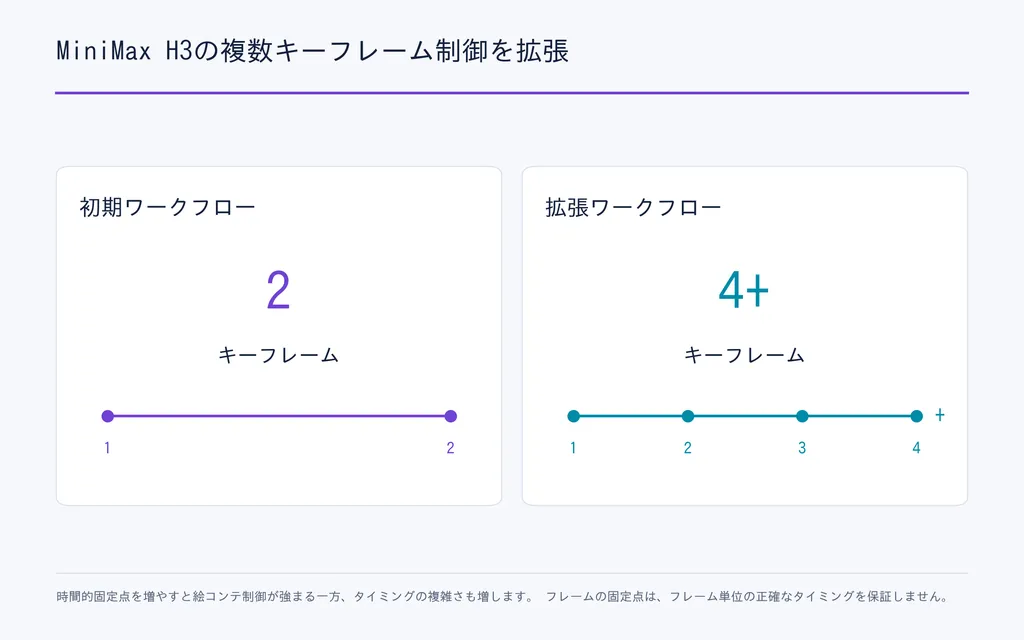
記録されたワークフローを調べると、2つのキーフレームから4つ以上の固定点へ拡張した構成が見られました。絵コンテの制御は大幅に強まりますが、現在のH3キーフレーム機能の主な限界である時間指定への追従性も明らかになります。
事例:H3キーフレームを2つから4つ以上へ拡張
複数キーフレームの一貫性テストでは、視覚的な固定点を増やしても、各参照が自動的に意図した時刻に現れるわけではありませんでした。ある状態は早く、別の状態は遅れて現れたり、近接するフレームで2つの状態が混ざったりしました。
より信頼性の高い方法では、3つの制御を組み合わせていました。
時間上の配置にはAddGuide、イベントの順序にはプロンプトの時間指定、同一性とスタイルには継続的な参照を使います。
あるワークフローでは、124フレーム目付近の目標をガイドと明示的な時間表現の両方で強調し、視覚参照も再利用して同一性、照明、スタイルを維持しました。
この分離が重要です。1つの条件付け手法だけで、タイミング、外観、同一性、動きを同時に解決できるとは考えるべきではありません。
H3キーフレームが目標フレームからずれる理由
次の場合、フレームのずれが起きやすくなります。
- 複数のキーフレームの見た目が似ている。
- 1つのクリップにイベントを詰め込みすぎている。
- 複数の人物が動いたり話したりする。
- 台詞のタイミングを視覚的な動作に合わせる必要がある。
- 長いクリップに複数の場面転換がある。
- 視覚と音声の条件が注意を奪い合う。
絵コンテどおりであることが重要なショットでは、目標フレームを決定論的な編集用キーフレームではなく、強い時間的制約として扱いましょう。
MiniMax H3で画像・音声ガイドを動画の継続生成に使うには?
H3の継続生成では、1枚の末尾フレームより、短い映像と音声の文脈ウィンドウのほうが有用な場合が多くあります。
静止画はH3に前のショットがどのように見えたかを伝えます。複数フレームなら、被写体とカメラがどのように動いていたかも伝わります。音声を加えると、場面の状態をさらに引き継げます。
事例:最後の22フレームと音声でH3の続きを生成
実用的な継続生成ワークフローの1つでは、前のクリップの最後の22フレームと対応する音声を次の生成に渡します。
手順はシンプルです。
- 既存クリップの最後の22フレームを残します。
- 対応する音声を残します。
- 両方を継続生成の初期文脈にします。
- 次の区間を生成します。
- 繰り返された重複部分を切り取ります。
- クリップをつなぎ合わせます。
22フレームのウィンドウは、H3が対応する複数フレームガイドの長さの1つに一致するため、特に便利です。
制作全体への示唆は、連続性は末尾フレームだけの問題ではなく、文脈ウィンドウの問題だということです。1枚の画像は外観を保ちますが、複数フレームの映像・音声文脈なら、移動方向、身振りの進行、カメラの挙動、継続中の音も保持できます。
長い動画でH3キーフレームの一貫性を保つには?
長いH3動画では、1つのキーフレームでは解決できない誤差が蓄積します。生成を繰り返すうちに、人物の同一性が揺らぎ、鮮明さが落ち、移動方向が変わり、音声の連続性が弱まる可能性があります。
最も有効な戦略は、3つの目標を分けることです。
- 動きの連続性には複数フレームの文脈を使う。
- 被写体の一貫性には同一性と場面の参照を再利用する。
- 区間の品質を立て直す必要があるときは、高品質な視覚的固定点を導入する。
事例:736 × 1280のH3クリップ7本
あるH3の長編ワークフローでは、7本の別々のクリップを長いシーケンスにまとめました。各区間は解像度736 × 1280、15ステップ、Turbo LoRAなしで生成し、その後自動で連結しました。
このワークフローは強い先頭・末尾フレームの固定点を使い、新しい区間が毎回、意図した視覚状態で始まり、終わるようにしました。
ここから導ける実践的な長編動画の戦略は、長いAI動画を1回の無制限な生成ではなく、制御された分割生成として扱うことです。
商品動画、ブランドのキャラクター、連作の場面では、分割したワークフローのほうが、品質が崩れ始めた際に確認、修正、立て直しをしやすくなります。
良い映像を変えずにMiniMax H3の音声品質を改善するには?
音声と映像に常に同じサンプリング予算が必要とは限りません。映像は良いのに音が弱い場合、両方を変更し続けると、うまくいった映像を損なう可能性があります。
そこで実験的なH3ワークフローでは、動画の潜在表現を固定し、音声だけに追加の調整ステップを与える方法が試されています。
事例:動画4ステップ+音声調整6ステップ
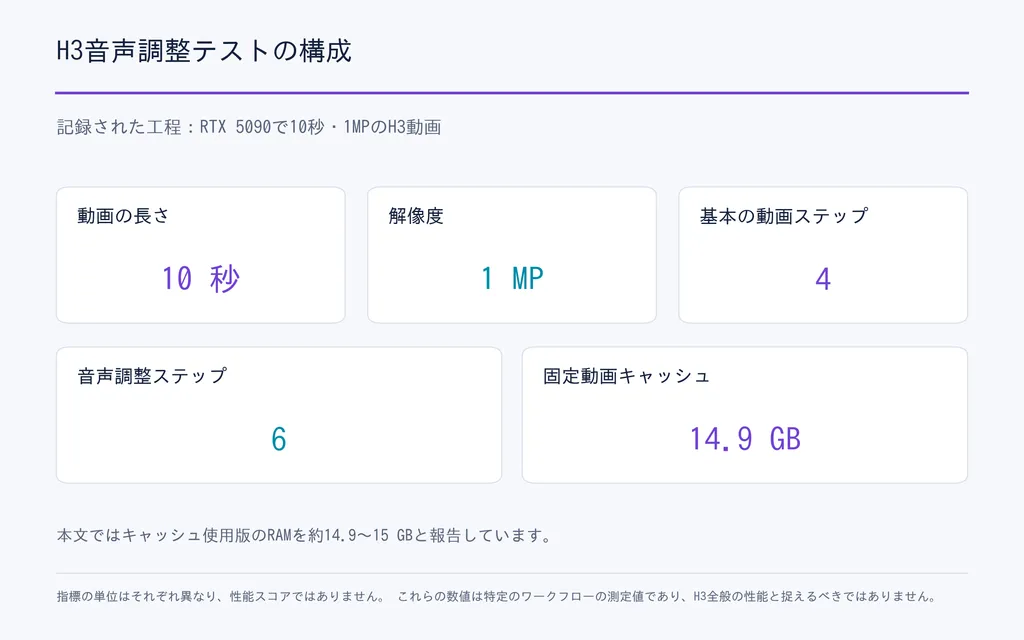
記録されたあるテストでは、RTX 5090上で10秒・1MPのH3動画を使用しました。
ワークフロー | おおよその時間 |
|---|---|
標準の4ステップ生成 | 136.5秒 |
4ステップ+音声調整6ステップ、追加キャッシュなし | 265秒 |
4ステップ+音声調整6ステップ、固定動画キャッシュあり | 186秒 |
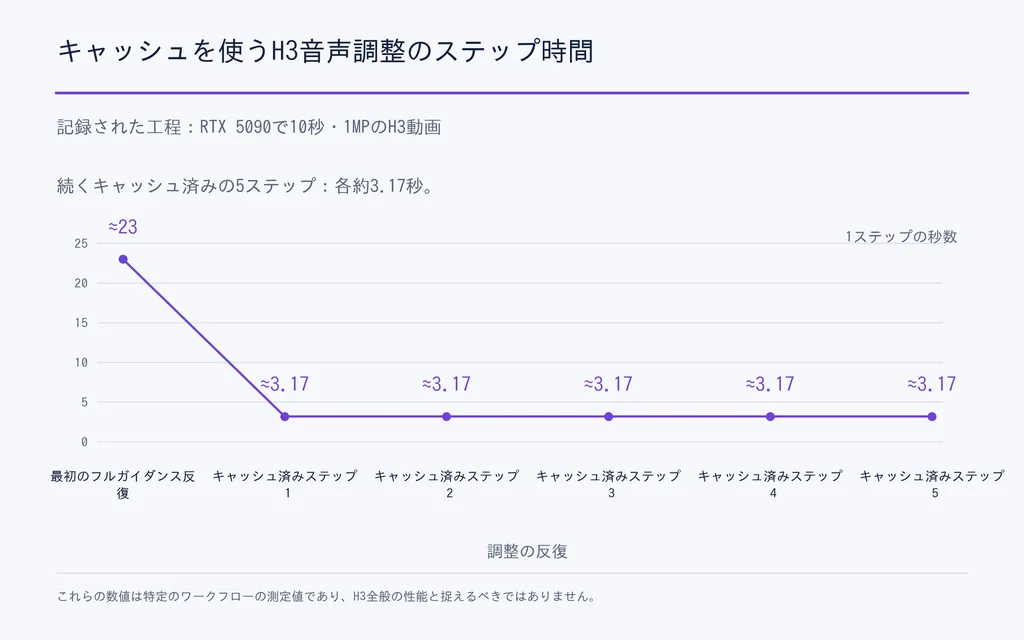
キャッシュ使用版のRAM使用量は約14.9~15 GBでした。最初のフルガイダンス反復には約23秒かかり、続くキャッシュ済みの5ステップは約1ステップあたり3.17秒で実行されました。よりクリアな音声を追加生成すると約45秒が加わりました。
これらの数値は特定のワークフローの測定値であり、H3全般の性能と捉えるべきではありません。
より重要な教訓は、音声と映像に別々の最適化予算を割り当てるメリットがあることです。映像がすでに十分なら、クリップ全体を再サンプリングするより、音声だけに計算を追加するほうが効率的な場合があります。
MiniMax H3のキーフレーム制御にはどのような主な限界がある?
MiniMax H3は動画のタイムライン内に画像・音声ガイドを置くという基本課題を解決していますが、制作ではなお4つの制限が重要です。
フレームのタイミングは決定論的ではない
ガイドが正確な位置を狙っていても、目に見える遷移は少し早く、または遅くなることがあります。絵コンテ上の重要な展開は、生成後に必ず確認してください。
キーフレームの影響には、より細かな制御が必要
複数の参照を追加できるようになると、次の課題はそれぞれがどの程度強くモデルを制約すべきかを決めることです。商品の主役カットは、途中の動作ポーズより厳密な追従が必要かもしれません。
音声制御は画像制御ほど成熟していない
音声にも同じタイムラインの考え方を使えますが、同期、少ないステップでの品質、ワークフローの安定性は、視覚ガイドほど予測しやすくありません。
長い継続生成では誤差が蓄積する
生成の反復によって、同一性、照明、鮮明さ、動きが徐々に変化する可能性があります。無期限に連続性が保たれると期待するより、継続的な参照と定期的な品質の固定点を使うほうが確実です。
よくある質問
H3 AddGuideは1本の動画で複数の画像・音声参照を使える?
はい。複数のH3 AddGuide段階を連結でき、ガイドには静止画、対応するフレーム列、音声、または映像と音声を組み合わせた文脈を含められます。記録されたワークフローでは、2つのキーフレームから4つ以上に拡張しています。追加された制約が相互作用する中で時間の正確さを保つことが、主な課題です。
継続生成には末尾フレームよりH3 AddGuideのほうが良い?
動きや音声の連続性が重要な場合は、通常、より多くの情報を与えられます。末尾フレームは外観を保持し、複数フレームガイドは直前の動きの文脈を提供します。ある実用的な方法では最後の22フレームと対応する音声を使い、次の区間につなぐ前に重複部分を切り取ります。
H3キーフレームが指定フレームからずれるのはなぜ?
H3のガイドは生成の固定点であり、決定論的なアニメーションのキーフレームではありません。モデルが遷移を早く始めたり、目標の視覚状態に遅れて到達したりすることがあります。長いクリップ、複数人物の場面、台詞のシーケンス、複数のガイドが競合するワークフローでは、ずれが起こりやすくなります。
H3はTurbo LoRAで使える?音声品質を改善するには?
Turboワークフローではサンプリングステップが減りますが、音声と映像の品質が同じ割合で改善するとは限りません。10秒・1MPのあるワークフローでは、通常の4ステップの後に音声だけの調整を6ステップ行いました。動画を固定してガイダンスをキャッシュすると、総時間は約265秒から約186秒に短縮されました。
結論
MiniMax H3のキーフレーム制御は、従来のコマごとのアニメーションというより、画像、動き、音声のためのタイムライン型条件付けシステムとして最も有効です。AddGuideで動画内に参照の固定点を置けるようになり、5、22、39フレームなどの対応する長さで動きを考慮した継続生成が可能になります。複数のガイドは、絵コンテ上の展開を構造化された生成シーケンスに変えられます。現在の最良のワークフローは、時間的固定点、プロンプトの時間指定、継続的な同一性参照、短い映像・音声の文脈ウィンドウ、定期的な品質の立て直しを組み合わせます。フレームのずれ、ガイドの影響、音声の調整、長編動画の累積的な劣化は依然として精度を制限しますが、H3はAI動画を単発のプロンプト生成から、より制御しやすい創作タイムラインへと確実に進めています。
Virse ブログの他の記事
ワークフロー

GPT Image 2.5 Noise and Oversharpening: Why Some Images Still Look AI-Generated
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Keeps Changing My Image: How to Use a "Keep List" for Reliable Edits
2026年10月9日 by Yifan Zhao
ワークフロー

GPT Image 2.5 Editing Drift: Why Images Get Blurry, Cropped or Worse After Multiple Edits
2026年10月9日 by Yifan Zhao